TLB 转换后援缓冲器工作原理与 Linux 内核 TLB 刷新开销优化
在现代多核高性能服务器与高并发系统中,CPU 主频与计算能力飞速提升,但内存访存延迟(Memory Wall)依然是制约性能的关键瓶颈。从虚拟地址(VA)到物理地址(PA)的转换依赖于内存管理单元(MMU)遍历 4 级甚至 5 级页表(PGD -> P4D -> PUD -> PMD -> PTE)。如果每次访存都触发 4~5 次内存寻址,性能将彻底崩溃。
TLB(Translation Lookaside Buffer,转换后援缓冲器)作为 MMU 内部的高速硬件缓存,直接缓存了最近使用的虚拟页号到物理页号的映射。然而,在多核(SMP)架构下,当内核修改页表(如 munmap、内存规整、进程切换)时,维护各核心间 TLB 的一致性会引发高昂的跨核中断开销(TLB Shootdown)。本文深入剖析 TLB 硬件原理与 Linux 内核中的极致优化路径。
一、TLB 硬件架构与查询路径
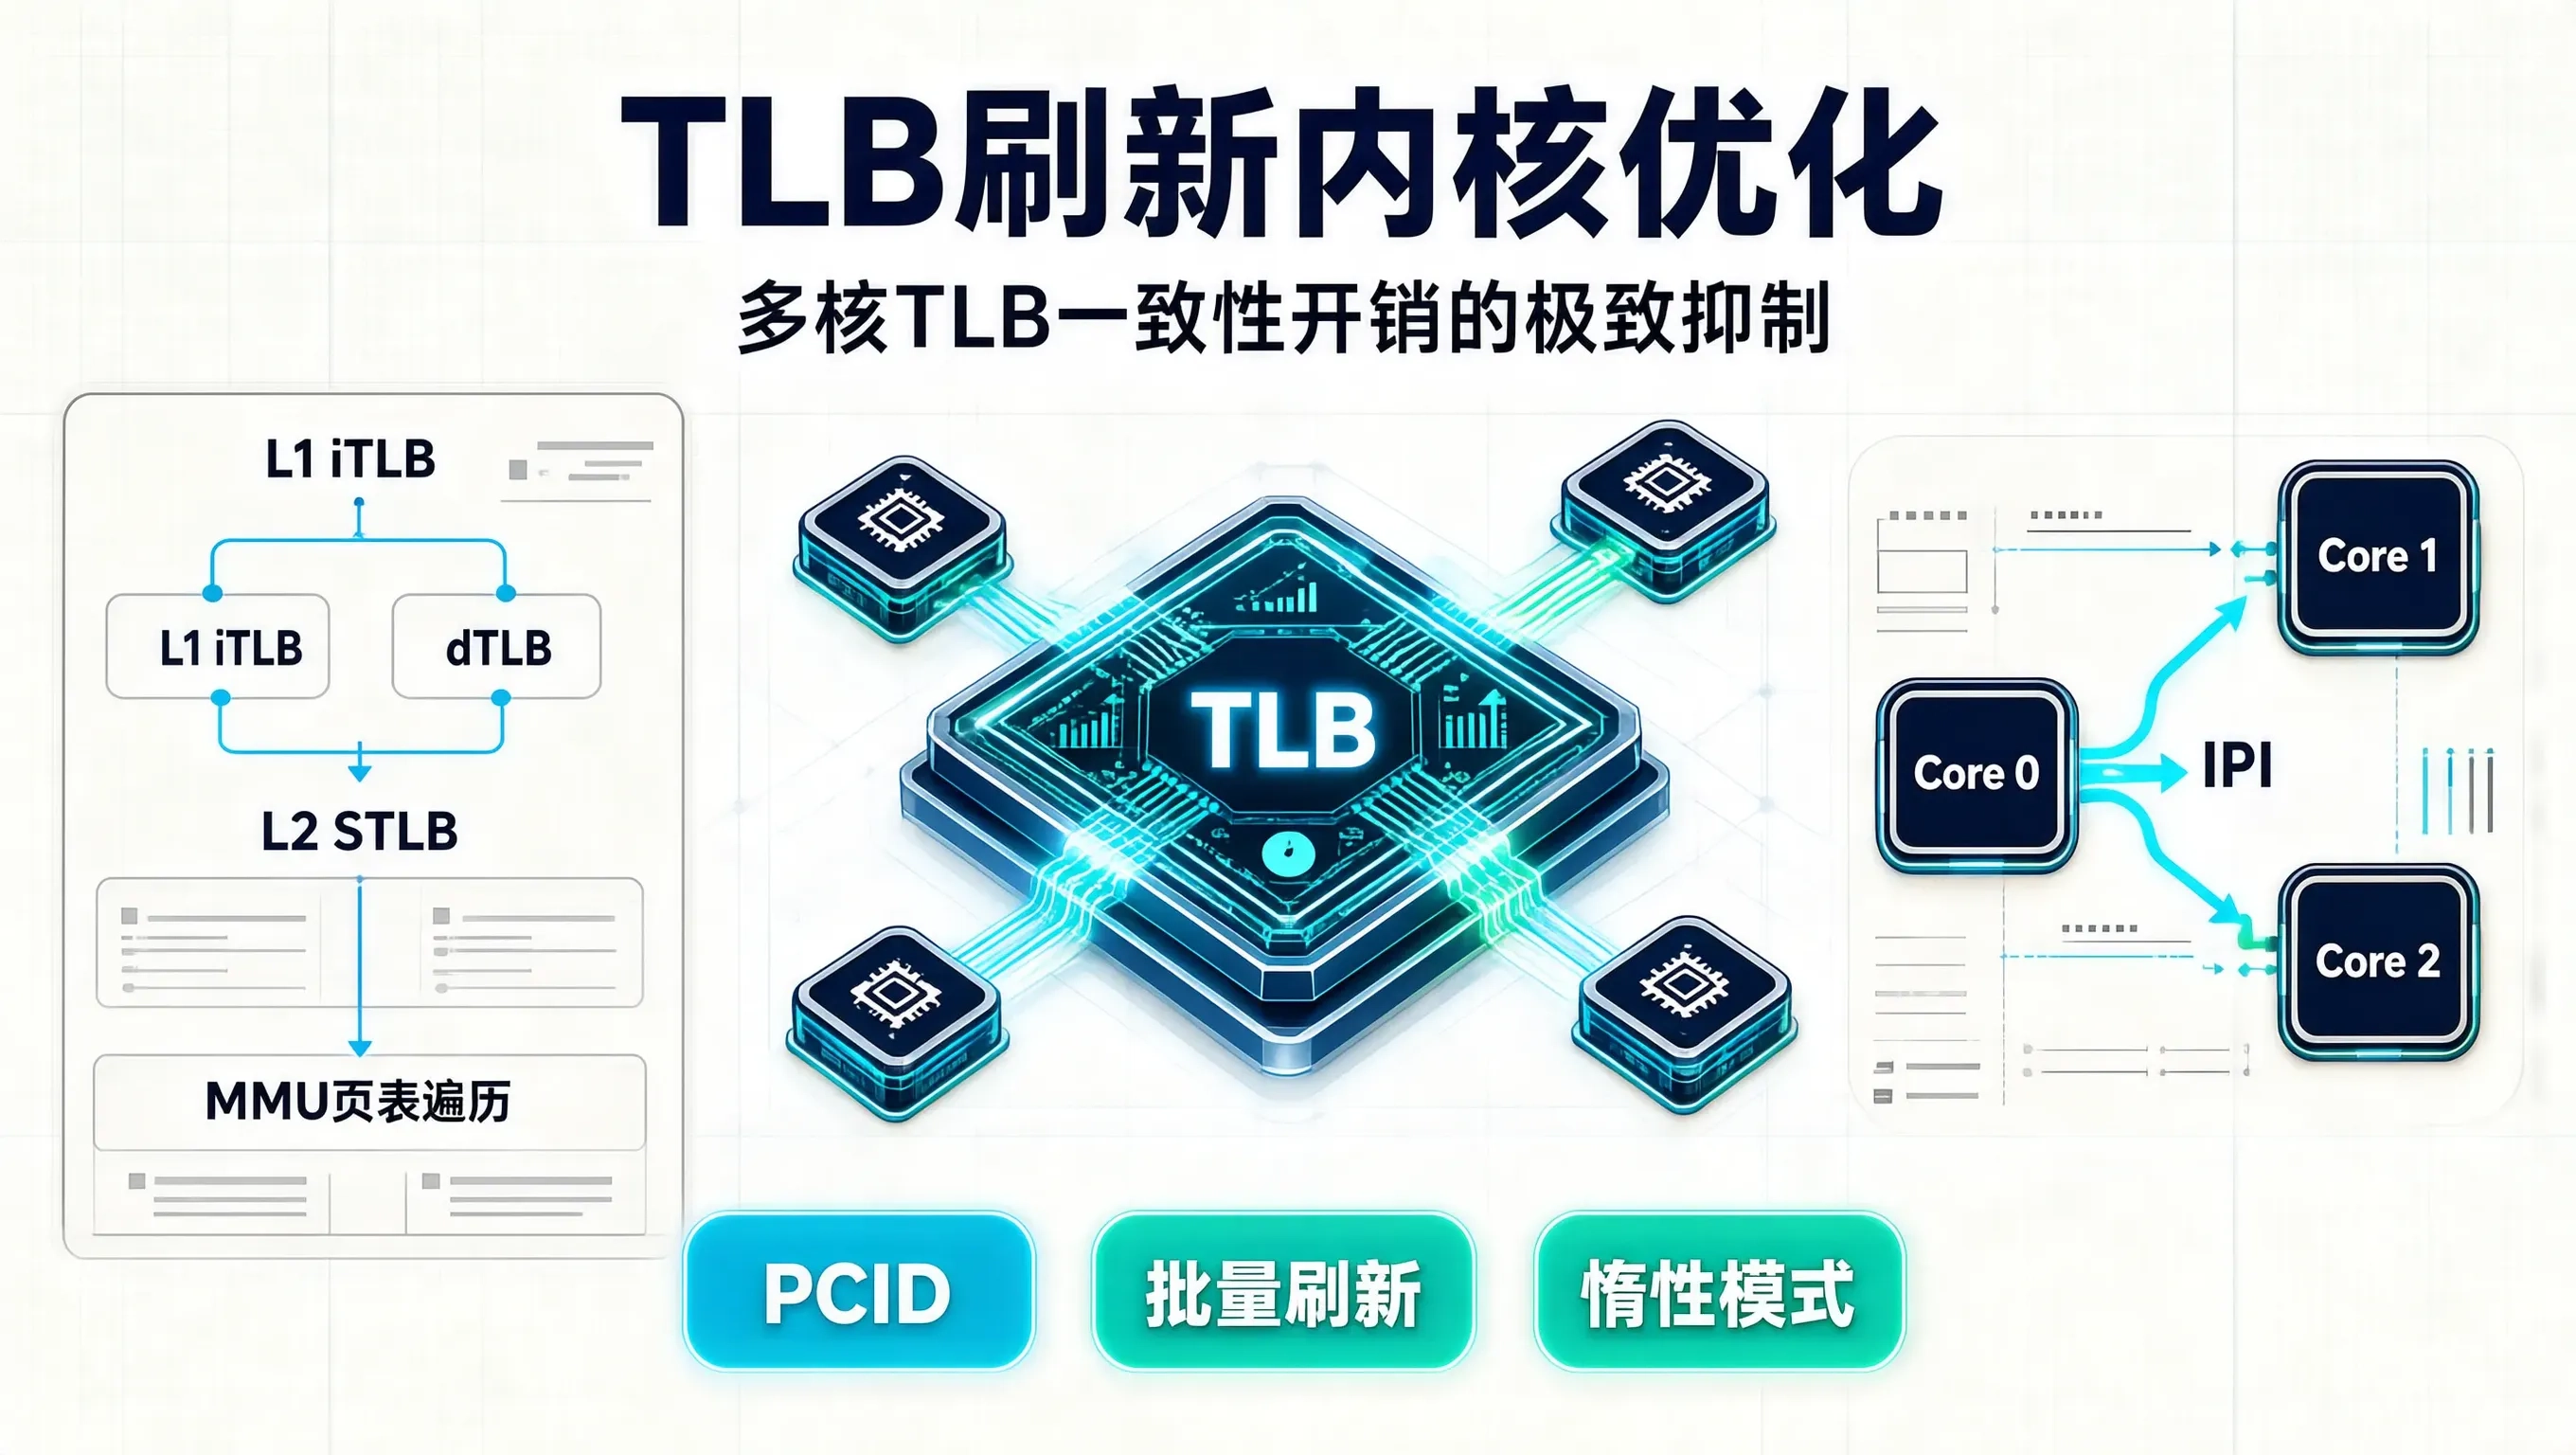
在 CPU 内部,TLB 通常按照功能与层级分为 L1 iTLB(指令 TLB)、L1 dTLB(数据 TLB)以及统一的 L2 STLB(Shared/Second-level TLB)。
[ CPU 核心发出虚拟地址 Virtual Address (VA) ]
│
▼
[ 查询 L1 iTLB / dTLB ]
├── 命中 (Hit, ~1 cycle) ──► 获得物理地址 (PA)
└── 未命中 (Miss)
│
▼
[ 查询 L2 STLB ]
├── 命中 (Hit, ~7-12 cycles) ──► 获得物理地址 (PA)
└── 未命中 (Miss)
│
▼
[ 硬件 MMU 触发 Page Table Walk ]
(连续访问 4 级页表,耗时 50~200+ 周期)
│
▼
[ 填入 TLB 并输出物理地址 ]
当发生 TLB Miss 时,硬件 Page Walker 必须通过 CR3 寄存器指向的根页表基地址逐步下探。为了减少 TLB Miss,CPU 硬件引入了组相联(Set-Associative)与全相联结构,但硬件容量极其宝贵(L1 通常仅 64128 条,L2 约 10242048 条)。
二、Linux 内核中的 TLB 刷新场景与 IPI 开销
当内核中的页表发生变更时,旧的 TLB 条目必须被显式失效(Invalidate),否则会导致严重的用户态数据踩踏或安全漏洞。
1. 经典触发场景
- 进程切换(Context Switch):传统机制下,切换不同进程需要更新 CR3 寄存器,硬件会自动冲刷当前核心的全部非全局(Non-Global)TLB。
- 内存回收与解绑(munmap / mprotect):用户进程释放某段内存时,内核修改页表后必须使对应地址范围的 TLB 失效。
- 页迁移与内存碎片整理(KSM / THP Compaction):物理页地址变动,必须同步更新映射并刷新 TLB。
2. SMP 多核下的 TLB Shootdown 风暴
在 SMP 系统中,如果一个多线程进程在 Core 0 上调用了 munmap,但该进程的线程同时在 Core 1、Core 2 上运行,Core 0 无法直接修改其他核心的私有硬件 TLB。
内核必须通过 IPI(Inter-Processor Interrupt,处理器间中断) 向所有正在运行该进程上下文的核心发送广播中断,强制其他核心暂停当前流水线并执行 TLB 刷新指令(如 invlpg)。
[ Core 0 (调用 munmap) ] ──发送 IPI 中断──► [ Core 1 (挂起并刷新 TLB) ]
└──发送 IPI 中断──► [ Core 2 (挂起并刷新 TLB) ]
当多线程程序频繁申请释放内存时,TLB Shootdown 引发的中断风暴会导致 CPU 大量耗费在中断上下文自旋等待上,在 perf top 中表现为 smp_call_function_many 或 flush_tlb_func 占用极高。
三、Linux 内核核心优化机制
为了抑制 TLB 刷新的性能损耗,Linux 内核演进出了多套深度优化机制。
1. PCID / ASID 机制(Process-Context Identifier)
在未引入 PCID 之前,每次进程切换切换 CR3,所有 TLB 必须全部刷掉。现代 x86_64 支持 PCID(ARM 支持 ASID),硬件允许在 TLB 条目中附加 12 位的进程标签(支持 4096 个上下文)。
- 当切换进程时,内核更新 CR3 的同时保留第 63 位(NOFLUSH 位):$$\\text{CR3} = \\text{Target_PGD} \\mid \\text{PCID} \\mid (1ULL \\ll 63)$$
- 硬件不会清空原有 TLB,切回原进程时之前的 TLB 条目依然有效,大幅降低了微服务与高频进程切换系统的 TLB Miss。
2. Lazy TLB 模式
当 CPU 调度到内核线程(如 kworker)时,内核线程没有自己独立的用户态 mm_struct(current->mm == NULL),而是借用前一个进程的 active_mm。
Linux 内核将该 CPU 标记为 Lazy TLB 状态。此时其他核心发生 TLB Invalidation 时,如果目标核心处于 Lazy 模式,内核不会立即向其发送 IPI 中断,而是延后到该核心真正切换到新用户态进程时再一并冲刷,彻底省去了无效中断。
3. 批量刷新机制(TLB Batching)
内核在执行大块内存解绑时,并非每释放一个 4KB 页就触发一次 invlpg,而是通过 mmu_gather 结构进行聚合:
// arch/x86/mm/tlb.c 核心刷新逻辑概览
void flush_tlb_mm_range(struct mm_struct *mm, unsigned long start,
unsigned long end, unsigned int stride_shift,
bool freed_tables)
{
int cpu;
struct flush_tlb_info info;
// 1. 若仅在单核运行,直接执行本地刷新,避免 IPI
if (cpumask_equal(mm_cpumask(mm), cpumask_of(smp_processor_id()))) {
count_vm_tlb_event(NR_TLB_LOCAL_FLUSH_ALL);
local_flush_tlb();
return;
}
// 2. 计算需要失效的页数量,若跨度过大则直接整片全刷,而非单页循环 invlpg
info.start = start;
info.end = end;
info.stride_shift = stride_shift;
// 3. 仅针对当前正在运行该 mm 上下文的活跃 CPU 发送 IPI
on_each_cpu_mask(mm_cpumask(mm), flush_tlb_func, &info, 1);
}
四、生产环境排查与调优指南
要排查系统是否存在严重的 TLB 瓶颈,可以通过内核虚拟文件系统和 perf 工具进行定位:
# 1. 查看系统当前的 TLB 刷新与 IPI 中断统计
cat /proc/interrupts | grep -E "TLB|Function call"
# 2. 使用 perf 捕获 TLB Shootdown 开销
perf top -e cycles -e tlb:tlb_flush –call-graph dwarf
# 3. 检查系统是否开启硬件 PCID 支持
grep -q "pcid" /proc/cpuinfo && echo "PCID Supported" || echo "PCID Not Supported"
在高吞吐内存密集型系统中,理解 TLB 的生命周期不仅有助于编写 Cache 友好的高性能代码(如减少小对象频繁解绑、采用对象池),也为深入理解内核内存管理与多核并发控制提供了坚实的底层抓手。