💖💖作者:计算机毕业设计江挽 💙💙个人简介:曾长期从事计算机专业培训教学,本人也热爱上课教学,语言擅长Java、微信小程序、Python、Golang、安卓Android等,开发项目包括大数据、深度学习、网站、小程序、安卓、算法。平常会做一些项目定制化开发、代码讲解、答辩教学、文档编写、也懂一些降重方面的技巧。平常喜欢分享一些自己开发中遇到的问题的解决办法,也喜欢交流技术,大家有技术代码这一块的问题可以问我! 💛💛想说的话:感谢大家的关注与支持! 💜💜 网站实战项目 安卓/小程序实战项目 大数据实战项目 深度学习实战项目
目录
- 基于大数据的低能见度事件监测数据分介绍
- 基于大数据的低能见度事件监测数据分演示视频
- 基于大数据的低能见度事件监测数据分演示图片
- 基于大数据的低能见度事件监测数据分代码展示
- 基于大数据的低能见度事件监测数据分文档展示
基于大数据的低能见度事件监测数据分介绍
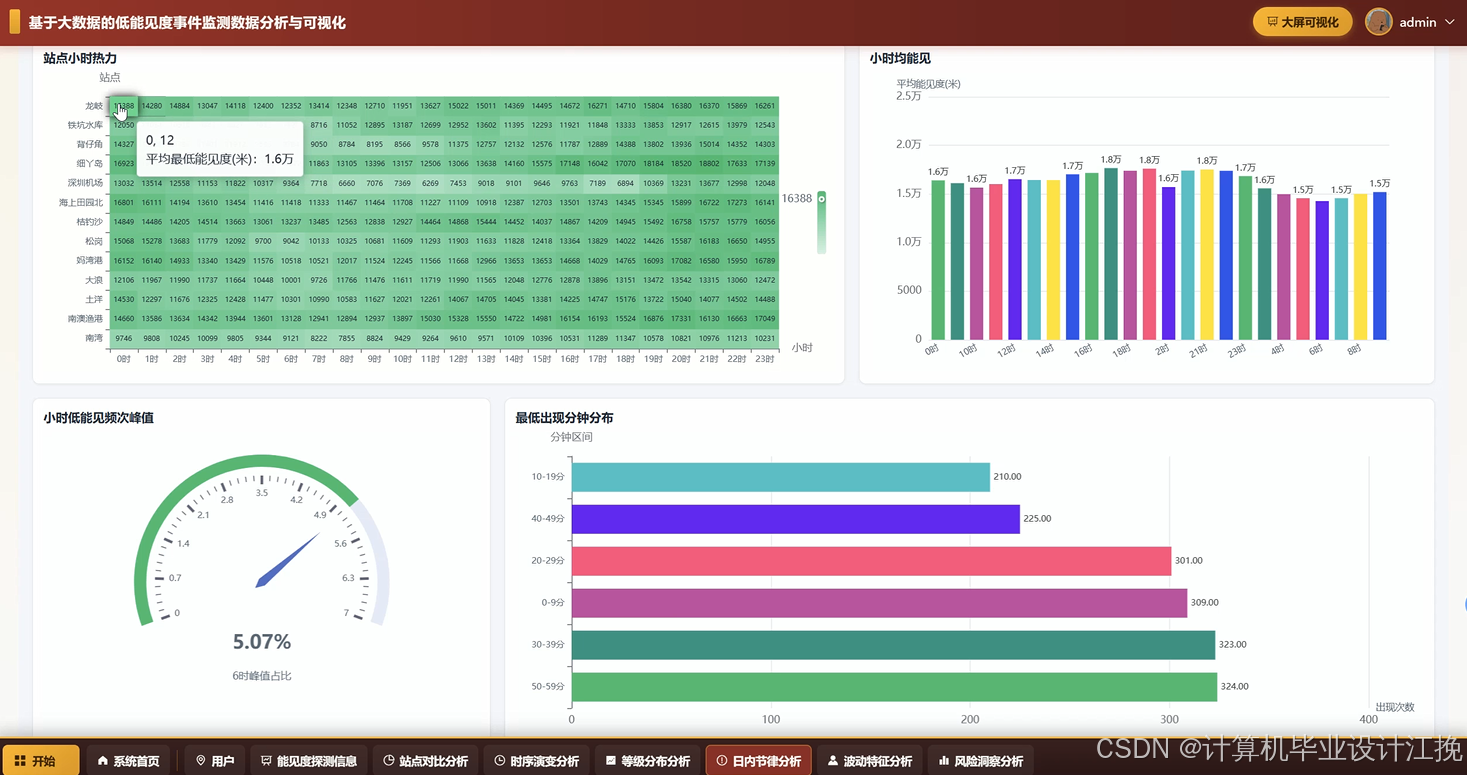
本系统名为《基于大数据的低能见度事件监测数据分析》,面向低能见度事件监测场景下的数据存储、清洗、统计与可视化分析需求,采用 Hadoop 与 Spark 作为核心大数据处理框架,以 HDFS 完成原始监测数据的分布式存储,通过 Spark SQL 与 Pandas、NumPy 完成数据清洗、指标计算与多维统计分析,后端基于 Python 的 Django 框架构建数据接口,前端采用 Vue 结合 ElementUI、Echarts、HTML、CSS、JavaScript 与 jQuery 实现交互展示。系统围绕用户首页、能见度探测信息、站点对比分析、时序演变分析、等级分布分析、日内节律分析、波动特征分析以及风险洞察分析等功能模块展开,能够对低能见度事件监测数据进行按站点、按时间、按等级等多维度处理,帮助用户直观了解不同站点之间能见度变化差异、事件在时间轴上的演变趋势、能见度等级的分布结构、日内变化节律以及波动与风险特征,从而形成一个从大数据存储、计算分析到可视化呈现的完整毕业设计系统。
基于大数据的低能见度事件监测数据分演示视频
演示视频
基于大数据的低能见度事件监测数据分演示图片

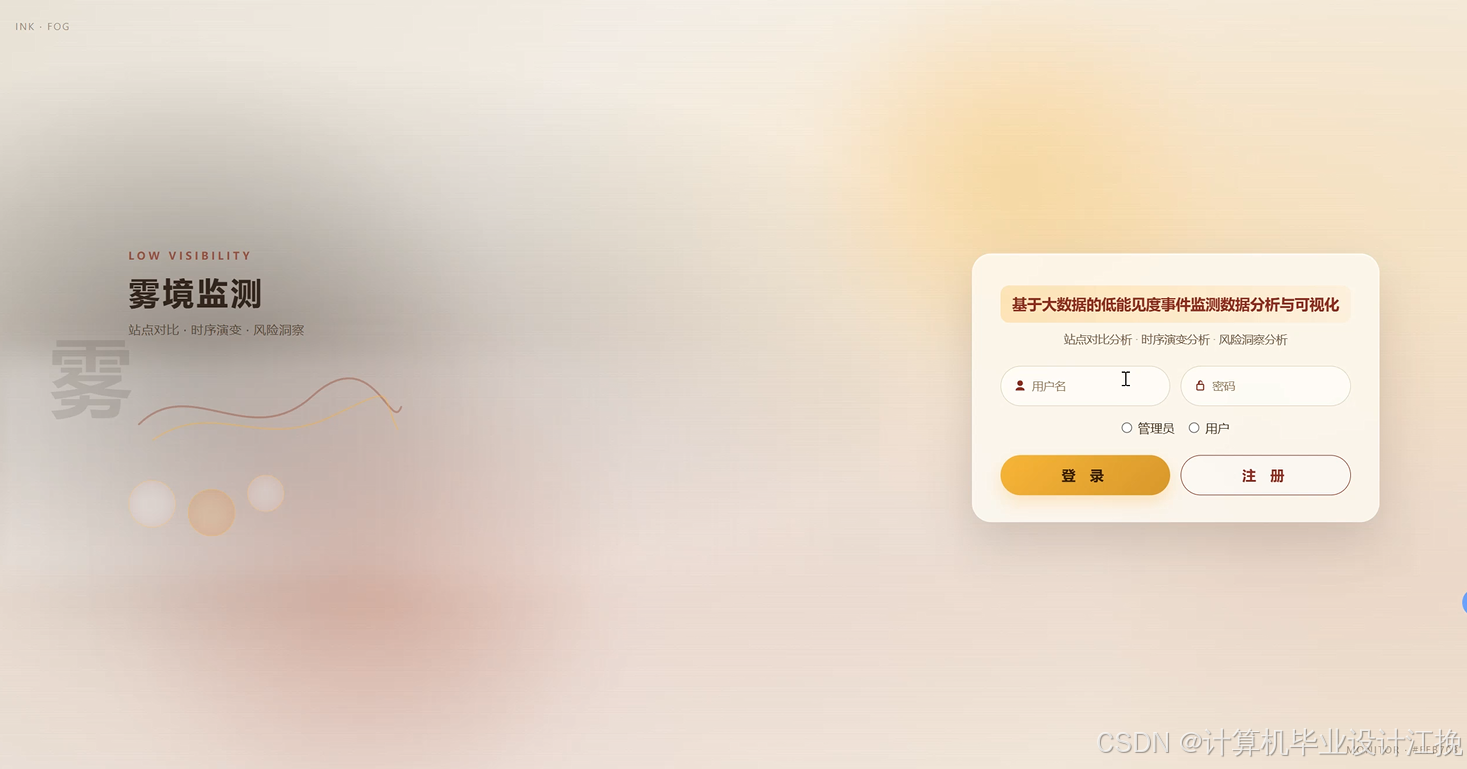
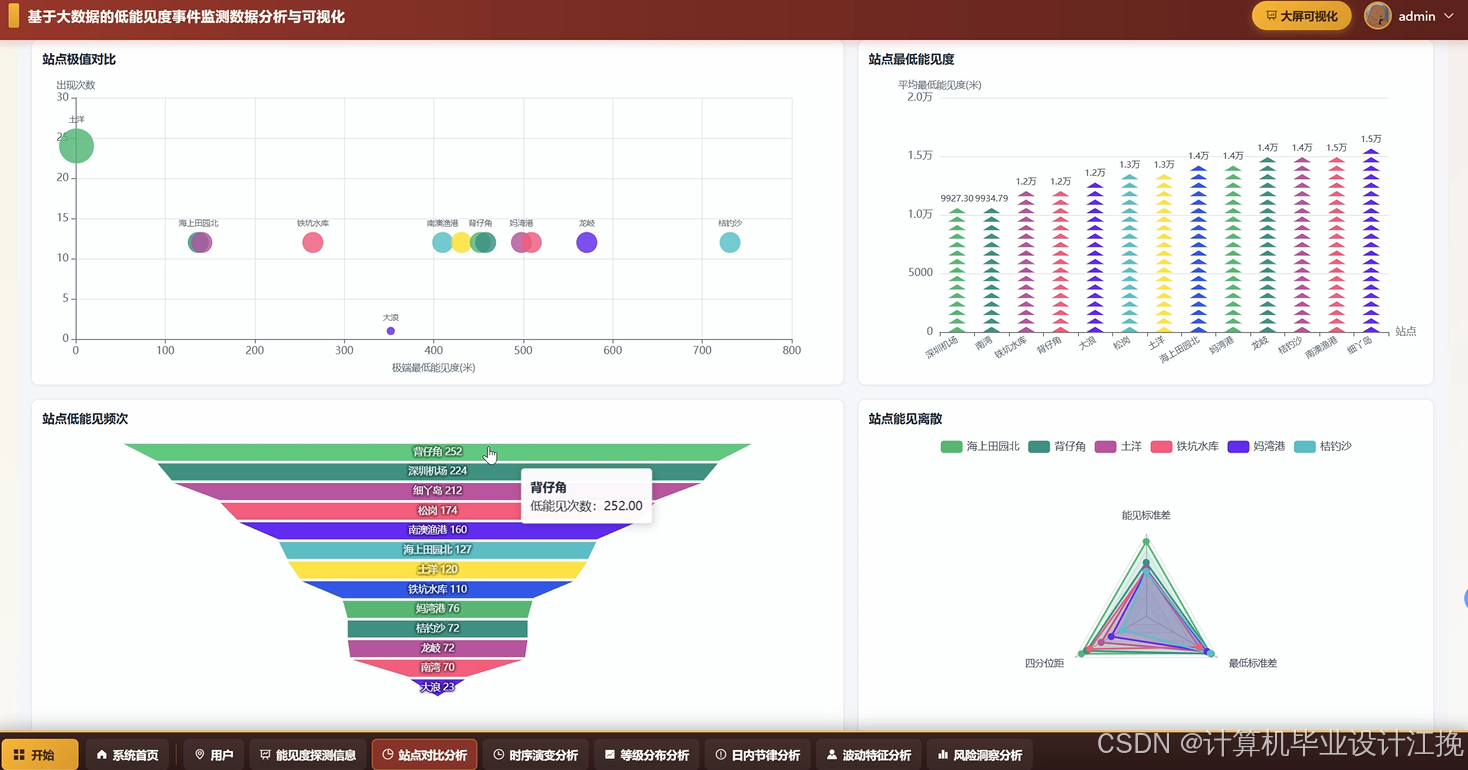
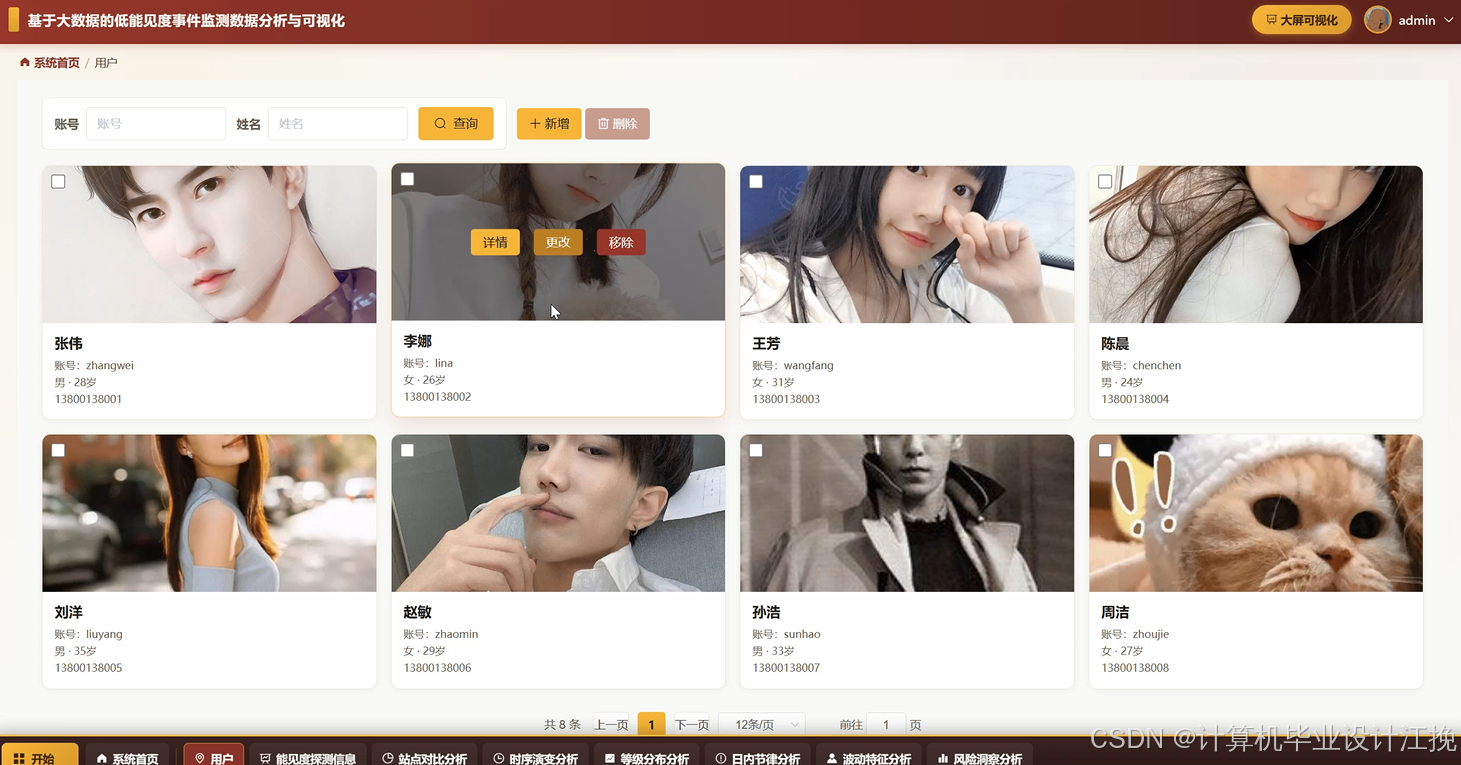
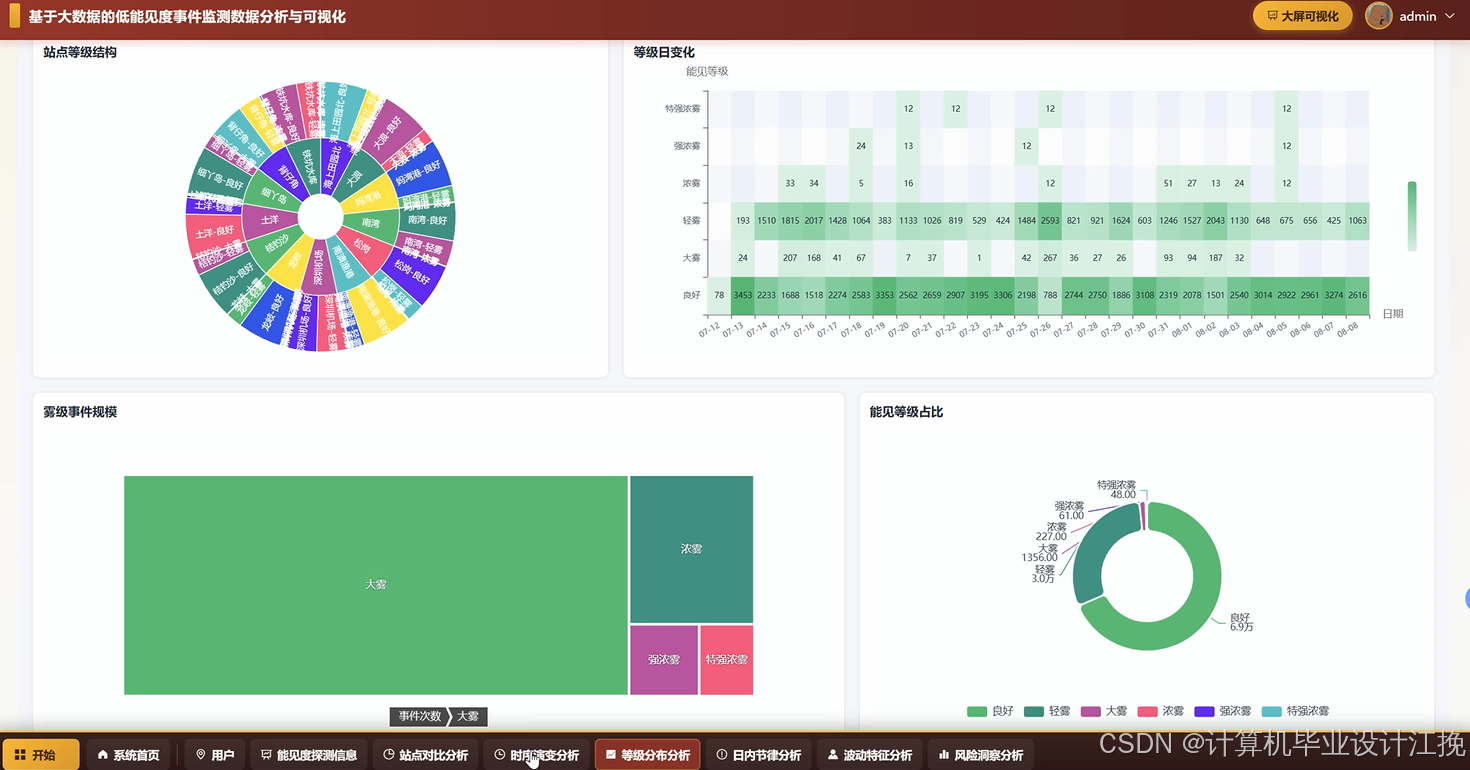


基于大数据的低能见度事件监测数据分代码展示
from pyspark.sql import SparkSession
from pyspark.sql.functions import col, count, avg, min, max, stddev, hour, to_timestamp, when, desc, sum as _sum, round as _round
from django.http import JsonResponse
from django.views.decorators.http import require_GET
from .models import VisibilityRecord
import pandas as pd
import numpy as np
spark = SparkSession.builder.appName("LowVisibilityMonitorAnalysis").master("local[*]").config("spark.sql.shuffle.partitions", "4").getOrCreate()
@require_GET
def station_compare_analysis(request):
station_id = request.GET.get("station_id")
start_time = request.GET.get("start_time")
end_time = request.GET.get("end_time")
queryset = VisibilityRecord.objects.filter(station_id=station_id, observe_time__range=(start_time, end_time)).values("station_id", "observe_time", "visibility_value", "visibility_level")
pdf = pd.DataFrame(list(queryset))
if pdf.empty:
return JsonResponse({"code": 400, "msg": "当前站点在所选时间段内没有监测记录", "data": []}, json_dumps_params={"ensure_ascii": False})
pdf["observe_time"] = pd.to_datetime(pdf["observe_time"])
pdf["visibility_value"] = pd.to_numeric(pdf["visibility_value"], errors="coerce")
pdf = pdf.dropna(subset=["visibility_value"])
sdf = spark.createDataFrame(pdf)
sdf.createOrReplaceTempView("station_visibility")
result = spark.sql("""
SELECT station_id,
COUNT(1) AS record_count,
ROUND(AVG(visibility_value), 2) AS avg_visibility,
ROUND(MIN(visibility_value), 2) AS min_visibility,
ROUND(MAX(visibility_value), 2) AS max_visibility,
ROUND(STDDEV(visibility_value), 2) AS std_visibility
FROM station_visibility
GROUP BY station_id
ORDER BY avg_visibility ASC
""").toPandas()
level_dist = sdf.groupBy("station_id", "visibility_level").agg(count("visibility_value").alias("level_count")).toPandas()
result = result.merge(level_dist, on="station_id", how="left")
result["level_ratio"] = result["level_count"] / result["record_count"]
result = result.sort_values(by="avg_visibility", ascending=True)
records = result.to_dict(orient="records")
return JsonResponse({"code": 200, "msg": "站点对比分析完成", "data": records}, json_dumps_params={"ensure_ascii": False})
@require_GET
def time_series_analysis(request):
station_id = request.GET.get("station_id")
granularity = request.GET.get("granularity", "hour")
queryset = VisibilityRecord.objects.filter(station_id=station_id).values("observe_time", "visibility_value")
pdf = pd.DataFrame(list(queryset))
if pdf.empty:
return JsonResponse({"code": 400, "msg": "该站点暂无监测数据", "data": []}, json_dumps_params={"ensure_ascii": False})
pdf["observe_time"] = pd.to_datetime(pdf["observe_time"])
pdf["visibility_value"] = pd.to_numeric(pdf["visibility_value"], errors="coerce")
pdf = pdf.dropna(subset=["visibility_value"])
if granularity == "hour":
pdf["time_bucket"] = pdf["observe_time"].dt.strftime("%Y-%m-%d %H:00:00")
elif granularity == "day":
pdf["time_bucket"] = pdf["observe_time"].dt.strftime("%Y-%m-%d")
else:
pdf["time_bucket"] = pdf["observe_time"].dt.strftime("%Y-%m")
sdf = spark.createDataFrame(pdf)
sdf.createOrReplaceTempView("time_visibility")
result = spark.sql("""
SELECT time_bucket,
COUNT(1) AS record_count,
ROUND(AVG(visibility_value), 2) AS avg_visibility,
ROUND(MIN(visibility_value), 2) AS min_visibility,
ROUND(MAX(visibility_value), 2) AS max_visibility
FROM time_visibility
GROUP BY time_bucket
ORDER BY time_bucket ASC
""").toPandas()
result["trend_direction"] = np.where(result["avg_visibility"].diff().fillna(0) >= 0, "上升", "下降")
result["moving_avg"] = result["avg_visibility"].rolling(window=3, min_periods=1).mean().round(2)
result["fluctuation"] = (result["max_visibility"] – result["min_visibility"]).round(2)
records = result.to_dict(orient="records")
return JsonResponse({"code": 200, "msg": "时序演变分析完成", "data": records}, json_dumps_params={"ensure_ascii": False})
@require_GET
def risk_insight_analysis(request):
station_id = request.GET.get("station_id")
threshold = float(request.GET.get("threshold", 500))
queryset = VisibilityRecord.objects.filter(station_id=station_id).values("observe_time", "visibility_value", "visibility_level")
pdf = pd.DataFrame(list(queryset))
if pdf.empty:
return JsonResponse({"code": 400, "msg": "该站点暂无监测数据", "data": []}, json_dumps_params={"ensure_ascii": False})
pdf["observe_time"] = pd.to_datetime(pdf["observe_time"])
pdf["visibility_value"] = pd.to_numeric(pdf["visibility_value"], errors="coerce")
pdf = pdf.dropna(subset=["visibility_value"])
pdf["is_low_visibility"] = np.where(pdf["visibility_value"] <= threshold, 1, 0)
pdf["hour_segment"] = pdf["observe_time"].dt.hour
sdf = spark.createDataFrame(pdf)
sdf.createOrReplaceTempView("risk_visibility")
risk_result = spark.sql("""
SELECT hour_segment,
COUNT(1) AS total_count,
SUM(is_low_visibility) AS low_count,
ROUND(SUM(is_low_visibility) / COUNT(1), 4) AS low_ratio,
ROUND(AVG(visibility_value), 2) AS avg_visibility,
ROUND(MIN(visibility_value), 2) AS min_visibility
FROM risk_visibility
GROUP BY hour_segment
ORDER BY low_ratio DESC
""").toPandas()
risk_result["risk_level"] = np.where(risk_result["low_ratio"] >= 0.6, "高风险", np.where(risk_result["low_ratio"] >= 0.3, "中风险", "低风险"))
risk_result["risk_score"] = (risk_result["low_ratio"] * 100).round(2)
overall_low = int(pdf["is_low_visibility"].sum())
overall_total = int(len(pdf))
overall_ratio = round(overall_low / overall_total, 4) if overall_total > 0 else 0
records = risk_result.to_dict(orient="records")
return JsonResponse({"code": 200, "msg": "风险洞察分析完成", "data": records, "overall_low": overall_low, "overall_total": overall_total, "overall_ratio": overall_ratio}, json_dumps_params={"ensure_ascii": False})
基于大数据的低能见度事件监测数据分文档展示
💖💖作者:计算机毕业设计江挽 💙💙个人简介:曾长期从事计算机专业培训教学,本人也热爱上课教学,语言擅长Java、微信小程序、Python、Golang、安卓Android等,开发项目包括大数据、深度学习、网站、小程序、安卓、算法。平常会做一些项目定制化开发、代码讲解、答辩教学、文档编写、也懂一些降重方面的技巧。平常喜欢分享一些自己开发中遇到的问题的解决办法,也喜欢交流技术,大家有技术代码这一块的问题可以问我! 💛💛想说的话:感谢大家的关注与支持! 💜💜 网站实战项目 安卓/小程序实战项目 大数据实战项目 深度学习实战项目