在上一篇文章中我们实现多路转接之select服务器的,今天我们学习poll以及epoll服务器
一.poll
(1)poll 函数接口

A. 参数说明
- fds:一个 poll 函数监视的结构列表,每一个元素都包含三部分内容:文件描述符、监视的事件集合、就绪的事件集合。
- nfds:表示 fds 数组的长度。
- timeout:表示 poll 函数的超时时间,单位是毫秒(ms)。
B. 参数 timeout 的取值
- -1:poll 调用后进行阻塞等待,直到被监视的某个文件描述符上的某个事件就绪。
- 0:poll 调用后进行非阻塞等待,无论被监视的文件描述符上的事件是否就绪,poll 检测后都会立即返回。
- 特定的时间值:poll 调用后在指定的时间内进行阻塞等待,若被监视的文件描述符上没有事件就绪,则在该时间后 poll 进行超时返回。
C. 返回值说明
- 若函数调用成功,则返回有事件就绪的文件描述符个数。
- 若 timeout 时间耗尽,表示超时,则返回 0。
- 若函数调用失败,则返回 -1,同时错误码被设置。
D. 错误码
poll 调用失败时,错误码可能被设置为:
- EFAULT:fds 数组不包含在调用程序的地址空间中
- EINTR:此调用被信号所中断
- EINVAL:nfds 值超过 RLIMIT_NOFILE 值
- ENOMEM:核心内存不足
(2)struct pollfd 结构
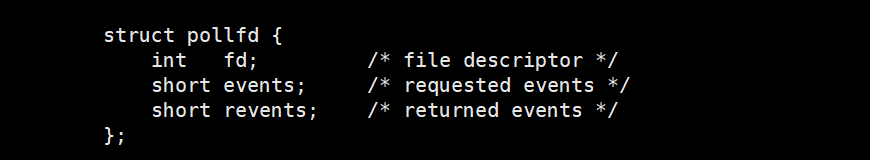
A. 参数说明
- fd:特定的文件描述符,若设置为负值则忽略 events 字段并且 revents 字段返回 0。
- events:需要监视该文件描述符上的哪些事件。
- revents:poll 函数返回时告知用户该文件描述符上的哪些事件已经就绪。
B. events 和 revents 的取值
| POLLIN | 数据(包括普通数据和优先数据)可读 | 是 | 是 |
| POLLRDNORM | 普通数据可读 | 是 | 是 |
| POLLRDBAND | 优先级带数据可读(Linux 不支持) | 是 | 是 |
| POLLPRI | 高优先级数据可读,比如 TCP 带外数据 | 是 | 是 |
| POLLOUT | 数据(包括普通数据和优先数据)可写 | 是 | 是 |
| POLLWRNORM | 普通数据可写 | 是 | 是 |
| POLLWRBAND | 优先级带数据可写 | 是 | 是 |
| POLLRDHUP | TCP 连接被对方关闭,或者对方关闭了写操作,它由 GNU 引入 | 是 | 是 |
| POLLERR | 错误 | 否 | 是 |
| POLLHUP | 挂起。比如管道的写端被关闭后,读端描述符上将收到 POLLHUP 事件 | 否 | 是 |
| POLLNVAL | 文件描述符没有打开 | 否 | 是 |
这些值都以宏的方式定义,二进制序列中有且只有一个 bit 位是 1,且为 1 的 bit 位各不相同。
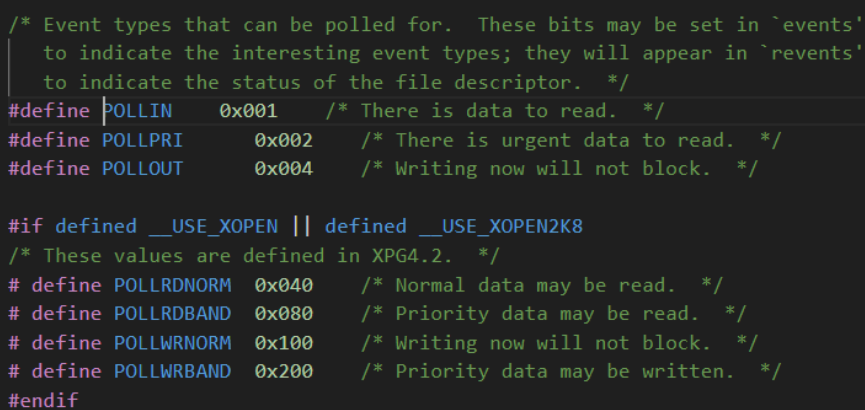
在调用 poll 函数之前,可以通过或运算符|将要监视的事件添加到events成员中。
在 poll 函数返回后,可以通过与运算符&检测revents成员中是否包含特定事件,以此判断对应文件描述符的特定事件是否就绪。
简单示例
// 设置监听:可读 + 可写
fd.events = POLLIN | POLLOUT;
// poll返回后,判断是否发生可读事件
if(fd.revents & POLLIN)
{
// 有数据可读,执行读操作
}
原理说明
C. 返回结果
- 返回值小于 0,表示出错。
- 返回值等于 0,表示 poll 函数等待超时。
- 返回值大于 0,表示 poll 由于监听的文件描述符就绪而返回。
(3)poll 服务器
我们来直接看代码:
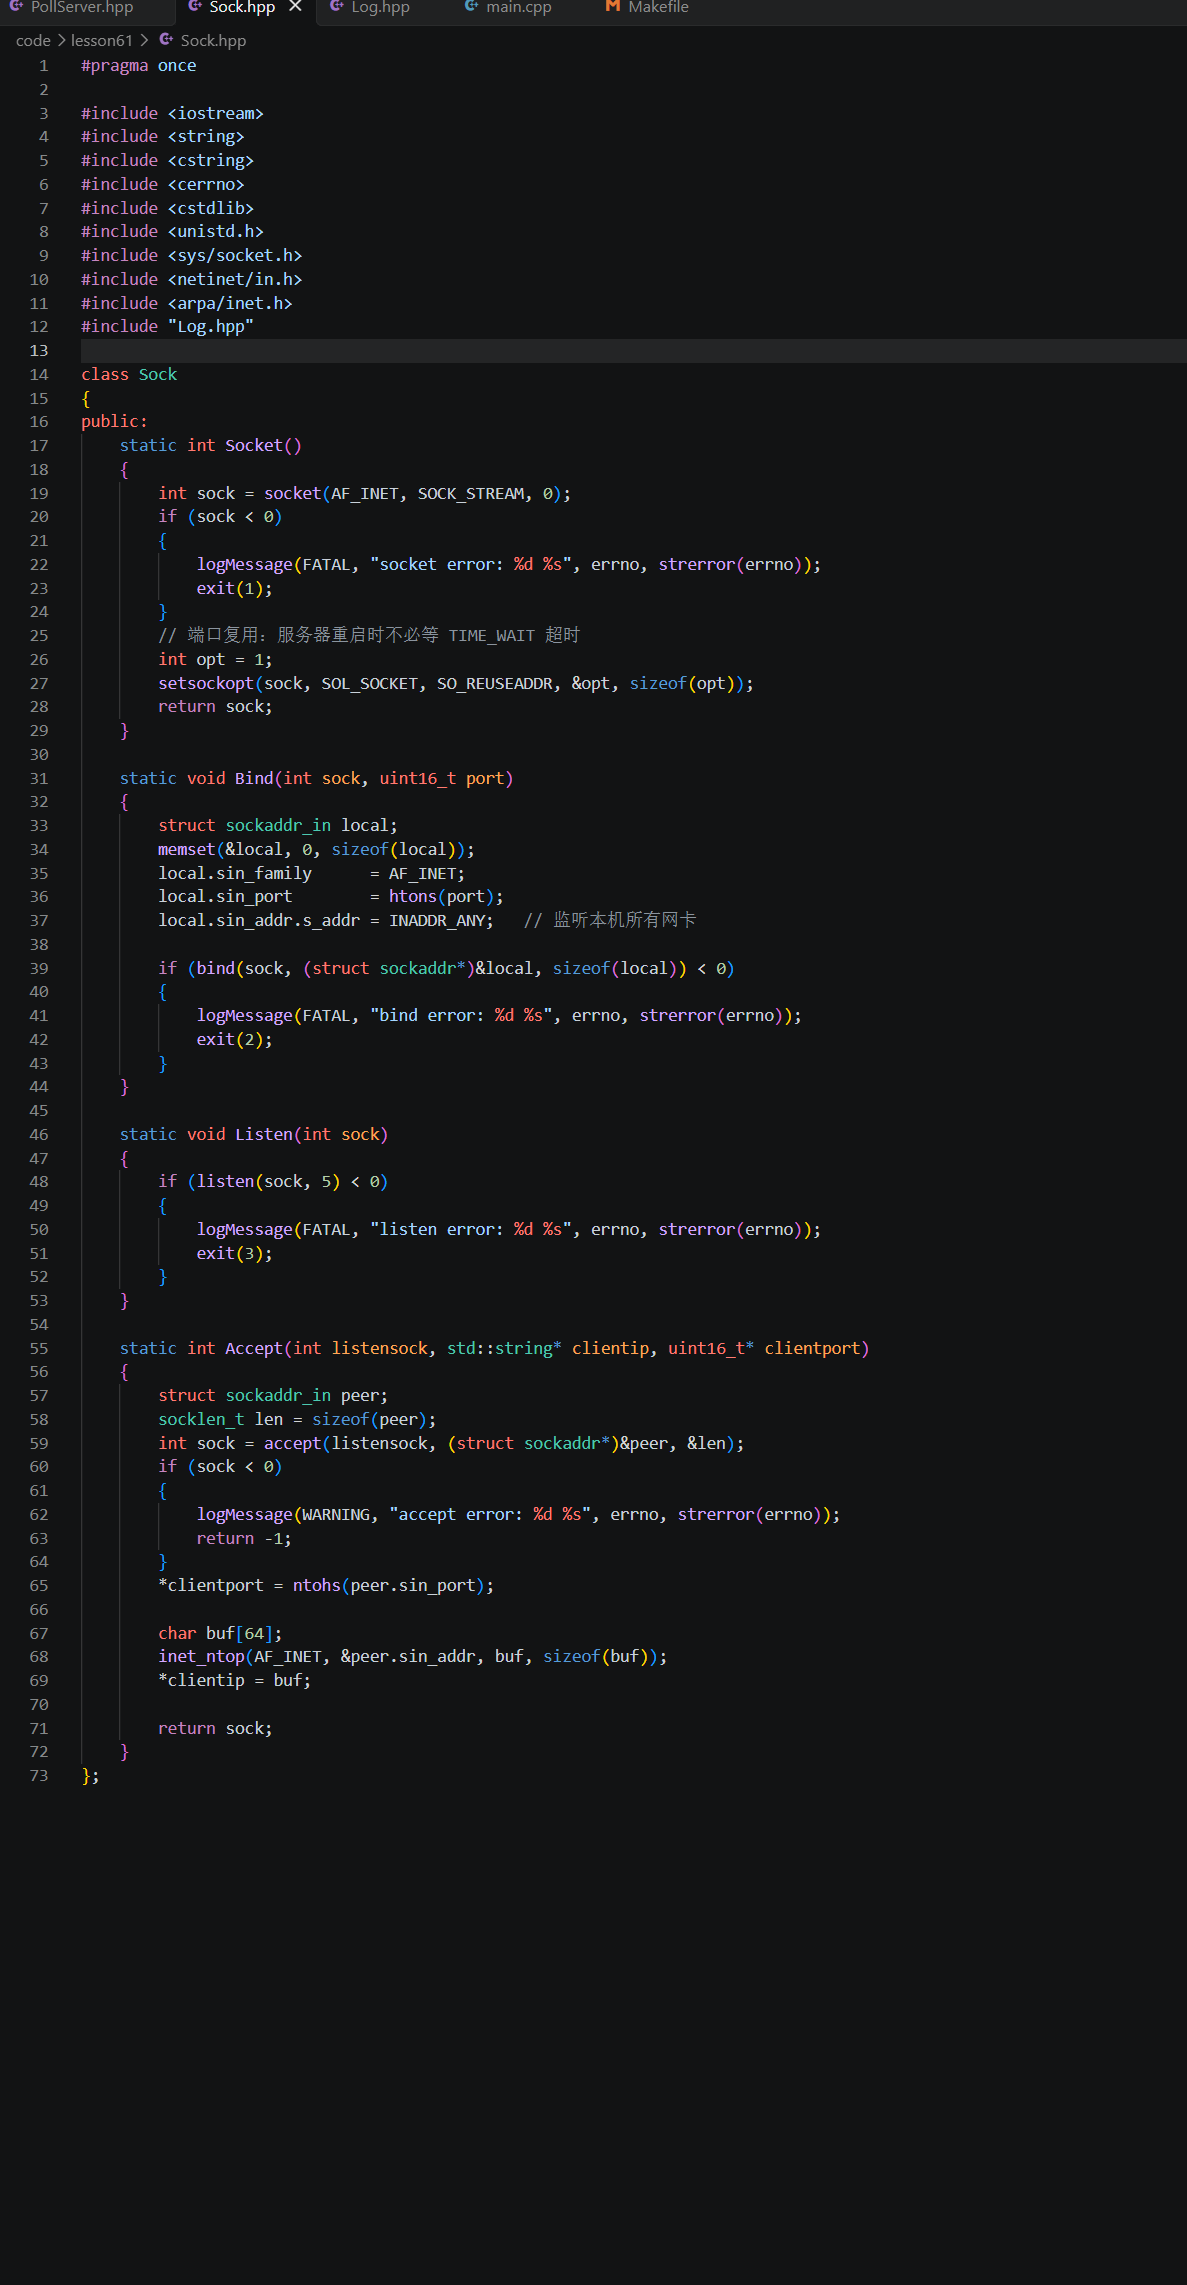
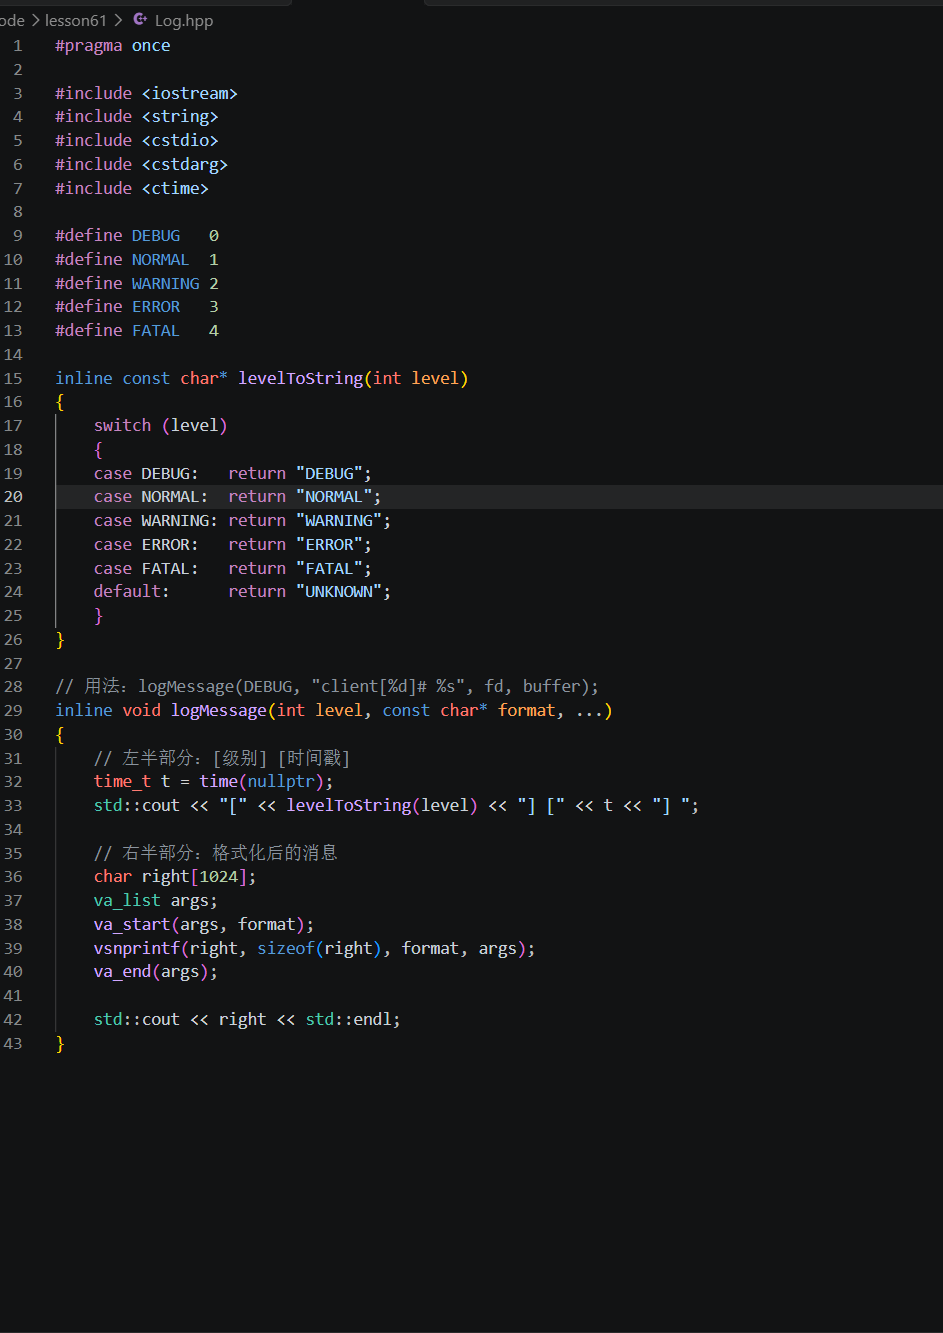
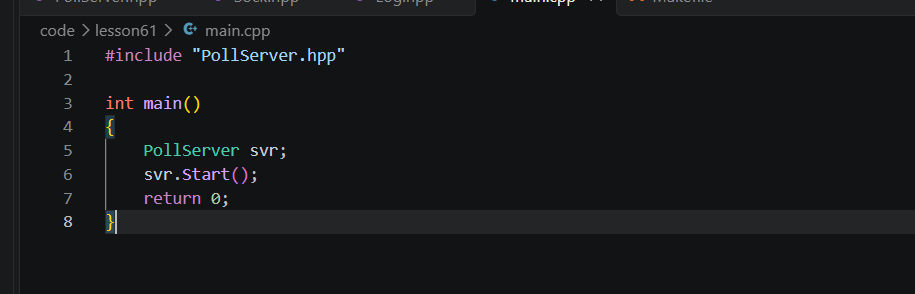
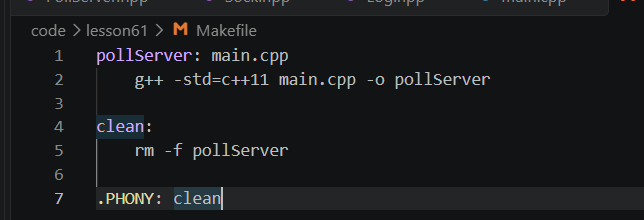
a.代码展现:
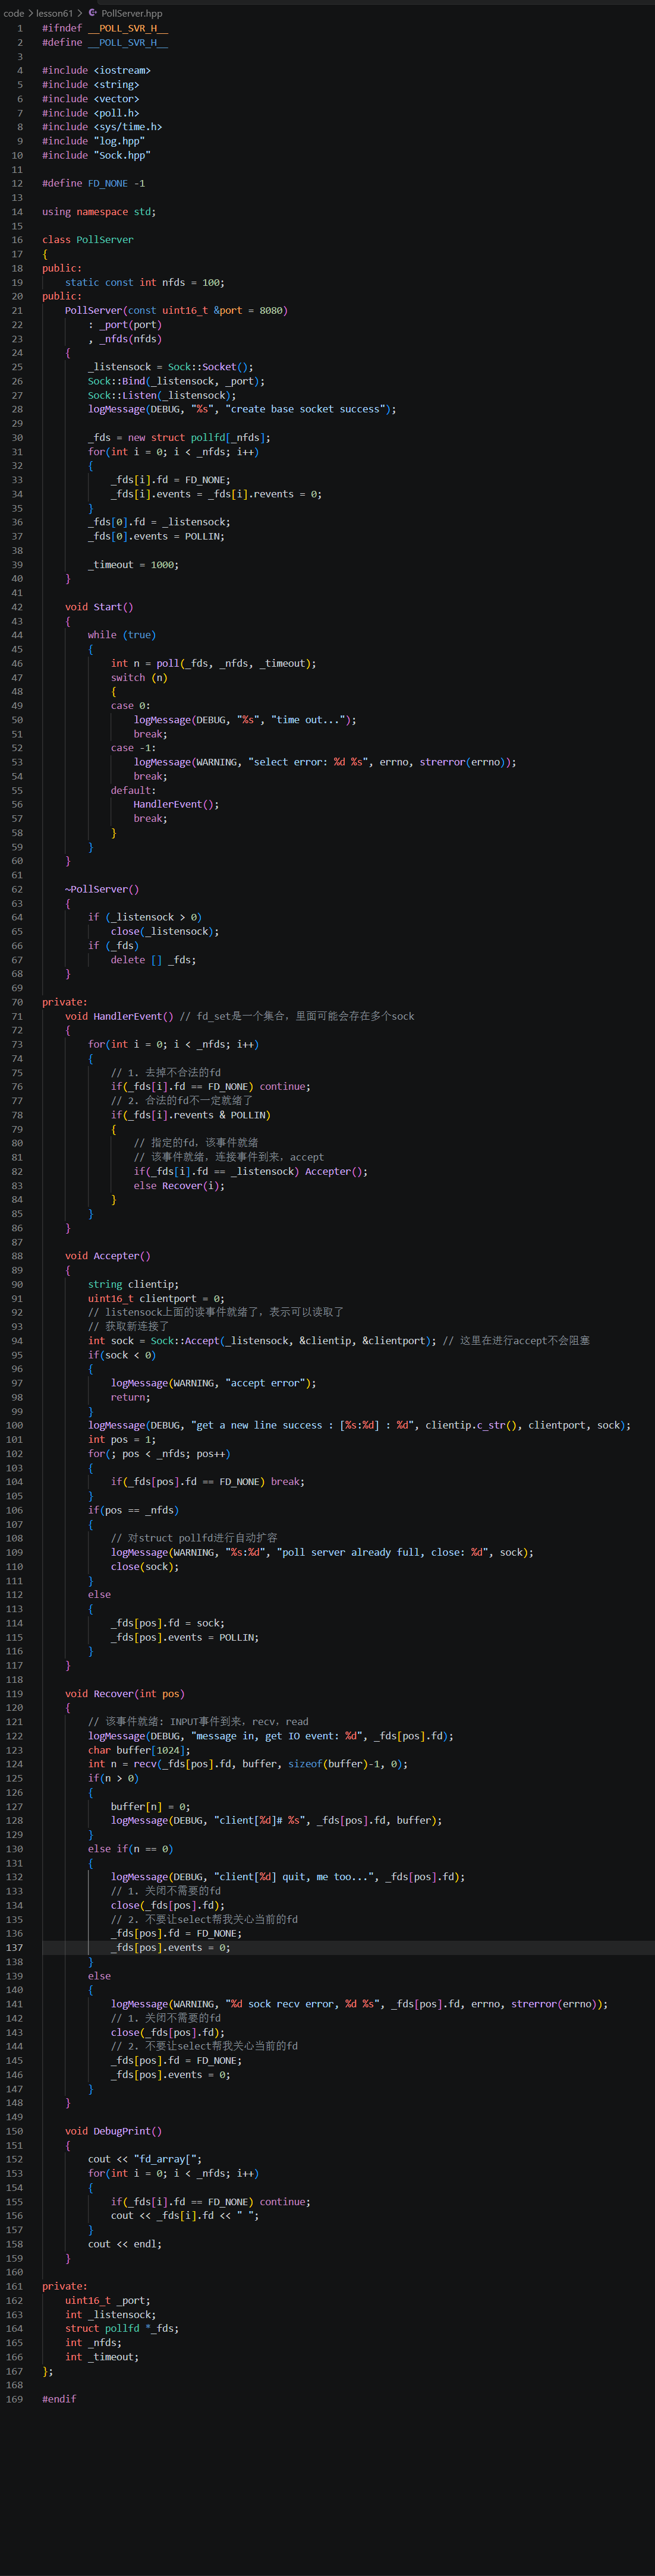
_fds 数组的大小是固定设置的,因此在将新获取连接对应的文件描述符添加到 fds 数组时,可能会因为 fds 数组已满而添加失败,这时 poll 服务器只能将刚刚获取上来的连接对应的套接字进行关闭。
(4)poll 服务器代码解析
1.四个文件的分工
main.cpp ← 入口:new 一个服务器,跑起来(2 行)
│
PollServer.hpp ← 核心:多路转接逻辑(谁有数据就处理谁)
│
├── Sock.hpp ← 工具:把 socket 那套系统调用包成好用的函数
└── log.hpp ← 工具:日志
为什么要拆成四个文件?
一句话:让"容易写错的东西"只写一次。
socket / bind / listen / accept 这四个系统调用,参数结构体长、要 memset 清零、要处理字节序、错误码还得手动查——每写一个服务器就重复一遍,还容易漏。所以把它们封装进 Sock.hpp,以后写第二个、第三个服务器,一行 Sock::Bind() 就够了。 这就是工程上说的分层:底层封装不变的部分,上层专注变化的逻辑。
2. log.hpp:先解决"看得见"的问题
新手习惯这样调试:
cout << "到这里了" << endl;
调完再删掉。问题有三个:
所以需要一个 logMessage(level, format, …),用法像 printf:
logMessage(DEBUG, "client[%d]# %s", fd, buffer);
三个设计点:
| 级别用 #define DEBUG 0 这种数字 | 将来要过滤日志(比如只看 WARNING 以上)时,数字能直接比较大小:level >= WARNING |
| 用 va_list + vsnprintf | 这是 C 实现可变参数的标准套路:va_start 开始取参 → vsnprintf 格式化 → va_end 收尾 |
| 函数声明为 inline | 定义写在头文件里,被多个 .cpp 包含时会重复定义,inline 正好解决这个问题 |
输出格式:
[DEBUG] [1716952384] create base socket success
级别 时间戳 消息
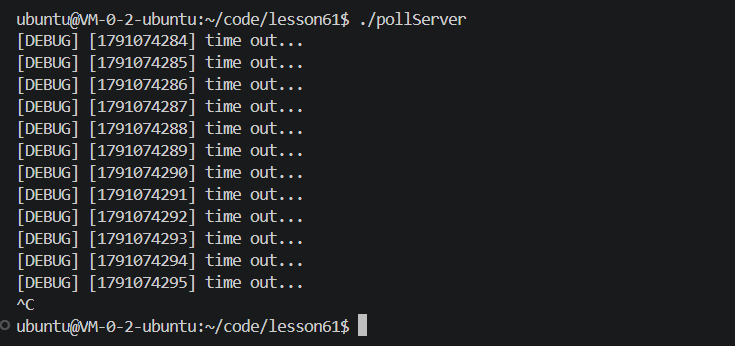
启动后每秒打印一次 time out…,说明服务器已经跑起来在正常轮询了——这是最直观的"存活证明"。
3.Sock.hpp:把系统调用封装成"只暴露正确用法"
先感受一下原始写法有多繁琐:
struct sockaddr_in local;
memset(&local, 0, sizeof(local));
local.sin_family = AF_INET;
local.sin_port = htons(port);
local.sin_addr.s_addr = INADDR_ANY;
if (bind(sock, (struct sockaddr*)&local, sizeof(local)) < 0) { /* 错误处理 */ }
封装之后:
Sock::Bind(sock, port);
四个函数各自的思路:
| Socket() | 创建套接字 | SO_REUSEADDR:不加这个,服务器重启会报 Address already in use,得等几十秒 TIME_WAIT 过去才能再启动 |
| Bind() | 绑定端口 | htons() 做字节序转换(网络序是大端,x86 是小端);INADDR_ANY 表示监听本机所有网卡 |
| Listen() | 进入"被动监听"状态 | 从此这个 fd 不再主动连别人,只等别人连它。backlog 是等待队列长度 |
| Accept() | 取出一个已完成连接 | 返回的是一个全新的 fd |
Accept() 是新手最大的坎,单独说清楚:
int listensock = Sock::Socket(); // 监听 fd:一辈子只用来 accept
int sock = Sock::Accept(listensock, &clientip, &clientport); // 连接 fd:真正用来收发数据
这是两个完全不同的 fd。 监听 fd 只负责"有人来敲门",连接 fd 才是真正通话的那条线。
打个比方:监听 fd 是前台接待,连接 fd 是会客室。前台不参与谈话,只负责把人领进会客室。
错误处理也分了级,这个区分很重要:
| Socket / Bind / Listen | exit() 终止进程 | 服务器根本起不来,继续跑没有意义 |
| Accept | 返回 -1,只记日志 | 一个连接没接上,不该让整个服务器挂掉 |
一句话原则:初始化阶段的错误要终止,运行阶段的错误要容错。
4. PollServer.hpp:核心实现
4.1 为什么需要 poll
最笨的写法:accept 到一个连接就开一个线程去处理。
问题在于:1 万个连接就是 1 万个线程,光线程栈就要吃掉几十 GB 内存,CPU 还全耗在线程切换上。
poll 的思路:不许多线程,用一个主线程盯着所有 fd,谁有数据就处理谁。
┌─ fd 5 (客户端 A) 没数据
主线程 poll ──| fd 7 (客户端 B) 有数据 <– 只处理这个
└─ fd 9 (客户端 C) 没数据
一个线程管 100 个连接,这就是 IO 多路转接——"多路"指多个连接,"转接"指转交给对应的处理函数。
4.2 pollfd 数组是理解一切的钥匙
struct pollfd {
int fd; // 要监视的文件描述符,-1 表示忽略
short events; // 【输入】我关心什么事件(POLLIN = 可读)
short revents; // 【输出】实际发生了什么事件(内核填写)
};
events 和 revents 一进一出,是 poll 最核心的设计,也是新手最容易混的地方:
_fds[i].events = POLLIN; // 我告诉内核:可读的时候通知我
// …… 调用 poll(),内核把结果填进 revents ……
if (_fds[i].revents & POLLIN) // 我检查:是不是真的可读了
为什么要拆成两个字段?
因为一次 poll 要检查 100 个 fd,不能用一个字段同时表示"我想知道"和"我知道了"——否则调用返回后,你分不清这个值是自己的请求还是内核的回复。
4.3 三个函数的职责划分
Start() ── 死循环:poll –> 按返回值分流
│ ├─ 0 :超时(timeout 到了)
│ ├─ -1 :出错
│ └─ >0 :有事件 –> HandlerEvent()
│
HandlerEvent() ── 遍历所有槽位,找出 revents & POLLIN 的
│ ├─ fd == _listensock –> Accepter() (新连接来了)
│ └─ 其他 fd –> Recover(i) (老连接发数据了)
│
Accepter() ── accept 新连接 –> 从槽位 1 开始找空位 –> 注册进去
Recover(pos) ── recv 数据 –> 按返回值分三种情况处理
HandlerEvent() 里那个 if 是整个服务器的"分岔路口":
if (_fds[i].fd == _listensock) Accepter();
else Recover(i);
能这样判断,是因为槽位 0 永远留给监听 fd(构造时写死 _fds[0].fd = _listensock)。所以"这个就绪的 fd 是监听 fd 还是客户端 fd",比较一下就行了。
4.4 固定数组 + FD_NONE 标
static const int nfds = 100; // 一共 100 个槽位
#define FD_NONE -1 // -1 表示这个槽位是空的
- 槽位 0 → 监听 fd,固定不变;
- 槽位 1~99 → 客户端连接,来一个占一个,走了就置回 -1;
- 找空位就是线性扫描:
for (pos = 1; pos < _nfds; pos++)
if (_fds[pos].fd == FD_NONE) break;
为什么不用 vector 动态增删?
因为 poll() 需要连续数组,vector 中间删元素要搬移数据,一扩容所有指针还都失效。固定数组 + 空槽标记,下标稳定,最省心。
代价是超过 100 个连接就得拒绝——这正是 Accepter() 里 pos == _nfds 那个分支干的事。
4.5 recv 的三种返回值,一个都不能漏
int n = recv(fd, buffer, sizeof(buffer) – 1, 0);
if (n > 0) // ① 收到数据,正常处理
else if (n == 0) // ② 对端关闭了连接(TCP 四次挥手)
else // ③ 出错
关键在第 ②③ 种:必须 close(fd) 并把槽位置回 FD_NONE。
假设对端断开了,你不摘掉这个 fd,会发生什么:
poll 每次都返回:fd 7 可读(对端已关闭,读永远返回 0)
↓
HandlerEvent 每次都处理 fd 7
↓
recv 返回 0,但你什么都不做
↓
下一轮 poll 又立刻返回 fd 7 可读 ……
↓
【死循环空转,CPU 100%】
这就是 fd 泄漏导致的忙等(busy loop)——写网络程序最常见的线上事故之一。
4.5 串起来:一次连接的完整生命周期
① 服务器启动
PollServer 构造 → Socket / Bind / Listen → _fds[0] = 监听 fd
↓
② 客户端连上来
poll 返回 → _fds[0].revents & POLLIN → Accepter()
→ accept 出新 fd(比如 7)→ 找到空槽位 1 → _fds[1].fd = 7
↓
③ 客户端发数据
poll 返回 → _fds[1].revents & POLLIN → Recover(1)
→ recv 读到数据 → 打印日志
↓
④ 客户端断开
poll 返回 → _fds[1].revents & POLLIN → Recover(1)
→ recv 返回 0 → close(7) → _fds[1].fd = FD_NONE 【槽位回收】
↓
⑤ 回到 ②,该槽位可被新连接复用
四个文件在这条链路里的位置:
| 启动 | Sock::Socket / Bind / Listen + logMessage |
| 新连接 | Sock::Accept + logMessage |
| 收数据 | 直接调用 recv + logMessage |
| 全程 | poll() 系统调用(PollServer 直接调) |
(5)poll 服务器测试
我们在调用 poll 函数时,将 timeout 的值设置成 1000,因此运行服务器后每隔 1000 毫秒没有客户端发来连接请求,那么服务器就会超时返回。
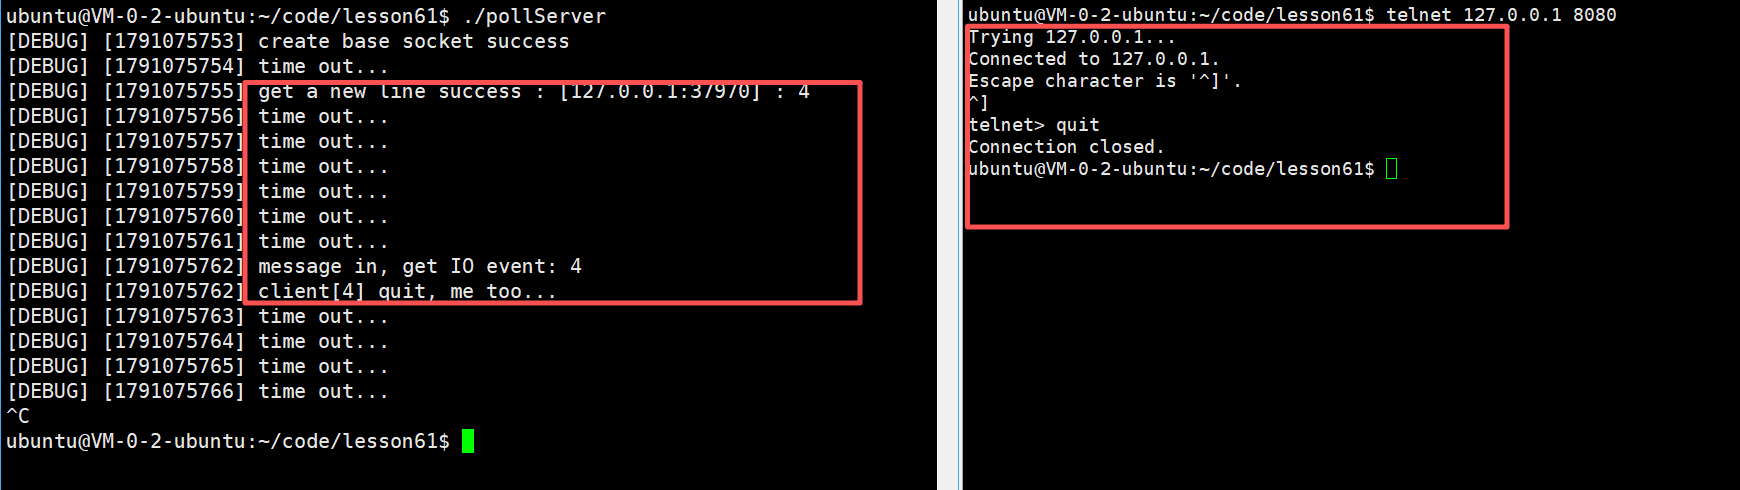
用 telnet 工具连接 poll 服务器后,poll 函数在检测到监听套接字的读事件就绪后就会调用 accept 获取建立好的连接,并打印输出客户端的 IP 和端口号等信息,此时客户端发来的数据也能成功被 poll 服务器收到并进行打印输出。
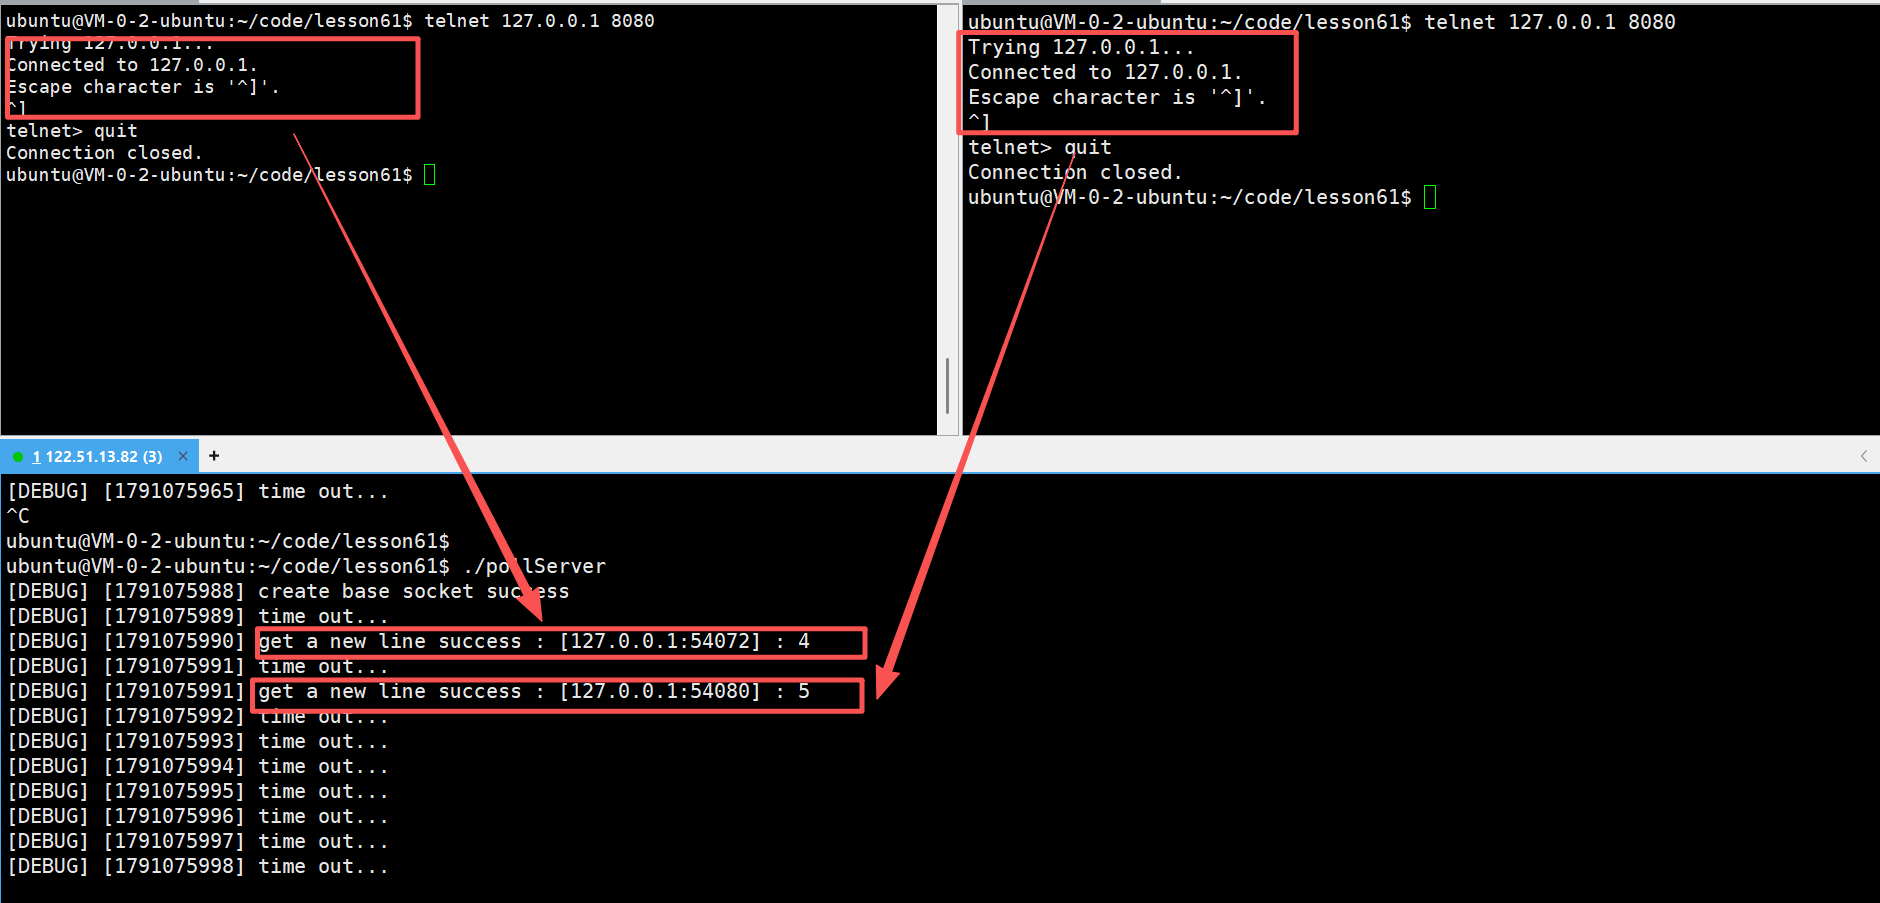
poll 服务器也是单进程、单线程服务器,同样可以为多个客户端服务。
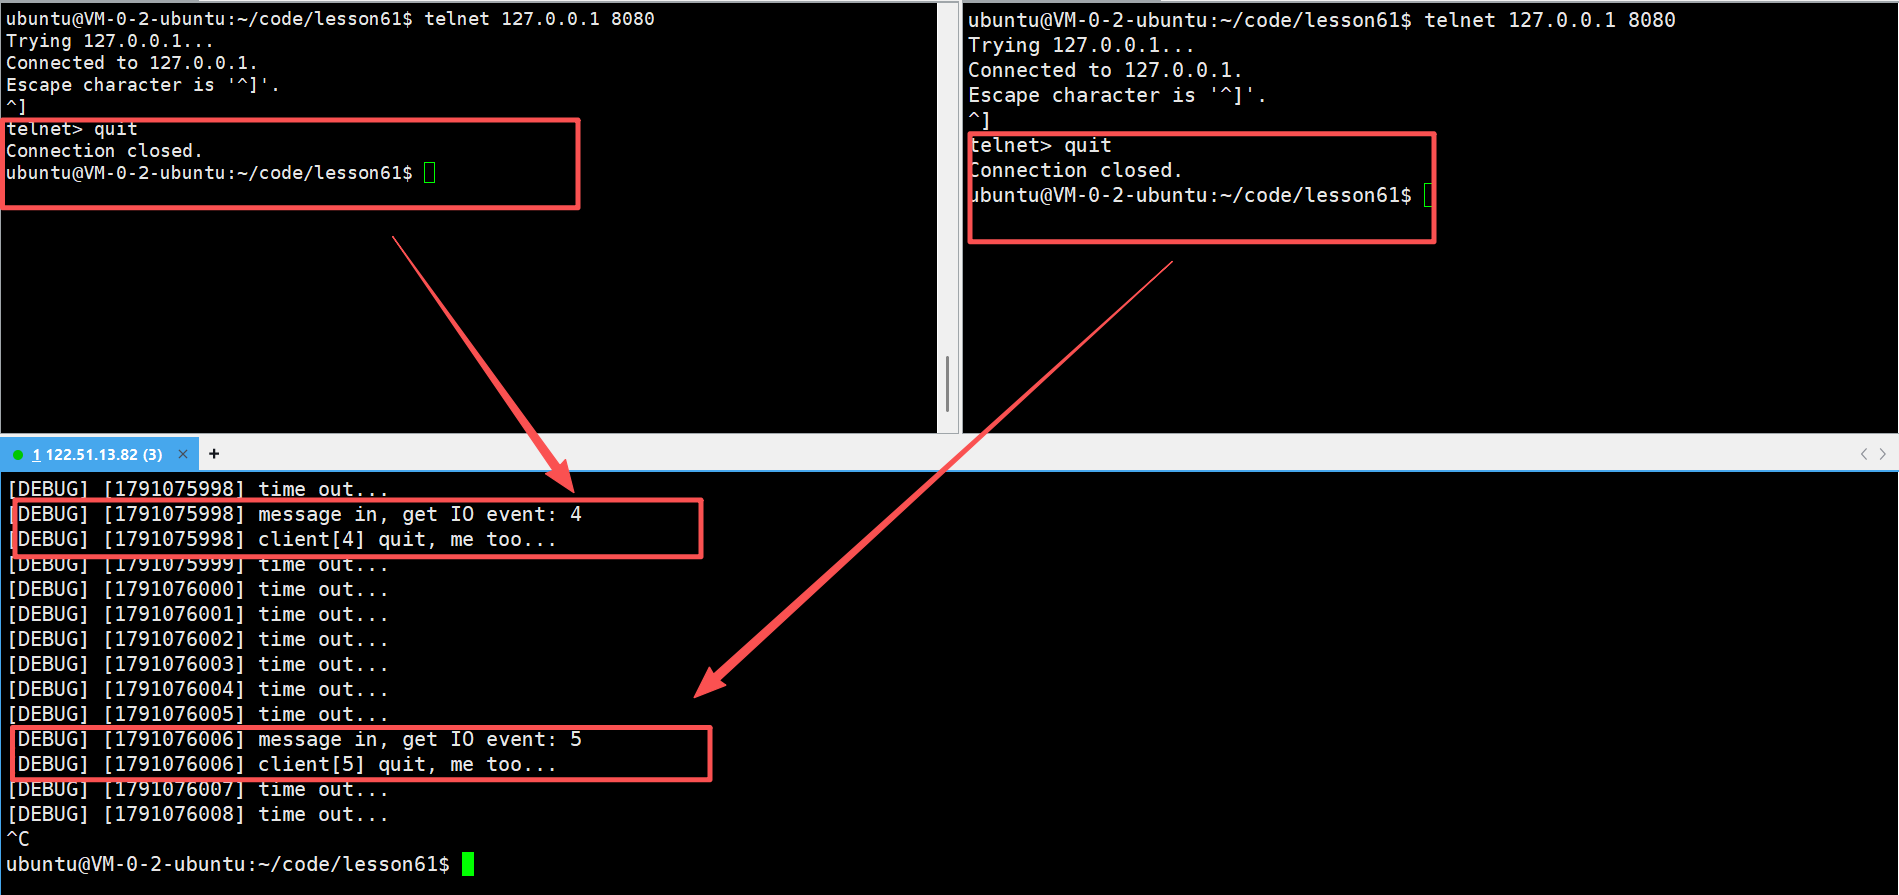
当服务器端检测到客户端退出后,也会关闭对应的连接,并将对应的套接字从 _fds 数组中清除。
(6)poll 的优点
struct pollfd 结构体将待监听事件events和就绪返回事件revents拆分为两个独立成员,把 select 的输入输出型参数分离。因此每次调用 poll 前,不需要像 select 那样重复重置监听集合,接口使用更简便。 poll 可监控的文件描述符没有固定上限(受限于内存与系统资源,数量过大性能依旧会下降)。 支持同时等待多个文件描述符,实现 IO 多路复用,提升 IO 处理效率。 适合海量连接、少量活跃连接的场景,节省资源。
说明: 代码中_fds数组虽然定义大小为 100,但数组长度可以按需扩大;poll 能监视的文件描述符数量由它第二个参数nfds决定。 反观 select 的fd_set本质是位图,默认仅 1024 bit,因此 select 最多只能监视 1024 个文件描述符。
(7)poll 的缺点
当监听的文件描述符数量很多时,存在下面几个性能问题:
二.epoll
(1)初识 epoll
按照 man 手册的说法:是为处理大批量句柄而作了改进的 poll。
epoll 是系统提供的一个多路转接接口。
- epoll 系统调用也可以让程序同时监视多个文件描述符上的事件是否就绪,与 select 和 poll 的定位是一样的,适用场景也相同。
- epoll 在命名上比 poll 多了一个 e,可以理解成是 extend,epoll 就是为了同时处理大量文件描述符而改进的 poll。
- epoll 在 2.5.44 内核中被引进,几乎具备了 select 和 poll 所有优点,它被公认为 Linux2.6 下性能最好的多路 I/O 就绪通知方法。
(2)epoll 的相关系统调用
epoll 有 3 个相关的系统调用。
A. epoll_create 函数
- 参数 size:自 Linux2.6.8 之后,size 参数会被内核忽略,但传入的值仍然必须大于 0。
- 返回值:epoll 模型创建成功时,返回对应的 epoll 文件描述符;创建失败返回 -1,同时会设置错误码。使用完毕后,必须调用 close() 关闭该文件描述符。
注意:不再使用 epoll 实例时,需要调用 close() 关闭 epoll 对应的文件描述符。当所有引用该 epoll 实例的文件描述符都关闭后,内核才会销毁 epoll 实例并释放相关资源。
B. epoll_ctl 函数
它不同于 select() 是在监听事件时告诉内核要监听什么类型的事件,而是在这里先注册要监听的事件类型。
epoll_ctl 函数参数说明
- epfd:epoll_create 的返回值,也就是 epoll 实例的句柄。
- op:代表要执行的操作,由三个宏定义。
- fd:待监视的目标文件描述符。
- event:结构体,指定要在该文件描述符上监听的事件。
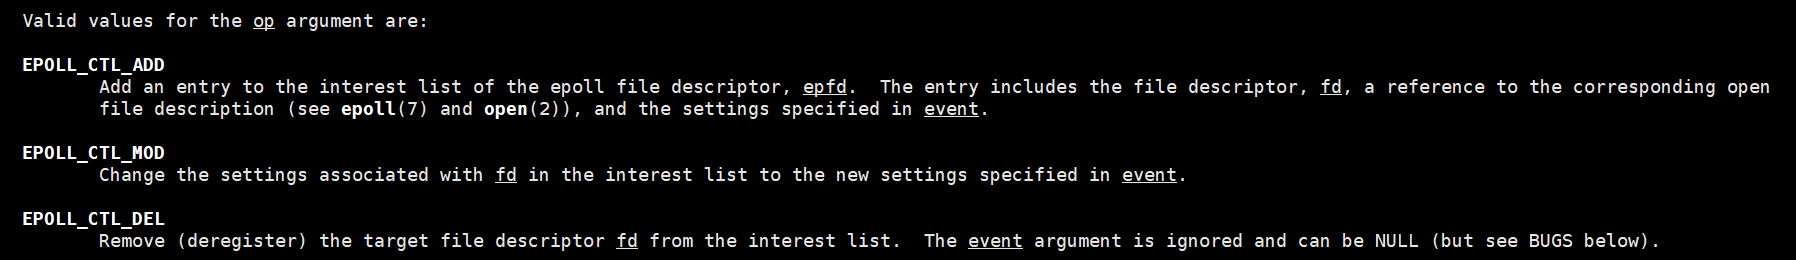
第二个参数 op 的三种取值:
- EPOLL_CTL_ADD:将新的文件描述符 fd 注册到 epfd 对应的 epoll 实例中。
- EPOLL_CTL_MOD:修改已经注册的文件描述符所监听的事件。
- EPOLL_CTL_DEL:从 epfd 的 epoll 实例中删除指定文件描述符 fd。
返回值:调用成功返回 0;调用失败返回 -1,同时会设置错误码。
第四个参数对应的 struct epoll_event 结构体:
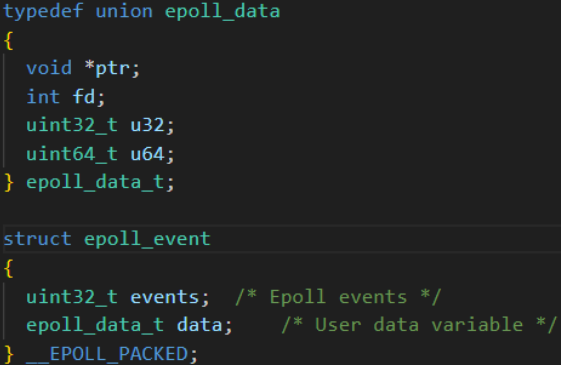
struct epoll_event 结构体说明
struct epoll_event 包含两个成员:
events 常用宏取值说明:
- EPOLLIN:对应文件描述符可读(包含对端 Socket 正常关闭的情况)。
- EPOLLOUT:对应文件描述符可写。
- EPOLLPRI:对应文件描述符有紧急数据可读,即 TCP 带外数据到达。
- EPOLLERR:对应文件描述符发生错误。
- EPOLLHUP:对应文件描述符挂断,代表对端关闭连接。
- EPOLLET:将 epoll 设置为边缘触发(Edge Triggered)模式,与水平触发(Level Triggered)相对。
- EPOLLONESHOT:事件只监听一次。事件触发完成后,如果还想继续监听该 Socket,需要重新把这个文件描述符添加到 epoll 实例中。
这些事件宏是二进制掩码,每个宏在二进制中仅有一个 bit 置 1,因此可以使用位或|叠加多个事件,使用位与&判断事件是否触发。

C. epoll_wait 函数
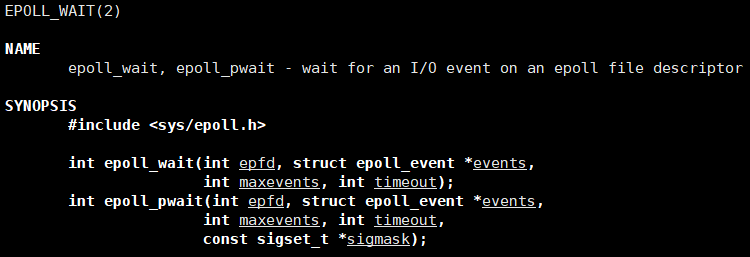
参数说明:
- epfd:epoll_create 函数的返回值(epoll 句柄),用于指定 epoll 模型。
- events:内核会将已就绪的事件拷贝到 events 数组中(不能是空指针,内核只负责将就绪事件拷贝到该数组,不会在用户态中分配内存)。
- maxevents:events 数组中的元素个数,该值不能大于创建 epoll 模型时传入的 size 值。
- timeout:表示 epoll_wait 函数的超时时间,单位是毫秒(ms),0 会立即返回,-1 是永久阻塞。
参数 timeout 的取值:
- -1:epoll_wait 调用后进行阻塞等待,直到被监视的某个文件描述符上的某个事件就绪。
- 0:epoll_wait 调用后进行非阻塞等待,无论被监视的文件描述符上的事件是否就绪,epoll_wait 检测后都会立即返回。
- 特定的时间值:epoll_wait 调用后在特定的时间内阻塞等待,若被监视的文件描述符上没有事件就绪,则在该时间后 epoll_wait 超时返回。
返回值:
- 若函数调用成功,则返回有事件就绪的文件描述符个数。
- 若 timeout 时间耗尽,则返回 0。
- 若函数调用失败,则返回 -1,同时错误码会被设置。
epoll_wait 调用失败时,错误码可能被设置为:
- EBADF:传入的 epoll 模型对应的文件描述符无效。
- EFAULT:events 指向的数组空间无法通过写入权限访问。
- EINTR:此调用被信号所中断。
- EINVAL:epfd 不是一个 epoll 模型对应的文件描述符,或传入的 maxevents 值小于等于 0。
(3)epoll 工作原理
A. 红黑树 && 就绪队列
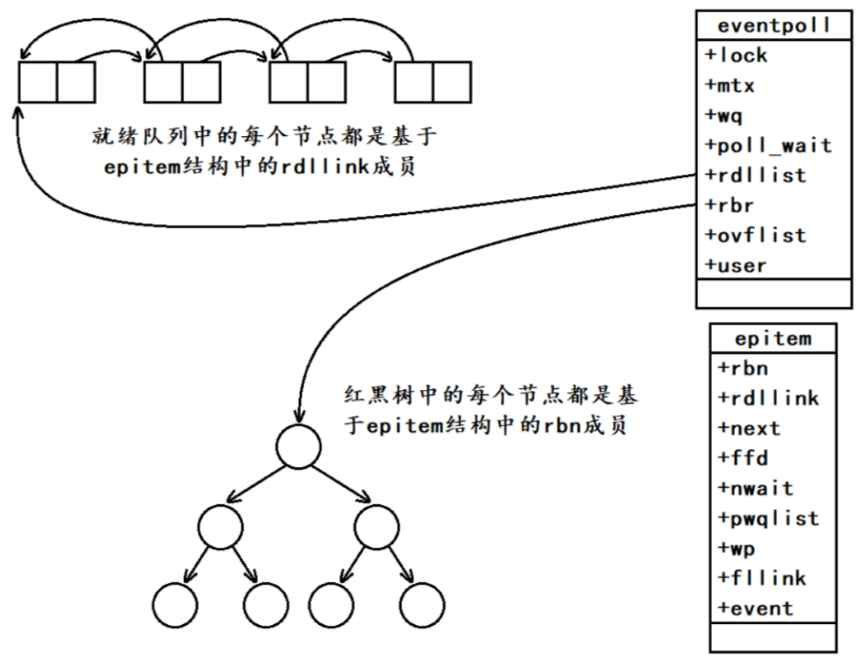
当某⼀进程调⽤epoll_create⽅法时,Linux内核会创建⼀个eventpoll结构体,这个结构体中有两个成员与epoll的使⽤⽅式密切相关.
struct eventpoll{
…
//红黑树的根节点,这棵树中存储着所有添加到epoll中的需要监视的事件
struct rb_root rbr;
//就绪队列中则存放着将要通过epoll_wait返回给用户的满足条件的事件
struct list_head rdlist;
…
}
- epoll 模型中的红黑树本质就是告诉内核,需要监视哪些文件描述符上的哪些事件,调用 epll_ctl 函数就是在对这颗红黑树进行增删改操作。
- epoll 模型中的就绪队列本质就是告诉内核,哪些文件描述符上的哪些事件已就绪,调用 epoll_wait 函数就是从就绪队列中获取已就绪的事件。
在 epoll 中,对于每一个事件都有一个对应的 epitem 结构体,红黑树和就绪队列中的节点分别是基于 epitem 结构中的 rbn 成员和 rdllink 成员的,epitem 结构中的成员 ffd 记录的是指定的文件描述符值,event 成员记录的就是该文件描述符对应的事件。
struct epitem{
struct rb_node rbn; //红黑树节点
struct list_head rdllink; //双向链表节点
struct epoll_filefd ffd; //事件句柄信息
struct eventpoll *ep; //指向其所属的eventpoll对象
struct epoll_event event; //期待发生的事件类型
}
- 对于 epitem 结构中 rbn 成员而言,ffd 与 event 的含义是:需要监视 ffd 上的 event 事件是否就绪。
- 对于 epitem 结构中的 rdlink 成员而言,ffd 与 event 的含义是:ffd 上的 event 事件已就绪。
注意事项:
epoll 内部使用红黑树管理所有待监听的文件描述符,红黑树属于二叉搜索树,需要键值key,文件描述符 fd 可以直接作为红黑树的key。
调用epoll_ctl向红黑树新增节点时:
- 如果设置了EPOLLONESHOT选项:事件触发并处理完成后,内核会自动把该 fd 从红黑树中移除。如果后续还想继续监听该文件描述符,需要重新调用epoll_ctl将其添加进 epoll 模型。
- 如果新增节点没有设置EPOLLONESHOT:节点插入红黑树后会一直保留,除非用户主动调用epoll_ctl(EPOLL_CTL_DEL)手动删除该节点EPOLLONESHOT作用:保证一个 socket 连接在任一时刻只被一个线程处理,避免多线程并发处理同一个连接引发的竞态问题。
B. 回调机制
所有添加到红黑树里的监听事件,都会和网卡等设备驱动注册回调函数,在内核中这个回调函数名为 ep_poll_callback。
- 对于 select 和 poll:操作系统在监听多个文件描述符时,需要主动轮询所有 fd,逐个检查事件是否就绪,这会加重系统开销。
- 对于 epoll:操作系统不需要主动轮询检测文件描述符。当红黑树中监听的事件就绪时,内核会自动触发对应的回调函数,将就绪事件加入就绪队列。
- 用户调用 epoll_wait 获取就绪事件时,只需要判断就绪队列是否为空;队列非空,则直接将就绪队列中的事件拷贝到用户空间。
- 回调机制最大优势:内核不再主动轮询全部 fd,事件就绪时由硬件驱动主动触发回调。
注意:
- 只有已经添加到红黑树中的事件,才会注册底层回调。也只有这些事件就绪时,才会执行回调并放入就绪队列。
- 事件不断就绪时,回调持续向就绪队列插入节点;上层业务不断调用 epoll_wait 取出节点,这是典型的生产者 – 消费者模型。
- 就绪队列会被多个执行流并发访问,因此需要互斥锁保护临界资源。eventpoll 结构体中的 lock、mtx 就是用来加锁保护,所以 epoll 本身是线程安全的。 eventpoll 中的 wq(wait queue,等待队列):当多个执行流想要操作同一个 epoll 实例时,会在这个等待队列上阻塞等待。
- 生产者:设备驱动回调函数,往就绪队列放就绪事件;
-
消费者:用户态调用 epoll_wait,从就绪队列取出事件。
(4)代码示例


代码上的变化
- 删掉(内核接管了):FD_NONE 空槽标记、找空位的循环、数组满拒绝连接、遍历 100 个槽位。
- 新增(跟内核打交道):epoll_create() 建模型、epoll_ctl(ADD) 登记 fd、epoll_ctl(DEL) 摘除。
// poll:遍历全部 100 个槽位
void HandlerEvent() {
for(int i = 0; i < _nfds; i++) {
if(_fds[i].fd == FD_NONE) continue;
if(_fds[i].revents & POLLIN) { /* 处理 */ }
}
}
// epoll:只遍历就绪的 n 个
void HandlerEvent(int n) {
for(int i = 0; i < n; i++) {
int fd = _revs[i].data.fd;
if(_revs[i].events & EPOLLIN) { /* 处理 */ }
}
}
// poll:自己找空槽位,满了只能拒绝
for(pos = 1; pos < _nfds; pos++)
if(_fds[pos].fd == FD_NONE) break;
if(pos == _nfds) close(sock);
else { _fds[pos].fd = sock; _fds[pos].events = POLLIN; }
// epoll:交给内核
struct epoll_event ev;
ev.events = EPOLLIN;
ev.data.fd = sock;
epoll_ctl(_epfd, EPOLL_CTL_ADD, sock, &ev);
两个坑
- EPOLL_CTL_DEL 要在 close() 之前——否则 fd 号被复用时会误删新连接
- EPOLLERR / EPOLLHUP 必须处理——不处理会 epoll_wait 空转,CPU 100%
(5)epoll 服务器测试
我们在编写 epoll 服务器在调用 epoll_wait 函数时,将 timeout 的值设置成了 -1,因此运行服务器后若没有客户端发来连接请求,那么服务器就会调用 epoll_wait 函数后阻塞等待。

接下来我们使用 telnet 工具连接 epoll 服务器后,epoll 服务器调用的 epoll_wait 函数在检测到监听套接字的读事件就绪后就会调用 accept 获取建立好的连接,并打印输出客户端的 IP 和端口号,此时客户端发来的数据也能成功被 epoll 服务器收到并进行打印输出。 
该 epoll 服务器同样为单进程、单线程服务器,但可以为多个客户端提供服务。当服务器端检测到客户端退出后,也会关闭对应连接,此时 epoll 服务器对应的 5 号和 6 号文件描述符就关闭了。

使用 ls /proc/PID/fd 命令,查看当前epoll服务器的文件描述符的使用情况。文件描述符 0、1、2 是默认打开的,分别对应的是标准输入、标准输出和标准错误,3 号文件描述符对应的是监听套接字,4 号文件描述符对应 epoll 句柄,5 号和 6 号文件描述符分别对应访问服务器的两个客户端。

(6)epoll 的优点(和 select 的缺点对应)
误区纠正: 很多网络博客提到 epoll 使用 mmap 内存映射,让用户态直接访问内核就绪队列,消除数据拷贝开销。这个说法是错误的。出于操作系统安全隔离设计,内核不会把内核空间数据直接暴露给用户进程,不存在这种内存映射。我们代码里定义的 struct epoll_event 是在用户空间分配的内存,获取就绪事件时,内核依然需要把就绪事件数据拷贝到用户提供的这块内存。
与 select 和 poll 的不同之处
- 使用 select 和 poll 时,需要用户自己维护一个外部数组,用来记录所有待监听的文件描述符及其对应的事件,文件描述符的增、删、改逻辑都要由用户代码手动实现。
- 而使用 epoll 时,无需用户维护外部数组。epoll 底层的红黑树承担了这个存储作用,红黑树上节点的增删改操作全部由内核完成;用户只需要调用 epoll_ctl,通知内核执行对应的添加、修改、删除监视事件操作即可。
- 多路转接接口的数据交互分为两个方向:一是用户向内核传递需要监听哪些文件描述符与事件;二是内核向用户返回哪些文件描述符已经就绪。 select 和 poll 将这两类交互逻辑合并在同一个系统调用里完成。epoll 在接口设计上把两者解耦:调用 epoll_ctl 实现用户告知内核需要监听的事件;调用 epoll_wait 实现内核向用户返回就绪事件。
(7)epoll 的工作方式
epoll 有 2 种工作方式:水平触发(LT)和边缘触发(ET)。
a. 水平触发 Level Triggered 工作模式
- 只要底层有事件就绪,epoll 就会一直通知用户。
- 类似于数字电路中的高电平触发一样,只要一直处于高电平,则会一直触发。

epoll 默认采用 LT(水平触发)工作模式。
- 在 LT 模式下,只要文件描述符上还有未处理的就绪事件,epoll 就会持续向用户通知该事件。因此当 epoll 捕获到读事件就绪时,可以不用一次性处理完全部数据,或者只读取一部分数据;只要缓冲区还有残留数据未读完,下一次调用 epoll_wait 依旧会再次上报这个就绪事件。
- select、poll 本身就属于水平触发(LT)模式。
- LT 模式同时支持阻塞 IO 和非阻塞 IO。
b. 边缘触发 Edge Triggered 工作模式
如果在第 1 步将 socket 添加到 epoll 描述符的时候使用了 EPOLLET 标志,epoll 进入 ET 工作模式。
- 只有底层就绪事件数量由无到有或由有到多发生变化的时候,epoll 才会通知用户。
- 类似于数字电路中的上升沿触发一样,只有当电平由低变高的那一瞬间才会触发。

若要将 epoll 设置为 ET(边沿触发)工作模式,需要在调用 epoll_ctl 添加监听事件时,额外带上 EPOLLET 标志。
- 在 ET 模式下,只有当底层就绪事件从无到有、或者就绪事件变多的瞬间,epoll 才会向用户上报一次事件。所以当 epoll 捕获到读事件就绪时,必须立刻把缓冲区数据一次性全部读完。因为如果本次没有读完,后续没有新数据到来时,epoll 将不会再次触发事件通知,残留的数据会一直留在缓冲区,造成数据丢失。
- ET 模式下事件通知的次数远少于 LT,并且每次事件到来都会完整处理完缓冲区所有数据,减少了系统调用次数,以此提升网络吞吐量。所以 ET 的性能通常优于 LT,Nginx 内部 epoll 默认就使用 ET 模式。
- 只支持非阻塞的读写。
select 和 poll 其实也是工作在 LT 模式下, epoll 既可以支持 LT, 也可以支持 ET。
c. ET 工作模式下如何进行读写
因为在 ET 工作模式下,只有底层就绪事件无到有或由有到多发生变化的时候才会通知用户,这就倒逼用户当读事件就绪时必须一次性将数据全部读取完毕,当写事件就绪时必须一次性将发送缓冲区写满,否则可能再也没有机会进行读写了
因此读数据时必须循环调用 recv 函数进行读取,写数据时也必须循环调用 send 函数进行写入。
注意:在ET 工作模式下,recv 和 send 操作的文件描述符必须设置为非阻塞状态,这是必须的,不是可选的。
d. 对比 LT 和 ET
- LT 是 epoll 的默认行为。使用 ET 能够减少 epoll 触发的次数,但是需要在一次响应就绪过程中就把所有的数据都处理完。应用层尽快的取走了缓冲区中的数据,那么在单位时间内,该模式下工作的服务器就可以在一定程度上给发送方发送一个更大的接收窗口,所以对方就有更大的滑动窗口,一次向我们发送更多的数据,从而提高了 IO 吞吐。
- 在 ET 模式下,一个文件描述符就绪之后,用户不会反复收到通知,看起来比 LT 更高效,但若在 LT 模式下能够做到每次都将就绪的文件描述符立即全部处理,不让操作系统反复通知用户的话,其实 LT 和 ET 的性能也是一样的。
- ET 的编程难度比 LT 更高。
e. 理解 ET 模式和非阻塞文件描述符
使用 ET 模式的 epoll 需要将文件描述设置为非阻塞。这个不是接口上的要求,而是 “工程实践” 上的要求。
假设这样的场景:服务器接受到一个 10k 的请求,会向客户端返回一个应答数据。如果客户端收不到应答,不会发送第二个 10k 请求。

如果服务端写的代码是阻塞式的 read,并且一次只 read 1k 数据的话(read 不能保证一次就把所有的数据都读出来,参考 man 手册的说明,可能被信号打断),剩下的 9k 数据就会待在缓冲区中。

此时由于 epoll 是 ET 模式,并不会认为文件描述符读就绪,epoll_wait 就不会再次返回,剩下的 9k 数据会一直在缓冲区中,直到下一次客户端再给服务器写数据,epoll_wait 才能返回。
但是,服务器只读到 1k 个数据,要 10k 读完才会给客户端返回响应数据。客户端要读到服务器的响应,才会发送下一个请求。客户端发送了下一个请求,epoll_wait 才会返回,才能去读缓冲区中剩余的数据。

因此,为了解决上述问题(阻塞 read 不一定能一下把完整的请求读完),于是就可以使用非阻塞轮询的方式来读缓冲区,保证一定能把完整的请求都读出来,而如果是 LT 没这个问题。只要缓冲区中的数据没读完,就能够让 epoll_wait 返回文件描述符读就绪。
(8)epoll 的使用场景
- epoll 的高性能并不是万能的,它只在特定场景下才能发挥优势;如果场景选择不当,epoll 的性能反而会变差。
- epoll 适合大量连接,但只有少量连接处于活跃状态的场景。典型例子:需要同时维护上万客户端连接的互联网入口服务器。这类服务器绝大多数连接大部分时间处于空闲,只有少部分连接会收发数据,正好契合 epoll 的事件通知机制,能够极大减少无效遍历开销。
- 反过来,如果是服务之间内网通信,连接数量很少(仅几个连接),此时使用 epoll 并不划算。因为 epoll 本身存在创建、管理事件的额外开销,少量连接场景下 select/poll 的开销更低。IO 多路复用模型的选型,需要结合业务的连接数量、连接活跃比例综合判断。
(9)epoll 中的惊群问题(了解)
可参考:epoll惊群效应解析-CSDN博客