WebGPU Storage Buffer 与 Uniform Buffer 权衡
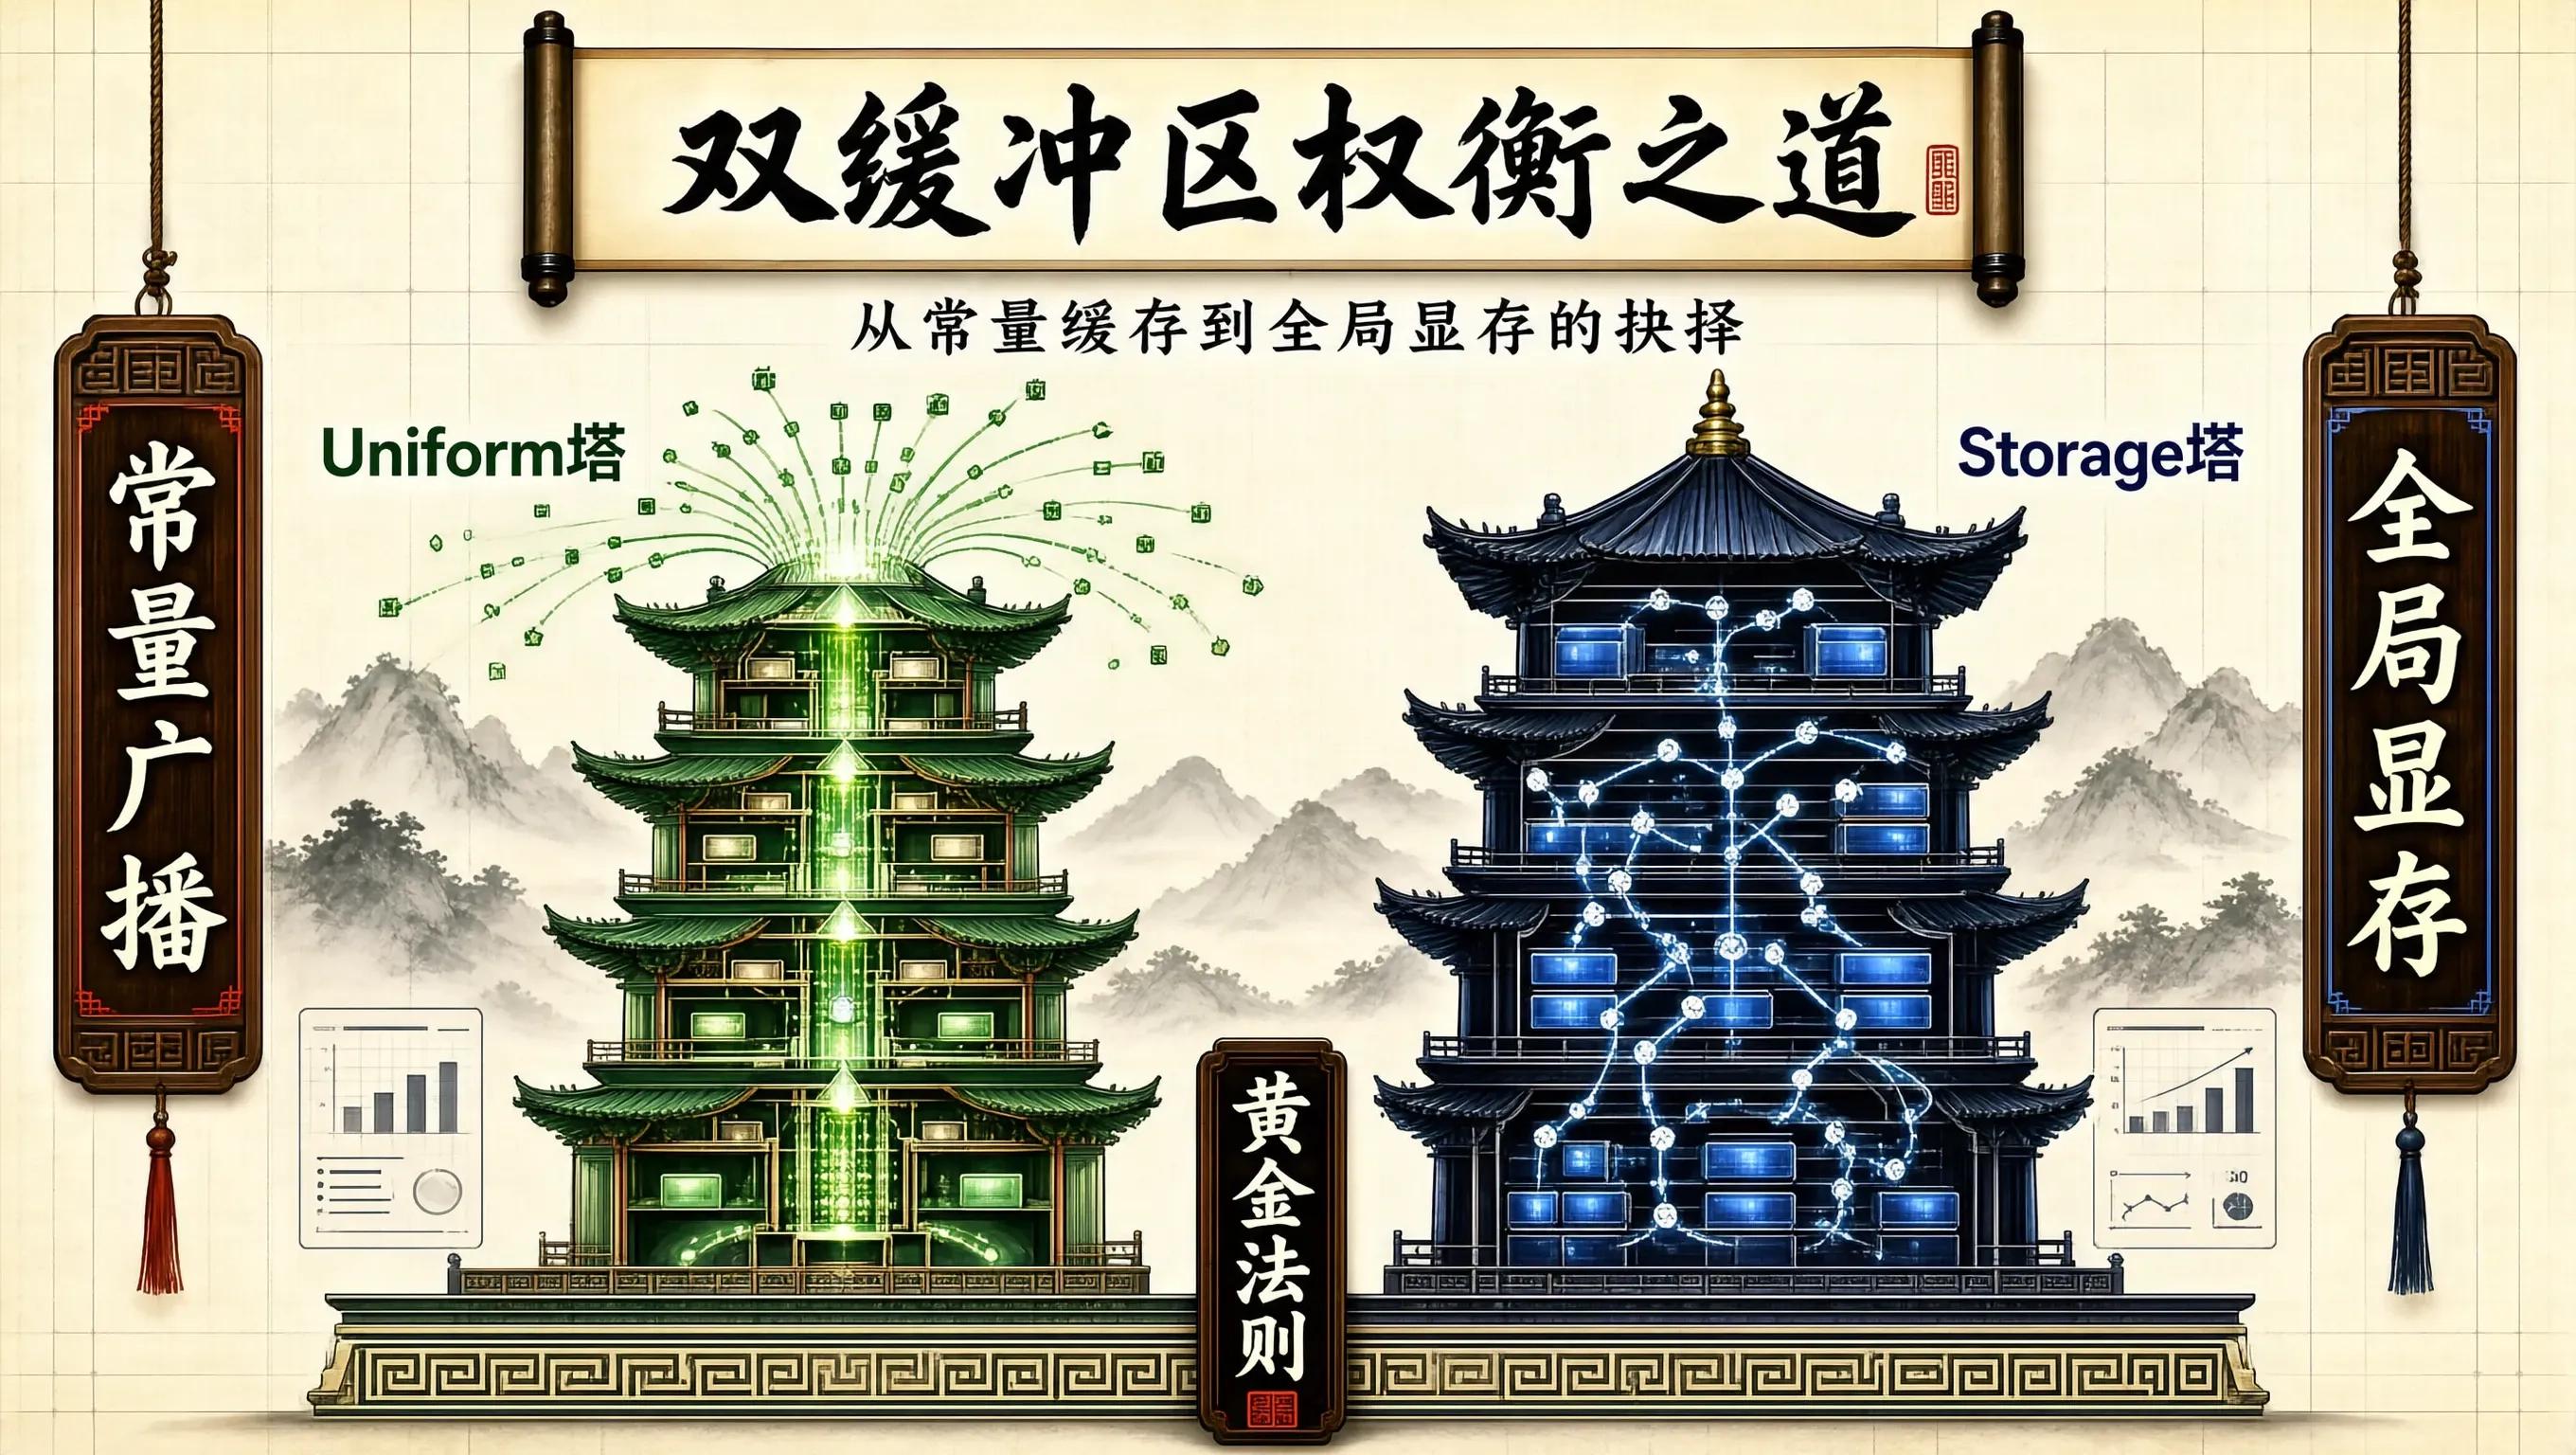
在 WebGPU 渲染与通用计算管线设计中,将数据从 JavaScript 内存送入着色器(WGSL)的核心载体是缓冲区(Buffer)。而在创建绑定组(BindGroup)时,我们面临的最基础也是最重要的架构选型之一,就是数据究竟该封装为 Uniform Buffer 还是 Storage Buffer?
很多初学者容易根据名字直觉来选:以为“参数就用 Uniform,大数据就用 Storage”。但在底层显卡硬件架构与驱动实现中,这两类缓冲区在内存寻址模式、硬件缓存层级(L1/L2 Cache)、读写权限以及尺寸限制上存在巨大的物理鸿沟。
选错缓冲区类型,轻则着色器抛出尺寸超限崩溃,重则导致 GPU 计算单元发生严重的显存访问争用与指令停顿。
核心物理特性与规格对比
| 硬件缓存位置 | GPU 常量内存 / 高速只读常量缓存 (Constant Cache) | 全局显存 (VRAM / Global Memory) |
| 访问权限 | 仅只读(Read-Only) | 可读可写(Read-Write)(计算管线)或只读 |
| 最大容量限制 | 默认 64 KB(maxUniformBufferBindingSize) | 默认 128 MB ~ 2 GB(maxStorageBufferBindingSize) |
| 访存模式 | 适合所有计算单元并发读取同一地址(广播式访问) | 适合动态索引、随机访存或不同线程读取不同元素 |
| 字节对齐要求 | 极严格(16 字节对齐,且偏移必须是 256 字节整数倍) | 较宽松(通常 4 或 8 字节对齐) |
深度权衡场景分析
1. 为什么 Uniform Buffer 限制在 64 KB?
Uniform Buffer 在硬件层通常映射到 GPU 每个流式多处理器(SM / Compute Unit)自带的专用常量缓存(Constant Cache)。
- 当一个工作组(Workgroup)中的所有线程同时读取同一个变量(如摄像机投影矩阵 cameraMatrix 或时间戳 time)时,常量缓存可以通过硬件单周期“广播(Broadcast)”给所有核心,延迟极低(接近寄存器速度);
- 但这种常量缓存容量极其有限,因此 WebGPU 规范保守地将默认上限设为 64 KB。如果你试图将一个包含数千个粒子位置的数组放进 Uniform,设备直接会在创建管线时拒绝。
2. Storage Buffer 的强大与开销
Storage Buffer 直接驻留在 GPU 的全局显存(Global VRAM)中。
- 它的尺寸可以达到数百兆甚至数吉字节,支持动态大小数组(array<f32>)和原地原子读写操作(atomic<u32>);
- 但代价是:如果访问模式杂乱无章,没有利用好局部性(Spatial Locality),会频繁触发显存 L2 缓存未命中,导致计算单元在等待内存返回数据时空转。
// WGSL 着色器中的两种绑定形态
struct FrameGlobalUniforms {
viewProjMatrix: mat4x4<f32>,
cameraPosition: vec3<f32>,
ambientLightColor: vec3<f32>,
time: f32,
};
struct ParticleData {
position: vec3<f32>,
velocity: vec3<f32>,
life: f32,
};
// 1. 全局低频常量:使用 Uniform Buffer (高速常量广播)
@group(0) @binding(0) var<uniform> globalUniforms: FrameGlobalUniforms;
// 2. 海量粒子实例数据:使用 Storage Buffer (大容量读写)
@group(0) @binding(1) var<storage, read_write> particles: array<ParticleData>;
TypeScript 前端创建与绑定实战
在前端装配 WebGPU 管线时,必须在 createBindGroupLayout 中显式指定 buffer 类型:
export function setupPipelineLayout(device: GPUDevice): GPUPipelineLayout {
const bindGroupLayout = device.createBindGroupLayout({
entries: [
// 0 号槽位:Uniform Buffer
{
binding: 0,
visibility: GPUShaderStage.VERTEX | GPUShaderStage.FRAGMENT | GPUShaderStage.COMPUTE,
buffer: {
type: 'uniform',
hasDynamicOffset: false,
minBindingSize: 80, // FrameGlobalUniforms 占用的字节数
},
},
// 1 号槽位:Storage Buffer (可读写)
{
binding: 1,
visibility: GPUShaderStage.COMPUTE,
buffer: {
type: 'storage', // 或 'read-only-storage'
hasDynamicOffset: false,
},
},
],
});
return device.createPipelineLayout({
bindGroupLayouts: [bindGroupLayout],
});
}
黄金选型法则(Decision Framework)
在做前端图形与端侧计算架构时,请遵循以下三条黄金准则:
深入理解显卡硬件的访存路径,才能在 WebGPU 的广阔天地中写出兼具优雅与极限性能的着色器代码。