别让模型只会猜:用向量符号代数拆解 ARC 的抽象推理
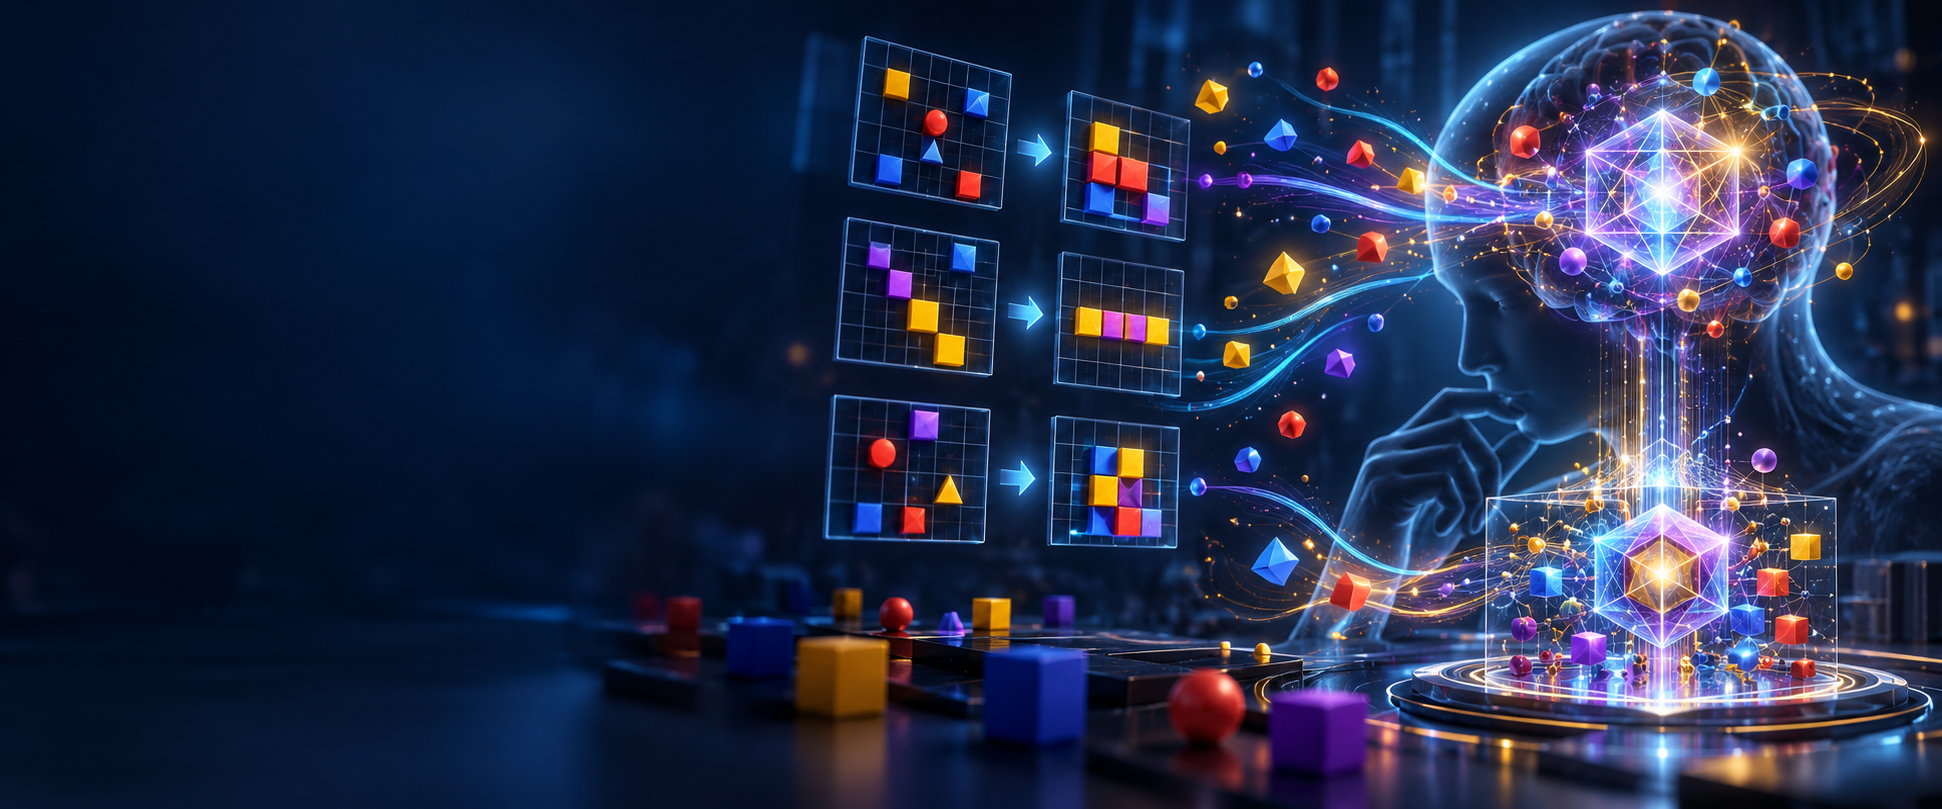
我一直觉得,判断一个 AI 是否真正具备推理能力,不能只看它会不会把一张图片分类成猫、狗或汽车。更尖锐的问题是:给它几组极少的输入—输出示例,规则不写出来,也没有海量同类数据,它能不能自己发现“哪些东西算对象”“变化发生在什么层面”“下一步应该执行哪条规则”?
抽象与推理语料库(ARC)之所以难,正是因为它把问题压缩成了这种极少样本的视觉程序学习。每道题通常只有几组彩色网格示例,系统必须从中归纳一个转换程序,再把程序应用到新的网格。颜色、位置、形状、数量、对称、移动和组合关系都可能成为规则的一部分;而且下一道题往往不会重复上一道题的表面形式。
我从向量符号代数(Vector Symbolic Algebra, VSA)的思路里看到一条很有吸引力的路线:不要让神经网络直接从像素跳到答案,而是先把网格拆成对象,再把对象的颜色、中心和形状编码成高维向量,用向量绑定和捆绑表达组合关系,最后让符号搜索与神经学习共同合成一段可检查的程序。
一,ARC 的难点不是看图,而是发现“什么值得看”
普通图像识别通常假设任务定义已经给出:输入是一张图,输出是类别;训练集越大,模型越容易学习稳定的统计规律。ARC 则故意拿走了这些便利。它不给出类别名,不告诉我们哪些像素属于同一个对象,也不规定输出网格必须与输入同样大小。
我会把 ARC 的难点拆成四层:第一层是尺寸,输出网格可能保持不变、变成固定大小,或者由输