如果有人告诉你,世界上有一个AI模型,它不会聊天、不会写文章、不会生成代码,却能在发布一周内引发全球开发者社区刷屏,你大概会觉得不可思议。但Jev确实做到了。
2026年9月15日,旧金山创业公司TypeSafe AI正式发布了旗舰模型Jev,定位为“System One决策模型”。与ChatGPT、Claude等大语言模型不同,Jev不生成任何文字,它接收一段状态信息,回答你预先定义好的结构化问题,然后返回带概率的判定结果。
一句话概括:LLM负责“说话”,Jev负责“判断”。
为什么需要一个“不说话的AI”?
要理解Jev的价值,得先看看生产环境中的AI Agent每天到底在做什么。
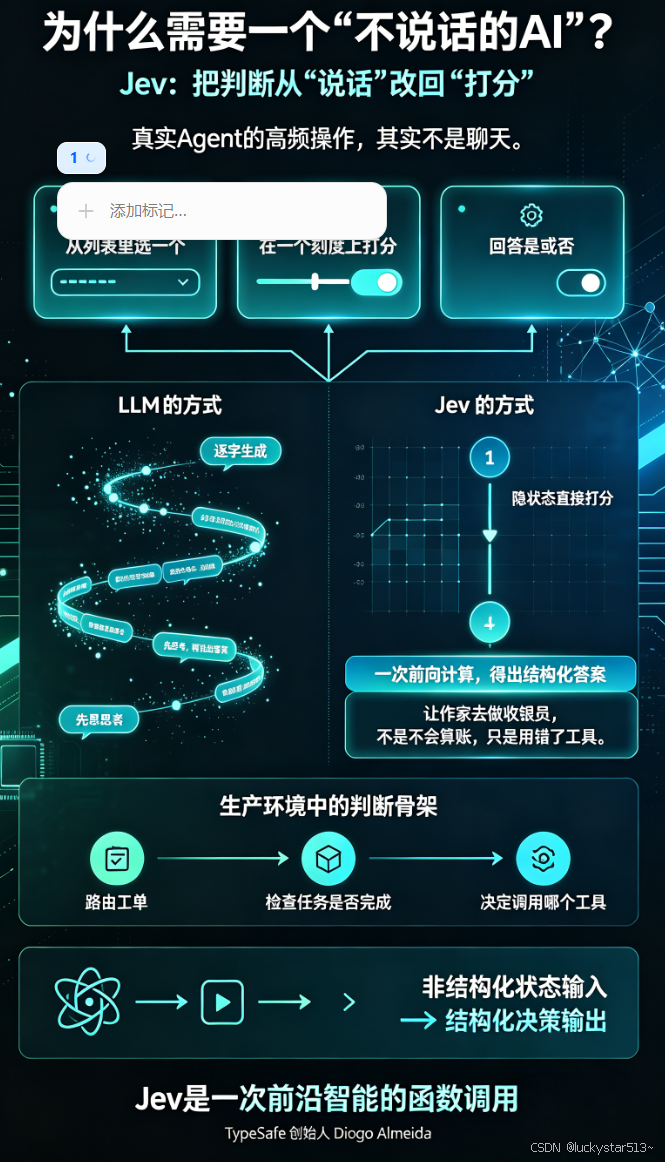
一个真实运行的Agent,最高频的操作其实只有三种:从列表里选一个、在一个刻度上打分、回答是或否。 路由工单、检查任务是否完成、决定调用哪个工具——这些判断构成了Agent运行的基本骨架。
但现实是,大多数团队把这些判断任务也丢给了大语言模型。而LLM的运作方式是从第一个token开始逐字生成,回答一个“是或否”的问题,也要先“思考”一番再“说”出来。这就像让一个作家去做收银员:他不是不会算账,只是用错了工具。
Jev的思路截然不同。它跳过了自回归解码的整个过程,直接在模型的隐状态上打分,一次前向计算就得出答案。TypeSafe创始人Diogo Almeida把Jev定义为“一次前沿智能的函数调用”——非结构化状态输入,结构化决策输出。
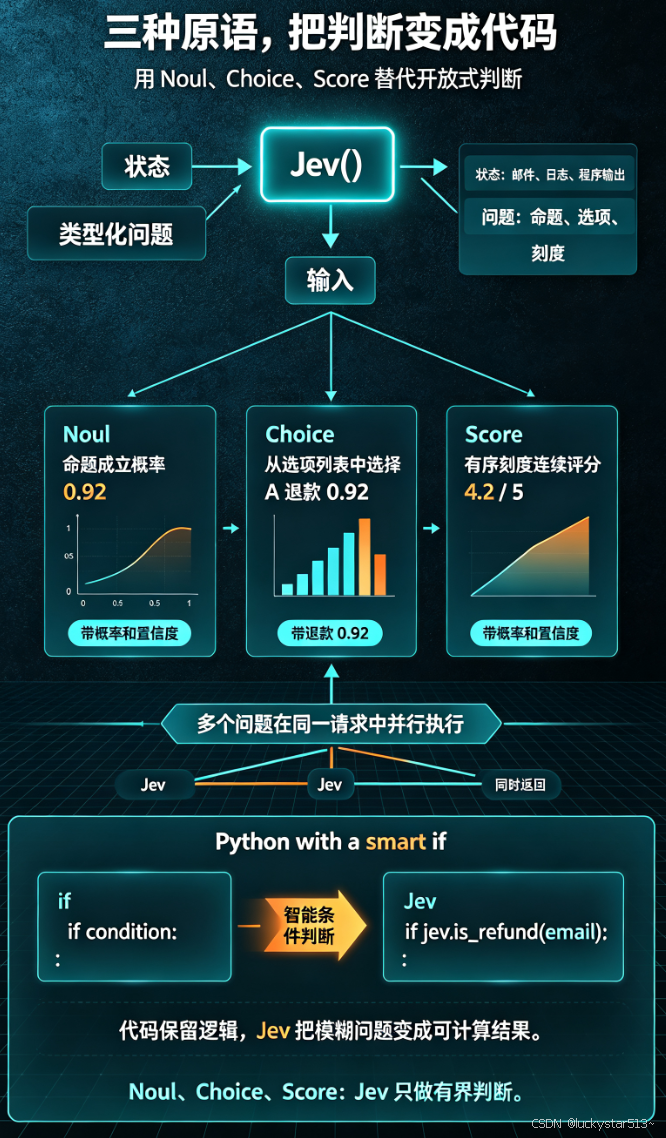
三种原语,把判断变成代码
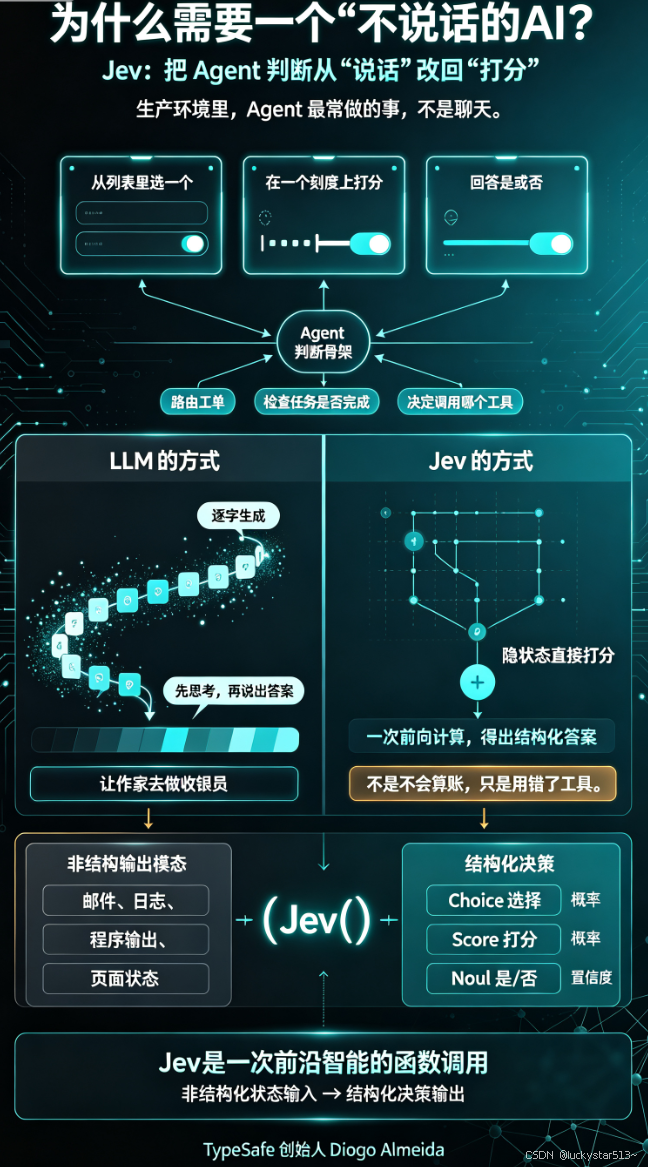
Jev的接口简单到令人意外。它只提供三种问题类型:
- Noul(是/否判断) :给定一个命题,返回它在0到1之间的成立概率。
- Choice(选择) :从你事先声明的选项列表中选一个,同时返回完整的概率分布和置信度。
- Score(打分) :在一个有序刻度上给出连续评分,附带各档位的概率。
使用方式也很直观。你给它一段状态(一封邮件、一条日志、一段程序输出),再加上几个类型化的问题,Jev会一次性返回所有答案,每个答案都带概率和置信度。多个问题在同一请求中并行执行。
社区里有人把这个模式总结得很精准:Jev就是“Python with a smart if” ——你的代码负责逻辑和动作,Jev负责“判断”那个if条件到底成不成立。
快200倍、便宜400倍,怎么做到的?
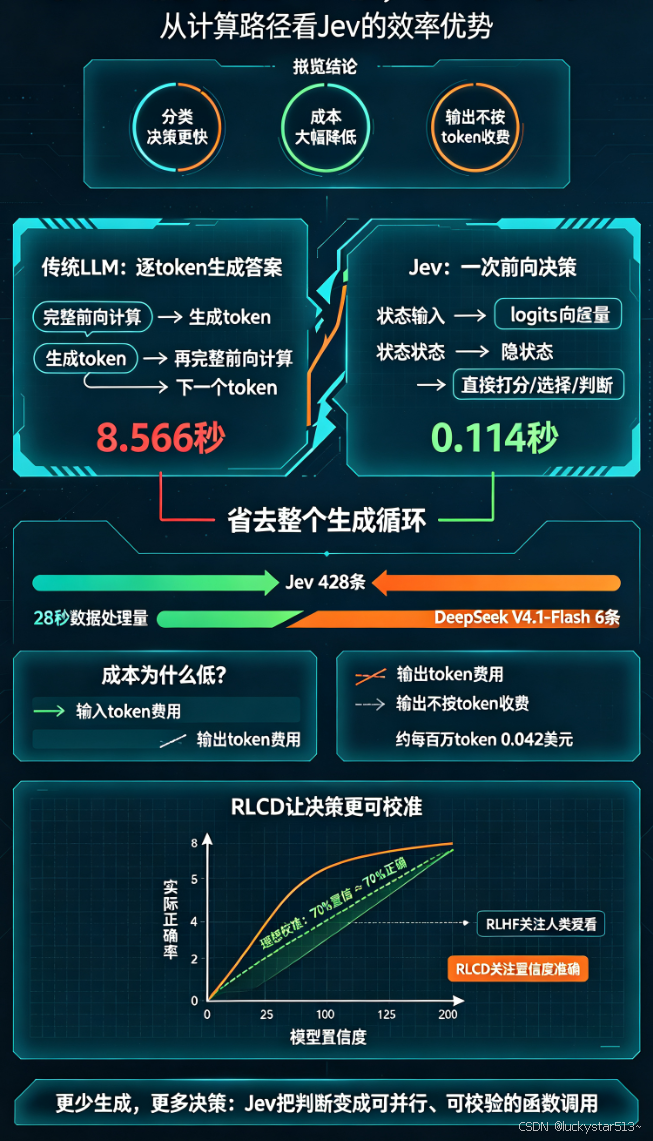
TypeSafe公布的数据相当惊人:在分类决策任务上,Jev比前沿大模型最快提速近200倍,成本最低降至约四百分之一。
这个数字背后有具体的技术原因。传统LLM生成一个答案需要逐token解码,每个token都要跑一次完整的前向计算。而Jev只需要一次前向计算,直接读取隐状态的logits来做决策。省掉了整个生成过程,延迟自然断崖式下降。
在官方演示中,同一个判断任务,Jev耗时0.114秒,而对照的大模型用了8.566秒。在社区实测中,有人用它28秒处理了428条数据的分类打标,而DeepSeek V4.1-Flash在同一时间内只完成了6条。
成本方面同样悬殊。Jev的输入价格约为每百万Token 0.042美元,输出不按Token收费——因为它根本不生成文本。
支撑这一切的是TypeSafe开发的新训练方法RLCD(Reinforcement Learning for Calibrated Decisions,面向校准决策的强化学习) 。与RLHF(从人类反馈中强化学习)追求“人类爱看”不同,RLCD优化的是模型置信度与实际正确率的对应关系:当模型说“我有70%的把握”时,大约70%的情况下它确实是对的。
从浏览器点击到微信助手:社区玩法一览
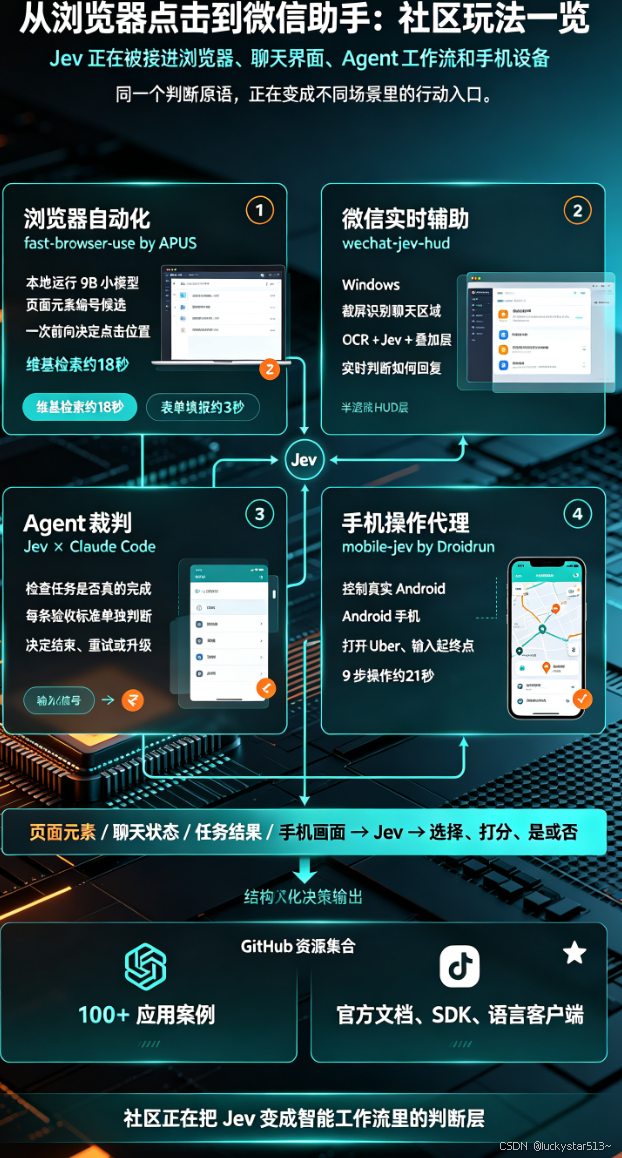
Jev发布后,开发者社区的创意速度令人咋舌。在GitHub上,已经出现了两个维护中的Jev资源集合:一个收录了超过100个应用案例,另一个精选了官方文档、SDK和各语言的客户端库。
几个有代表性的用法:
浏览器自动化。 这是最热门的方向。中国AI企业APUS开源了针对Jev的独立复现成果fast-browser-use,在本地运行一个9B参数的小模型,把页面上可交互的元素整理成带编号的候选动作集,由模型一次前向计算直接决定“点哪里”。在Apple M2 Pro笔记本上全程离线运行,维基百科检索任务中位耗时约18秒,表单填报仅需3秒左右。
微信实时辅助。 有开发者做了wechat-jev-hud工具,运行在Windows上,通过截屏识别聊天区域,把Jev接在OCR和叠加层中间做实时判断,帮你决定该怎么回消息。
Agent“裁判”。 有人把Jev接进Claude Code,让它检查Agent的任务是否真的完成了。Agent说“done”不等于结果真的达标,Jev可以针对每一条验收标准分别做是/否判断,工作流代码再根据这些信号决定是结束、重试还是升级人工处理。
手机操作代理。 Droidrun团队用Jev做了mobile-jev,控制真实Android手机打开Uber、输入起终点、一路点击到付款界面,9个操作步骤仅耗时21秒。
值得关注的国产化进展
Jev发布仅4天后,APUS AI实验室就公布了独立开源复现成果,全部代码以MIT协议开放,支持macOS、Linux、Windows三大平台,既可以在GPU服务器上运行,也可以在没有GPU的Mac和PC上运行。
这意味着即使Jev的官方API还没有覆盖所有地区,开发者也能在本地跑起来。APUS的复现已经封装为标准Agent Skill,可以通过一行命令接入Claude Code、Codex等主流编程智能体。
对于国内开发者来说,这是一个值得关注的信号:决策模型的路线可能比大语言模型的国产化替代更容易落地——因为它本身就不需要那么大的模型,9B参数的本地模型就能胜任浏览器自动化中的判断任务。
它不适合做什么?
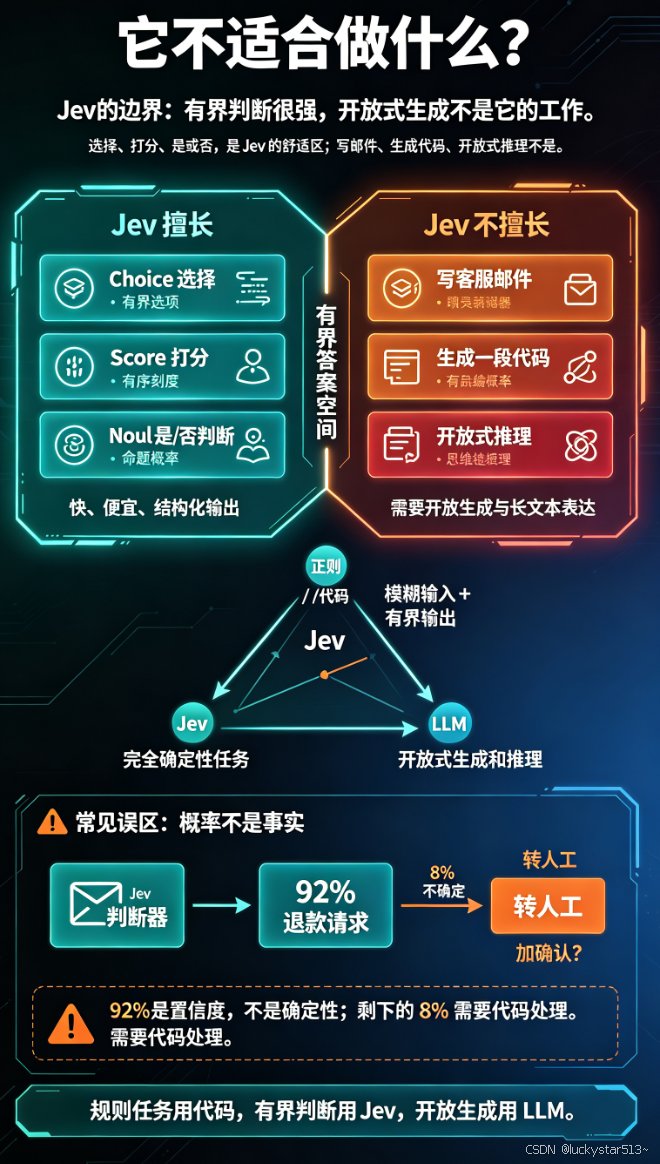
Jev不是万能药。它的设计目标非常明确:有界答案空间的判断任务。
选择、打分、是/否——这三类任务Jev又快又便宜。但如果你需要写一封客服邮件、生成一段代码、或者进行开放式推理,Jev帮不上忙。社区里有一条判断原则说得很清楚:完全确定性的任务用正则或代码,模糊输入但有界输出的任务用Jev,开放式生成和推理才交给LLM。
另外,Jev的输出是概率而不是事实。它说“有92%的概率这封邮件是退款请求”,剩下的8%需要你的代码来处理——可能是转人工,可能是加一道确认。把概率当作确定性来用,是社区反复提醒的常见误区。
最后
Jev的爆火,本质上反映了一个正在发生的转变:AI系统的架构正在从“一个模型包打天下”,走向“快慢分工” 。昂贵的大模型负责规划、生成和推理这些“慢思考”,高频、原子化的“快判断”交给轻量决策模型完成。
这让我想起认知科学里的经典框架:人类大脑有系统一(快速直觉)和系统二(慢速深思),两者协作才构成了完整的决策能力。当前的AI系统几乎只有“系统二”——什么任务都要先“想”一遍。Jev补上的,恰恰是缺失的那一半。
对于开发者来说,这意味着一个新的工具箱:不是每个if都需要一个作家来回答。
参考资源:
- TypeSafe官方文档:docs.typesafe.ai
- Awesome Jev资源集合:github.com/AnotiaWang/awesome-jev
- Jev应用案例集:github.com/JackZeng/Jev_apps
- jevlang(Python决策工作流):github.com/sumanmichael/jevlang
- APUS开源复现:fast-browser-use