大家好,我是搬砖工呀。
国庆过半,大伙一定是玩的开心,游的愉快。
当初Typscript决定用Go来重写,我们.NETer会有点意难平啊。C#的创造者最终没有选择自己亲儿子(虽然已经不管版)。这不hez2010大佬的新项目来了,让亲儿子也可以编译Typescript。
https://github.com/hez2010/TypeScript/tree/typescript-cs
首先说明,虽然是实验项目,但是也能说明一些问题的,比如我们最不想回答的,为啥不选择C#,目前的测试数据表明,在这领域,C#真的没Go合适。最起码现在的版本如此。
我们当然知道,性能优化都需要一个持续改进的过程,但是初版来看,和Go的版本差距比Go慢1倍左右。这也正常,毕竟一切都还没有优化。如果我们用Rust重写,可能上来就不慢了吧(呵呵)
我们继续开始今天的内容,先看项目完整度
一、Typescript-cs完整度
我们先汇总项目整体概况。大体如下:
| 阶段进度 | 7 / 10 交付 | 阶段 0–6 完成(09-22 → 10-02),阶段 7–9 未开始 |
| 语义核心 | 完成 | 13,446 个活跃语义配置,单检查器与默认四检查器两种模式下源代码图与完整诊断记录全部一致 |
| 验证规模 | 罕见地大 | 单是扫描器就 1,828,290 条 token 记录;检查器查询比对 1,649,908 次 |
| 代码量 | 约 Go 的一半 | C# 162,392 行(手写 129,891)vs Go 317,847 行(手写 270,515) |
| 性能 | 未达标 | 从“慢 4–5 倍”追到“慢 1.2–1.6 倍”;没有任何一批数据证明追平或超过 Go |
| 内存 | 明显更差 | 峰值工作集 Go 41–56 MiB,C# 133–213 MiB(Satori 206–260 MiB) |
| 平台 | 最大短板 | 21 个目标,只有 Windows x64 有“发布并执行”的 NativeAOT 成果 |
| 结论 | 不能替换 Go | Go 后端仍是产品后端;服务/LSP/API、打包、性能、跨平台全部未过 |
项目目前已经可以在Win X64平台下编译TS文件。但是性能比Go的差。内存比Go的大。内存上我们应该可以理解,毕竟没有比Go更简洁的语言了,真的很好。
文章在发布的时候,作者又更新了。目前9个计划已经全部完成了。
一起往下看,具体的科学实现过程。
二、实现过程
先分析现在Go版本的项目文件规模。
2.1项目文件

值得注意的点:
- 检查器一个包就是 60,831 行,其中单个 checker.go 就有 32,575 行。文档明确说这是唯一不能“换算法”的部分——换掉算法再同时换运行时、存储和并发,调试工作量会成倍放大。
- 47,332 行(14.9%)是生成代码或 stringer 代码。计划的对策是“用生成器产出 C# 等价物”,而不是手抄。
- 编辑器相关(语言服务 41,555 + LSP 22,035)比很多人以为的大:文档说“编辑器对等是一个不亚于编译器正确性的独立工作流”。
再看实际写出来的东西。下面这张是我在本机直接统计的(C# 侧统计 csharp/ 下排除 obj/bin 的 .cs;Go 侧统计 tsc/internal + tsc/cmd 下排除 *_test.go):
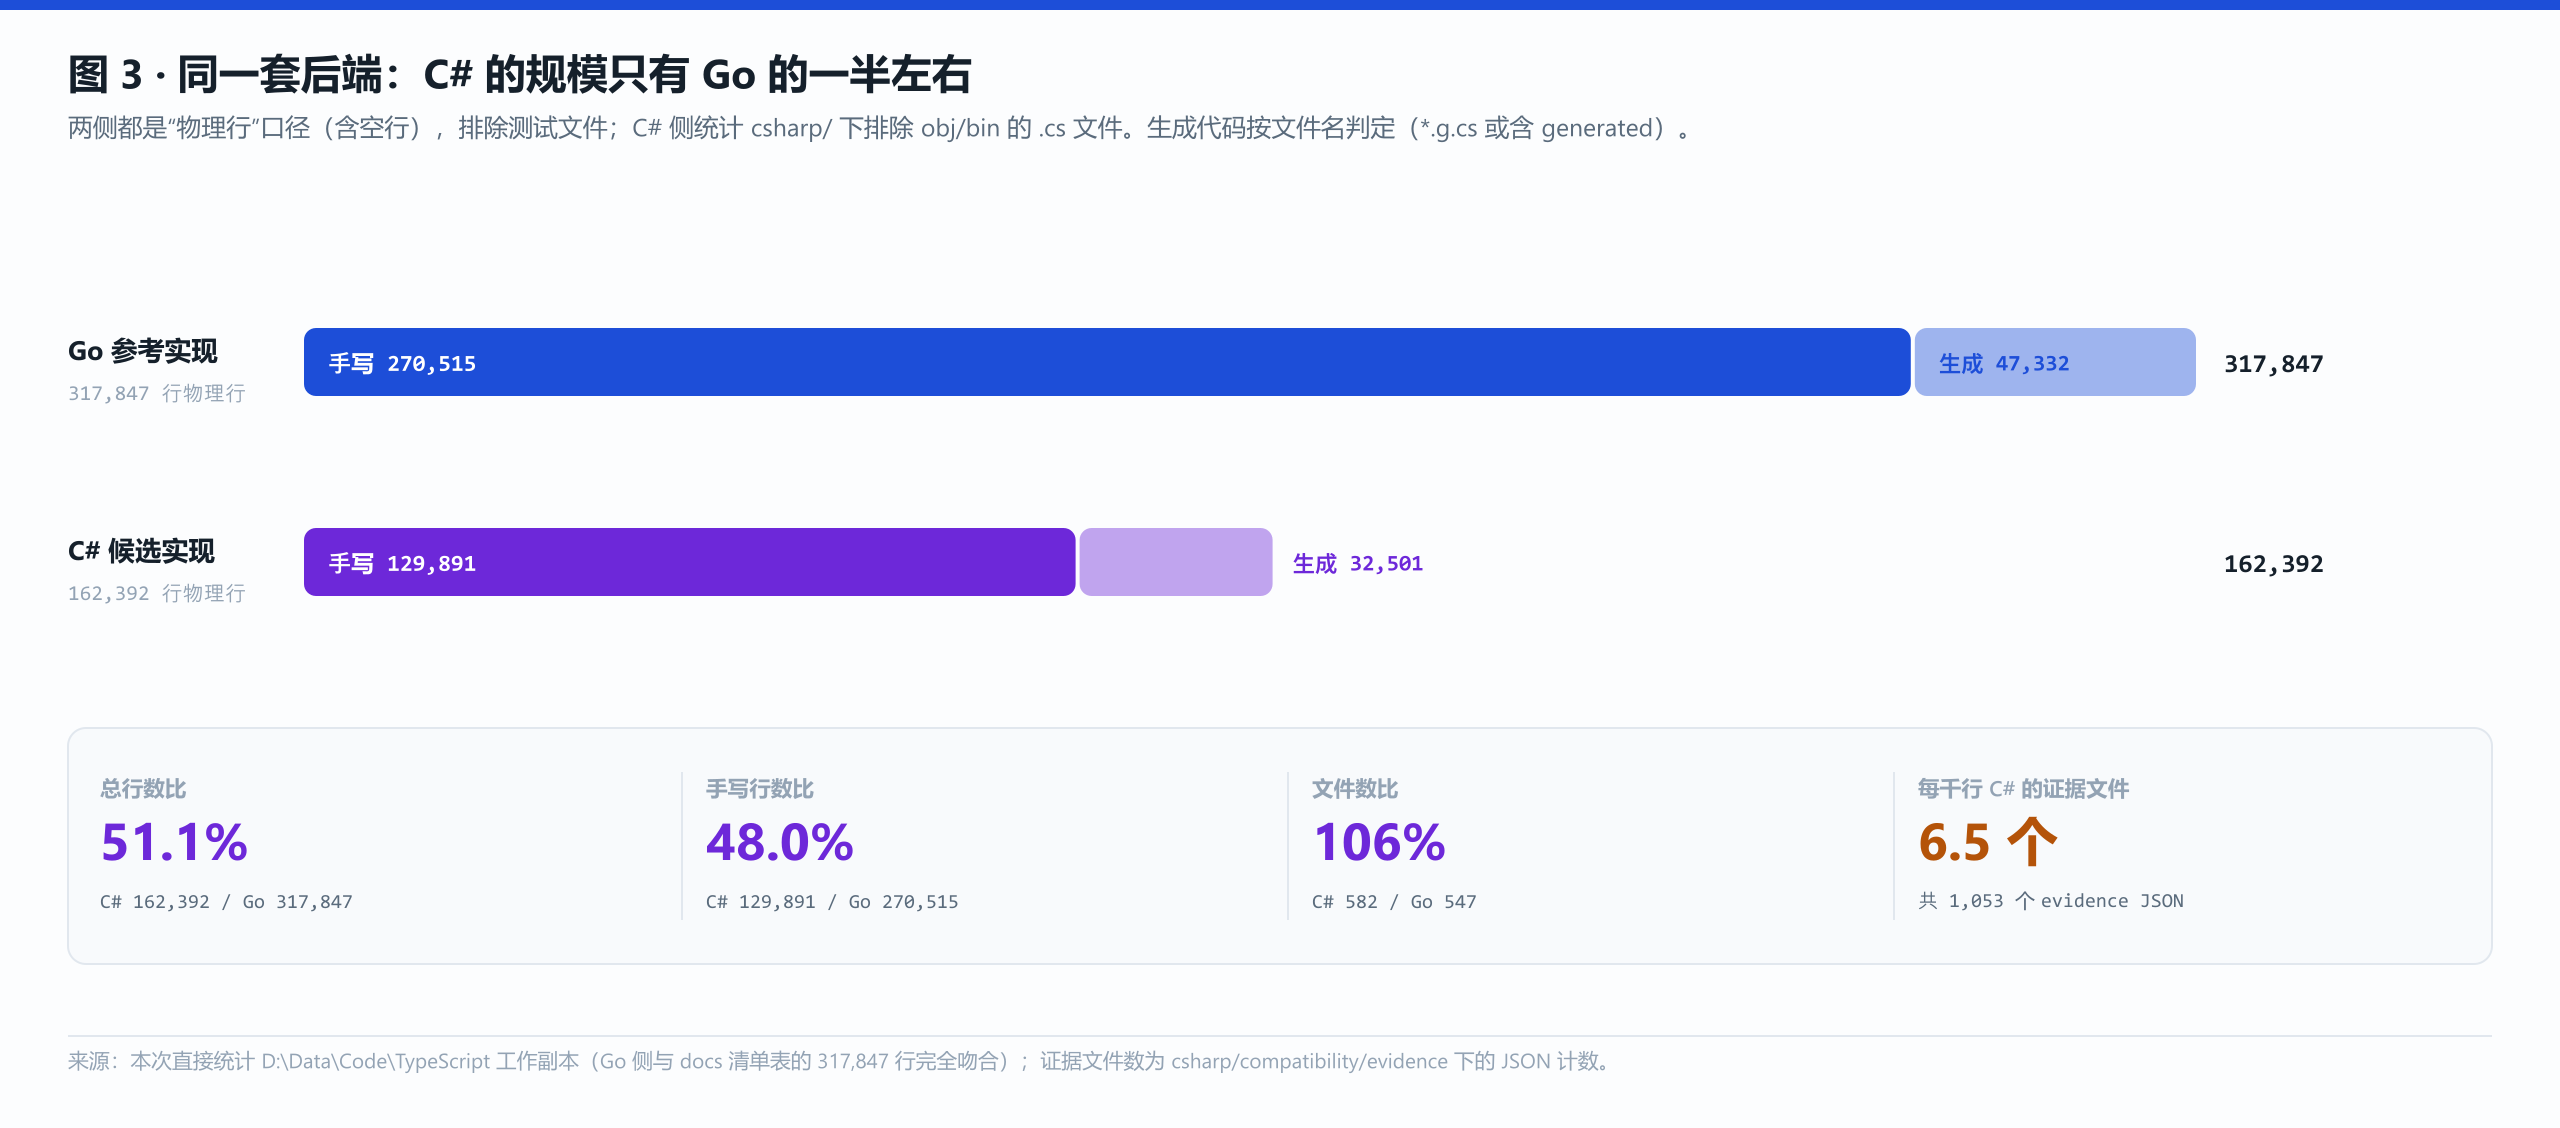
很奇怪的统计数据:
| 总行数 | 317,847 | 162,392 | 51.1% |
| 手写行数 | 270,515 | 129,891 | 48.0% |
| 文件数 | 547 | 582 | 106.4% |
行数少了近一半,文件数反而多了 6%。这个组合说明它是“按职责重新切分 + 用 C# 类型系统合并等价逻辑”的结果,不是逐文件翻译——计划里也是这么要求的:允许“多个 Go 函数映射到一个共享 C# 实现”,移植台账是覆盖率工具,不是保持重复的理由。
还有一个数字耐人寻味:csharp/compatibility/evidence/ 下有 1,053 个证据文件,即每千行 C# 代码配 6.5 个证据文件。这套工程真正的产出不只是编译器,还有它自己的证明。
接下来就是具体的迁移计划了。比较晦涩,还很长,可以直接跳过去结论。但是这里其实是很好的工程实践,值得我们去学习,如何把握这么大的项目。学到就是赚到。
三、迁移计划
计划把工作切成 10 个阶段(编号 0–9),每个阶段都有明确的完成要求。下面这张图是各阶段的推进顺序与当前状态:
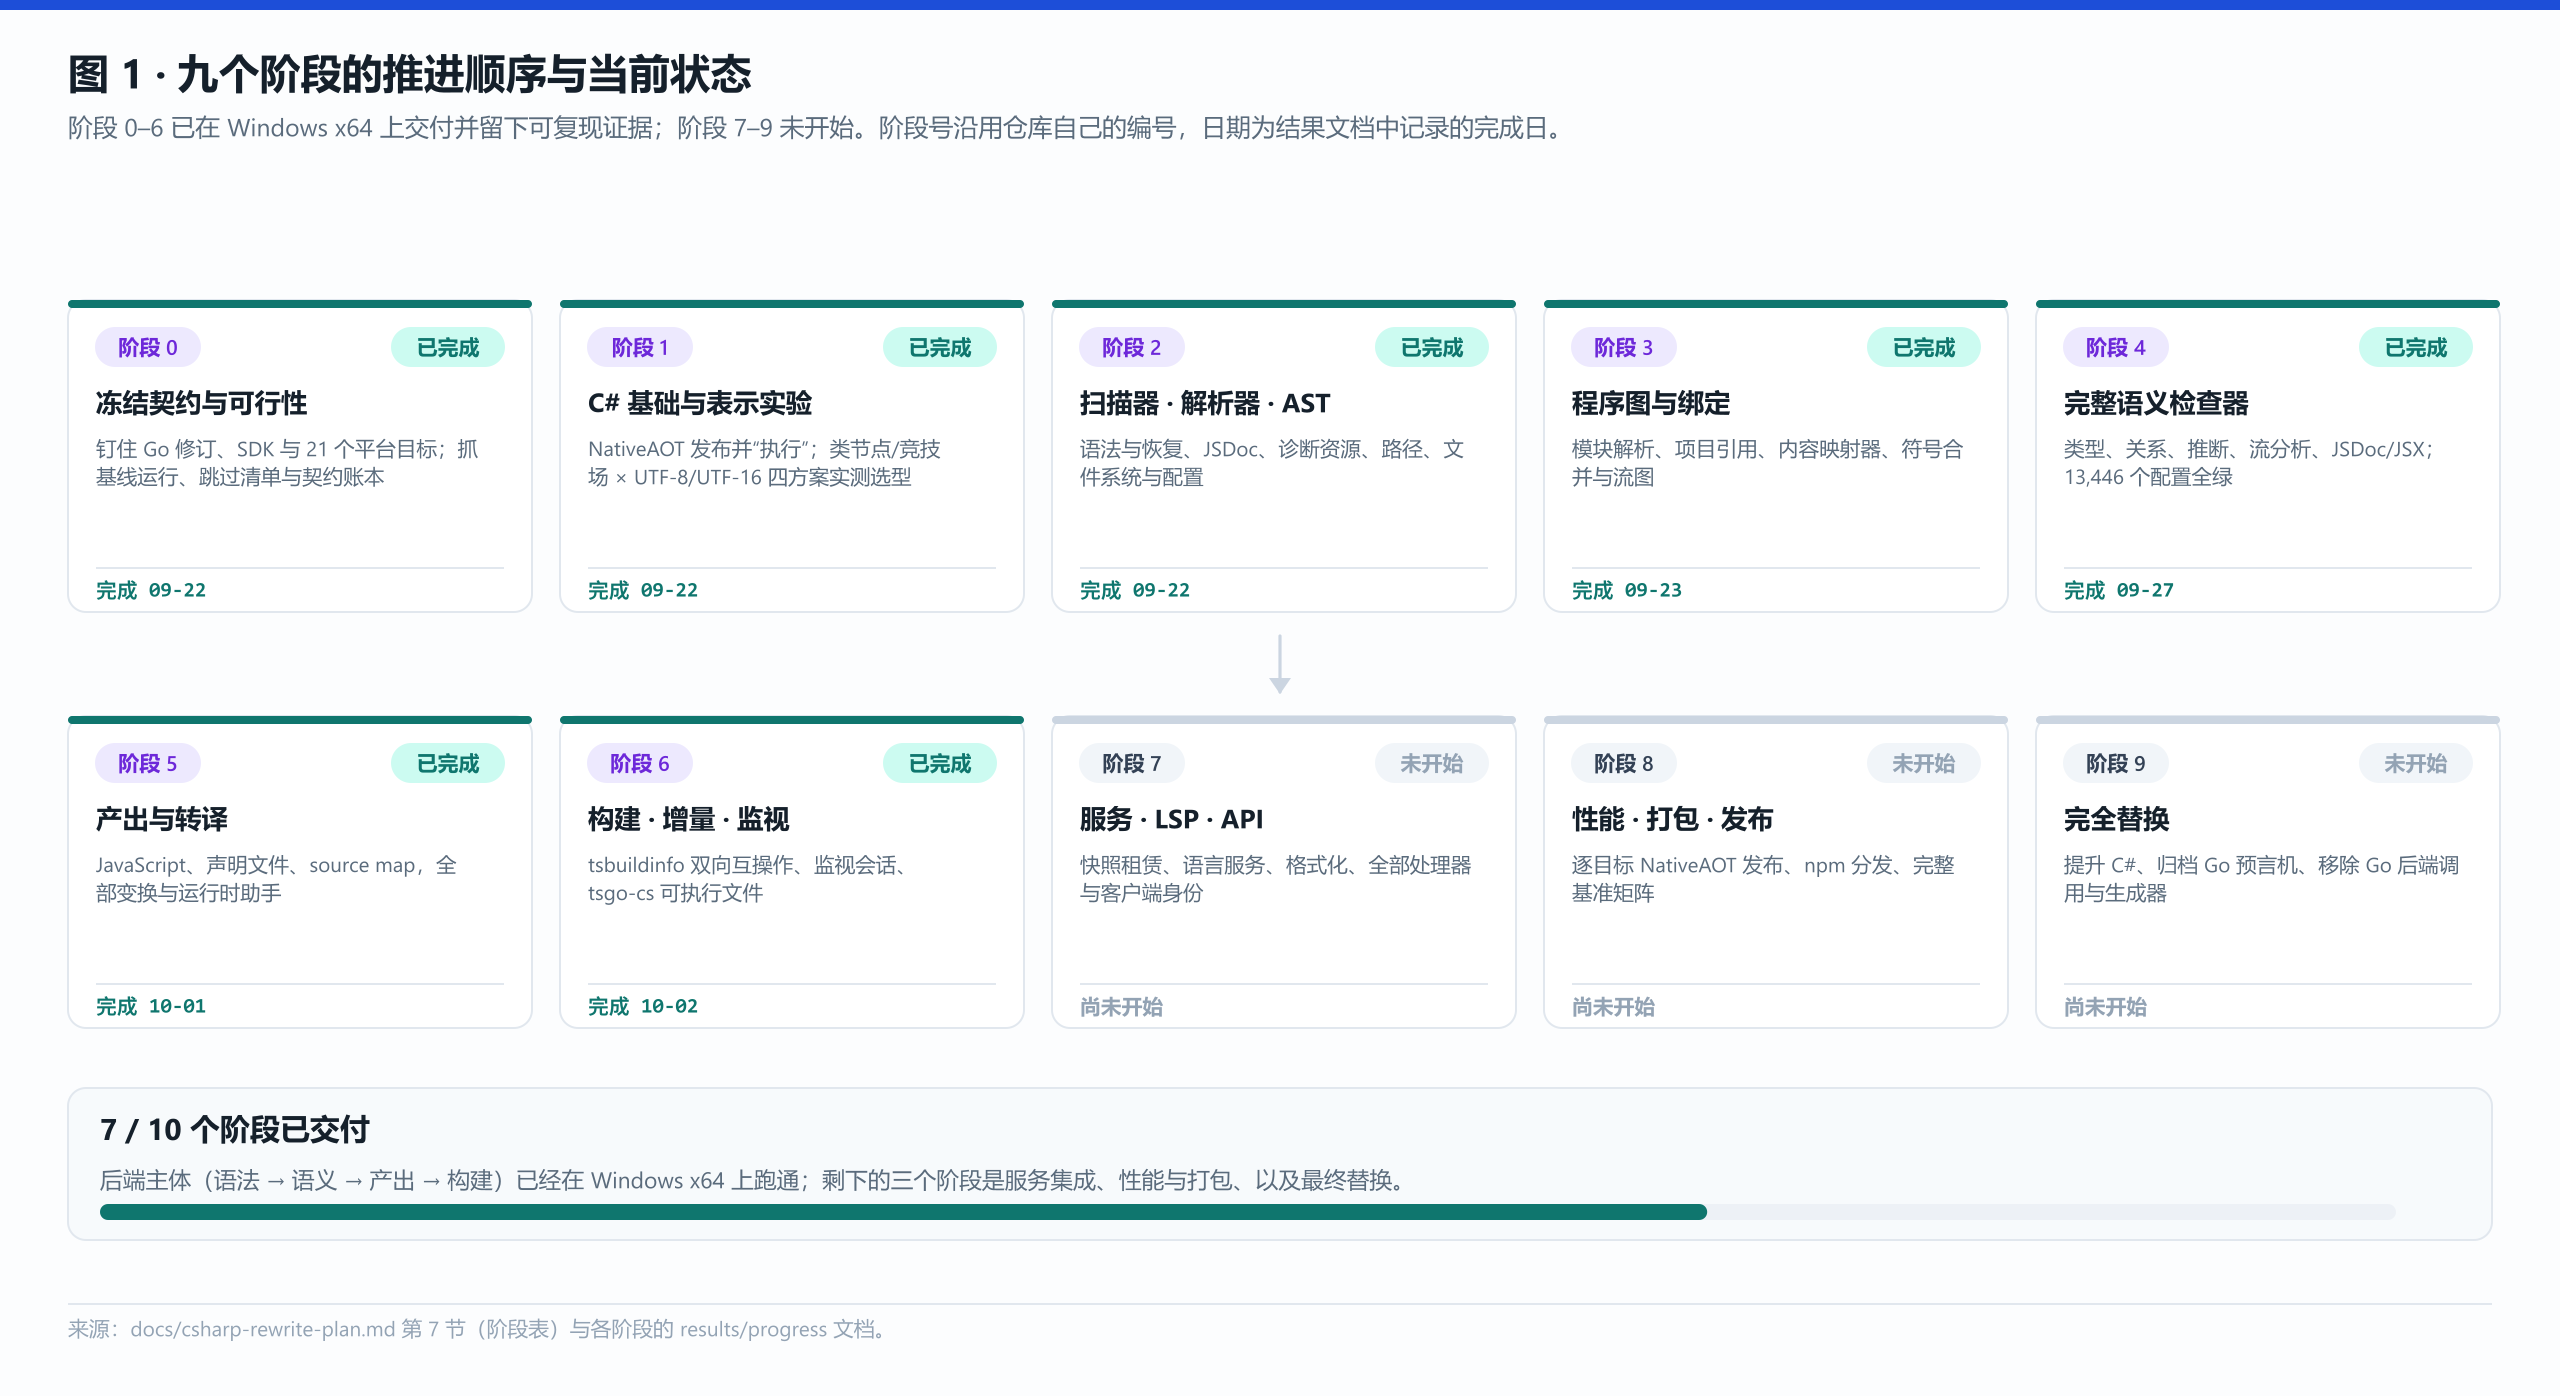
| 0 | 冻结契约与可行性 | 已完成 | 09-22 |
| 1 | C# 基础与表示实验 | 已完成 | 09-22 |
| 2 | 扫描器 · 解析器 · AST | 已完成 | 09-22 |
| 3 | 程序图与绑定 | 已完成 | 09-23 |
| 4 | 完整语义检查器 | 已完成 | 09-27 |
| 5 | 产出与转译 | 已完成 | 10-01 |
| 6 | 构建 · 增量 · 监视 | 已完成 | 10-02 |
| 7 | 服务 · LSP · API | 未开始 | — |
| 8 | 性能 · 打包 · 发布 | 未开始 | — |
| 9 | 完全替换 | 未开始 | — |
可以看到,功能其实已经全部完成了,剩下的就是Go版本的同等替代功能,比如LSP等
笔者有话说:截至今天10月5日,作者又更新了代码库,9个计划应该全部完成了。我就不在赘述了。
3.1 阶段 0–1:先做实验,再决定表示
阶段 1 的任务不是写检查器,而是回答“用什么表示数据”。它用真正的 parse/bind/check/encode 管线比了四个变体(类节点/竞技场 × UTF-8/UTF-16 扫描),5 个顺序进程 × 15 个样本 × 20 次操作 = 每变体 75 个样本:
| 类型化类节点, UTF-8 扫描 | 0.793750 | 1,704,208 | 3.13% |
| 类型化类节点, UTF-16 扫描 | 0.746055 | 1,730,920 | 3.31% |
| 类型化竞技场, UTF-8 扫描 | 0.940745 | 1,628,320 | 4.45% |
| 类型化竞技场, UTF-16 扫描 | 0.903435 | 1,655,032 | 2.62% |
结论是选类型化类节点 + 临时 UTF-16 扫描视图,但保留原始 UTF-8/WTF-8 字节:UTF-16 扫描在这个实验里快约 6%、多约 1.6% 分配,而竞技场虽然省分配、走完整管线却更慢。文档自己给这个结论划了边界:These results justify the next-phase implementation choice; revisit measured hot spots on the full scanner/checker workload rather than treating this slice as an end-to-end compiler speed claim.(这是下一阶段的选型依据,不能当作端到端的编译器速度结论。)
这个决定后来被推翻了两次,这是我认为整套记录里最有价值的一条线索:
也就是说,阶段 1 的快照式选型,最后是被真实负载推翻、再被文档如实记录下来的。这与“先在 2 文件 × 100 别名的切片上选型”的局限正好对应。
同阶段还立起了几个后面一直复用的能力:NativeAOT 发布并执行(可执行文件 5,144,576 字节)、独立的 AST 编码(C# 自己生成每个报文段,交给未改动的 JS 解码器校验)、20,000 层嵌套类型括号与 10,000 层别名依赖链通过解析/检查/克隆/打印/编码、原生 profiler 直接产出 pprof 格式且能被 Go 的 pprof -top 消费。基础断言数 458,098 条。
仓库层面的回归也是一路带上的:hereby validate –all 跑出 161,228 个 Go 测试/子测试通过、2,152 个原有跳过、813 个 API 测试、12 个扩展测试、17 个工具测试。
这里其实我们也看到,我们C#真的背负的历史债务的,如果我们当初就是UTF8编码的字符串,好多东西都会好很多。谁让当年Java也是UTF16呢?抄当然要一致。特别这关键地方。我想哭死。平心而论,在发明C#的年代,用UTF16太合理了,不责怪。
3.2 阶段 2:扫描器、解析器、AST 与基础宿主
这一阶段把“语法层”整个搬过来,验证表非常密:
| 扫描器/重扫描/畸形输入/Unicode | 12,895 例,1,828,290 条 token 记录 | 与 Go 完全一致 |
| 测试指令、虚拟文件、选项、符号链接 | 12,866 例,17,433 单元 | 完全一致 |
| 全部内置声明库 | 108 个文件,183,538 个 AST 节点 | 完全一致 |
| 完整展开的解析语料 | 17,448 个文件,1,699,364 条 AST 记录 | 16,762 完全一致 + 686 条记录在案的差异 |
| 仅 JS 语法诊断 | 28 例,58 条诊断 | 27 完全一致 + 1 条畸形源恢复 |
| 显式文档树(含全部库) | 839 个物理文件,1,228 单元,12,599 棵树,50,944 个节点 | 332 完全一致 + 896 条逐条钉住的差异 |
| 正则文法 | 103,248 例 | 103,211 完全一致 + 37 条记录在案的修正 |
| 源元数据 | 6,778 次比对 | 全部通过 |
| 路径/CLI/配置/VFS | 每种资源布局 3,152 例 | 3,135 完全一致 + 17 条差异 |
| 生产解析器安全 | 36 个深输入,1,421,783 节点,深度 21,000 | 通过 |
比对粒度值得单独说:每个前序记录包含 kind、UTF-8 字节起止、flags、字面量文本、子节点数、全部 50 个 schema 标量字段、全部 127 个 NodeList/ModifierList 字段。也就是说这不是“树形状差不多”,而是逐字段。
而那 686 条差异是怎么处理的?这是这套工程最值得学的地方——差异台账(difference ledger):
计划的“差异台账”条款要求:每一处分歧都要记录用例标识、源哈希、参考与候选结果、理由、独立证据、可复现命令,并且“严格比对结果必须与语义门禁并列保留”,为的是将来若有人要求 100% Go 兼容,这些差异是可见且可逐个追溯的,而不是消失在归一化里。
实现上给了四条明确的、被刻意收窄的比对策略:
| equivalent-parser-context | 两个解析器与独立 JS 解析器都接受该文件;节点种类、文本、子节点、标量/列表属性、源跨度一致,只有 5 个解析器上下文位不同 |
| equivalent-trivia-boundary | 语言树与属性相同;不同起点经 trivia 扫描后必须落到同一个 token,不同终点只能覆盖空白 |
| equivalent-context-and-trivia | 前两条同时成立 |
| invalid-source-recovery | 三方都拒绝该输入,候选树结构合法、每条诊断有界、至少一条诊断指出与任一参考相同的越界区间 |
同时明确禁止这些策略掩盖:拒绝合法输入、丢标识符或子节点、改运算符/仅类型标志、改列表契约。syntax.mjs –strict 会在每一条差异上失败并把完整台账写出来,文档说它“不会重写或归一化掉这些结果”。
3.3 阶段 3:程序图与绑定
| semver、模块/类型/配置解析 | 16,524 例完全一致 |
| 解析轨迹 | 7,731 例(含归档的参考/候选轨迹表示) |
| 绑定语料 | 16,633 单元;16,236 完全一致 + 397 条可审计的解析器派生差异 |
| 程序图 | 232 次比对(单路/四路调度、module 模式、JSX、包去重、大小写、符号链接的项目引用) |
| span map | 22,469 例完全一致 |
| mapper 编解码 | 1,150 例;另有 43 条真实 mapper 进程断言 |
| 程序所有权与安全 | 15 条断言,12,000 层嵌套,3,000 文件导入链 |
397 条绑定差异的处理方式是这一阶段的精华。不是“因为上游解析器有差异所以放过”,而是设立四道必须同时满足的检查:
另外还有 15 个负向对照:改源、改模式、改解析器哈希、改传输指纹、改符号/局部变量/导出/流数据/诊断,都必须被拒。原文:No binder failure is accepted merely because its file has a parser difference.
用一句话概括这种设计思路:它不追求“看起来对”,而是追求“每一处不一致都有一个可以复查的因果解释”。
3.4 阶段 4:完整语义检查器
阶段 4 是整个重写的核心,也是唯一有“收敛曲线”可画的阶段。它的做法是:每一批修复后,重跑全量语料,然后把累计值写进文档。于是我们得到了一条 14 个记录点的序列:
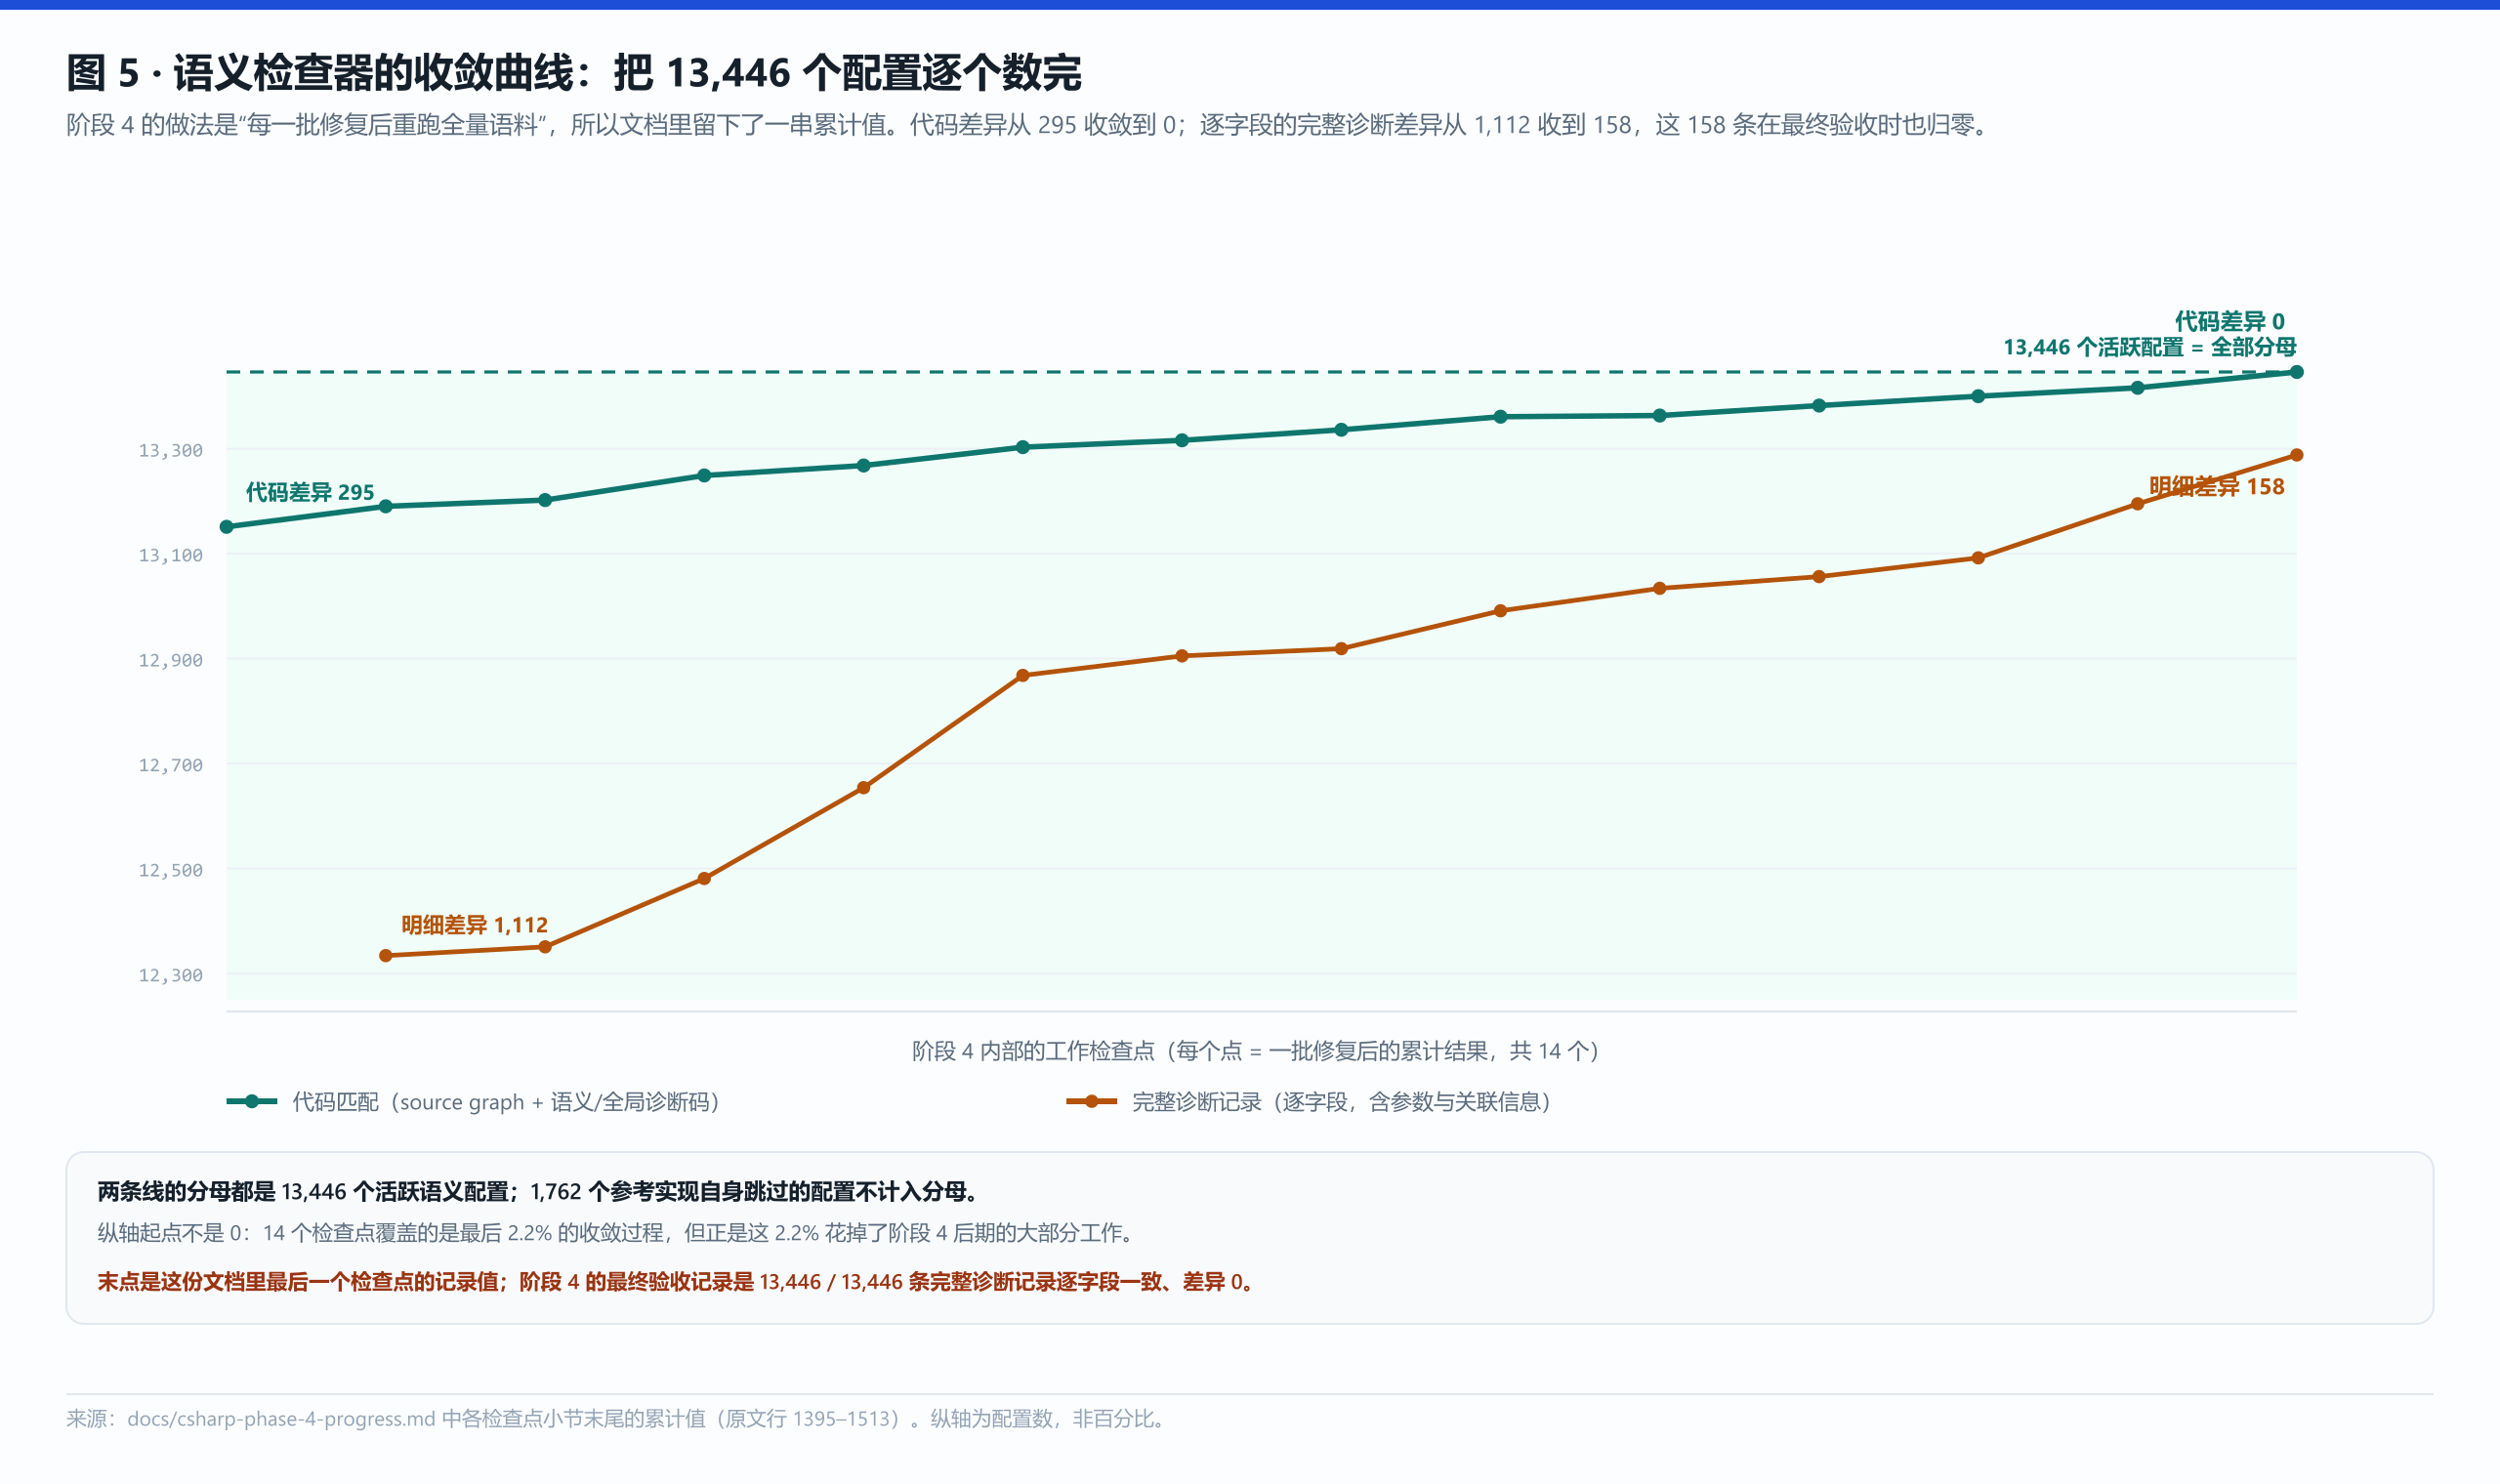
从具体表格数据看。
| 1 | 13,151 | 295 | — | — |
| 2 | 13,190 | 256 | 12,334 | 1,112 |
| 4 | 13,249 | 197 | 12,481 | 965 |
| 6 | 13,303 | 143 | 12,868 | 578 |
| 8 | 13,336 | 110 | 12,919 | 527 |
| 10 | 13,363 | 83 | 13,034 | 412 |
| 12 | 13,400 | 46 | 13,092 | 354 |
| 14 | 13,446 | 0 | 13,288 | 158 |
可以看到得到如下结论:
- 分母都是 13,446 个活跃语义配置,另有 1,762 个参考实现自己跳过的配置不计入分母(文档明确保留、不新增排除);
- 纵轴起点不是 0。第一个记录点就只剩 295 个差异,也就是最后 2.2%——而这 2.2% 花掉了阶段 4 后期的大部分工作;
- 序列末点是文档中最后一次工作记录点的值(明细差异 158)。阶段 4 的最终验收记录是 13,446 / 13,446 条完整诊断记录逐字段一致、差异 0(phase4-final-semantics.json 里 detailedMatches: 13446, differences: 0, gateComplete: true,其中 6,863 条含非空语义诊断)。这两个数字口径不同,不要混用。
“代码匹配”与“明细匹配”的差别也值得说明:前者只比源代码图 + 语义/全局诊断码,后者比完整诊断记录——包括文本参数、消息链、关联信息、位置与重数,只对顶层诊断顺序做归一化。
验证规模
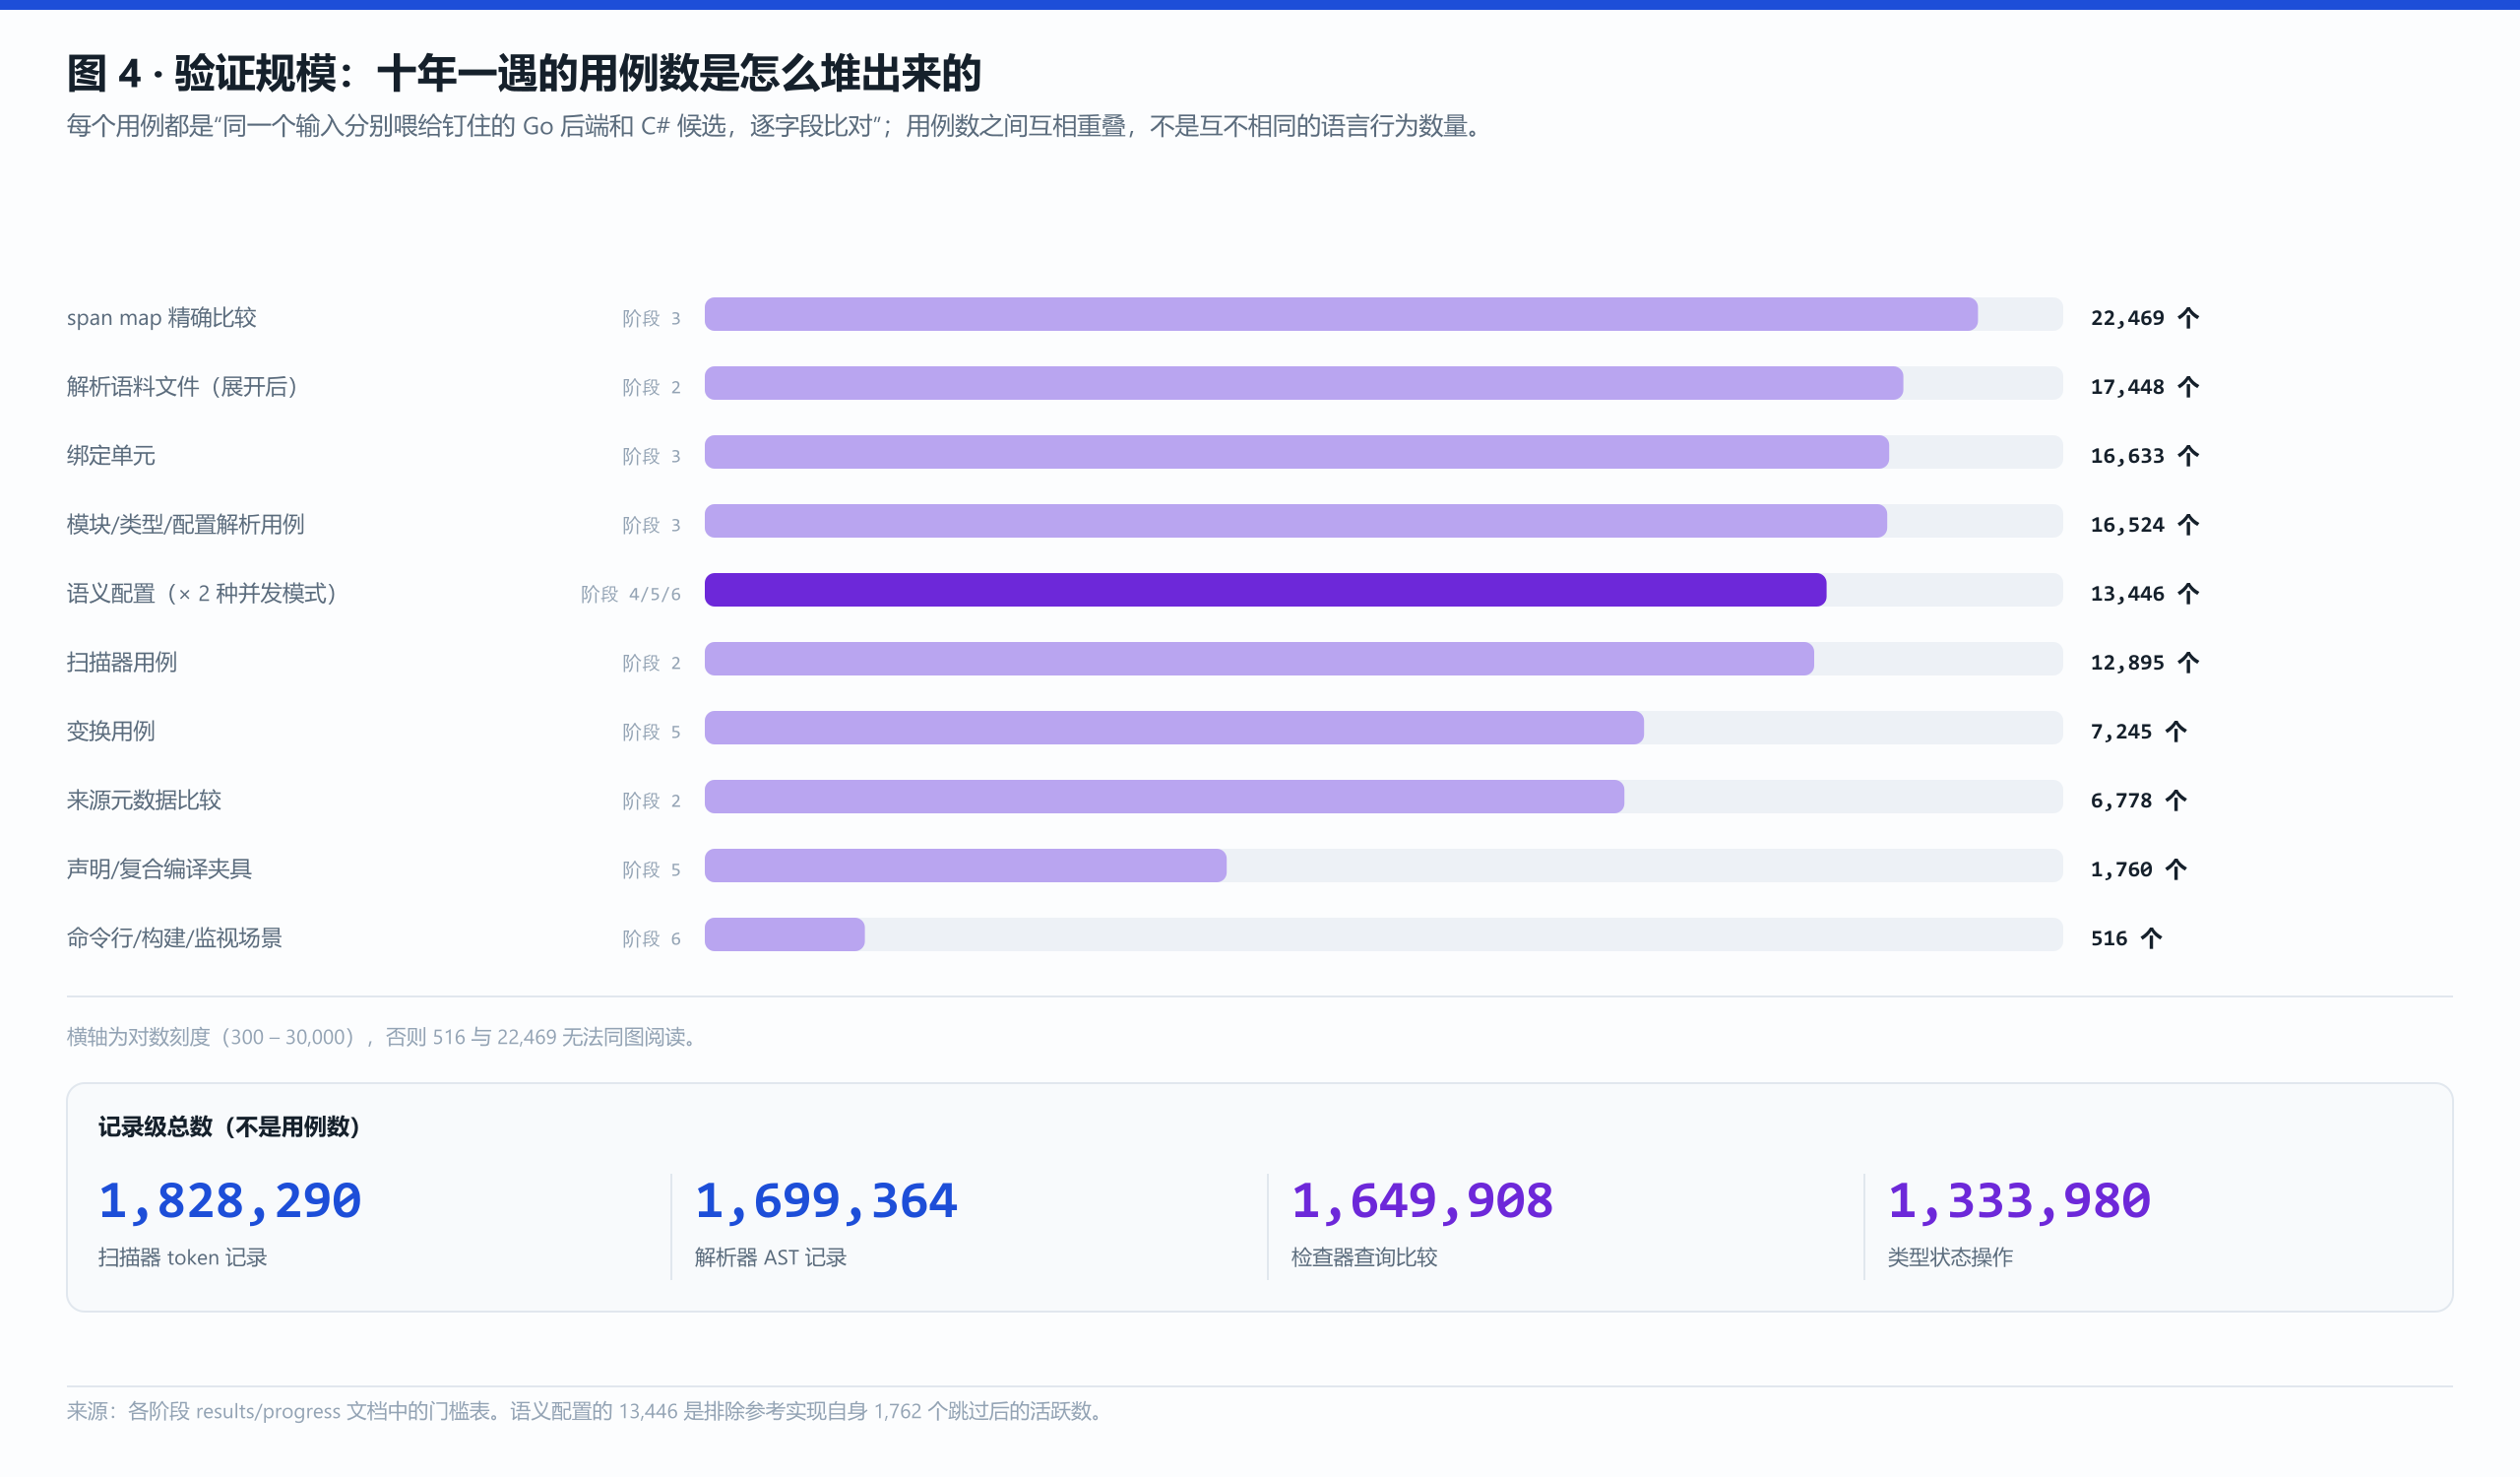
除了 13,446 个语义配置,还有:
- 检查器查询 API:31 个族、1,949 个配置、1,649,908 次查询比对,候选零失败;另有 4 个“Go 查询 API 自身崩溃”的配置被单独记为参考失败,不计入通过;
- 记录级总数:扫描器 token 记录 1,828,290 条、解析器 AST 记录 1,699,364 条、检查器查询比对 1,649,908 次、类型状态操作 1,333,980 次;
- 并行调度:CheckerPool 默认 4 个独立检查器上下文,沿用参考实现的分区策略(源/声明两种机制、导入亲和、负载上限、确定性平局处理)。分区算法与 Go 一致到 1,023 例 / 71,424 次分配,1–8 个检查器全覆盖;另有 25 条安全断言覆盖真实四 worker 重叠、取消、恢复。
有一个细节特别能说明这套验证的严格程度:语料预言机最初捕获的是 runner 的发射前语义诊断,后来发现发射过程会通过检查器缓存副作用改动 3 条诊断记录。处理方式不是改断言,而是刷新完整参考、把新旧两份快照都留档。
阶段 4 当时的性能口径(后面第五节会看到它被大幅改善):Release CoreCLR 中位延迟是 Go 的 4.8–8.6 倍,p95 ≤ 342.7 ms,峰值 RSS ≤ 148.4 MiB,释放后堆增长 < 11 KiB。
3.5 阶段 5:完整产出与转译
产出层的门禁表(原文表 + 我的整理):
| 写出器、source map、元数据、名字生成 | 378 | 377 | 1 | 0 |
| 语法打印器 | 2,296 | 2,291 | 5 | 0 |
| 变换与集成 | 7,245 | 7,005 | 240 | 0 |
| 声明的自定义用例 | 428 | 422 | 6 | 0 |
| 声明/复合编译夹具 | 1,760 | 1,758 | 2 | 0 |
| 程序发射 | 240 | 240 | 0 | 0 |
| 单文件转译 | 415 | 415 | 0 | 0 |
其中最有说服力的一类是 857 个独立 JavaScript 执行探针——不是比对文本,而是把 C# 打出来的 JS 真的跑一遍,看运行时行为(注释敏感表达式、枚举、命名空间引用、参数属性、解构与运算符求值顺序、装饰器应用、async 生成器、迭代器清理、资源释放、类初始化、模块绑定)。
那 240 条“复核后的差异”是怎么定的?文档给的是逐条断言 + 独立存证,而且相当多的结论是“参考实现错了,C# 是对的”。举几个具体例子:
- preserve-binary-association:Go 会把右嵌套的乘法、数字字面量加法、三种位运算展平去掉括号;C# 保留括号。Node 执行证明展平会改变浮点结果(0 变成约 1e-308,10000000000000002 变成 10000000000000000)或改变可观察的操作数转换顺序(c, b, a 变成 a, b, c);
- preserve-async-arguments-property-name:参考实现生成 { arguments_1 },把键名改了;C# 生成 { arguments: arguments_1 },用 Node 探针验证属性存在;
- writer-chunked-crlf:只针对一个夹具——先写 a\\r、再写 \\n、再写 b,两边字节相同,但 Go 把 CR 和 LF 分别计数,报行号 2;C# 报行号 1。Node 的独立运行时报 chunked-crlf.js:2:1,确认 C# 的位置是对的;
- register-forced-static-accessor-storage:参考实现在“类装饰器 + 静态 auto-accessor + useDefineForClassFields: false”组合下直接断言失败,C# 记录该断言消息并给出可执行的改正版本。
这些差异还有专门的清单文件约束:module-corrections.json 95 条、declaration-corrections.json 6 条、emit-fixture-corrections.json 2 条,每一条都绑定输入与两份输出的精确哈希,输入或输出一变,批准自动失效。
3.6 阶段 6:构建、增量与监视
| build-info 编解码 | 567 例(含 545 个不同状态)+ 28 条畸形/缓存安全断言 | 完全一致 |
| 增量状态 | 135 个场景、942 个周期;762 次双向状态交接 | 完全一致 |
| 项目构建 | 48 个场景、342 个周期 | 46 完全一致 + 2 条复核修正 |
| 自撰监视转换 | 33 个场景、242 个周期 | 完全一致 |
| 原始命令回放 | 全部 516 个导出场景、1,771 个周期 | 编译/构建/监视范围已验证;5 个 profiling 契约延后 |
| 命令行可执行文件 | 7 次独立进程调用 | 版本/帮助、编译、no-op 状态保持、错误退出、强制重建、清理 |
**762 次“双向状态交接”**是这一阶段最有价值的设计:它把一端产出的构建状态(.tsbuildinfo)喂给另一端的初始文件系统并继续编译,比对诊断、源代码图、发射字节、状态内容与后续写入决策。文档专门点出原因:Comparing two independent cold compilations alone would not establish this interoperability.(只比两次互不相干的冷编译,证明不了互操作性。)
阶段 6 还发现并修复了两个 Go 参考实现自身的缺陷:
同时留下一个明确的边界:原生监视只验证了 Windows x64,Linux/macOS 与其他保留目标仍需真机执行;“发布”不等于满足这道门禁。
四、性能差距
性能这条线在文档里是分 10 批测出来的,每批都换了一个变量。把它们纵向排起来,就是这张图:
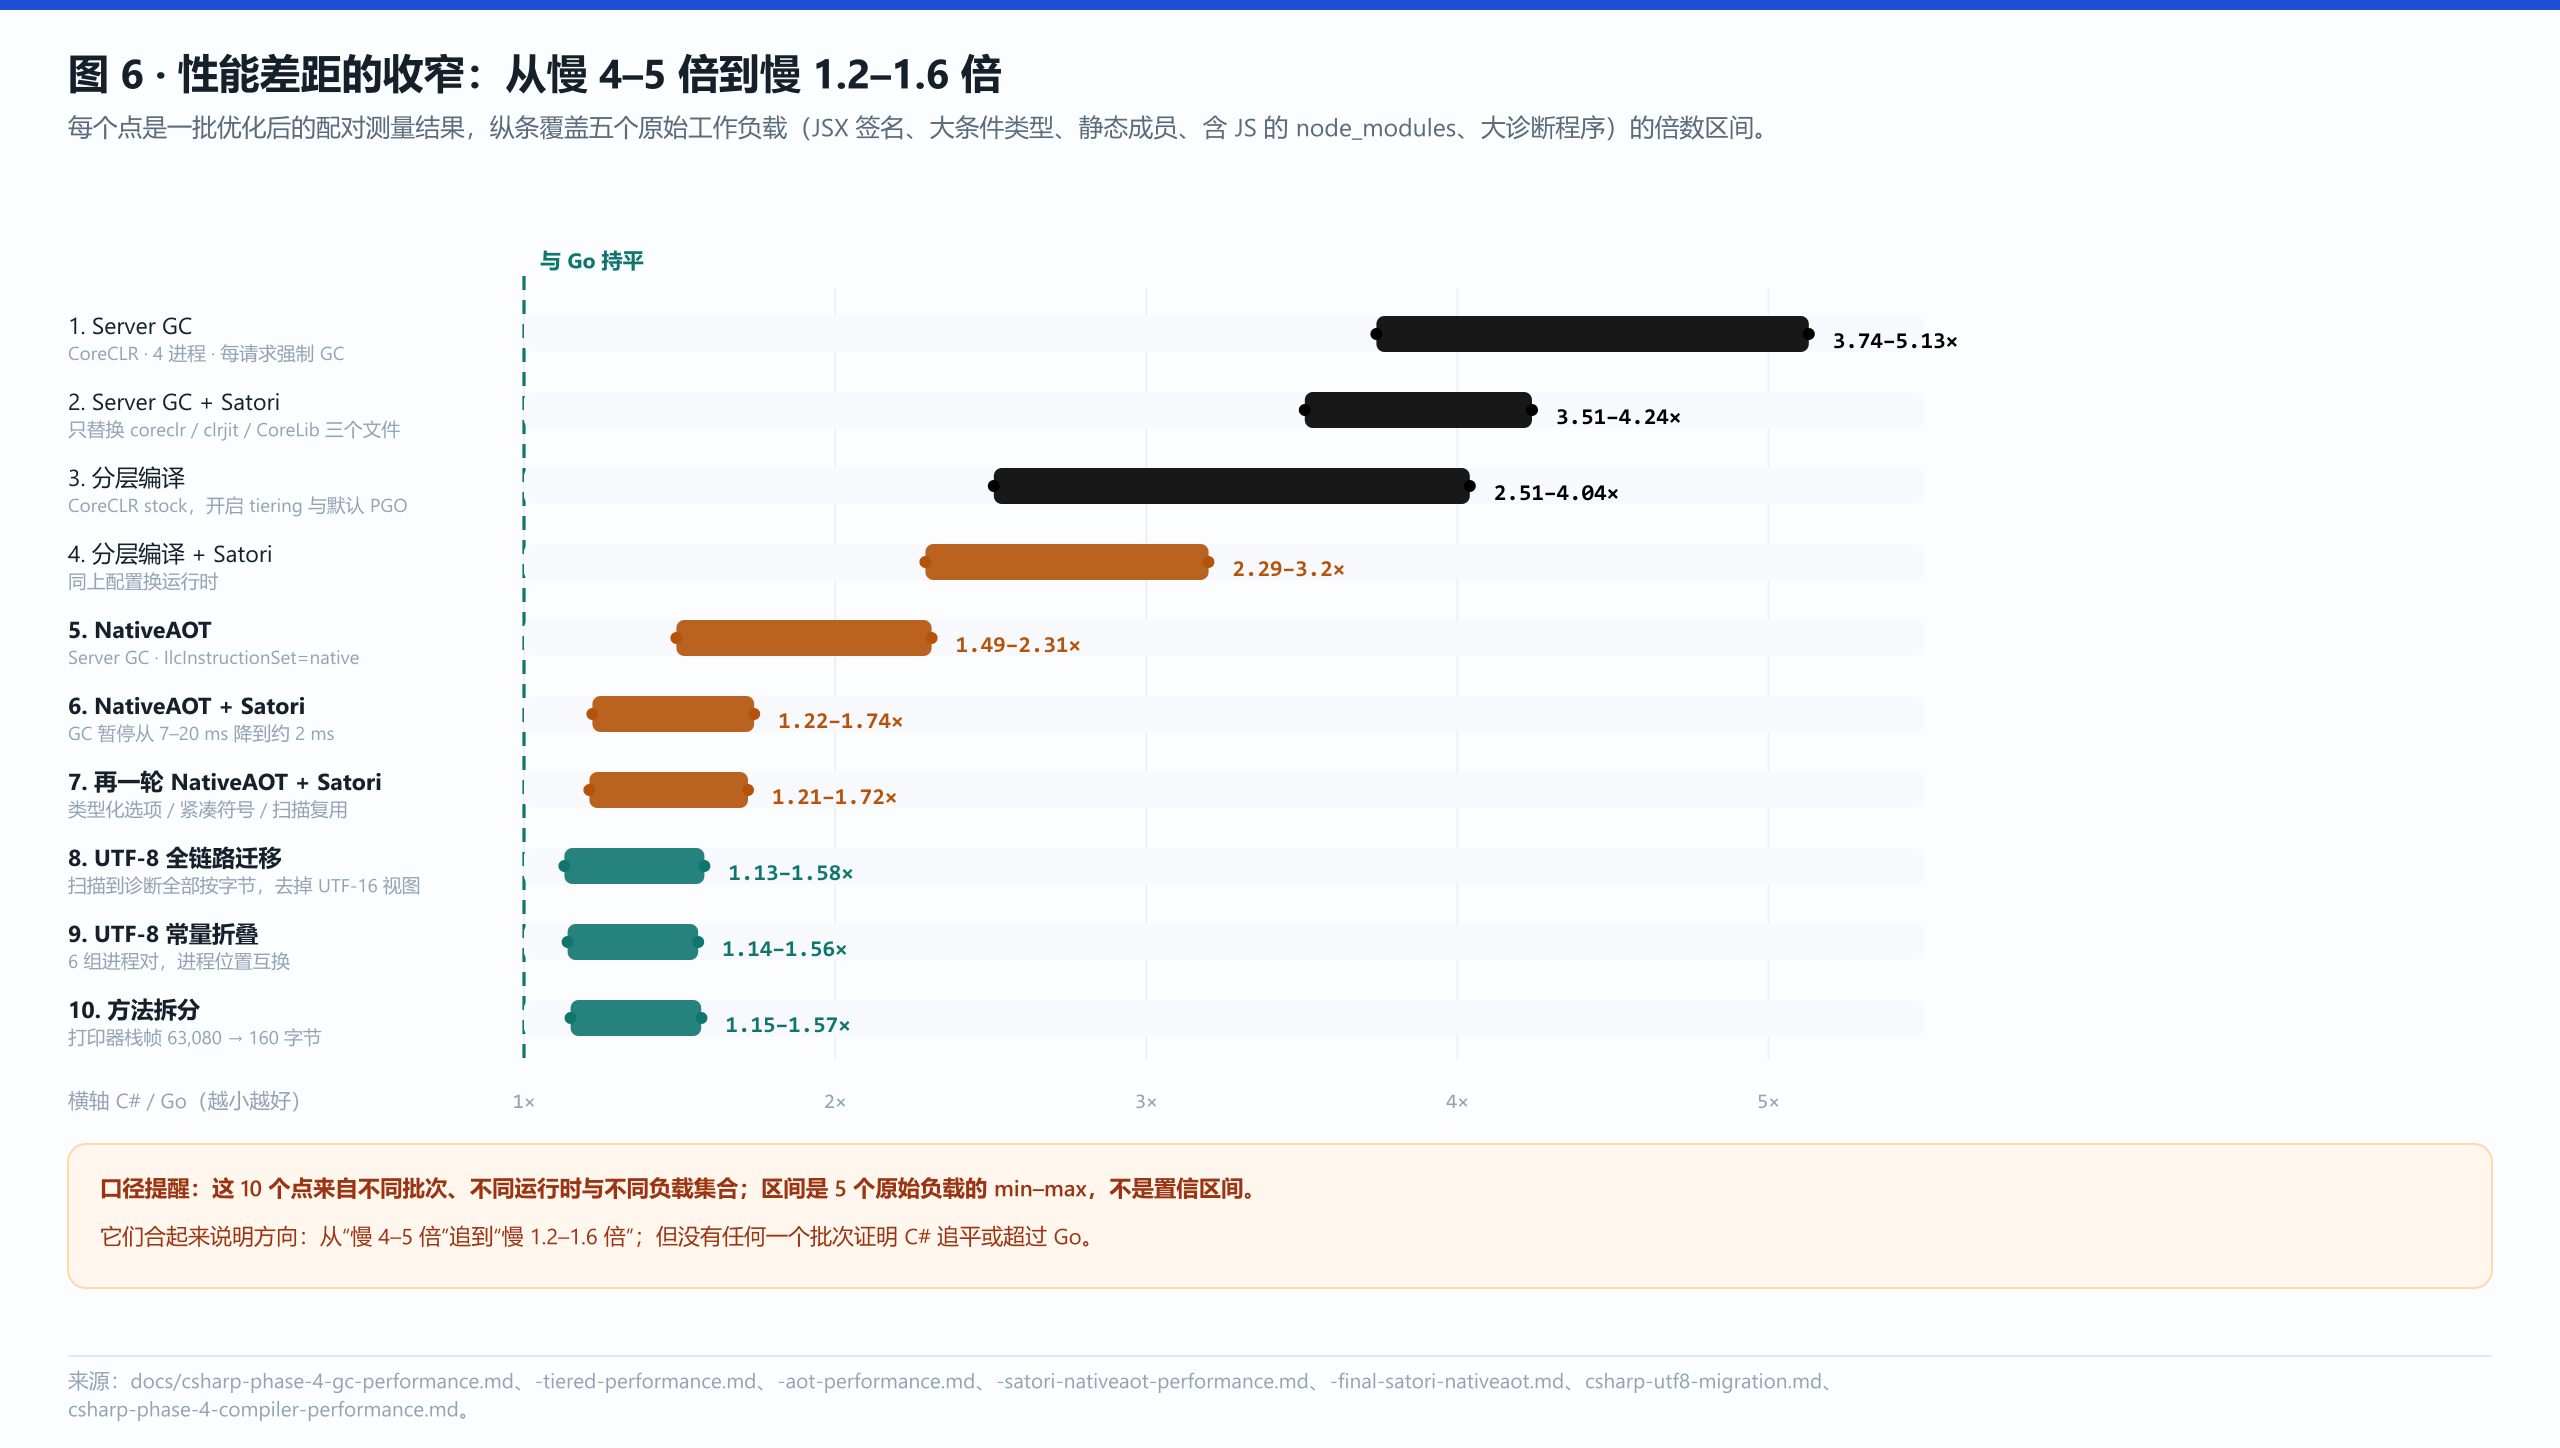
| 1 | Server GC | 3.74–5.13× |
| 2 | Server GC + Satori 运行时 | 3.51–4.24× |
| 3 | 分层编译(tiering + 默认 PGO) | 2.51–4.04× |
| 4 | 分层编译 + Satori | 2.29–3.20× |
| 5 | NativeAOT | 1.49–2.31× |
| 6 | NativeAOT + Satori | 1.22–1.74× |
| 7 | 再一轮 NativeAOT + Satori | 1.21–1.72× |
| 8 | UTF-8 全链路迁移 | 1.13–1.58× |
| 9 | UTF-8 常量折叠优化 | 1.14–1.56× |
| 10 | 大方法拆分 | 1.15–1.57× |
这张图最该配一句口径提醒(图层底部也写了):这 10 个点来自不同批次、不同运行时、不同负载集合,区间是 5 个原始负载的 min–max,不是置信区间。它们合起来只能说明方向。
方向之外的三个细节,我认为是这一节真正的信息量:
一、运行时确实贡献了一半以上的差距。 换掉 Satori 的 coreclr.dll / clrjit.dll / System.Private.CoreLib.dll 三个文件(应用二进制逐字节不变),GC 暂停中位数从 7.41 / 20.16 / 9.74 / 9.79 / 8.48 ms 降到 1.99 / 2.04 / 1.90 / 1.81 / 2.00 ms,整体中位耗时降 15.3–25.7%。但文档每次都补一句:因为 JIT 和 CoreLib 也换了,这是“运行时发行版比较”,不是“GC 单项替换”。代价是峰值工作集上升 17.3–64.3%。
二、剩下的差距集中在“程序构造”,不在“检查”。 这是最反直觉的一条。以 UTF-8 迁移后的最终数据为例:
| 大诊断程序 | 程序构造 | 20.23 ms | 15.17 ms |
| 大诊断程序 | 检查 | 3.23 ms | 1.04 ms |
| 大条件类型 | 程序构造 | 22.84 ms | 15.11 ms |
| 大条件类型 | 检查 | 45.63 ms | 45.37 ms |
大条件类型负载上检查时间几乎持平;差距在扫描/解析/绑定这些“构造”环节,而且是分布式的——CPU profile 显示没有一个占主导的多余操作,是解析器与绑定器的成本散落在各处。文档给的下一步线索很具体:The C# factory still allocates individual class nodes; Go uses typed arenas.(C# 工厂仍逐个分配类节点,Go 用类型化竞技场。)这也正好呼应第二节里 C# 分配字节数是 Go 的 3.07–4.13 倍这件事。
三、被拒绝的优化和保留的优化一样重要。 文档里有一整类“实验记录”是失败的:
- 常规 async 在 NativeAOT 下慢 30–53%,所以保留原生 async;
- 递归栈池化省了分配但耗时长,回退;
- 禁用面向大小的 LINQ 无收益,不作为项目设置;
- 拆分 Binder.DeclareNode 与 Checker.CheckSourceElementAsync 的复合分支:调度器和主栈帧变小了,但完整 NativeAOT 代码分别增长 14.9% 与 13.3%,五个文本控制负载中位变慢 1.6–3.2%,不保留;
- 用 BCL SIMD 搜索 ASCII 空白串,多数负载变慢,不保留。
保留的是两个:SymbolNodePrinter.Emit 与 LibraryFeatures.PropertyLibrary 的方法拆分。收益是可验证的——打印器原来每次调度都要预留并清零 63,080 字节栈帧,拆分后调度器只留 160 字节;符号节点打印器完整 NativeAOT 代码从 114,431 降到 80,568 字节(−29.6%)。
三类硬数据:省下来的操作、降下去的耗时、付出去的内存
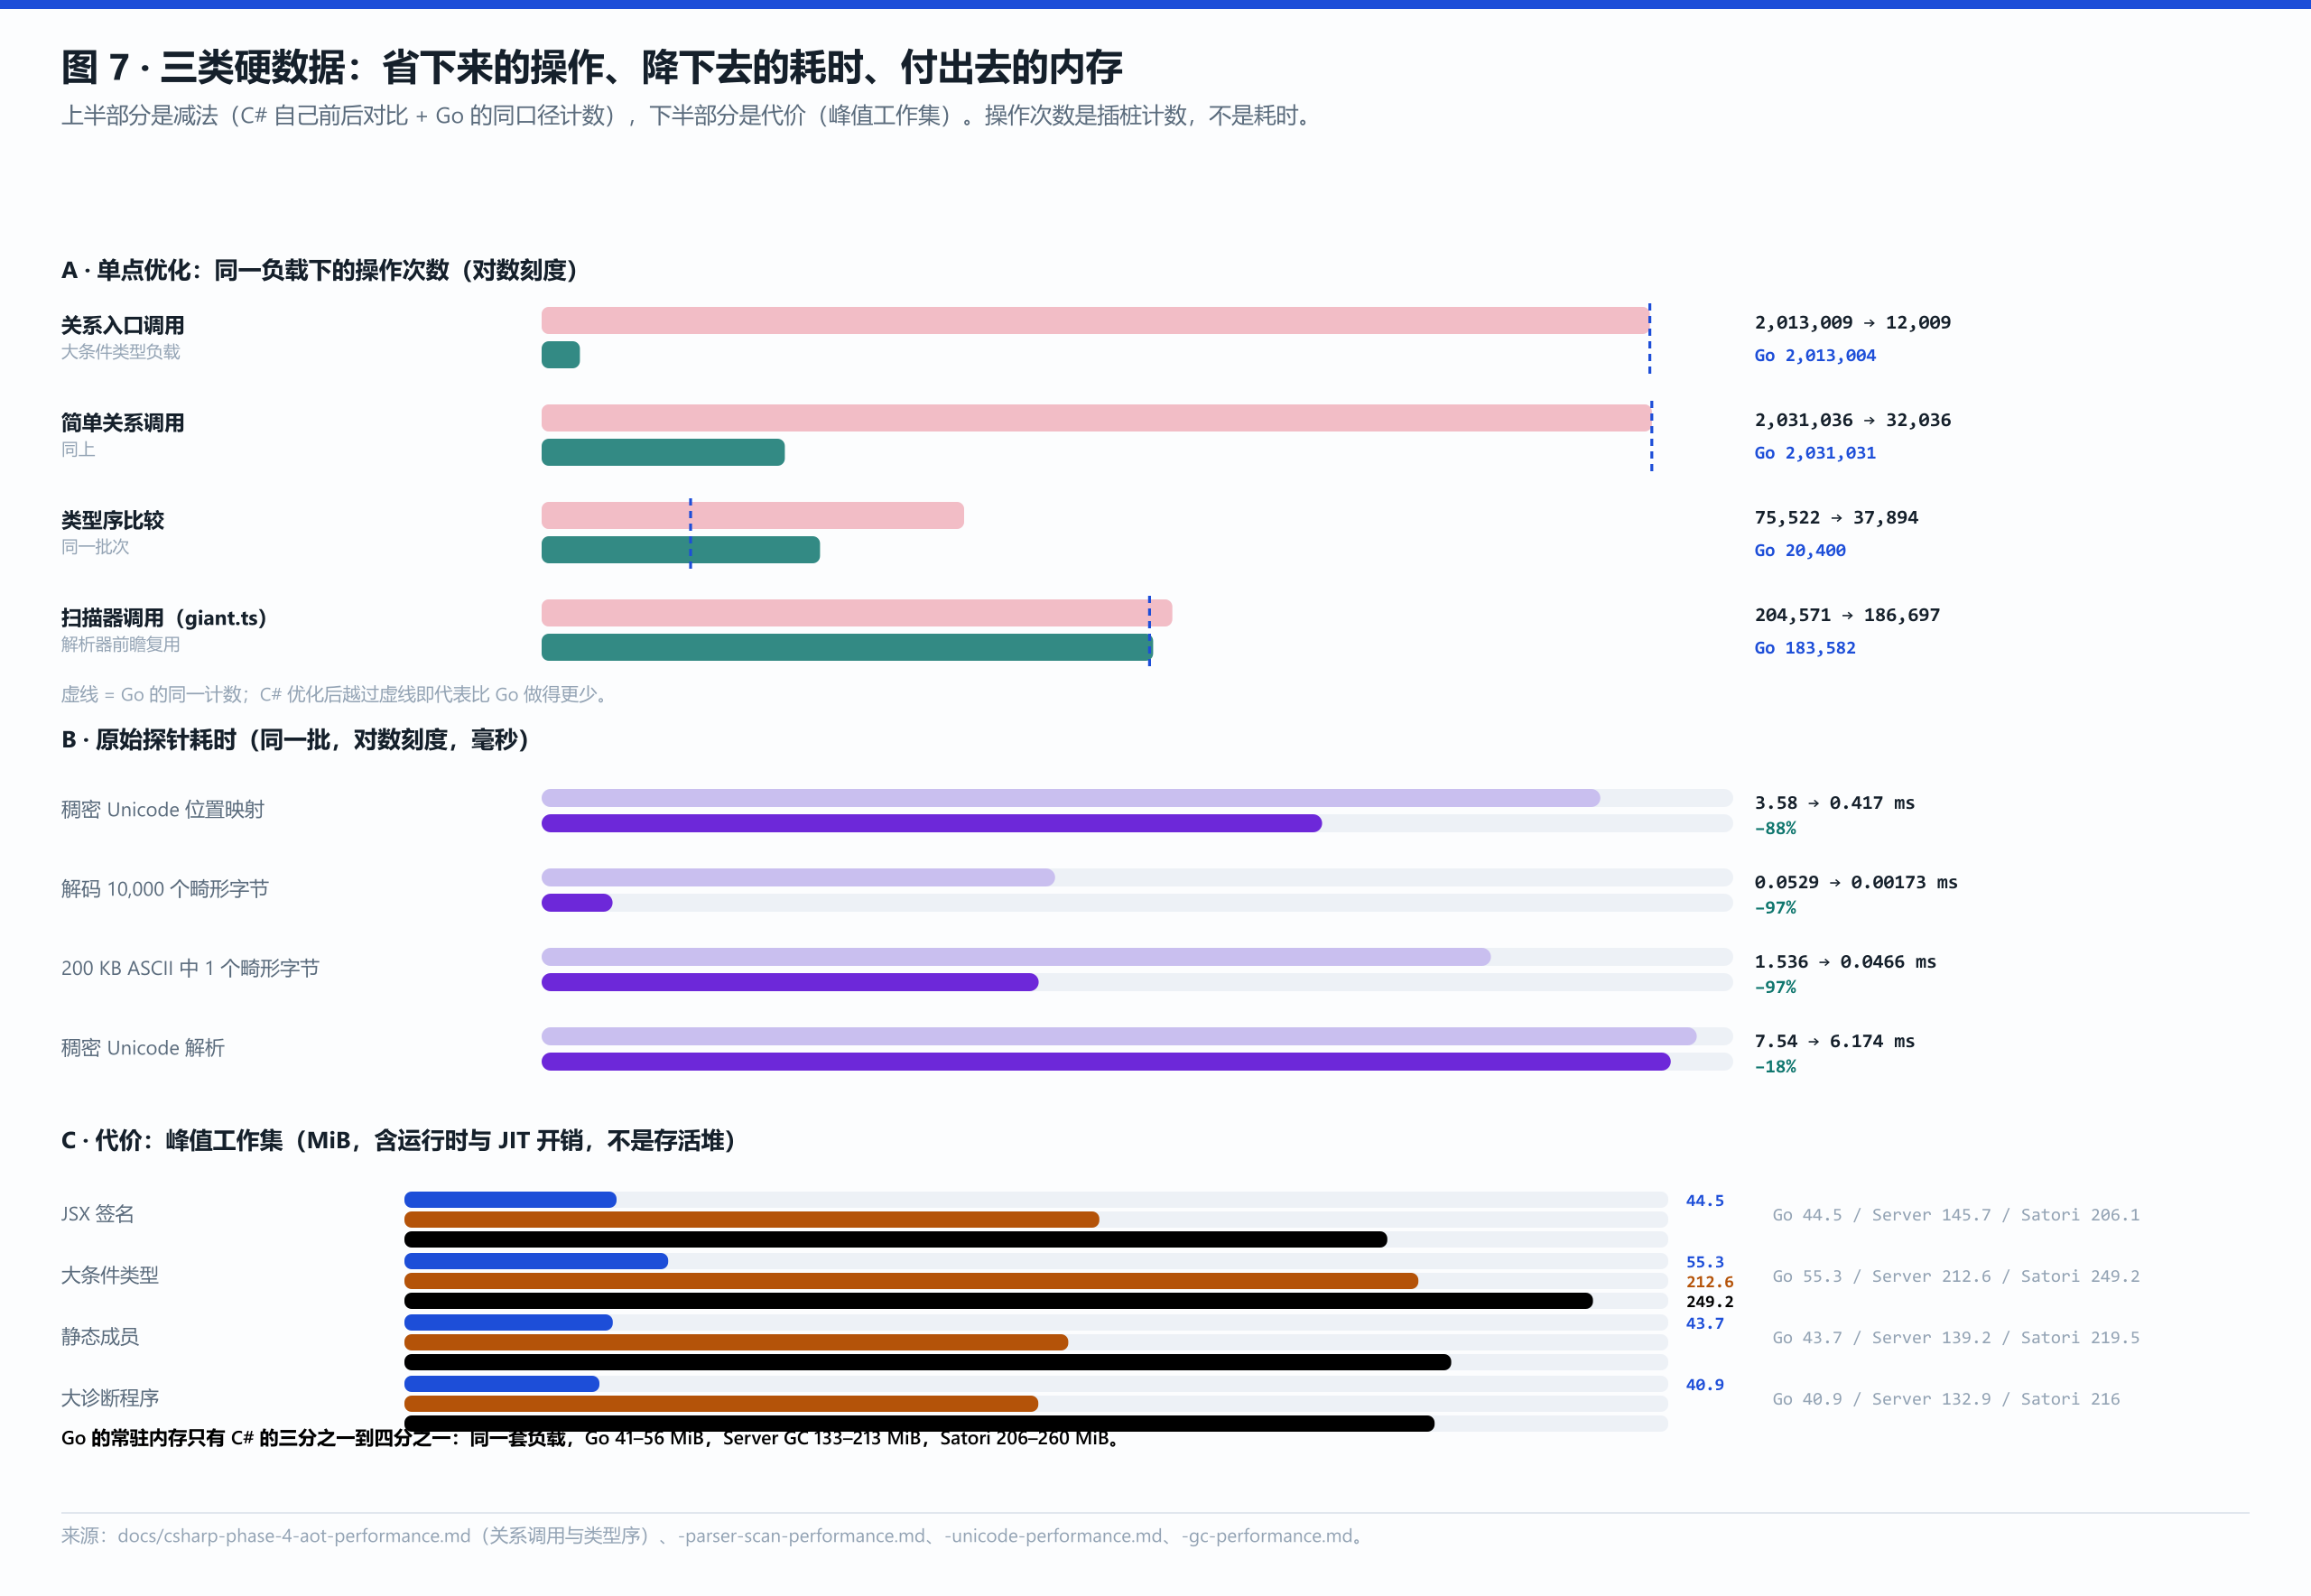
A. 省下来的操作次数(插桩计数,不是耗时):
| 关系入口调用 | 2,013,009 | 12,009 | 2,013,004 |
| 简单关系调用 | 2,031,036 | 32,036 | 2,031,031 |
| 类型序比较 | 75,522 | 37,894 | 20,400 |
| 扫描器调用(giant.ts) | 204,571 | 186,697 | 183,582 |
第一行的故事很清楚:C# 一开始和 Go 做了一样多的工作(2,013,009 vs 2,013,004),优化后降到 1.2 万次——减少了 99.4%。手法是先用恒等性回答“这个并集里是否已包含该类型”,而不是逐个问“是不是子类型”。类型序比较仍未追平 Go(37,894 vs 20,400),这一项是明确的未完成项。
B. 原始探针耗时:稠密 Unicode 位置映射 3.58 → 0.417 ms(−88%)、解码 10,000 个畸形字节 0.0529 → 0.00173 ms(−97%)、200 KB ASCII 中 1 个畸形字节 1.536 → 0.0466 ms(−97%)、稠密 Unicode 解析 7.540 → 6.174 ms(仅 −18%)。
C. 付出去的内存(峰值工作集,含运行时与 JIT 开销,不是存活堆):
| JSX 签名 | 44.5 | 145.7 | 206.1 |
| 大条件类型 | 55.3 | 212.6 | 249.2 |
| 静态成员 | 43.7 | 139.2 | 219.5 |
| 大诊断程序 | 40.9 | 132.9 | 216.0 |
Go 的常驻内存只有 C# 的三分之一到四分之一,而让耗时变好的 Satori 又比 Server GC 高出 17–64%。这是一个非常明确的取舍:当前所有速度改善都在拿内存换。
五、测试
都到这里了,我们必须测试一下,眼见为实。直接Clone项目,切换到typescript-cs分支,编译项目:
5.1 结果文件
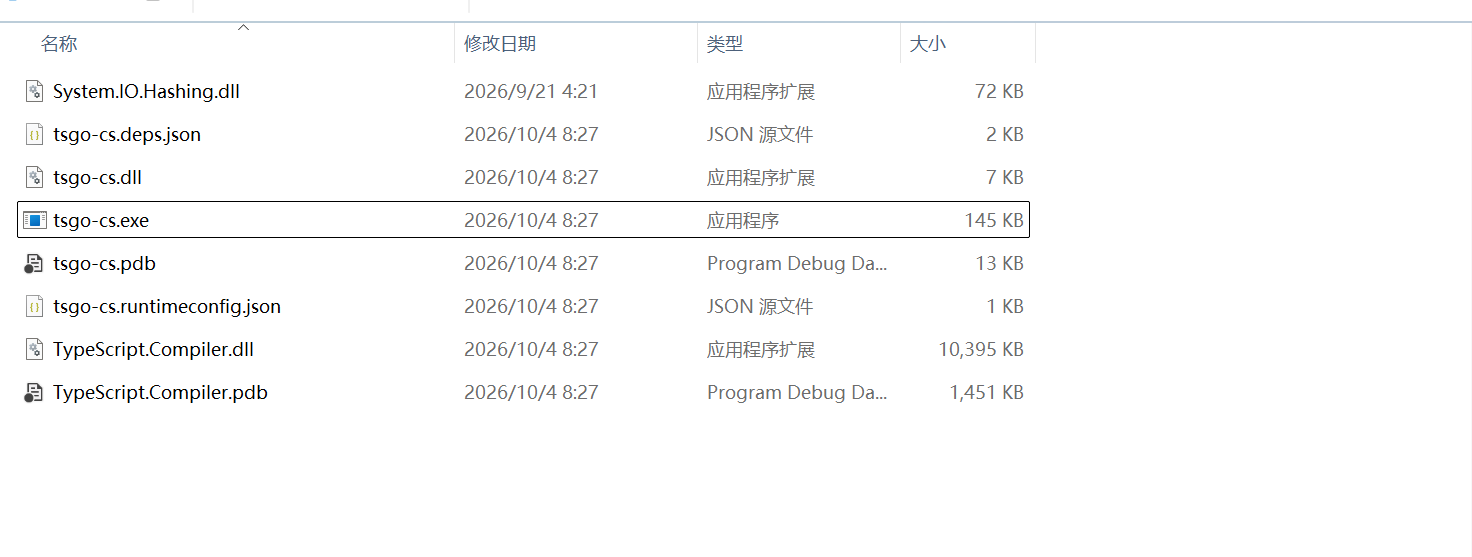
我们这里不Aot.反正就是Aot后也比不上Go
5.2 测试项目
就测试最简单的接口引用。直接开搞
\\\\user.ts
export interface User{
name: string;
id: number;
}
\\\\main.ts
import { User } from "./user";
let u: User= {name:"Test",id:1};
console.log(u.name);
直接编译
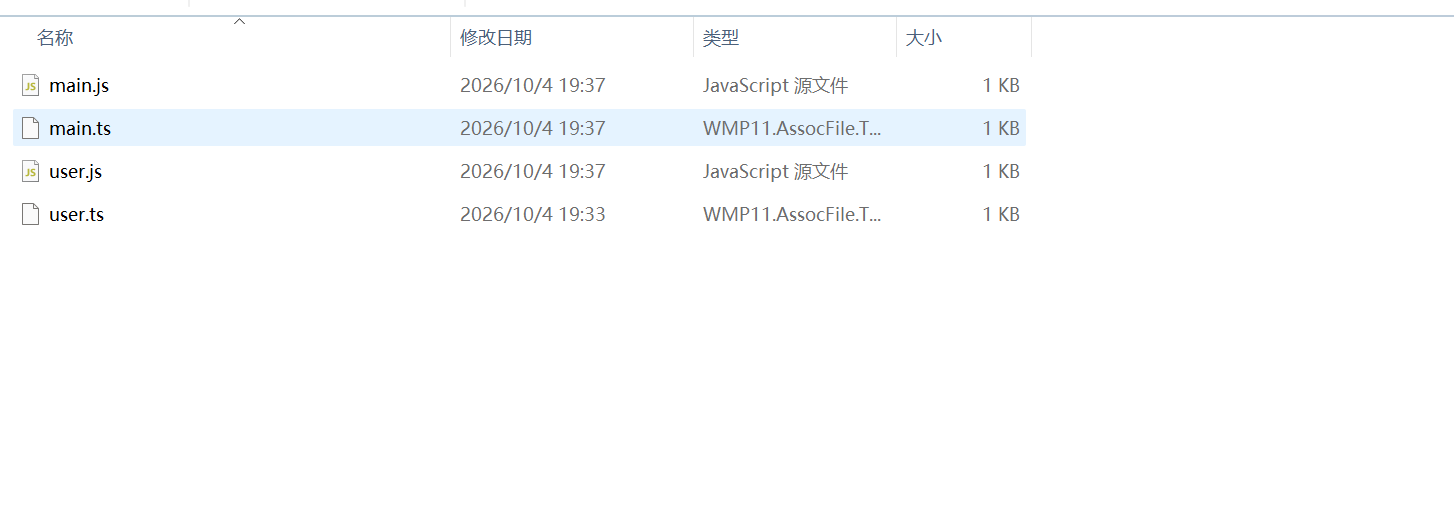
最终确实生成了标准的js文件,证明这确实是个实打实的项目,真的完成了ts的编译。
5.3 作者测试数据
作者做的测试结果
| Version startup | 28.1–29.5 | 179.8 | 30.7 | 33.2 | 31.6 |
| 64-module build | 54.9–56.6 | 1114.5 | 208.0 | 217.5 | 196.3 |
| Declaration-only build | 52.4–53.3 | 921.7 | 150.1 | 156.0 | 133.5 |
| 512-file build | 80.0–81.9 | 943.7 | 221.0 | 238.4 | 235.2 |
| Large-file build¹ | 299.8–302.1 | 3195.3 | 1100.7 | 995.9 | 900.3 |
| 512-file incremental edit | 88.5–95.0 | 1020.8 | 267.0 | 281.6 | 266.9 |
| Project-reference no-op | 30.1–30.8 | 259.9 | 35.1 | 37.4 | 35.5 |
大文件的编译Go快3倍。512个文件的编译,Go快4倍了。性能上确实有很大差距。这已经是C#用上AOT和Satori GC的结果。
六、结论
其实到这里。我不太想下结论,因为这并不是一个完整的项目。比Go版本还是有不少差距,直接比较并不公平。但心里的那一丝丝不平,是不是可以可以抚平了。C#是个优秀的语言,但是确实不是所有地方就能做到最好,就算可以,可能还需要花费很大的精力来搞。
我们再往深处想,现在是AI时代了,我们所有语言都在迎来巨变,指挥AI用Rust来写程序,一上来性能就不差.Typescript选择了Go,Github Copilot选择了Rust。我们C#还有多少自留地可以守住,未来未知。
以上今天的所有内容。我是搬砖工。多多关注点赞,您的支持是我更新的最大动力。
