🏆 本文收录于 《YOLOv9实战:从入门到深度优化》 专栏。
该专栏系统复现并深度梳理全网主流 YOLOv9 改进方法与工程实战案例,覆盖分类、目标检测、实例分割、多目标追踪、关键点检测、旋转目标检测等多个方向,坚持 持续更新 + 深度解析 + 工程验证。
专栏将围绕 YOLOv9 的网络结构、训练策略、损失函数、数据增强、模型压缩、推理加速与部署落地等内容展开,重点分析 Programmable Gradient Information(PGI)、GELAN 等核心设计思想,并结合实际项目讲解其改进方式与应用价值。
部分章节还会结合国内外前沿论文与 AIGC 大模型技术,对主流改进方案进行重构与再设计,使内容更加贴近真实业务场景,适合希望深入研究 YOLOv9 或具有工程落地需求的开发者学习与参考。
🎯限时特惠:当前活动一折秒杀,一次订阅,终身有效,后续所有更新章节全部免费解锁 👉 传送门 👈️ 🎉本专栏还不够过瘾?别急,好戏才刚刚开始!我已经为你准备了一整套 YOLO 进阶实战大礼包🎁:
👉《YOLOv8实战》 👉《YOLOv9实战》 👉《YOLOv10实战》 👉《YOLOv11实战》 👉《YOLOv12实战》 👉以及最新上线的 《YOLOv26实战》
想一次搞定所有版本?直接冲 《YOLO全栈实战合集》,一站式涵盖 YOLO 各版本实战教学!
🚀想学哪个版本?直接找 bug 菌“许愿”,安排!必须安排!🚀
🎯 本文定位:计算机视觉 × YOLOv9 生成式 AI 与自动标注篇 📅 预计阅读时间:约 45~60 分钟 🏷️ 难度等级:⭐⭐⭐⭐☆(高级) 🔧 技术栈:Python 3.9+ · PyTorch 2.0+ · YOLOv9 · ByteTrack · OpenCV · NumPy
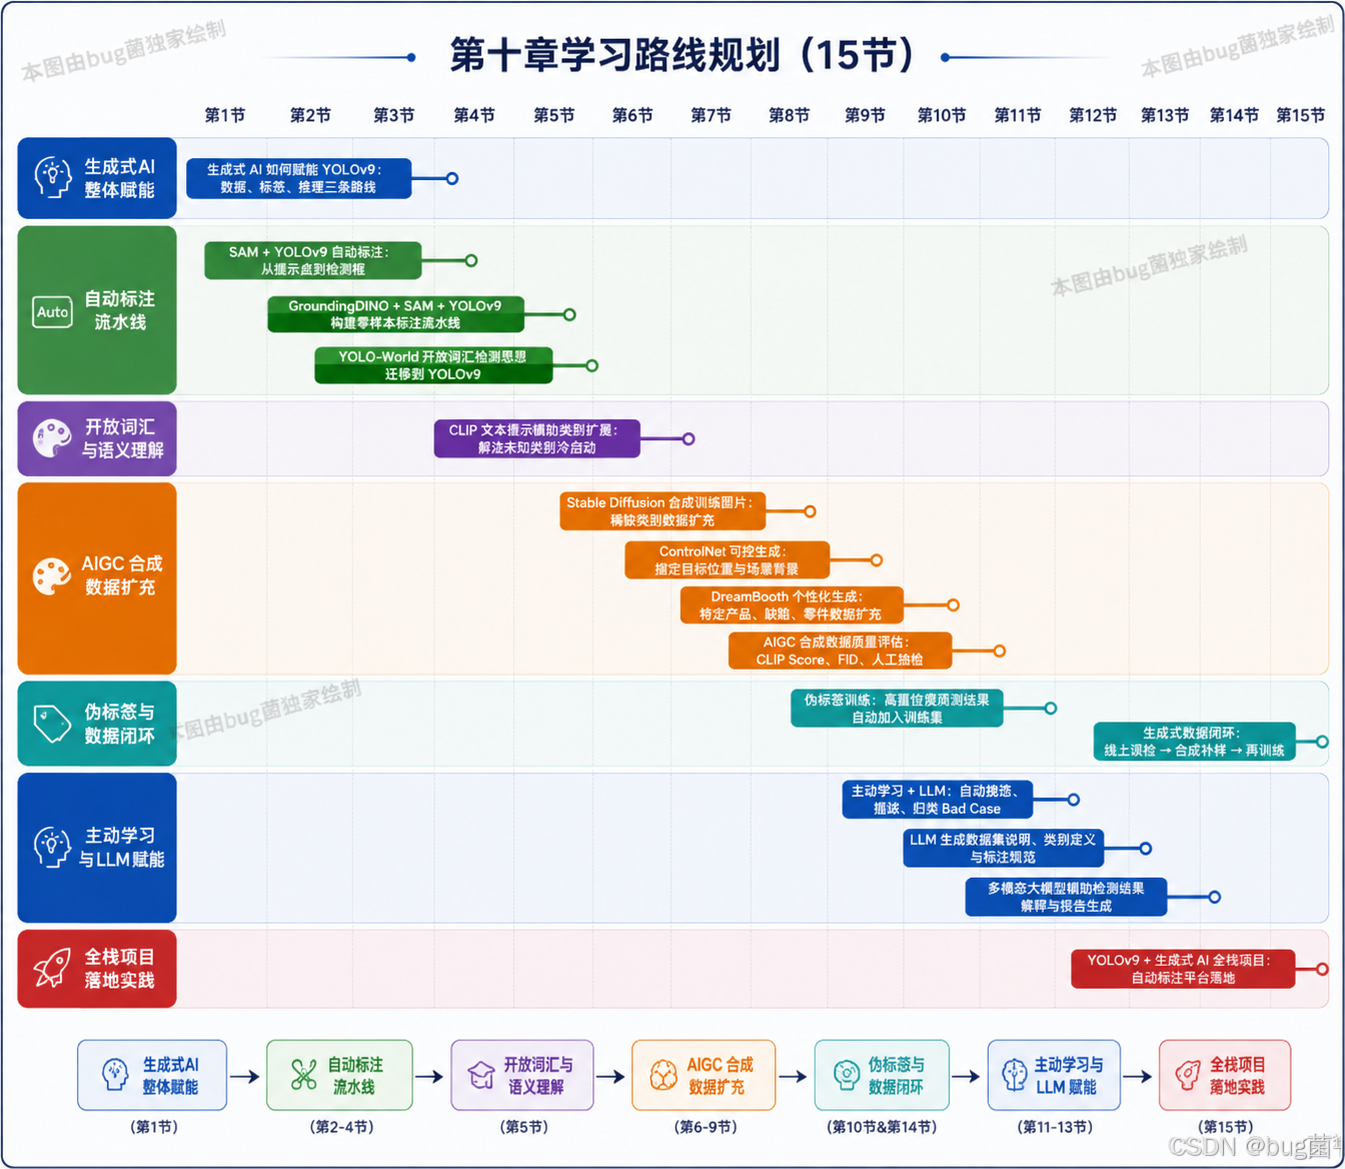
全文目录:
-
- 🔁 上期回顾
- 🎯 本节主题:生成式数据闭环——线上误检 → 合成补样 → 再训练
-
- 一、为什么需要\”闭环\”?从一个真实的痛点说起
- 二、闭环的整体架构设计
- 三、第一阶段:线上误检的自动捕获
-
- 3.1 什么算\”误检\”?定义采集策略
- 3.2 误检采集器的实现
- 四、第二阶段:误检原因的智能分析
-
- 4.1 误检原因的分类框架
- 4.2 基于LLM的误检原因分析器
- 4.3 为什么分两步(规则 + LLM)?
- 五、第三阶段:生成式补样——让模型\”脑补\”训练数据
-
- 5.1 生成策略总览
- 5.2 核心生成模块:Stable Diffusion 稀缺类别补充
- 5.3 生成策略的提示词工程
- 六、第四阶段:自动标注与质量过滤
-
- 6.1 合成数据质量过滤管道
- 七、第五阶段:增量训练的触发与执行
-
- 7.1 什么时候触发增量训练?
- 7.2 增量训练管理器
- 八、整合:完整的闭环编排器
-
- 8.1 完整闭环的使用示例
- 九、增量训练的关键技术细节
-
- 9.1 灾难性遗忘问题
- 9.2 学习率设置的原则
- 9.3 层冻结策略
- 十、闭环系统的监控与可观测性
- 十一、工程落地的几个坑与经验
-
- 坑1:合成数据的\”分布欺骗\”问题
- 坑2:触发阈值的设置需要领域知识
- 坑3:合成数据占比要有上限
- 坑4:增量训练的模型热更新不能裸换
- 十二、完整数据流的一次端到端演示
- 📋 本节要点总结
- 🔭 下期预告:第15节——YOLOv9 + 生成式 AI 全栈项目:自动标注平台落地
- 📌 附录
- 🧧🧧 文末福利,等你来拿!🧧🧧
- 🫵 Who am I?
写在前面:这一节是我个人觉得整个第十章里最\”解渴\”的一节。前面十三节我们拆开了看:合成数据怎么生成、标注怎么自动化、报告怎么用大模型来写……但工程里最折磨人的问题从来不是某一环做不好,而是这些环节怎么串起来,怎么让系统自己发现问题、自己补数据、自己变得更好。闭环这件事,说起来容易,真正落地需要把每一块都踩扎实。这节就带你把这条链路从头到尾走一遍。
🔁 上期回顾
在上期《YOLOv9【第十章:生成式 AI 与自动标注篇·第13节】多模态大模型辅助检测结果解释与报告生成!》内容中,我们聊的是\”让AI给AI的输出写报告\”这件事。YOLOv9跑完推理,给你一堆框和置信度,这些原始输出对业务人员来说几乎是天书。第13节的核心思路是:把检测结果、置信度分布、误检统计这些结构化数据,连同原始图像一起喂给多模态大模型(如GPT-4V、Qwen-VL、InternVL等),让模型用自然语言帮你解读\”这张图检测到了什么、置信度为什么偏低、可能的漏检原因是什么\”。
我们实现了几个关键功能:
① 检测结果结构化描述:将YOLO输出的bbox坐标、类别、置信度转换成自然语言描述,配合原图让多模态模型生成\”这张图中左上角有一个置信度0.43的行人,检测框偏小,可能存在遮挡\”这样的解读。
② 批量Bad Case报告生成:筛选出低置信度预测与人工标注不一致的样本,批量送入LLM,