💥💥💞💞欢迎来到本博客❤️❤️💥💥
🏆博主优势:🌞🌞🌞博客内容尽量做到思维缜密,逻辑清晰,为了方便读者。
🎁完整资源、论文复现、期刊合作、论文辅导及科研仿真定制事宜点击:
👉👉👉本文完整资源下载
⛳️座右铭:行百里者,半于九十。
⛳️赠与读者
👨💻做科研,涉及到一个深在的思想系统,需要科研者逻辑缜密,踏实认真,但是不能只是努力,很多时候借力比努力更重要,然后还要有仰望星空的创新点和启发点。建议读者按目录次序逐一浏览,免得骤然跌入幽暗的迷宫找不到来时的路,它不足为你揭示全部问题的答案,但若能解答你胸中升起的一朵朵疑云,也未尝不会酿成晚霞斑斓的别一番景致,万一它给你带来了一场精神世界的苦雨,那就借机洗刷一下原来存放在那儿的“躺平”上的尘埃吧。
或许,雨过云收,神驰的天地更清朗…….🔎🔎🔎
💥第一部分——内容介绍
从场景到决策:数据驱动的电热综合能源系统分布鲁棒优化研究
摘要
电热综合能源系统通过热电联产、电锅炉等耦合设备实现电能与热能的协同调度,是提升可再生能源消纳能力的重要载体。然而,风电、光伏出力的间歇性与负荷需求的波动性使得系统调度面临严峻的不确定性挑战。传统鲁棒优化以最恶劣场景为决策依据,虽保证了安全性却牺牲了经济性;随机规划依赖精确的概率分布假设,而实际中可获取的数据往往难以支撑这一假设。本文系统梳理数据驱动分布鲁棒优化在电热综合能源系统中的方法论进展,重点分析多离散场景生成与削减、综合范数模糊集构建、两阶段优化架构及求解策略等关键技术环节。研究表明,以条件生成对抗网络与K-medoids聚类相结合的场景处理范式,配合1-范数与∞-范数联合约束的概率分布模糊集,能够在数据有限条件下实现经济性与鲁棒性的有效权衡。本文进一步讨论了场景生成质量评估、模糊集参数自适应以及计算可扩展性等开放问题,为后续研究提供参考。
关键词: 分布鲁棒优化;电热综合能源系统;数据驱动;多离散场景;模糊集;两阶段调度
1 引言
1.1 研究背景
“双碳”目标的推进正在深刻重塑能源系统的结构与运行方式。在这一转型进程中,电热综合能源系统因其能够打破传统电力与供热系统之间的壁垒、实现多能互补与协同优化,被视为提升能源利用效率、促进可再生能源消纳的关键技术路径。热电联产机组在发电的同时回收余热,电锅炉将富余电能转化为热能存储或利用,热网本身具备的惯性又为系统提供了天然的缓冲能力——这些特性使电热耦合系统在应对可再生能源波动时拥有比单一电力系统更大的灵活性空间。
然而,灵活性空间的拓展并不自动消解不确定性问题,而是将其转化为更为复杂的调度决策问题。当风电和光伏的出力预测误差同时作用于电力平衡与热力平衡时,调度决策需要在电、热两种能量流之间寻找协调方案:电锅炉的启停影响电力净负荷,热电联产机组的出力分配同时牵动电与热的供需关系,热网的储热特性虽可缓冲热力波动,但这种缓冲能力的释放又受到温度约束和流量调节能力的限制。这种多维耦合的不确定性传导机制,使得电热综合能源系统的调度问题在方法论上具有独特的研究价值。
1.2 不确定性建模的三种范式
从方法论演进的角度审视,应对不确定性的优化调度策略大致经历了三种范式的更替。
随机优化是最早被广泛采用的方法。它假设不确定性变量服从某种已知的概率分布,通过场景采样或解析方法将随机问题转化为确定性等价形式。在电热综合能源系统的早期研究中,风电出力和负荷需求常被建模为服从正态分布或Beta分布的随机变量。这种方法的优势在于能够利用概率信息获得期望意义下的最优决策,但其脆弱性同样明显:当实际分布偏离假设分布时,优化结果的性能可能显著退化。更根本的问题在于,精确的概率分布本身就是一个难以获取的信息。
鲁棒优化采取了截然不同的策略。它放弃对概率分布的依赖,转而定义一个不确定性集合——通常是一个有界区间或多面体——并要求决策在所有可能的不确定性实现下均满足约束。这种方法保证了“最坏情况下的可行性”,但其代价是决策的过度保守。对于电热综合能源系统而言,过度的保守性意味着不必要的机组出力上调、储能冗余配置以及由此带来的经济性损失。当不确定性集合的边界由极端场景确定时,调度方案可能需要为发生概率极低的组合场景付出高昂的预留成本。
分布鲁棒优化(Distributionally Robust Optimization, DRO)正是在这一张力中产生的第三种范式。它的核心思想是:不假定概率分布已知,但也不完全放弃分布信息。相反,DRO构建一个“模糊集”(ambiguity set)——即一族与经验数据“足够接近”的概率分布的集合——并在此集合的最坏分布下优化期望成本。这一思想可以追溯至Scarf(1958)的经典工作,但直到近年来数据可得性的提升和计算能力的进步,DRO才在能源系统领域获得实质性的应用拓展。
1.3 数据驱动DRO的兴起
数据驱动分布鲁棒优化的兴起,根植于一个朴素而深刻的观察:在实际工程中,概率分布不可知,但历史数据可得。风电场的SCADA系统持续记录出力数据,负荷监测装置积累着用电模式,这些数据虽不足以精确刻画真实分布,却包含关于分布形状的宝贵信息。DRO的方法论价值在于,它提供了一种将数据信息“温和地”纳入决策过程的机制——既不盲目信任数据(如随机优化),也不完全忽视数据(如传统鲁棒优化)。
在电热综合能源系统的语境下,这一方法论转向具有特殊的意义。与纯电力系统不同,电热耦合系统的不确定性源更为多样:除了风电和光伏出力波动外,热负荷本身受气象条件、用户行为、建筑热惯性等多因素影响,其概率分布形态往往难以用参数化模型准确描述。同时,可获取的历史数据量往往有限——新建系统可能仅有数月的运行记录,供热数据的采集频率和覆盖范围也常不及电力数据。这些现实约束使得DRO的“数据效率”优势尤为突出:即使在样本有限的情况下,通过合理构建模糊集,仍可获得比传统方法更优的决策。
1.4 本文的结构
本文围绕数据驱动分布鲁棒优化在电热综合能源系统中的方法论展开系统论述。第2节分析多离散场景的生成与削减方法,这是DRO的数据基础;第3节讨论模糊集的构建策略,特别是综合范数约束的建模逻辑;第4节阐述两阶段优化架构与求解策略;第5节综述现有研究中的典型技术路线与实证发现;第6节讨论当前研究的局限与未来方向。
2 多离散场景:DRO的数据基础
2.1 场景生成的两条技术路线
分布鲁棒优化的决策质量,在很大程度上取决于用以构建模糊集的经验分布是否充分捕捉了不确定性变量的统计特征。场景生成方法因此成为DRO流程中的第一个关键环节。
在电热综合能源系统的DRO研究中,场景生成主要沿两条技术路线展开。第一条路线采用传统的统计采样方法,如拉丁超立方采样(Latin Hypercube Sampling, LHS)。LHS通过对每个不确定性维度进行分层采样,能够在较少的样本量下获得对输入分布较好的覆盖。其优势在于实施简便、计算成本低,适合对不确定性变量的边缘分布有基本了解的场景。然而,LHS的局限同样明显:它假设各维度之间相互独立,当风电出力的空间相关性或电-热负荷之间的耦合关系需要被保留时,LHS的采样结果可能无法准确反映这些依赖结构。
第二条路线则借助深度学习技术,特别是条件生成对抗网络(Conditional Generative Adversarial Networks, CGAN),直接从历史数据中学习不确定性变量的联合分布。CGAN的核心思想是让生成器与判别器在条件信息的引导下进行博弈:生成器试图从随机噪声中生成以特定条件(如预测值、时间标签)为条件的逼真场景,判别器则试图区分真实数据与生成数据。经过充分训练后,生成器能够产生在统计特征上与历史数据难以区分的合成场景。相较于LHS,CGAN的优势在于它能够以非参数化的方式捕捉复杂的高维依赖关系,包括风光出力的时空相关性以及电、热负荷之间的耦合波动模式。
2.2 场景削减的必要性与方法
无论采用何种生成方法,初始场景集往往规模庞大。对于包含多个不确定性维度和多个时段的调度问题,直接使用数千个场景进行优化计算将面临严峻的可扩展性挑战。因此,场景削减成为必要的预处理步骤。
K-medoids聚类算法在电热综合能源系统的DRO研究中被广泛采用。与K-means聚类不同,K-medoids选择实际存在的场景作为聚类中心,这一特性使其对异常值更为鲁棒,同时保留了真实场景的物理合理性。聚类数目通常通过手肘法或轮廓系数等指标确定,在场景的代表性与计算复杂度之间寻求平衡。
场景削减的质量直接影响模糊集的构造质量。如果削减后的典型场景无法充分代表原始数据的分布特征,模糊集可能会偏离真实分布,导致决策的鲁棒性不足或过度保守。然而,当前研究中对场景削减质量的定量评估尚不充分,多数工作仅报告聚类数目而缺乏对代表性指标的深入分析。
2.3 多离散场景集的结构特征
经过生成与削减后得到的多离散场景集,具有几个值得关注的结构特征。首先,场景集通常包含有限数量的典型场景(如10-50个),每个场景对应一个多维不确定性向量的实现。其次,每个典型场景被赋予一个概率权重,这些权重来自聚类过程中各类簇的样本占比,构成了对经验分布的离散近似。第三,场景集的质量与历史数据的数量、质量及覆盖范围密切相关——数据不足或偏差将直接传导至最终决策。
这些特征决定了DRO方法的适用边界:当历史数据丰富且具有代表性时,基于多离散场景的DRO能够有效逼近真实的最优决策;当数据稀缺或存在系统性偏差时,模糊集需要适当“膨胀”以覆盖潜在的分布偏移风险。
3 模糊集构建:从数据到不确定性的桥梁
3.1 模糊集作为“分布的距离球”
模糊集是DRO方法论的核心构件。它的直观含义是:真实的概率分布“应该”落在距离经验分布不太远的地方。模糊集通过一个“半径”参数来控制这种“不太远”的程度——半径越大,模糊集覆盖的分布范围越广,决策越保守;半径越小,模糊集越集中于经验分布附近,决策越依赖数据。
这一思想将模糊集的构建问题转化为两个子问题:选择何种“距离”或“散度”来度量分布之间的差异,以及如何确定合适的半径。在电热综合能源系统的DRO研究中,基于范数约束的模糊集构建方式获得了最为广泛的应用。
3.2 综合范数约束的建模逻辑
基于1-范数和∞-范数联合约束的模糊集构建方法,是当前电热综合能源系统DRO研究中的主流技术选择。其基本逻辑可表述为:将真实分布与经验分布之间的差异分解为两个维度,分别用不同的范数进行约束。
1-范数约束关注的是概率质量的“总量偏移”。它限制了真实分布中所有场景的概率值与经验概率值之间的绝对偏差之和。这一约束的作用是防止某一场景的概率被严重高估或低估,确保分布的整体形状不偏离数据太远。
∞-范数约束则关注“最大单项偏移”。它限制的是任意单个场景的概率值与经验值之间的最大偏差。这一约束对极端概率偏移更为敏感,防止某个场景的概率被赋予异常高或异常低的值。
两种范数的联合使用产生了一种互补效应:1-范数提供全局约束,防止分布整体“漂移”;∞-范数提供局部约束,防止个别场景的概率“失控”。这种双重约束结构使得模糊集既不过于宽泛(导致过度保守),也不过于狭窄(导致对数据过拟合),在稳健性与经济性之间提供了更精细的调节能力。
3.3 置信水平与样本量的关联
综合范数模糊集的半径并非任意设定,而是与置信水平和样本量之间存在理论关联。根据相关研究的结果,1-范数约束的半径通常与样本量的平方根成反比,而∞-范数约束的半径则与样本量的对数相关。这意味着随着历史数据量的增加,模糊集可以以更快的速率收缩,决策能够更加信任数据所提供的信息。
这一理论关联为实际应用提供了参数设定的依据。调度人员可以根据可用历史数据的规模,确定置信水平(如0.95或0.99),进而计算出合理的范数半径。这种数据驱动的参数确定方式,避免了传统鲁棒优化中不确定性集合边界依赖主观判断的问题。
3.4 其他模糊集构造方法的比较
除了综合范数约束外,基于Wasserstein距离的模糊集也受到关注。Wasserstein距离度量的是将一个分布“搬运”为另一个分布所需的最小“成本”,具有更好的几何直观性,且对支撑集的变化更为敏感。然而,Wasserstein模糊集在优化问题中的处理通常涉及更复杂的对偶变换,计算负担相对较高。
条件分布鲁棒优化是另一个值得关注的变体。传统DRO的模糊集不区分条件信息,而条件DRO则允许模糊集依赖于可观测的条件变量(如风电预测值)。这一改进能够捕捉不确定性分布随条件变化而变化的特征,在风电预测误差与预测值存在依赖关系时具有明显优势。然而,条件DRO的建模复杂度更高,在电热综合能源系统中的应用仍处于探索阶段。
4 两阶段优化:架构与求解
4.1 两阶段架构的决策逻辑
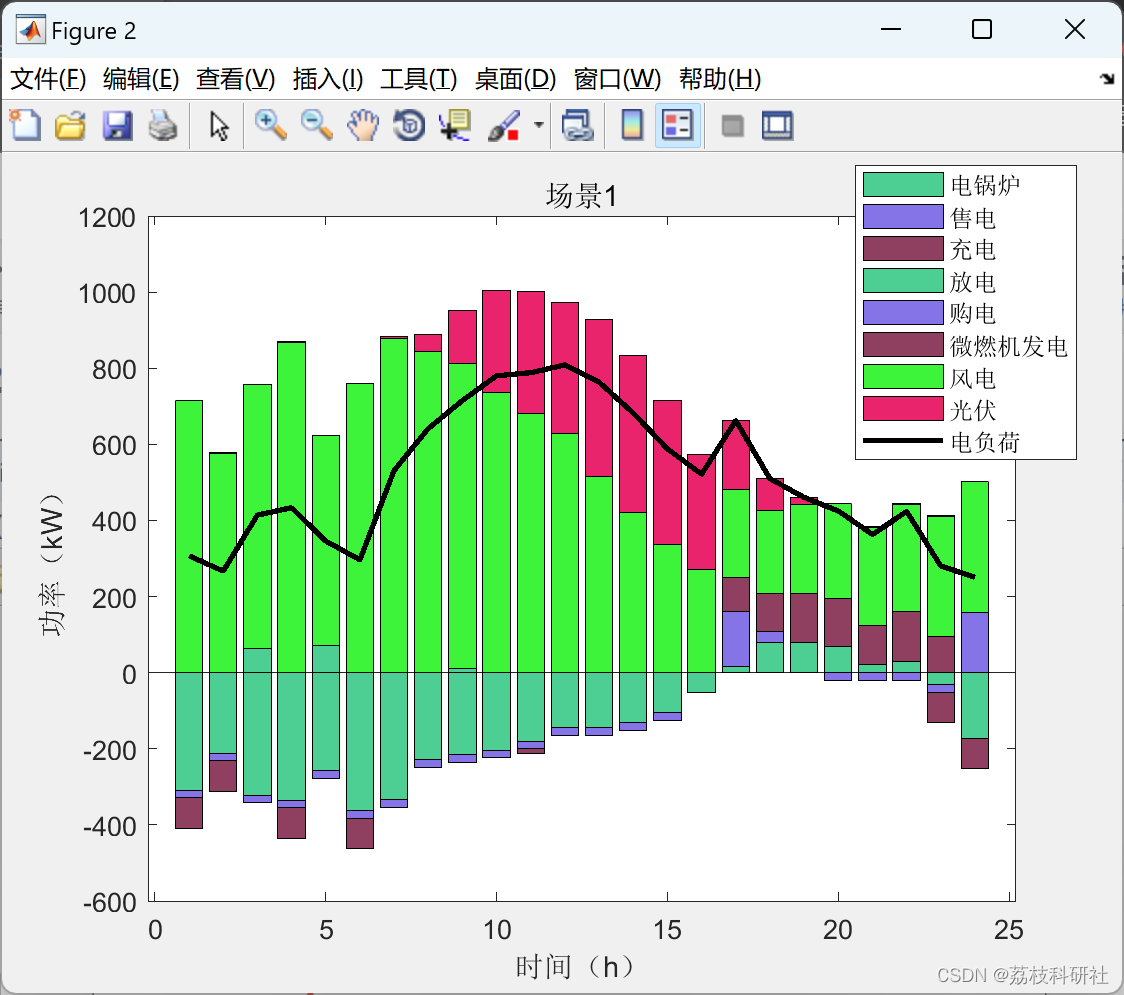
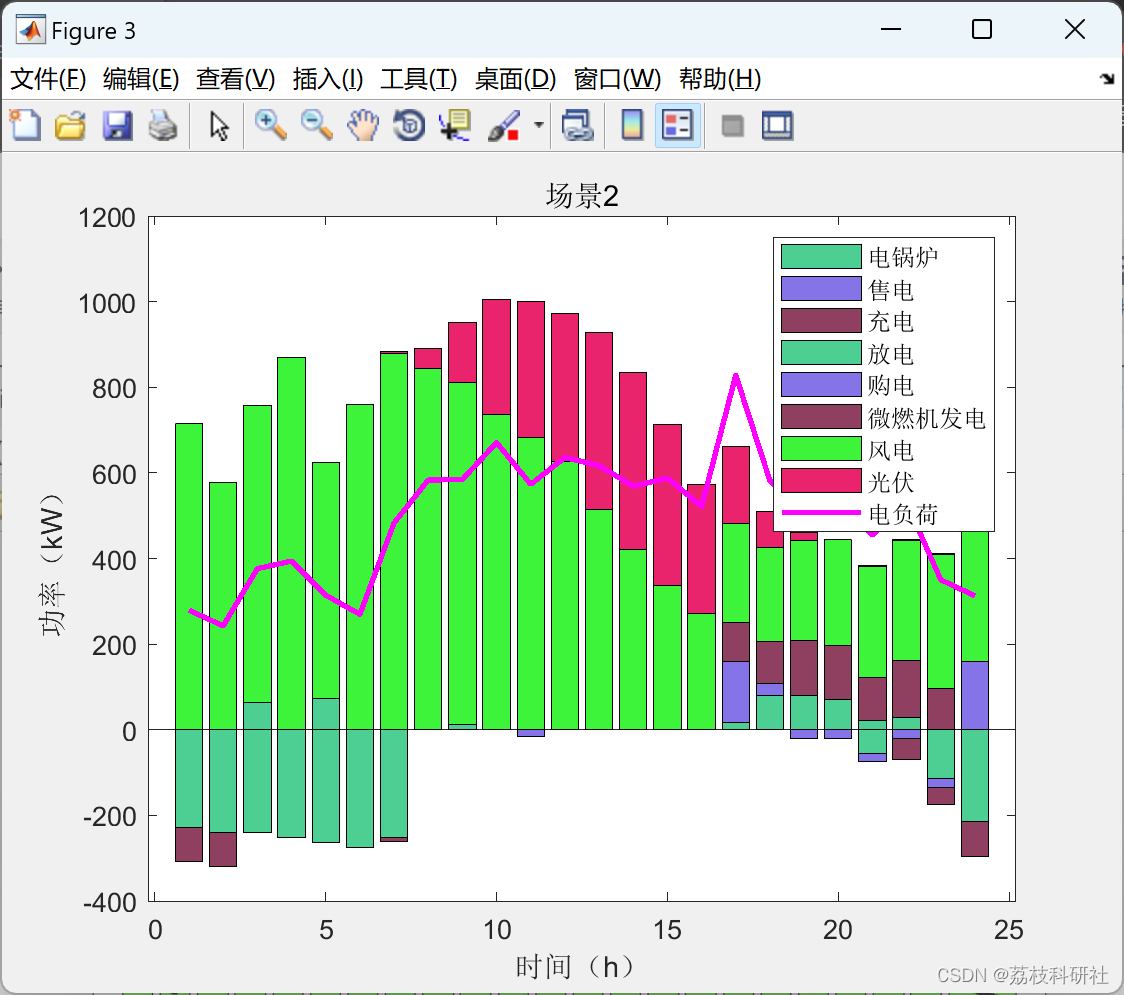
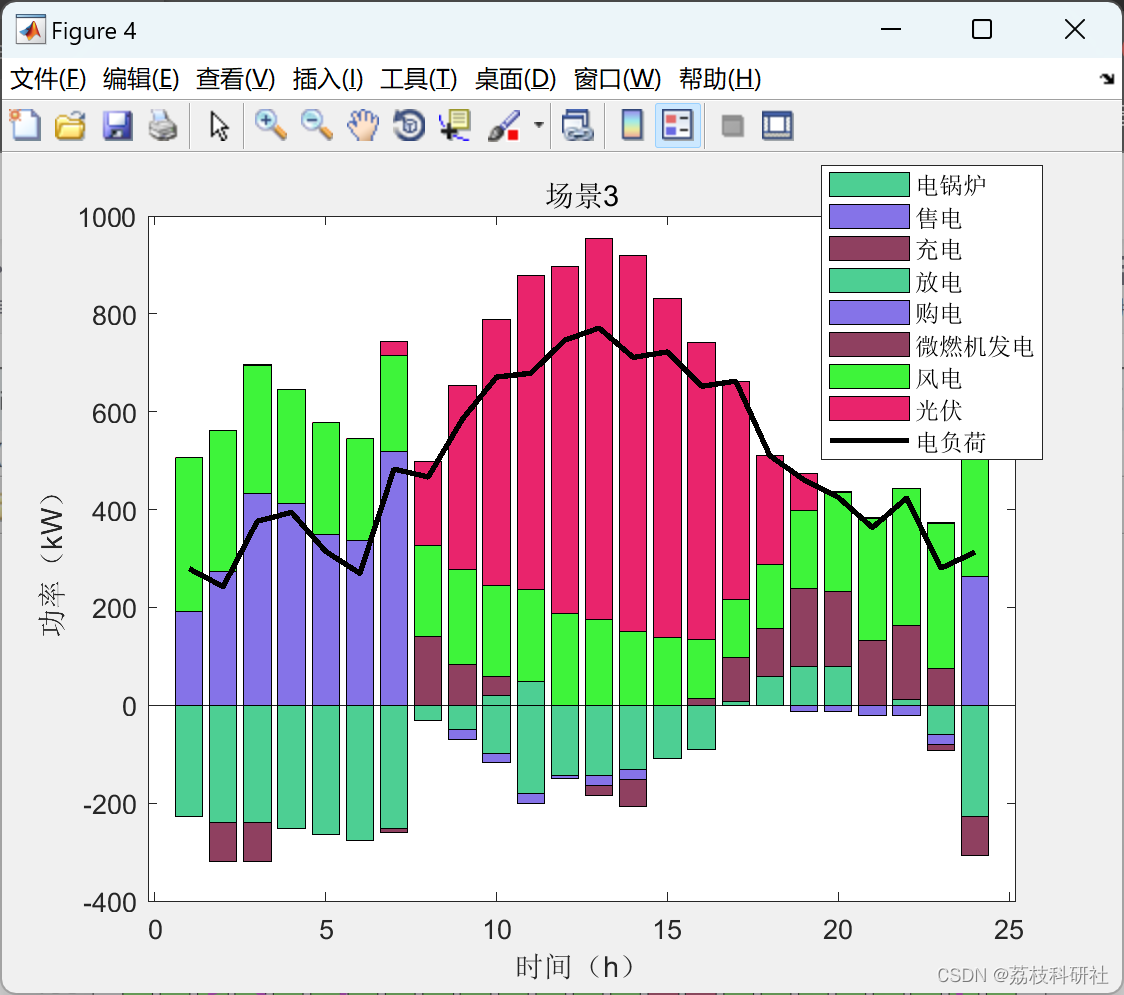
电热综合能源系统的DRO调度模型通常采用两阶段架构。第一阶段(日前阶段)确定“ Here-and-Now”决策变量,即在不确定性实现之前必须确定的量,如机组启停状态、储能充放电计划、与电网的交换功率基线等。第二阶段(实时阶段)确定“Wait-and-See”决策变量,即在不确定性实现后可以调整的量,如机组出力调整、电锅炉功率调节、弃风弃光量等。
这一架构的合理性在于它反映了实际调度的时间逻辑:日前决策必须在不确定性揭示之前做出,而实时调整可以依据实际发生的场景进行。DRO的目标函数因此具有min-max-min的三层结构:外层min选择第一阶段决策以最小化总成本,中间max在最坏分布下评估期望成本,内层min选择第二阶段最优调整策略。
4.2 列与约束生成算法
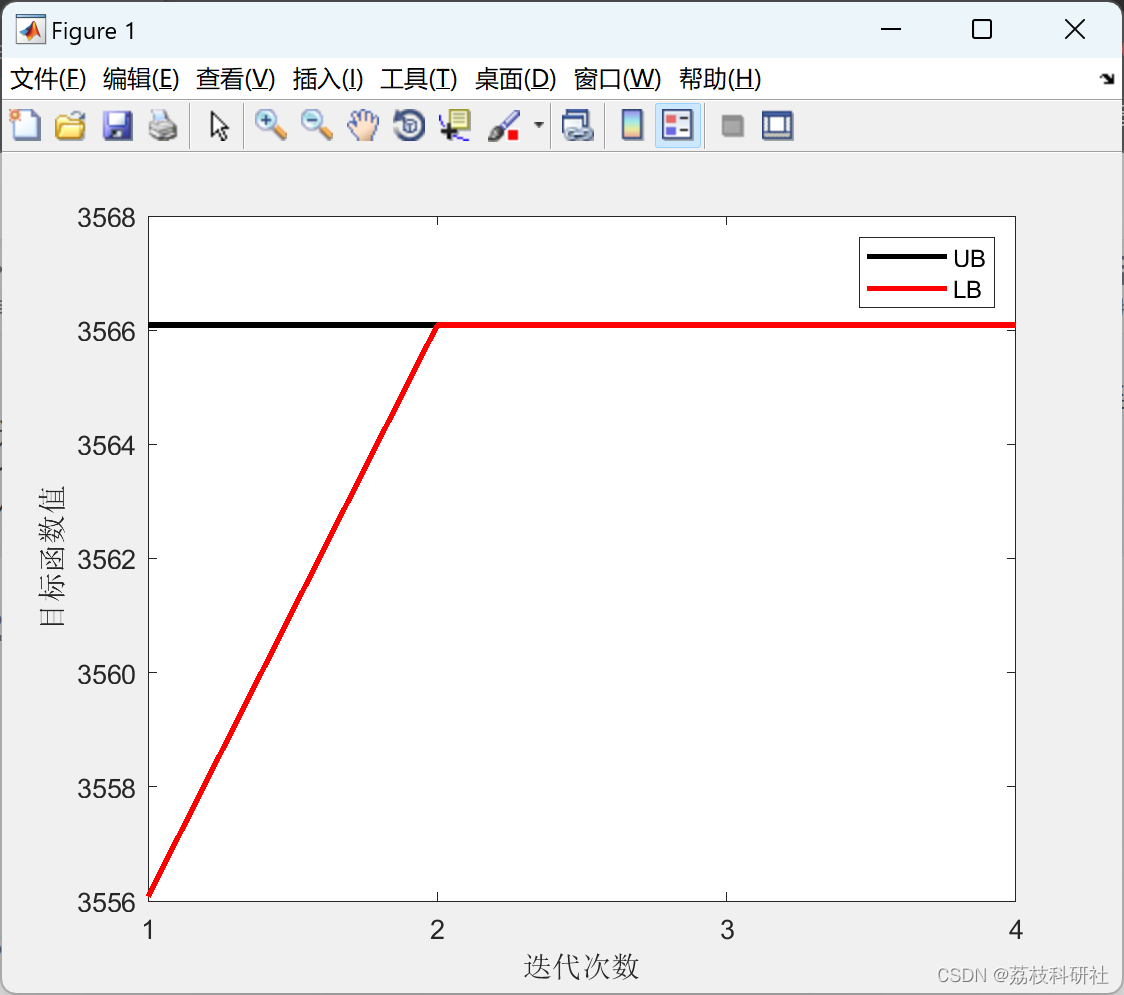
求解两阶段DRO模型的主要算法是列与约束生成(Column-and-Constraint Generation, C&CG)。该算法的核心思想是将原问题分解为主问题(Master Problem)和子问题(Subproblem)。主问题在已知的有限场景集下优化第一阶段决策,子问题则寻找当前决策下最坏的概率分布并生成新的场景约束。通过在主问题中不断添加子问题返回的“最坏场景”约束,算法迭代逼近原问题的最优解。
C&CG算法的效率取决于子问题求解的难度和主问题规模的增速。在电热综合能源系统的应用中,子问题通常涉及内层的min-max结构,需要通过强对偶理论转化为混合整数规划或线性规划形式。近年来,一些研究探索了并行化的C&CG实现,通过同时求解多个子问题或并行生成多个割平面来加速收敛。
4.3 计算可扩展性与线性化策略
电热综合能源系统的DRO模型包含大量的非线性和非凸元素:热电联产机组的电-热耦合特性、热网的温度-流量关系、电锅炉的效率曲线等。这些非线性因素与两阶段DRO的三层结构叠加,使问题的直接求解面临严峻的计算挑战。
实践中,研究者采用多种线性化与凸松弛策略来提升可扩展性。分段线性化被广泛用于处理机组效率曲线和成本函数;McCormick包络方法用于松弛热网中流量与温度乘积项导致的非凸性;二阶锥松弛则常用于处理电-热耦合约束中的二次项。这些线性化策略在保证近似精度的前提下,将原问题转化为混合整数线性规划(MILP)或二阶锥规划(SOCP),使得商业求解器能够有效处理。
然而,线性化并非没有代价。近似误差的累积可能导致决策的次优性,而在某些情况下,线性化后的可行域可能与原始可行域存在显著偏差。如何在计算效率与模型精度之间取得平衡,是实际应用中需要审慎权衡的问题。
5 研究现状与实证发现
5.1 典型技术路线
当前电热综合能源系统数据驱动DRO研究的主流技术路线可概括为“CGAN场景生成 + K-medoids场景削减 + 综合范数模糊集 + 两阶段C&CG求解”的集成框架。这一路线在多项独立研究中得到验证和细化。
马苗苗等(2026)针对电-热-氢储能综合能源系统,利用CGAN生成风光出力和电、热负荷场景,以K-medoids聚类提取典型场景,构建由1-范数和∞-范数联合约束的不确定集,采用C&CG算法求解两阶段DRO模型。仿真结果表明该方法能够有效提高系统经济性,同时保证求解效率。在另一项针对电-热-氢系统的研究中,类似技术路线的应用使运行成本较传统鲁棒优化降低了2.1%。
张森等(2026)将综合范数约束的DRO方法拓展至微能源网的规划问题,构建了min-max-min三层规划模型,采用C&CG求解。结果表明,所提模型相比传统随机优化和鲁棒优化在经济性与鲁棒性的平衡方面更具优势,年综合成本降低1.33%,且收敛所需的迭代次数更少。
5.2 实证效果的共同模式
梳理现有实证研究,可以发现一些共同的模式。在几乎所有对比实验中,DRO方法在成本指标上均优于传统鲁棒优化——这一优势的来源是明确的:DRO利用数据信息收缩了不确定性集合的有效范围,避免了为极端低概率场景付出过高的预留成本。同时,DRO的成本通常略高于随机优化,但这一差距反映了鲁棒性的“保险费”。
另一个值得关注的模式涉及参数的敏感性。多项研究表明,综合范数约束中的置信水平参数对结果有显著影响。当置信水平从0.95提升至0.99时,模糊集半径增大,决策趋于保守,成本上升但可行性保障增强。这一参数的调节实际上为决策者提供了一个“经济性-鲁棒性”的调节旋钮,使其能够根据风险偏好和运行条件灵活调整策略。
5.3 与其他不确定性方法的比较
与传统鲁棒优化的对比最为直接。传统鲁棒优化假设不确定性落在某个有界集合内,不考虑分布信息。DRO通过引入经验分布和模糊集,实际上是对传统鲁棒优化的“数据驱动收紧”。当模糊集半径趋于无穷时,DRO退化为传统鲁棒优化;当半径趋于零时,DRO趋近于基于经验分布的随机优化。这一连续谱的存在,使DRO具有更好的适应性。
与条件风险价值(CVaR)方法的比较则揭示了不同的风险建模哲学。CVaR关注的是尾部风险的期望值,属于风险度量而非分布不确定性建模。DRO的min-max结构则对模糊集内的所有分布赋予权重,其保守程度取决于模糊集的大小。两者可以结合使用,但建模的出发点不同。
6 开放问题与未来方向
6.1 场景质量评估的缺失
当前研究中对场景生成与削减质量的评估往往停留在定性描述层面。多数工作报告了聚类数目和典型场景的统计特征,但缺乏对“场景集在多大程度上保留了原始数据的分布信息”的系统性度量。这导致一个实际问题:当决策结果不理想时,难以判断问题出在场景质量、模糊集参数还是优化模型本身。建立场景质量的定量评估指标体系,是提升DRO方法论严谨性的一个基础性课题。
6.2 模糊集参数的自适应调节
综合范数约束中的置信水平参数目前多依赖经验设定。虽然理论上存在与样本量关联的计算公式,但实际数据的非独立同分布特性、分布偏移的时变性等因素使得固定参数难以在所有运行条件下保持最优。探索基于在线数据的自适应参数调节机制——例如根据滚动预测误差动态调整范数半径——是一个具有实用价值的方向。
6.3 从运行优化向规划问题的延伸
当前DRO在电热综合能源系统中的应用主要集中在运行调度层面。将DRO框架拓展至规划问题(如设备容量配置)面临额外的挑战:规划决策的时间尺度更长,不确定性集合可能需要覆盖多年的分布变化;规划模型本身的计算复杂度更高,与DRO的三层结构叠加后求解难度显著增加。已有初步探索将综合范数DRO用于微能源网的容量规划,但这一方向的系统化研究仍显不足。
6.4 信息物理耦合带来的新不确定性
电热综合能源系统的信息物理融合特征日益显著。调度决策依赖于通信网络传输的预测信息、状态量测和控制指令,而这些环节本身可能受到通信延迟、数据丢失或网络攻击的影响。这种“信息层”的不确定性与物理层的不确定性(风光出力、负荷波动)相互耦合,可能产生传统DRO框架尚未覆盖的新风险模式。将信息物理耦合不确定性纳入分布鲁棒优化的考量,是一个具有前瞻性的研究方向。
7 结语
数据驱动的分布鲁棒优化为电热综合能源系统的不确定性调度提供了一种兼具实用性与理论优雅性的方法论框架。它的核心贡献在于:在“盲目信任数据”的随机优化与“完全忽视数据”的传统鲁棒优化之间,开辟了一条以数据为引导、以模糊集为约束的中间道路。通过综合范数约束构建的模糊集,决策者可以在经济性与鲁棒性之间进行有原则的权衡,而非在两种极端策略之间做出非此即彼的选择。
然而,方法论上的优雅并不自动转化为工程实践中的可靠性。场景生成的质量、模糊集参数的设定、线性化的精度损失——每一个环节都可能引入误差,而这些误差在从数据到决策的传导链条中如何累积和放大,仍需更深入的理论分析与实证检验。对于研究者而言,电热综合能源系统的DRO不仅是一个优化问题,更是一个关于“如何在数据不完美、模型不精确、时间不充裕的条件下做出足够好的决策”的方法论实验场。
📚第二部分——运行结果
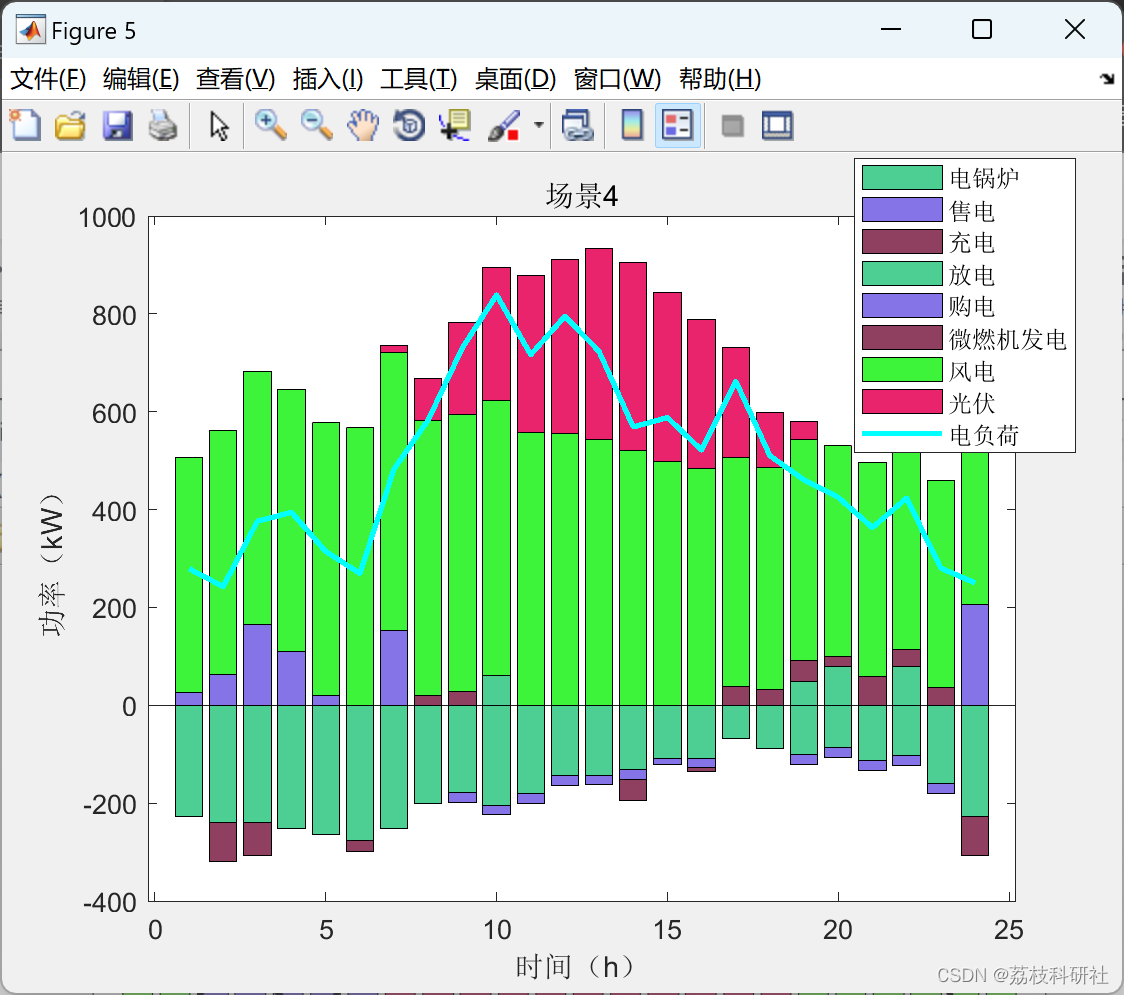
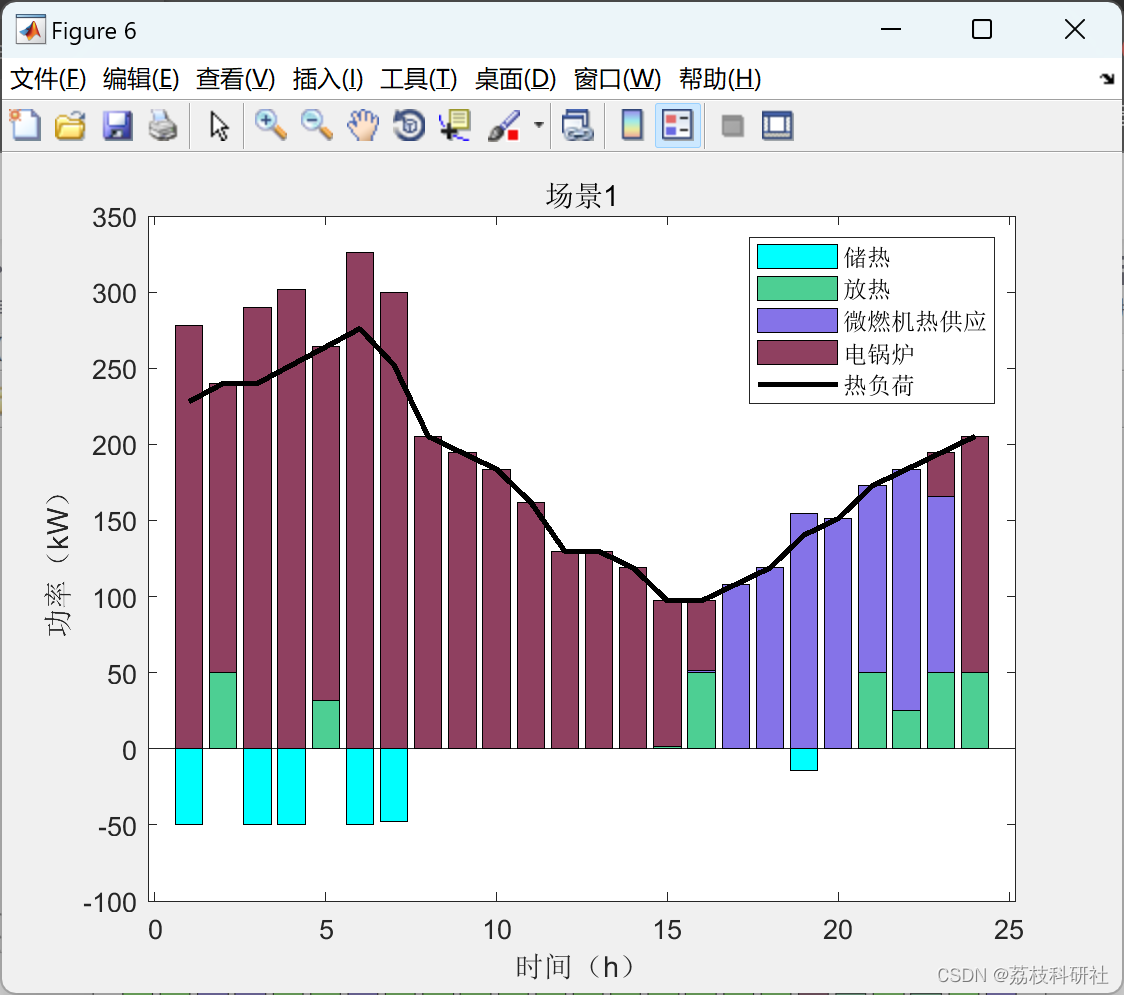
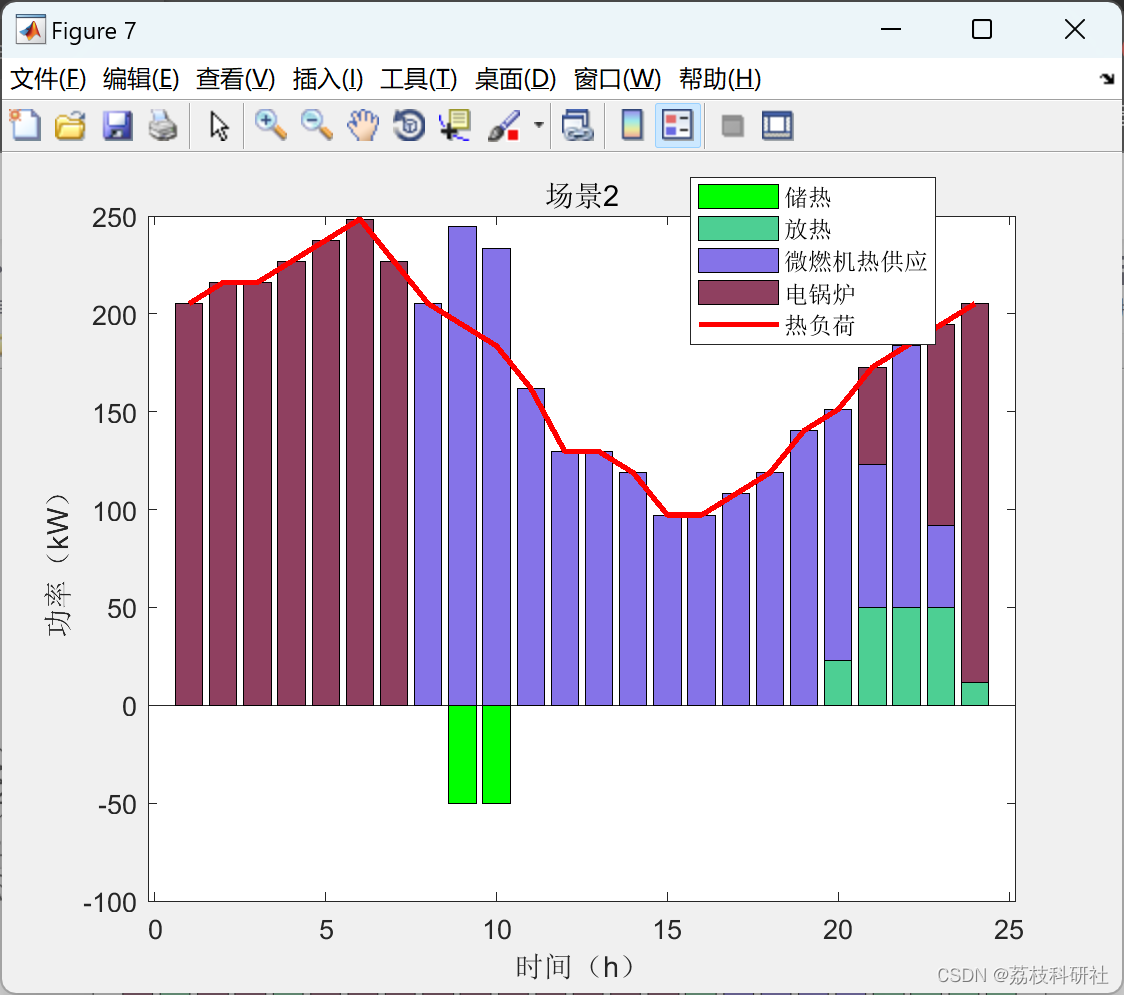
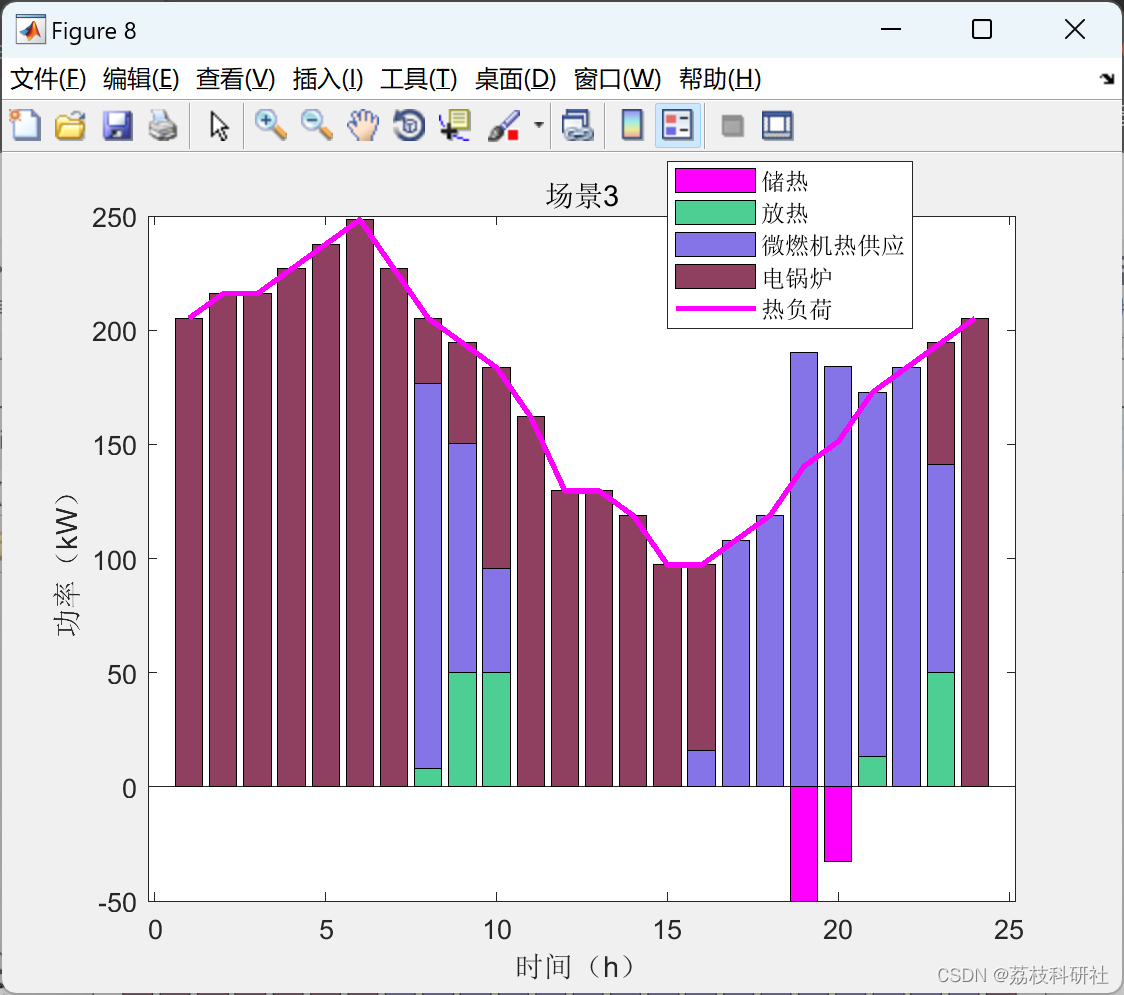


🎉第三部分——参考文献
文章中一些内容引自网络,会注明出处或引用为参考文献,难免有未尽之处,如有不妥,请随时联系删除。(文章内容仅供参考,具体效果以运行结果为准)
[1]孙旭,邱晓燕,张志荣,任昊,张明珂.基于数据驱动的交直流配电网分布鲁棒优化调度[J].电网技术,2021,45(12):4768-4778.DOI:10.13335/j.1000-3673.pst.2020.2273.
[2]贺帅佳,高红均,刘俊勇,刘友波,王家怡,向月.计及需求响应柔性调节的分布鲁棒DG优化配置[J].中国电机工程学报,2019,39(08):2253-2264+8.DOI:10.13334/j.0258-8013.pcsee.181968.
[3]高海淑,张玉敏,吉兴全,张晓,于永进.基于场景聚类的主动配电网分布鲁棒综合优化[J].电力系统自动化,2020,44(21):32-41.
🌈第四部分——本文完整资源下载
资料获取,更多粉丝福利,MATLAB|Simulink|Python|数据|文档等完整资源获取
本文完整资源下载