Python后端爬虫专题27:六个容器一起跑才叫项目——Docker Compose部署、迁移与恢复演练
上一篇练习完整答案
解析器层最适合发现 CSS 必需字段失效;HTTP 层发现 Retry-After 或恶意重定向处理错误;Repository 发现重复运行产生两行;API 层发现跨租户读取;进程内旅程发现 ETag 虽保存却没在下次传回;Compose 旅程发现 Celery 任务名、Redis、PostgreSQL 或 MinIO 装配错误。
三条详情时,正常一条 created=1;503 下载失败一条;缺 title 解析失败一条,因此 discovered=3、created=1、failed=2、errors 长度2,数据库一行,两个有正文的页面可留下快照(列表页也有快照)。全量 pytest 的实际数字应以你当次终端输出为准;它不能证明 Docker DNS、环境变量、真实 broker 投递、PostgreSQL 驱动、MinIO bucket 和跨进程状态都正确。
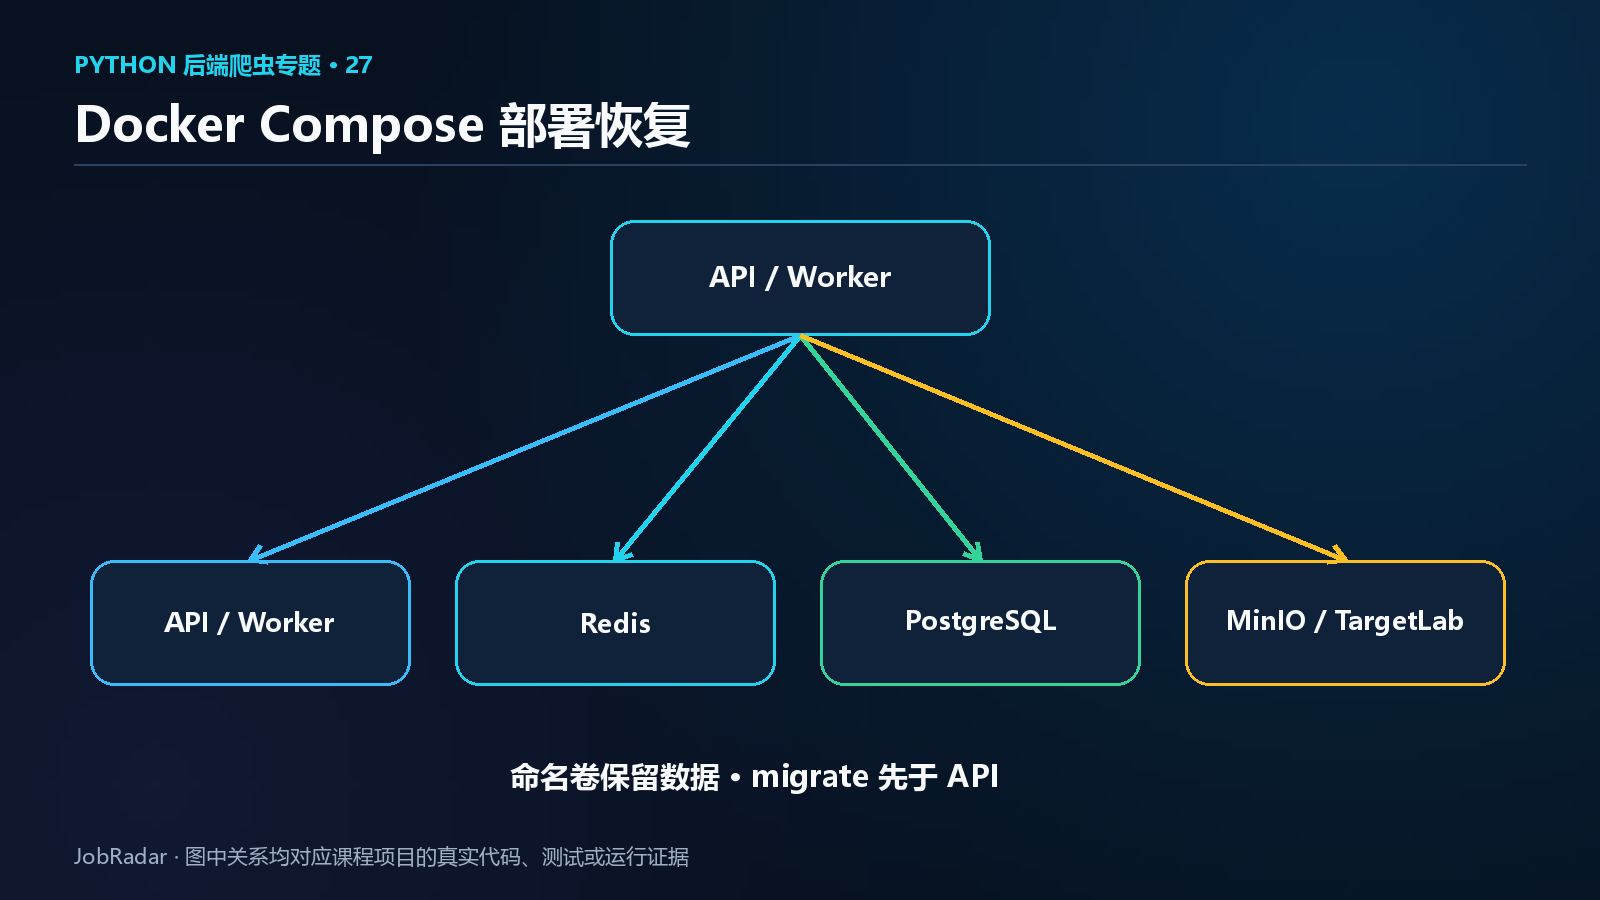
先看拓扑,不要先敲up
Compose 包含 postgres、redis、minio、targetlab、一次性 migrate、api 和 worker。migrate 等 PostgreSQL healthy 后执行 Alembic;api 等迁移完成、Redis 与 TargetLab healthy;worker 再等 API 与 MinIO。depends_on 的健康条件减少启动竞态,但运行中依赖崩溃仍需应用重连和告警。
API 对宿主开放 8010,TargetLab 8011,PostgreSQL 5435,Redis 6381,MinIO API/控制台 9010/9011,均绑定 127.0.0.1,避免课程密码暴露到局域网。生产应删除数据库/Redis宿主端口,使用 Secret 和 TLS。
先验证配置,再构建
cd project
docker compose config —quiet
docker compose up –d —build
docker compose ps
期待 postgres、redis、minio、targetlab、api、worker 为 healthy,migrate 为 exited (0)。migrate 正常退出不是故障;它的职责是把空库升级到 head。查看日志:
docker compose logs migrate
docker compose logs —tail 80 api worker
若 API healthy 而 worker 不 healthy,检查 celery inspect ping、broker URL 和任务 app;若 migrate 失败,不要让 API 以 create_all 偷偷建表,先修迁移。
一条公开接口旅程贯穿全部服务
.\\.venv\\Scripts\\python.exe –m scripts.demo_journey `
—api http://127.0.0.1:8010 `
—target "http://targetlab:8011/jobs?page=1" `
—tenant course-demo
脚本只通过 API 创建任务、轮询状态和查询职位,不读取容器内部数据库。首次应 completed、created=3、jobs=3;具体 task UUID 每次不同。Worker 访问的是 Compose DNS targetlab,其私网解析只有在 seed_hosts 和 private_hosts 都显式授权时通过。
第二次运行验证的不是速度
用相同 tenant 再跑一次,期望职位总数仍3,详情 report 主要为 not_modified=3、created=0。它证明 PostgreSQL 保留 validators、TargetLab ETag 生效、Worker 发送条件头、数据库幂等,而不是简单重复请求成功。若换 tenant,第一次仍应 created=3,因为缓存和事实不能跨租户偷用。
MinIO 控制台可查看 jobradar-snapshots 中按快照标识配对的 .html 与 .json 对象;也可从容器日志确认 bucket 初始化。快照存在不代表内容可公开,控制台凭据只用于本地课程。
重启恢复演练
先记录 /api/jobs total;执行:
docker compose restart api worker
docker compose ps
$headers = @{"X-Tenant-ID"="course-demo"}
Invoke-RestMethod –Uri "http://127.0.0.1:8010/api/jobs?size=100" –Headers $headers
重启后仍有三条,证明数据在 PostgreSQL volume,不在 API 内存。再运行旅程仍应增量。Redis 启用 AOF,MinIO 与 PostgreSQL 都有命名卷;但 volume 不是备份,宿主磁盘损坏或 down -v 都会丢失。
普通停止使用 docker compose down,会保留卷。docker compose down -v 会删除课程 PostgreSQL、Redis、MinIO 数据,只能在明确重置实验时使用。课程验收不会替你执行删除卷的命令。
数据库迁移为什么单独验收
单测在全新 SQLite 文件执行 alembic upgrade head,检查表和版本;Compose 则在 PostgreSQL 上真实执行。同一迁移脚本跨两种数据库不代表所有未来 DDL 都兼容,新增列、索引和 enum 必须分别验证。上线流程应先备份、评估锁表、迁移、验证,再滚动应用。
.\\.venv\\Scripts\\python.exe –m pytest tests\\test_migrations.py::test_alembic_upgrades_empty_database_to_current_schema –q
配置与秘密的边界
Settings 从 JOBRADAR_ 前缀环境变量读取数据库、broker、allowlist 和快照后端。Compose 中课程密码是可见开发值,不可直接用于生产。生产把 secrets 从部署平台注入,限制日志、轮换,并给 PostgreSQL/MinIO 最小账号权限。
auto_create_schema=false 是重要防线:容器环境只认 Alembic。SQLite 本地默认 true 是为了降低练习门槛,两个模式必须在文档中明确,避免开发环境掩盖迁移缺失。
本篇完整运行时装配
runtime.py 把环境设置转成 Session factory、快照实现、Celery queue 和 FastAPI。Worker 使用相同构建函数,模块没有写死 Compose 地址。
"""从环境变量装配数据库、Celery、快照存储和 FastAPI。"""
from pathlib import Path
from celery import Celery
from minio import Minio
from pydantic import Field
from pydantic_settings import BaseSettings, SettingsConfigDict
from sqlalchemy import create_engine
from sqlalchemy.orm import Session, sessionmaker
from .api import create_app
from .repository import create_schema
from .snapshots import FileSnapshotStore, MinioSnapshotStore
from .tasks import create_celery_app
class Settings(BaseSettings):
model_config = SettingsConfigDict(
env_prefix="JOBRADAR_", env_file=".env", extra="ignore"
)
database_url: str = "sqlite+pysqlite:///./data/jobradar.db"
broker_url: str = "memory://"
result_backend: str | None = "cache+memory://"
allowed_seed_hosts: str = "target.test"
allowed_private_hosts: str = ""
snapshot_backend: str = "file"
snapshot_path: Path = Path("data/snapshots")
minio_endpoint: str = "minio:9000"
minio_access_key: str = "jobradar"
minio_secret_key: str = "jobradar-development-only"
minio_secure: bool = False
minio_bucket: str = "jobradar-snapshots"
auto_create_schema: bool = True
@property
def seed_hosts(self) –> set[str]:
return {host.strip().casefold() for host in self.allowed_seed_hosts.split(",") if host.strip()}
@property
def private_hosts(self) –> set[str]:
return {host.strip().casefold() for host in self.allowed_private_hosts.split(",") if host.strip()}
class CeleryTaskQueue:
"""API 只传 JSON 标量;数据库会话和爬虫对象由 Worker 自己创建。"""
def __init__(self, app: Celery) –> None:
self._app = app
def enqueue(
self, *, task_id: str, seed_url: str, tenant_id: str, max_pages: int
) –> str:
result = self._app.send_task(
"jobradar.crawl",
kwargs={
"task_id": task_id,
"seed_url": seed_url,
"tenant_id": tenant_id,
"max_pages": max_pages,
},
)
return str(result.id)
def build_session_factory(settings: Settings) –> sessionmaker[Session]:
connect_args = (
{"check_same_thread": False}
if settings.database_url.startswith("sqlite")
else {}
)
engine = create_engine(settings.database_url, pool_pre_ping=True, connect_args=connect_args)
if settings.auto_create_schema:
create_schema(engine)
return sessionmaker(engine, expire_on_commit=False)
def build_snapshot_store(settings: Settings) –> FileSnapshotStore | MinioSnapshotStore:
if settings.snapshot_backend == "file":
return FileSnapshotStore(settings.snapshot_path)
if settings.snapshot_backend == "minio":
client = Minio(
settings.minio_endpoint,
access_key=settings.minio_access_key,
secret_key=settings.minio_secret_key,
secure=settings.minio_secure,
)
return MinioSnapshotStore(client, settings.minio_bucket)
raise ValueError("snapshot_backend must be 'file' or 'minio'")
def create_runtime_app(settings: Settings | None = None):
settings = settings or Settings()
sessions = build_session_factory(settings)
celery_app = create_celery_app(settings.broker_url, settings.result_backend)
return create_app(
sessions,
CeleryTaskQueue(celery_app),
allowed_seed_hosts=settings.seed_hosts,
allowed_private_hosts=settings.private_hosts,
)