📌 系列说明:一个 Java 后端视角的 Spring AI 渐进式实战教程,载体为开源项目「劳小司 · 智能法律助手」。
- 序章:技术栈全景与 AI 学习指南
- 阶段一 · 流式对话内核:篇1 SSE 流式·停止·思考可见化 / 篇2 会话记忆压缩与滚动体验
- 阶段二 · 工具调用:篇1 Function Calling 与法律计算器 / 篇2 联网搜索与工具预算
- 阶段三 · RAG 知识库:篇1 起步与底账化 / 篇2 Agentic RAG 与引用可信度 / 篇3 检索质量与体验
- 阶段四 · 多模型路由:篇1 五路级联路由
- 阶段五 · 安全与质量门:篇1 确定性安全层与强制检索打底(本文) / 篇2 质量门与评估门禁 / 篇3 指代消解与阻塞隔离
- 阶段六 · 产品化与用户体系:篇1 认证·配额·门禁 / 篇2 前端·移动端·身份 / 篇3 劳动法专精与多模态
- 阶段七 · 存储演进与部署:篇1 存储迁移 / 篇2 部署契约
📦 本篇涉及:safety/SafetyGuard.java、service/ChatService.java(ground 打底逻辑)。
一、安全底线能交给模型自觉吗
法律 AI 有一类绝不能出错的事:
- 用户要"你保证我能赢官司"——不能承诺胜诉;
- 用户流露轻生或正在遭受人身伤害——必须置顶求助提示;
- 任何法律结论——必须附免责声明。
直觉做法是在 System Prompt 里写"你必须加免责声明、你不能承诺胜诉"。但提示词是软约束:模型有概率不听,温度一高更飘,你无法保证 100%。安全这种事,99% 不够,必须 100%。
本项目的原则来自智慧问诊方案的一句话:“不让 LLM 自己看守自己。” 安全检查用纯规则引擎(关键词匹配 + 文案拼接)实现——零 LLM 调用、结果确定、可审计,免责声明覆盖率、急症置顶这些指标由架构保证 100%,而不是赌模型自觉。
二、四道关卡:嵌在请求/响应管道里

SafetyGuard 是一个极薄的规则引擎,四道关卡按请求生命周期排列:
用户消息 → ① 拒答拦截(命中即短路,不调模型)
→ ② 紧急置顶(命中则警告拼在回答最前)
→ ③ 高风险检索落空提示
→ ④ 免责声明(法律类回答强制追加在末尾)
核心就一个 contains 匹配,简单、确定、可审计:
public String checkRefusal(String userMessage) {
if (properties.isEnabled() && hitAny(userMessage, properties.getRefusalKeywords())) {
return properties.getRefusalReply(); // 命中 → 返回规范话术
}
return null; // 未命中 → null
}
private boolean hitAny(String message, List<String> keywords) {
return keywords.stream().anyMatch(message::contains);
}
词表和文案都有代码默认值,application.yml 的 legal.ai.safety 段可按需覆盖。
三、拒答拦截:短路在模型之前
拒答是成本和安全的双重短路。看 ChatService.chat() 的第一段:
String refusal = safetyGuard.checkRefusal(userMessage);
if (refusal != null) {
return Flux.just(
ServerSentEvent.<String>builder(refusal).event(EVENT_TOKEN).build(),
ServerSentEvent.<String>builder("[DONE]").event(EVENT_DONE).build());
}
命中拒答词(如"保证胜诉"“代写起诉状”)时,直接返回规范话术,不调模型、不落记忆、不扣配额——既守住了平台责任,又一分钱 token 不花。这是"确定性"的好处:命中即 100% 拦截,不存在模型"这次没拦住"。
紧急置顶、免责声明同理,都是在模型输出之外由代码强制拼接,模型改不了。
四、Grounded ReAct:强制检索打底
篇2(阶段三)埋过一个隐患:检索工具化后,模型可以不听——它可能觉得自己知道,跳过 searchLaw 直接凭记忆作答,幻觉又回来了。这一篇来实锤回收。
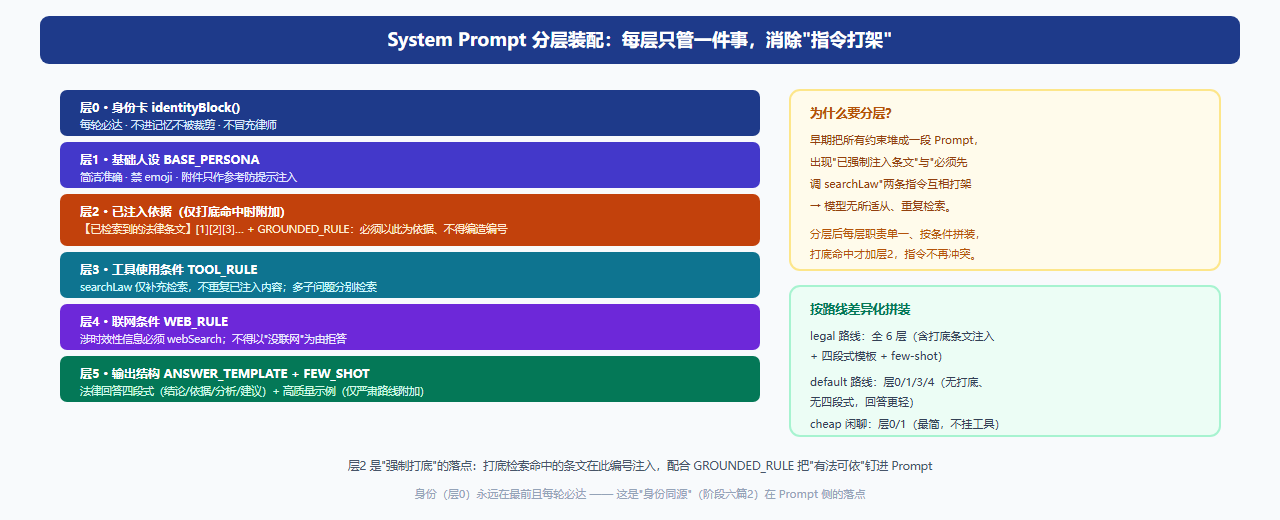
解法:对严肃路线,在进模型之前,代码层强制检索一次——模型没机会跳过。配置 grounded-routes: [legal] 指定哪些路线要打底,ChatService.ground() 里:
if (!ragProperties.isEnabled() || !legalish) {
return new GroundedResult(base, List.of()); // 非打底路线,正常返回
}
// 打底路线:进模型前,代码层同步检索一次(模型无法跳过)
List<LawCitation> cites = retrievalService.retrieveCitations(plan.primaryQuery(), category);
if (!cites.isEmpty()) {
registry.register(cites); // 命中登记(供审校 + 引用卡)
// 条文以 [1][2][3] 编号注入 System Prompt
return new GroundedResult(identityBlock() + BASE_PERSONA
+ "\\n\\n【已检索到的法律条文(回答以此为依据,用 [n] 角标注明出处)】\\n" + numbered
+ GROUNDED_RULE + ...);
}
命中后,条文以 [1][2][3] 编号写进 System Prompt,并附规则"回答必须以上述编号条文为依据,不得引用编号之外的条文、不得编造条文编号"。这样严肃法律问题上,"有法可依"是架构强制的,不是模型自愿的。
落空也有兜底:打底检索没命中(低于阈值)且问题命中高风险关键词(金额/刑期预测类)时,追加"建议咨询执业律师"提示,不臆测。
注意这是"Grounded ReAct"而非完整 ReAct:本项目没有实现显式的 Thought→Action→Observation 文本循环,而是在 ReAct 之前先用代码强制垫一轮检索,把"打底"从模型决策里拿出来。落地哲学是"检索工具化优先于显式循环"——够用、可控、成本低。
五、踩坑备忘
① 词表会误伤。 contains 简单,但"怎么告公司"这种正常咨询可能撞上某些拒答词。词表要持续用真实语料校准,宁可配可覆盖的默认值 + 金标集回归(篇2),也不要拍脑袋写死。
② 安全层产出不该被质量门拦。 拒答/引导咨询类回答(含"咨询执业律师")是安全层主动产出的规范话术,质量门(篇2)要放行它们,否则会因"没有法条引用"被判不通过、触发无谓重试。
③ 打底检索用改写后的查询。 plan.primaryQuery() 是 Planner 做过指代消解的查询(篇3),不是用户原话——多轮追问"那这个时效呢",打底检索要用改写后的完整问题,否则召回偏。
④ 强制打底和工具检索会叠加。 打底检了一次,模型可能又调 searchLaw 检类似的。所以 Prompt 分层里明确告诉模型:“searchLaw 仅用于已注入条文不足时补充,不要对已注入内容重复检索”——用指令减少冗余,配合工具预算兜底。
六、小结
| 确定性安全层 | 纯规则引擎,零 LLM,架构保证 100% |
| 四道关卡 | 拒答短路 / 紧急置顶 / 落空提示 / 免责声明 |
| Grounded ReAct | 严肃路线进模型前代码层强制检索一次 |
| 回收伏笔 | 治住篇2 埋的"模型可以不听" |
| 落地哲学 | 检索工具化优先于显式 ReAct 循环 |
七、下篇预告
安全层守住了"进模型前"和"出模型后的话术",但模型真正生成的那段回答质量怎么保证?答非所问、编造条文、敷衍两句怎么办?下一篇是质量门审校与评估门禁——把"不合格就不放行"做成机制。
🌐 源码与体验:Gitee(国内快)gitee.com/spaserby/laoxiaosi | GitHub github.com/spaserby/laoxiaosi 🖥 在线演示:laoxiaosi.noctisblue.com 本系列全套代码皆开源,觉得这篇有帮助,欢迎顺手点颗 ⭐