多Agent成本失控实战——并发、上下文与Token预算如何系统治理
从“Agent越多越强”到“每一美元都能解释”
#多Agent #Agent #LLM #Token #成本优化 #上下文工程 #Prompt Caching #并发控制 #模型路由 #可观测性
|
多Agent系统真正昂贵的地方,往往不是模型单价,而是同一份上下文被多个Agent重复读取、并发分支做了大量重叠工作、子Agent输出过长、失败后集体重试,以及主Agent不断把历史结果重新塞回上下文。本文从成本公式出发,拆解并发扇出、上下文复制、缓存、模型路由、交接格式、重试预算和观测指标,给出可执行的预算控制器与案例测算。目标不是让Token越少越好,而是在质量SLO不下降的前提下,让每个子Agent的创建都有理由、每次调用都有预算、每次失败都有止损线,最终把“多Agent很贵”变成可测量、可治理、可持续优化的工程问题。 |
图1 多Agent成本治理:从无界扇出到可观测、可预算、可收敛的执行系统
1. 先说结论:多Agent最贵的不是Agent数量,而是“重复工作 × 高价上下文 × 失败放大”
很多团队第一次把单Agent升级为多Agent时,会先做一件看起来非常合理的事:把任务拆成5份,同时启动5个子Agent。速度确实快了,质量有时也更好,但账单往往在几天后突然变得难以解释。原因并不是“5个Agent当然就贵5倍”这么简单。真实成本更像一个放大器:每个子Agent会重新消费系统提示、工具定义、业务规范和历史上下文;它们会产生自己的中间输出;主Agent还要再次读取、比较和综合;只要某个上游失败,重试可能把整棵调用树重新跑一遍。
Anthropic在公开复盘多Agent Research系统时给出过一个非常有参考价值的数据:其普通Agent交互的Token消耗大约是聊天的4倍,而多Agent系统大约可达到聊天的15倍。这个数字不是所有系统的固定倍率,但它揭示了本质——多Agent是在主动购买更多“并行计算与独立上下文”,只有当任务价值足够高、工作流确实可并行时,这笔计算才值得。
|
一个更准确的判断 多Agent成本治理的目标不是“少用Agent”,而是让每一次spawn都回答四个问题:它能否并行?它是否需要独立上下文?它能否产出可验证的独立结果?额外质量价值是否大于额外成本? |
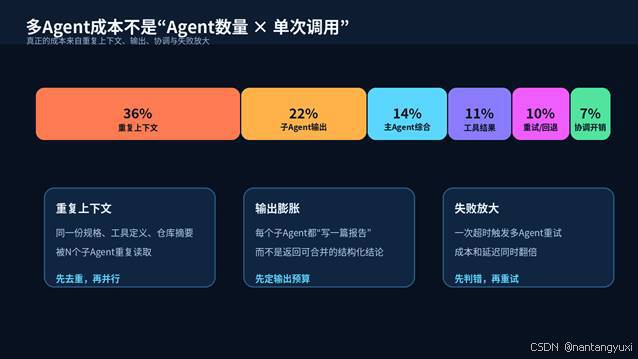
图2 多Agent成本的典型组成:重复上下文常常比“Agent数量”更值得先优化
2. 先把成本公式写出来:否则所有优化都只能靠感觉
生产系统里最危险的成本指标是“本月总Token”。它能告诉你钱花了多少,却几乎不能告诉你为什么贵、贵在哪个Agent、哪种任务在浪费、哪次优化真的有效。要让成本可治理,最少要把每个Agent调用拆成未缓存输入、缓存读取、缓存写入、输出、工具费用,以及由重试和协调产生的额外开销。

图3 建议使用的任务级成本分解公式
其中 U、H、W、O 分别代表未缓存输入Token、缓存命中Token、缓存写入Token和输出Token;P代表对应单价。C_tool是搜索、代码执行、浏览器、向量检索等按调用或按资源计费的工具开销;C_retry表示失败放大;C_coord则是主Agent综合、Reviewer复核、交接转换带来的协调成本。
|
指标 |
为什么必须记录 |
常见异常信号 |
|
未缓存输入Token |
判断上下文是否重复、是否过度携带历史 |
Agent数增加后几乎线性上升 |
|
缓存命中Token |
衡量稳定前缀复用效果 |
缓存功能已开但命中率很低 |
|
输出Token |
输出通常比输入更贵,且会进入下一轮输入 |
子Agent都返回长篇叙述 |
|
重试次数 |
区分正常波动与失败放大 |
429/超时后整棵任务树重跑 |
|
工具返回Token |
MCP/搜索结果可能吞掉上下文 |
一次工具调用返回几十页原文 |
|
Cost / Success |
把成本和任务价值绑定 |
总成本下降但成功率也下降 |
3. 第一大黑洞:无界并发不是并行,是重复探索
并发是多Agent最显眼的优势,也是最容易失控的地方。理想情况下,4个子Agent分别探索4个独立方向,端到端时间接近单个分支的最大耗时;现实里更常见的是4个Agent都拿着相同背景、搜索相似关键词、访问相同文档,最后返回内容高度重叠。此时你买到的不是“4倍搜索覆盖”,而是“4份重复上下文 + 4份重复工具结果 + 4份重复输出”。
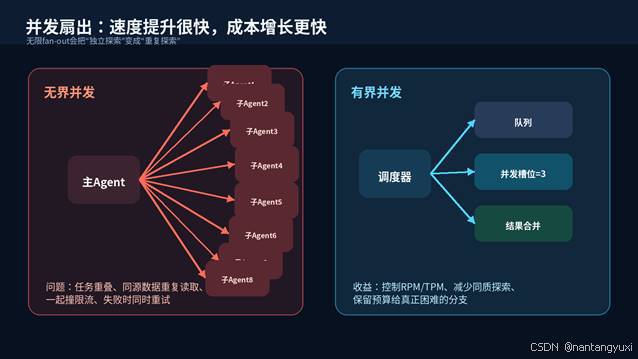
图4 无界fan-out与有界并发:并发槽位不是越多越好
3.1 先限制最大分支数,再谈动态扩容
最实用的做法不是让主Agent自由spawn,而是给它一个硬上限。例如:普通任务最多2个子Agent,复杂研究最多4个;只有当不同分支之间的主题相似度低于阈值、预计收益高于成本时才允许继续扩容。OpenAI的多Agent文档也明确指出:多Agent适合可分成具体、独立工作流的任务;对于严格顺序推理、频繁写共享状态、或者瓶颈本身是一个慢外部操作的任务,增加子Agent可能只会提高Token使用。
3.2 并发控制至少要有三层
· 全局层:限制系统同时运行的Agent总数,避免多个用户任务一起冲垮RPM/TPM。
· 任务层:限制单个任务的max_parallel和max_agents,防止一个“难题”吃掉全部预算。
· 资源层:对搜索、浏览器、数据库、代码执行等昂贵工具单独设置Semaphore和速率限制。
|
经验法则 当新增一个子Agent不能明确回答“它将探索哪个与现有分支不同的假设/数据源/模块”时,先不要spawn。让主Agent继续做,通常更便宜也更稳定。 |
4. 第二大黑洞:把完整上下文复制给每个子Agent
上下文窗口越大,越容易产生一种错觉:既然放得下,就把所有内容都塞进去。但大上下文并不免费。它除了直接增加输入Token,还会让模型在不相关信息里寻找重点,导致上下文污染。更糟的是,多Agent会把这份“过度上下文”复制N次。一个50K Token的项目背景,如果复制给6个子Agent,仅公共输入就已经是300K Token,还没有计算各自的工具结果、推理和输出。
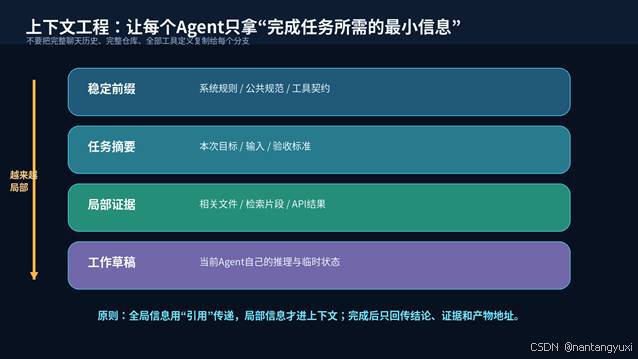
图5 推荐的上下文分层:公共规则、任务摘要、局部证据、工作草稿逐层收窄
4.1 用“最小充分上下文”替代“全量上下文”
每个子Agent真正需要的通常只有四类信息:目标、验收标准、局部证据、必要约束。完整聊天历史、无关代码、其他分支的草稿和全部工具定义不应该默认继承。对于代码仓库,先检索相关文件,再把文件路径与关键片段交给子Agent;对于研究任务,先把公共问题定义和已知事实写成一页“任务摘要”,不要把几十轮对话原样复制。
4.2 子Agent返回“摘要 + 证据 + 产物引用”,不要返回完整思考史
Anthropic的上下文工程实践强调,子Agent可以在自己的干净上下文里做深度工作,但回到主Agent时只返回压缩后的结论,通常是1K~2K Token量级,并把详细结果写入外部产物。这个模式能同时减少信息损失和Token开销:主Agent只需要知道“结论是什么、证据在哪里、产物怎么引用”,而不是重读子Agent几十页搜索过程。
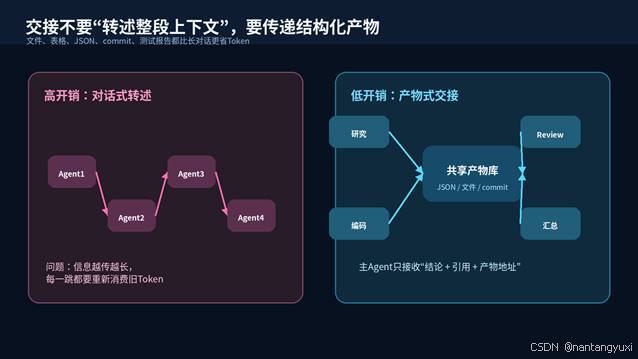
图6 产物式交接比“对话转述”更省Token,也更容易审计
5. 第三大黑洞:工具定义和工具结果悄悄占满上下文
多Agent一旦接入MCP、搜索、数据库、工单、文件系统等大量工具,工具定义本身就会变成一笔固定税。Anthropic在高级工具使用实践中展示过一个极端但很典型的现象:几十个MCP工具的定义可以在用户问题进入前就吃掉数万Token;工具结果如果原样回灌,成本和上下文污染会进一步扩大。
|
问题 |
低成本改法 |
不要这样做 |
|
工具定义太多 |
按需Tool Search / 动态加载3~5个相关工具 |
每个Agent启动时加载全部MCP Schema |
|
工具结果太长 |
分页、过滤、范围选择、服务器端聚合 |
把整张表/整份日志塞回模型 |
|
重复读相同资料 |
产物缓存、共享检索结果ID |
每个子Agent重新下载同一文件 |
|
结构化数据转文字 |
让代码/SQL先聚合再给模型 |
把十万行JSON直接交给LLM |
一个常被忽略的优化是“让代码处理数据,让模型处理判断”。如果任务只是排序、去重、筛选、计数、Join、格式转换,让代码执行环境先把原始数据压缩成几十行结构化结果,通常比让LLM逐Token读取更便宜、更确定。
6. 缓存:最便宜的Token,是第二次不用重新算的Token
Prompt Cache对多Agent非常重要,因为系统提示、工具契约、项目规范往往会被多个分支重复使用。但“打开缓存”不等于“缓存命中”。缓存依赖稳定前缀:如果你把用户动态输入、时间戳、随机ID插在公共规则中间,同一份规范在每个请求里都会变成不同前缀。
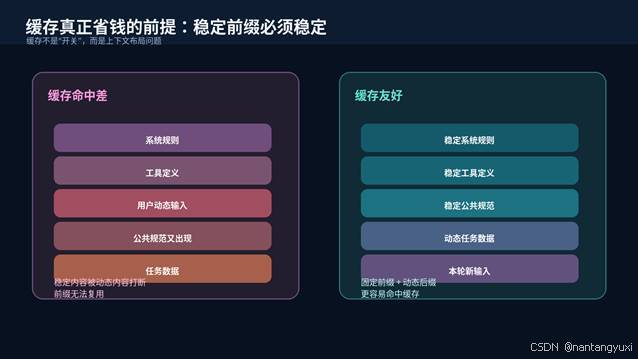
图7 缓存友好的上下文布局:稳定内容在前,动态内容在后
以OpenAI当前API为例,GPT-5.6及以后模型的缓存读取价格是未缓存输入的0.1倍,缓存写入是1.25倍;这意味着缓存适合“会被重复读”的稳定前缀,而不是所有内容都强行写入。真正应该监控的是cache_write_tokens、cached_tokens以及后续复用次数,而不是“是否启用了缓存”这个布尔值。
|
缓存是否划算的直觉 一段公共上下文如果只用一次,缓存写入反而更贵;如果会被多个子Agent或多轮请求重复读取,缓存才开始形成净收益。把“预计复用次数”加入spawn预算,比盲目缓存更可靠。 |
7. 模型路由:不要让所有Agent都坐商务舱
多Agent系统常见的第二类结构性浪费,是所有角色都默认使用同一个旗舰模型。实际上,规划、深度推理、简单提取、格式化、验证的认知难度完全不同。成本治理的关键不是“永远用便宜模型”,而是用最便宜、但能稳定满足该角色SLO的模型。

图8 模型分层:把最强模型留给最需要判断力的环节
|
角色 |
建议模型档位 |
典型任务 |
升级条件 |
|
路由/分类 |
低成本 |
判断任务类型、选工具、提取字段 |
置信度低或涉及高风险 |
|
并行执行 |
低~中档 |
检索、局部编码、数据清洗、草稿 |
复杂推理或多约束冲突 |
|
主Agent |
中~高档 |
规划、依赖管理、综合多个结果 |
高价值任务或证据冲突 |
|
Reviewer |
按风险触发高档 |
安全、正确性、关键决策复核 |
高金额/生产变更/不可逆操作 |
截至2026年9月,OpenAI API公开价格里,GPT-5.6 Luna、Terra、Sol的标准短上下文输入价分别约为$0.20、$2、$4/百万Token,输出价约为$1.20、$12、$20/百万Token;Anthropic Claude Sonnet 5约为$2/$10,Opus 5.5约为$4/$20。具体价格会变化,但数量级足以说明:把批量低难度子任务从旗舰模型下沉到成本型模型,往往比“删几句Prompt”更有杠杆。
8. 长上下文不是无限优惠:跨过价格阈值前要主动压缩
大上下文还有一个容易被忽略的价格拐点。以GPT-5.6 Sol为例,当前模型文档说明当输入超过272K Token时,整次请求的输入按2倍、输出按1.5倍计价。也就是说,很多“把所有分支结果都塞回主Agent再总结”的做法,不仅让Token变多,还可能让整次综合请求进入更高价区间。
· 在主Agent上下文达到阈值前主动compaction,只保留目标、决策、未解决问题和产物索引。
· 把大文件和完整报告放到对象存储/文件系统,只在上下文里放ID、路径、哈希和摘要。
· 对子Agent结果设置硬输出上限:例如摘要1K~2K Token,完整结果写产物。
· 长任务按里程碑切段,每段结束写结构化checkpoint,再用新上下文继续。
9. 重试不是可靠性免费午餐:先分类失败,再消耗预算
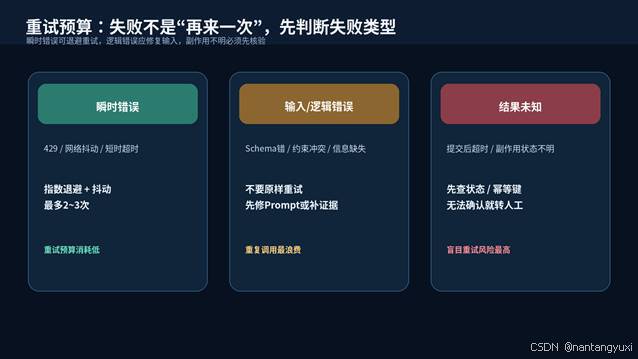
图9 三类失败对应三种完全不同的处理策略
多Agent系统里,最可怕的不是一次失败,而是“失败触发扇出重试”。比如主Agent创建4个子Agent,其中一个因429失败,调度器选择重跑整组;如果重试逻辑再遇到超时,就会产生2×、3×的成本放大。正确做法是把重试预算绑定到最小失败单元:只重跑失败分支,并且失败类型必须可解释。
9.1 建议的重试预算
· 瞬时网络/429:指数退避 + 随机抖动,通常最多2~3次。
· 输入/Schema错误:不允许原样重试,必须修改输入或降级路径。
· 副作用状态未知:先查询业务状态或幂等键,禁止盲目重放。
· 连续失败达到阈值:熔断该工具或该模型路由,切备用方案或转人工。
10. 预算控制器:让spawn变成一个“需要审批的资源决定”
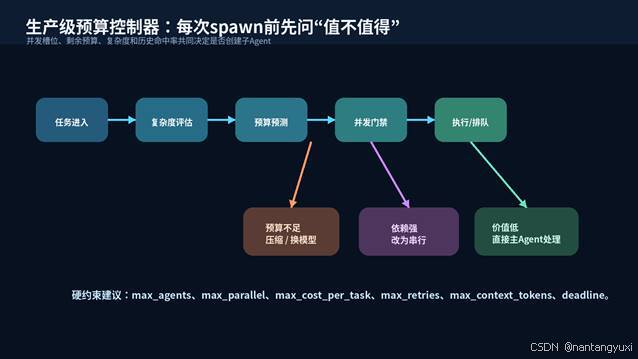
图10 生产级预算控制器:创建子Agent之前先做价值与资源判断
真正成熟的多Agent系统不会让“创建子Agent”只是一个普通工具调用。它更像申请数据库连接、申请GPU或启动容器:必须经过配额、并发和预算检查。可以给每个任务设置max_cost_per_task、max_agents、max_parallel、max_retries、max_context_tokens和deadline;主Agent每次准备spawn时,先估算新增分支的Token和工具成本,如果剩余预算不足,就压缩上下文、切换更便宜模型、改为串行,或者直接由主Agent处理。
代码示例:一个最小可用的预算 + 并发门禁
|
from dataclasses import dataclass @dataclass def can_spawn(self, estimated_usd: float) -> bool: def reserve(self, estimated_usd: float): semaphore = asyncio.Semaphore(3) # 单任务最多3个并行分支 async def run_subagent(task, budget, estimate): |
生产环境还应把“预估成本”和“实际成本”同时记录。预估用于阻止明显超预算的调用,实际用于校准估算器。随着日志积累,可以按任务类型训练一个非常简单的回归模型,预测输入Token、输出Token、工具调用次数和成功率,让预算控制从静态阈值升级为数据驱动。
11. 可观测性:不要问“今天用了多少Token”,要问“花的钱换来了什么”
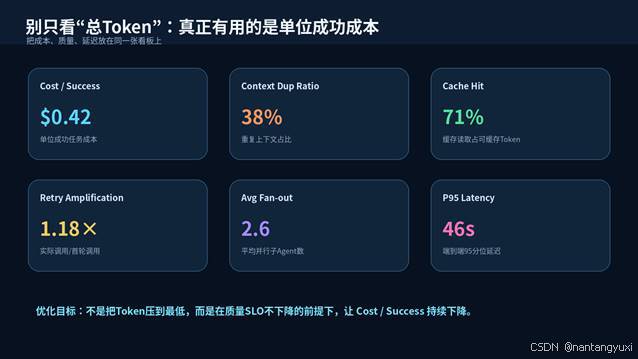
图11 多Agent成本看板应该同时显示成本、质量与延迟
|
指标 |
公式/定义 |
为什么有用 |
|
Cost / Success |
总成本 ÷ 成功任务数 |
最核心的单位经济性指标 |
|
Context Dup Ratio |
重复上下文Token ÷ 总输入Token |
定位“复制粘贴型”浪费 |
|
Cache Hit Ratio |
缓存读取Token ÷ 可缓存Token |
判断缓存布局是否真的有效 |
|
Retry Amplification |
实际调用数 ÷ 首轮调用数 |
识别失败导致的成本放大 |
|
Fan-out |
每个任务平均创建的子Agent数 |
判断是否过度并行 |
|
Token / Accepted Result |
总Token ÷ 被主Agent采用的结果数 |
发现低价值分支 |
|
P95 Latency |
95分位端到端时延 |
避免省钱后用户体验崩溃 |
这些指标必须按任务类型、模型、Agent角色和工具拆分。否则“平均值”会掩盖问题:可能80%的任务非常便宜,只有5%的复杂任务因为无限fan-out和长上下文把账单拉高。对多Agent系统来说,P90/P95成本分布往往比平均成本更重要。
12. 一个完整算例:6个Agent如何把单任务成本从约$1.7降到约$0.5
下面用一个“多源研究 + 报告”任务做示意。假设原方案由1个主Agent、4个研究Agent、1个Reviewer组成,全部使用同一高档模型,且每个研究Agent都复制完整背景。价格仅用2026年9月公开API单价做估算,实际账单还取决于缓存、工具、地区和服务层级。这个例子的目的不是给出固定成本,而是展示优化顺序。
|
阶段 |
原方案 |
优化方案 |
主要变化 |
|
主Agent规划 |
Sol,40K in / 6K out |
Terra,18K in / 3K out |
公共背景压缩为任务摘要 |
|
4个研究分支 |
每个Sol,32K / 8K |
每个Terra,12K / 4K |
限制输出,按来源切分避免重叠 |
|
Reviewer |
Sol,45K / 5K |
Sol,20K / 3K |
只读摘要+证据索引,不重读全部过程 |
|
并发 |
一次开4~6个 |
max_parallel=3 |
降低限流与同步重试 |
|
交接 |
复制完整文本 |
产物引用 + 结构化摘要 |
减少主Agent二次输入 |
按GPT-5.6 Sol约$4/M输入、$20/M输出,Terra约$2/M输入、$12/M输出粗算:原方案约$1.7/任务;优化方案约$0.5/任务,降幅约70%。如果稳定前缀还能获得较高缓存命中,成本还会进一步下降。更重要的是,这个优化没有依赖“把所有Agent换成最便宜模型”,而是先减少重复,再做模型分层。
|
不要只看降本百分比 任何模型降档、输出截断或并发收紧,都必须配套离线Eval与线上质量SLO。便宜但错误的结果不是优化;真正的优化是 Cost / Success 下降,同时正确率、召回率、安全性和P95延迟仍在目标范围内。 |
13. 异步任务别走实时通道:Batch/Flex也是成本工具
很多多Agent任务并不要求秒级返回,例如离线评测、批量分类、夜间代码扫描、知识库重建、历史工单摘要。这些任务如果和在线请求使用同一高优先级通道,既贵又会抢实时配额。OpenAI当前Batch API公开说明提供50%的成本折扣,并使用独立的批处理配额;Flex则用更慢、偶尔资源不可用换取更低价格。把“是否需要实时”作为调度维度,往往比继续压Prompt更有效。
· 在线用户请求:Standard/Fast,严格控制fan-out和deadline。
· 夜间评测、批量处理:Batch,接受24小时内完成。
· 低优先级后台任务:Flex或同类低价服务层。
· 周期性汇总:先聚合数据,再一次性让模型生成结论。
14. 决策树:什么时候值得多开一个Agent?
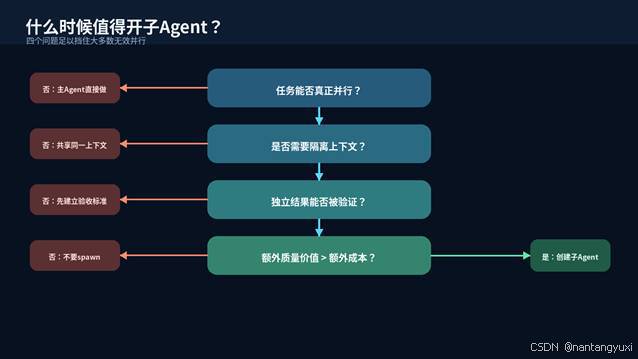
图12 创建子Agent前的四问决策树
如果一个任务不能并行、必须频繁共享可变状态、没有独立验收标准,或者额外质量价值很低,多Agent通常不是正确答案。此时更好的选择可能是单Agent + Workflow、单Agent + 工具、或者先用代码把确定性步骤完成,再让模型处理最后的判断。
15. 上线前检查清单
|
检查项 |
通过标准 |
|
任务边界 |
每个子Agent有独立目标、输入、输出和验收标准 |
|
最大扇出 |
设置max_agents和max_parallel,默认小于等于3~4 |
|
上下文 |
公共内容去重;完整文件用引用而非复制 |
|
工具 |
按需加载;结果有分页、过滤、截断 |
|
输出预算 |
每个角色有max_output_tokens或结构化Schema |
|
模型路由 |
低难度分支使用成本型模型,Reviewer按风险触发 |
|
缓存 |
稳定前缀在前,记录cache_write/cached_tokens |
|
重试 |
按失败类型处理,禁止整树盲目重跑 |
|
预算 |
每任务有max_cost、deadline、token cap |
|
可观测性 |
能按task/agent/model/tool查看Cost / Success |
|
Eval |
任何降本策略都经过质量回归测试 |
|
降级 |
预算不足、限流、模型不可用时有串行/低档/人工路径 |
16. 结语:真正成熟的多Agent,不是“会开更多Agent”,而是“知道什么时候不该开”
多Agent的能力提升,本质上来自更多上下文窗口、更多工具调用和更多并行计算。它天然不会比单Agent便宜。工程上能做的,不是幻想“多Agent零成本”,而是让新增计算只发生在有边际价值的地方:可并行的任务才并行,需要隔离的上下文才隔离,低难度任务下沉模型,稳定前缀尽量缓存,长结果写产物而不是反复塞回对话,失败只重试最小单元。
最终你需要管理的也不是“Token数量”,而是单位成功成本。一个系统今天用了1000万Token并不可怕;可怕的是没人知道其中多少是重复上下文、多少分支最后没有被采用、多少是盲目重试、多少是本可以交给代码或更便宜模型完成的工作。只要这些成本能被解释、预算能被约束、质量能被评测,多Agent就不再是一个烧钱的黑盒,而是一套可以持续优化的计算系统。
参考资料
OpenAI, Multi-agent guide: https://developers.openai.com/api/docs/guides/responses-multi-agent
OpenAI, Pricing: https://developers.openai.com/api/docs/pricing
OpenAI, Prompt caching: https://developers.openai.com/api/docs/guides/prompt-caching
OpenAI, Cost optimization: https://developers.openai.com/api/docs/guides/cost-optimization
OpenAI, Batch API: https://developers.openai.com/api/docs/guides/batch
Anthropic, How we built our multi-agent research system: https://www.anthropic.com/engineering/multi-agent-research-system
Anthropic, Effective context engineering for AI agents: https://www.anthropic.com/engineering/effective-context-engineering-for-ai-agents
Anthropic, Code execution with MCP: building more efficient AI agents: https://www.anthropic.com/engineering/code-execution-with-mcp
Anthropic, Introducing advanced tool use: https://www.anthropic.com/engineering/advanced-tool-use
Anthropic, Claude Sonnet 5: https://www.anthropic.com/news/claude-sonnet-5