在校园心理健康数字化建设中,传统心育模式重普查、轻跟踪,心理老师一人面对几千名学生,靠纸质量表和事后谈话勉强支撑。本文从一线心理老师的真实吐槽出发,拆解传统心育模式在筛查覆盖、数据质量、人力配置与信号研判上的四块短板,再给出 AI 多模态情绪识别 + 量表测评 + 智能预警的补齐思路,附系统架构与"一生一档"数据闭环参考。
一、心理老师吐槽合集:四类典型场景
先看四类高频出现的工作场景。它们不是"个例",而是一线心理老师在传统心育模式下反复踩到的坎。
场景一:开学普查,录量表录到手软
每学期开学,全员心理普查。3000 份纸质 SCL-90 问卷,扫描、手工录入、跑统计、写汇总。
"我一周要录 300 份量表,录到第 200 份时手已经在抖,哪还有时间坐下来跟学生做咨询?"
这张图是大多数学校心理老师最熟悉的画面:
• 普查任务重、周期长,名单不准(重号、已退学未销号、班级调整未更新);
• 录数据占掉大半工作时间,咨询服务时间被严重挤压;
• 结果只给出整体均分,无法快速看出哪些人需要立刻跟进。
传统心育的第一块短板就出来了——筛查靠周期、覆盖有盲区。
场景二:量表全选"从无",数据失真
普查季结束后,最怕的不是"分高",而是"分太低"的卷子——那种从头到尾选"从无""很轻"的,老师一眼就知道不真实。但没有旁证数据可以交叉验证,没法判断是真没事还是不愿说。
"同一份 SCL-90,一个学生填 180 分,另一个学生填 30 分。卷面看着差不多,但一个在求助,一个在防御。"
传统心育的第二块短板——数据单一、易被防御。
单一自评量表本质上只能测到"愿意如实作答的学生"。社会赞许性偏差、防御性作答、状态波动,都可能让结果偏离真实。
场景三:出事之后才看到"上学期成绩一直在掉"
典型场景:某次危机事件复盘时,老师调出学生过往数据,发现"上学期成绩滑坡 + 缺勤增多 + 朋友圈异常",这些信号当时没有人把它们和情绪状态放在一起看。
传统心育的第三块短板——信号割裂、研判缺证据。
心理数据、学业数据、出勤数据、奖惩数据分散在不同系统,没有跨数据源的融合研判机制。等到出事了再回头看,每个信号都是"事后诸葛亮"。
这也是为什么心理老师普遍觉得"我应该更早发现",但又确实发现不了。
场景四:走进咨询室的是少数
真正走进咨询室的学生往往并不是最需要帮助的那批人。
"主动来咨询的多是学习压力、人际关系;真正处于危机中的学生,常常是一个人在角落里被我们忽略。"
传统心育的第四块短板——服务模式天然只覆盖"主动求助者"。
传统心育是"被动响应":你来找我,我接你;你不来,我不知道你是谁、状态如何。
这四类场景汇总起来,构成了传统心育模式最常见的痛点清单。
二、传统心育模式的四块短板
吐槽背后是结构性问题,不是"心理老师不够努力"。下表把四类短板系统化拆开:
|
短板 |
传统模式表现 |
直接后果 |
|
筛查覆盖有盲区 |
一年 1-2 次普查,间隔数月空窗;只覆盖愿意配合的学生 |
关键时段(考试前后、季节交替)错过;高危学生隐身 |
|
数据单一易防御 |
依赖单一自评量表,社会赞许性偏差大 |
量表分数失真,真实状态被遮蔽;防御性作答无法识别 |
|
人力严重短缺 |
1 名心理老师对几千名学生,录数据、写档案占大部分时间 |
咨询时间被挤压,咨询师高负荷运转容易职业倦怠 |
|
信号割裂缺证据 |
心理/学业/出勤数据分散在不同系统,无融合研判机制 |
预警靠老师经验,事后才发现;危机事件难以早期介入 |
这四块短板是环环相扣的:覆盖不全 → 数据失真 → 老师更累 → 信号更难及时发现。要补齐,不能只在某一块上"加点料",而是要在模式层面把整个链路重新设计。
三、AI 多模态为什么能补齐:思路转变
补齐短板的核心不是"上 AI 显得高级",而是把心育从单一自评、周期普查、事后处置转向多模态、常态化、全程跟踪。两者的区别见下表:
|
环节 |
传统模式 |
AI 多模态模式 |
|
筛查覆盖 |
一年 1-2 次普查 |
无感监测 7×24 常态化覆盖 |
|
数据来源 |
单一自评量表 |
视觉+步态+量表+投射+对话,五维融合 |
|
预警方式 |
经验判断/事后发现 |
规则 + 关注度模型实时触发 |
|
人力配置 |
老师全程录数据 |
系统自动采集、自动归档,老师聚焦咨询 |
|
研判依据 |
单点数据 |
多模态交叉验证(量表 vs 无感 vs 投射) |
|
重点人群 |
主动求助者 |
覆盖沉默的高危学生 |
所谓"多模态",就是把不同类型的数据互补起来用:
• 视觉(人脸情绪)解决"不主动来咨询的学生看不到";
• 步态(行为情绪)解决"面部刻意控制时的识别";
• 量表自评(SCL-90/SAS/SDS 等)给出标准化、可对照常模的判定基线;
• 汉字联想投射解决"量表防御性作答"问题,挖掘深层心理;
• AI 数字人对话解决"7×24 可及性"。
每一类模态单独看都有局限,五类合起来才有可能拼出接近真实的心理状态画像。
下面这张表,是常见多模态数据源的工程化清单。
|
模态 |
采集方式 |
输出数据 |
补齐的短板 |
|
视觉情绪 |
校园已有摄像头+边缘节点,无感采集 |
七维情绪(快乐/平静/悲伤/惊讶/愤怒/厌恶/恐惧) |
覆盖盲区 + 7×24 监测 |
|
步态情绪 |
视频流分析,无感采集 |
四维步态情绪(快乐/感兴趣/无聊/厌恶) |
面部刻意控制时的交叉验证 |
|
量表自评 |
线上施测 SCL-90/SAS/SDS 等权威量表 |
因子分、结论、AI 建议 |
标准化判定基线 |
|
汉字联想投射 |
30 词联想,引导式作答 |
思维健康度、潜意识自我、负性情绪 |
突破防御性作答,挖掘深层 |
|
AI 数字人对话 |
7×24 文字/语音交互 |
交互记录+情绪轨迹 |
服务可及性 + 即时疏导 |
四、系统架构:多模态数据如何流动
一个能落地补齐短板的多模态心育平台,至少要做到四层分工清晰。
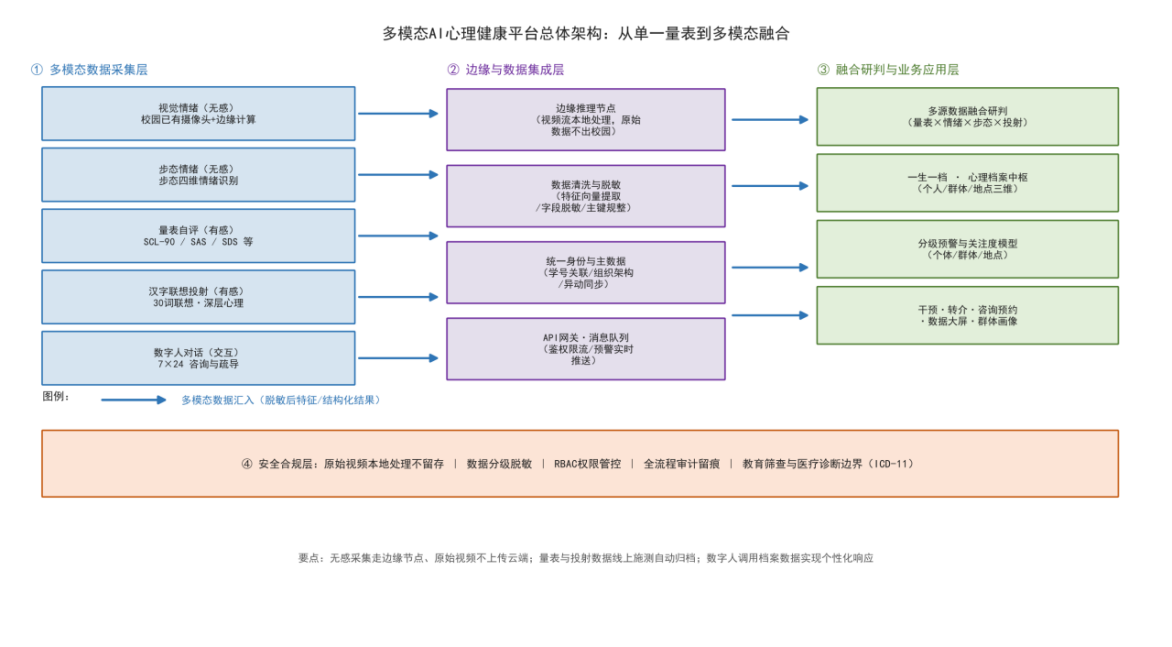
图 1 多模态 AI 心理健康平台总体架构图
几个工程上的关键点:
• 无感监测必须走边缘计算节点,原始视频本地处理、特征向量上行,原始画面不出校园——这是合规底线,也是技术效率最优解。
• 量表与汉字联想这类"有感"数据,线上施测即可,无需专用硬件,但需要做好标准化施测流程与防作弊机制。
• AI 数字人不是独立外挂,它要调用档案中枢里的无感数据 + 量表数据,给出"针对这个学生当下状态"的个性化响应,而不是通用话术。
• 安全合规层是横在所有层底下的:数据分级脱敏、RBAC 权限、审计留痕、教育筛查与医疗诊断的边界要清晰(按 ICD-11 划分)。
五、数据闭环:以"一生一档"档案中枢为核心
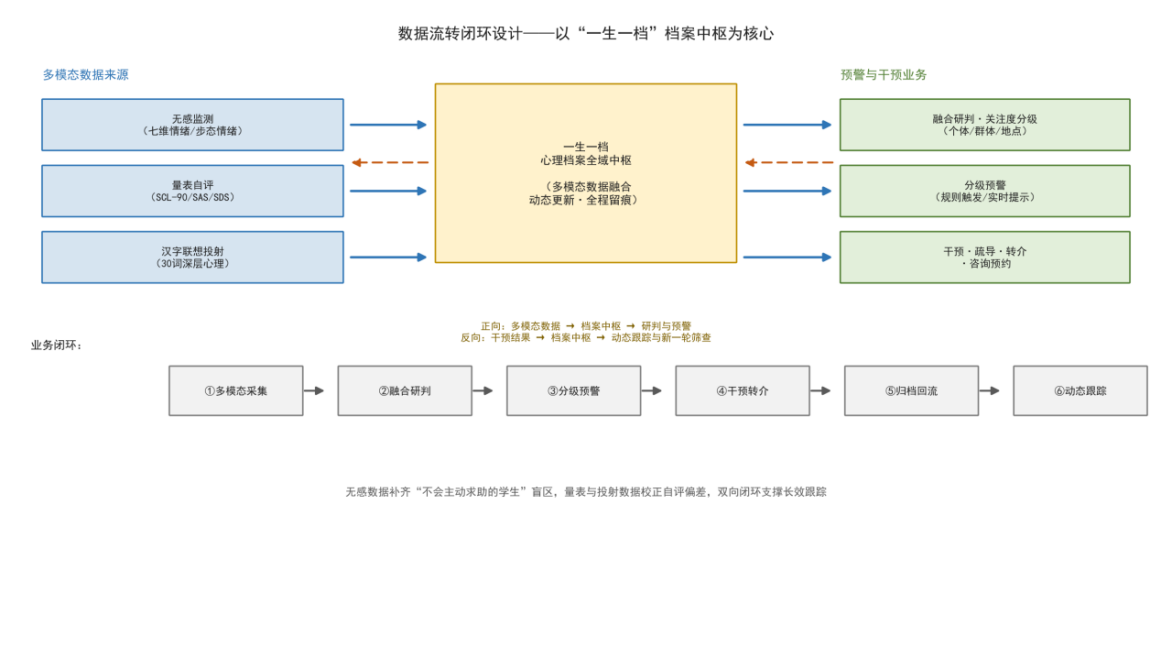
图 2 以"一生一档"档案中枢为核心的数据闭环
多模态数据采集上来之后,平台内部必须有一个统一的"档案中枢"——把每个学生的多模态数据动态聚合成一份"一生一档"心理档案,所有业务模块都围绕它读写。
5.1 多模态数据怎么融合?给一个具体例子
某高二学生,本学期 SCL-90 自评正常,防御性作答明显。系统在做融合研判时观察到:
• 视觉情绪:近两周校内公共区域无感监测显示"悲伤+厌恶"主导频次高于基线 2 个标准差;
• 步态情绪:步态识别显示"无聊+厌恶"为主,与面部情绪不冲突;
• 汉字联想投射:30 词联想中负性词占比偏高,与量表"全选正常"形成强烈反差;
• 学业数据:近一个月请假 3 次,期中成绩较上学期下降 18%。
系统按预设规则融合判定为中风险(关注度"中"),触发关注度预警和班主任工作台提示,由心理老师在 24 小时内完成人工复核。
这就是多模态补齐单一量表"防御性作答"短板的实际价值。
5.2 预警分级与响应时效
|
关注度等级 |
风险类型 |
系统响应 |
人工处置时效 |
|
无 |
常态波动 |
持续记录 |
— |
|
低 |
阶段性适应问题 |
档案汇总,提示关注 |
学期内复盘 |
|
中 |
明显异常信号叠加 |
触发预警,推送班主任/心理教师 |
24 小时内 |
|
高 |
多模态持续异常或规则命中 |
多角色同步通知,启动干预流程 |
2 小时内 |
5.3 数据回流与持续跟踪
"一生一档"档案中枢不是写完就结束。下一次筛查的基线、上一次干预的效果跟踪、个体情绪变化曲线、群体心理画像——都依赖档案中枢的累积数据。
• 正向数据让研判"有据可依":多模态数据回填档案,预警有证据链;
• 反向数据让工作"可见可管":干预结果回流档案,期末可看班级/年级心理态势;
• 动态跟踪让模式"持续运转":每一轮筛查的基线自动更新,模型随校情调整。
六、隐私合规底线
校园心理数据涉及未成年人个人信息,合规设计不是"加分项",是"一票否决项"。以下几点必须落地:
|
合规要求 |
具体做法 |
|
最小化采集 |
心理平台只申请业务必需字段;不盲目同步非必要数据 |
|
边缘处理 |
无感监测的原始视频本地处理,特征向量上行;原始画面不留存 |
|
分级脱敏 |
敏感字段(身份证、家庭病史)做掩码/哈希;测评原始得分不出库 |
|
RBAC 权限 |
区分学生/班主任/教师/心理教师/管理员六类角色,按需可见 |
|
审计留痕 |
谁在什么时间看了谁的档案、导出了什么,全程可追溯 |
|
边界划清 |
教育筛查与医疗诊断严格分开(按 ICD-11 分类),系统不出具诊断结论 |
|
伦理与告知 |
无感监测需在校园显著位置告知;学生/家长有知情权与申诉渠道 |
落地时可参考的标准包括:《学生心理健康档案的建立与管理规范》(T/FPHE 001-2023)、《心理咨询服务规范》GB/T 30446.2-2013、《个人信息保护法》未成年人相关条款,以及 ICD-11 关于心理问题分类的编码。
七、落地实施:三步走与常见坑
|
阶段 |
关键动作 |
效果 |
|
第一步(1-2 周) |
上线线上量表 + 档案电子化,把录数据环节彻底自动化 |
老师从录入工作中解放出来,咨询时间显著增加 |
|
第二步(2-4 周) |
接入无感监测 + 分级预警,建立关注度模型 |
覆盖盲区消除,沉默学生开始进入视野 |
|
第三步(2 周) |
上线数字人 + 汉字联想投射,全模态融合研判 |
防御性作答被识别,研判准确性提升一个量级 |
下面是几个最常见的坑,提前避一下:
• 只买设备不做流程:硬件到位但老师不会用,预警来了没人处置,反而变成新的负担。
• 把预警当考核指标:一旦预警和绩效挂钩,班主任会想方设法让预警"消失",系统失去价值。
• 摄像头滥用引发舆情:未告知、未限定场景、未做边缘处理,容易被家长投诉。
• 数据孤岛依然存在:只做心理平台,不打通学工/教务,研判依旧靠经验,短板没补上。
• 忽视 AI 数字人对话质量:通用话术学生立刻识破,反而消耗信任。
八、结语
心理老师吐槽的痛点,本质不是"老师不够多",而是传统心育模式在数据采集、人力配置、信号研判三个层面的结构性短板。AI 多模态能补齐的,正是这三个层面:
• 用视觉 + 步态无感监测补"覆盖盲区";
• 用 SCL-90 等量表 + 汉字联想投射补"单一自评易防御";
• 用一生一档档案中枢 + 多模态融合研判补"信号割裂缺证据";
• 用 AI 数字人 + 7×24 监测补"主动求助者偏少"。
这套组合不是替代心理老师,而是把老师从录数据、跑统计的体力活中解放出来,让他们真正回到咨询和育人上。当技术承担了"看见每一个学生"的工作,老师才能承担"陪每一个学生成长"的工作。
一句话总结:传统心育的短板靠单点修补无效,AI 多模态的价值在于用五类互补数据 + 一生一档档案中枢,把"被动响应"升级为"主动看见"。