音频大模型记不住谁说、怎么说的?VoxMem 二维框架量差距
目录
- 一、导语
- 二、先说清楚:这不是又一个长上下文榜单
- 三、它想量清的真问题:文字记不下的三类信息
- 四、二维框架怎么搭:证据类型 × 记忆操作
- 五、15 个模型实测:记词可以,记人记声崩了
- 六、现在就能跑:用 VoxMem 给语音助手做体检
- 七、冷静视角:这把尺子量得准,也有边界
- 总结
一、导语
2026年9月,墨尔本大学与新南威尔士大学团队在 arXiv 提交了一篇题为 VoxMem 的论文(编号 2609.32607),10月9日前后由新智元等媒体做了通俗解读。这篇工作没有发布新模型,而是给出了一把新的"尺子":专门量音频大模型在多次会话里,到底能不能记住"谁说的、怎么说的、现场有什么声音"。对做语音助手、家庭多用户助理、客服机器人的开发者来说,这把尺子量出的差距,比"上下文窗口又拉长了多少"更贴近真实体验。
二、先说清楚:这不是又一个长上下文榜单
先给不太熟悉的人补一个前提:这里说的"音频大模型"通常指 LALM(Large Audio Language Model,大型音频语言模型),它直接吃音频、吐文本或语音,不经过"先转文字再问答"的两段式流程。Qwen3-Omni、Gemini 系列、Phi-4-Multimodal、Audio-Flamingo 等都在这个范畴。
顺带一提,评测音频记忆时有两条常见的偷懒路线:一是先 ASR 转写、再让文本模型答,二是只给单轮短音频。前者直接把声学证据丢掉,后者根本没有"跨会话"可言。VoxMem 刻意避开这两条——所有被测模型都走原生音频接口,历史是多段相隔的会话,而不是一段被拉长的录音。
VoxMem 容易被人误读成"又一个比上下文长度"的榜单,但它关心的不是窗口够不够长,而是窗口再长,模型到底往里记了什么。这里有两个关键区分,动手前要先厘清:
- 词面内容(lexical content)vs 声学证据(acoustic evidence)。前者是"说了什么",转写成文字就完整保留;后者是"谁说的、怎么说的、周围有什么声音",只存在于波形里,转写即丢失。
- 单点抽取 vs 记忆操作。旧基准大多只考"从一段里取出一句话";而真实记忆要的是跨会话拼证据、跟状态、证据不够时知道闭嘴。
把这两点合起来看,VoxMem 的占位就清楚了:它是多会话语音记忆基准,用"声学证据类型 × 记忆操作"的二维框架,把音频记忆这件事拆开量,而不是用一把总分的尺子糊弄过去。
三、它想量清的真问题:文字记不下的三类信息
设想一台家庭语音助手同时服务一家人。你某天随口问:“我之前说的灯具更换,后来怎么样了?“要答对,助手得先听出提问的人是你——因为几天前另一位家人也聊过灯具更换,说的是"已批准”,而你当时说的是"先暂停”。这正是语音和文字最大的不同:会议纪要能记下每人说了什么,却记不下说话时的犹豫、惊讶,也记不下窗外的施工声。
这类问题不止出现在家里。会议室里多人轮流发言、客服热线中同一客户多次来电、车载助手服务全车乘客——只要"谁在什么时候、用什么语气说了什么"会影响答案,纯文字记录就不够用。VoxMem 的出发点,正是把这类"文字答不上来"的问题变成可量化、可复现的考题,而不是停留在直觉层面。VoxMem 把这种"只活在波形里"的信息归成三类声学证据:
为什么旧基准量不出这个?论文在对比表里点得很直白:SpokenWOZ、ContextDialog 只考词面;AudioMarathon、LongSpeech、VoiceGiraffe 把单段录音拉长;Audio MultiChallenge 仍是一段连续对话,只有 3~8 轮。它们要么只考"说了什么",要么把历史塞进一段超长录音——测的是"听懂这一段",不是"跨会话把证据绑回来"。更隐蔽的坑是:很多基准在不同长度下换不同的题,于是历史变长导致的掉分,和题目本身变难导致的掉分缠在一起,根本分不清。这正是 VoxMem 要拆掉的两根枷锁。
四、二维框架怎么搭:证据类型 × 记忆操作
VoxMem 的核心设计是一张二维分类法,两条轴分别回答"要记住什么"和"要对它做什么"。
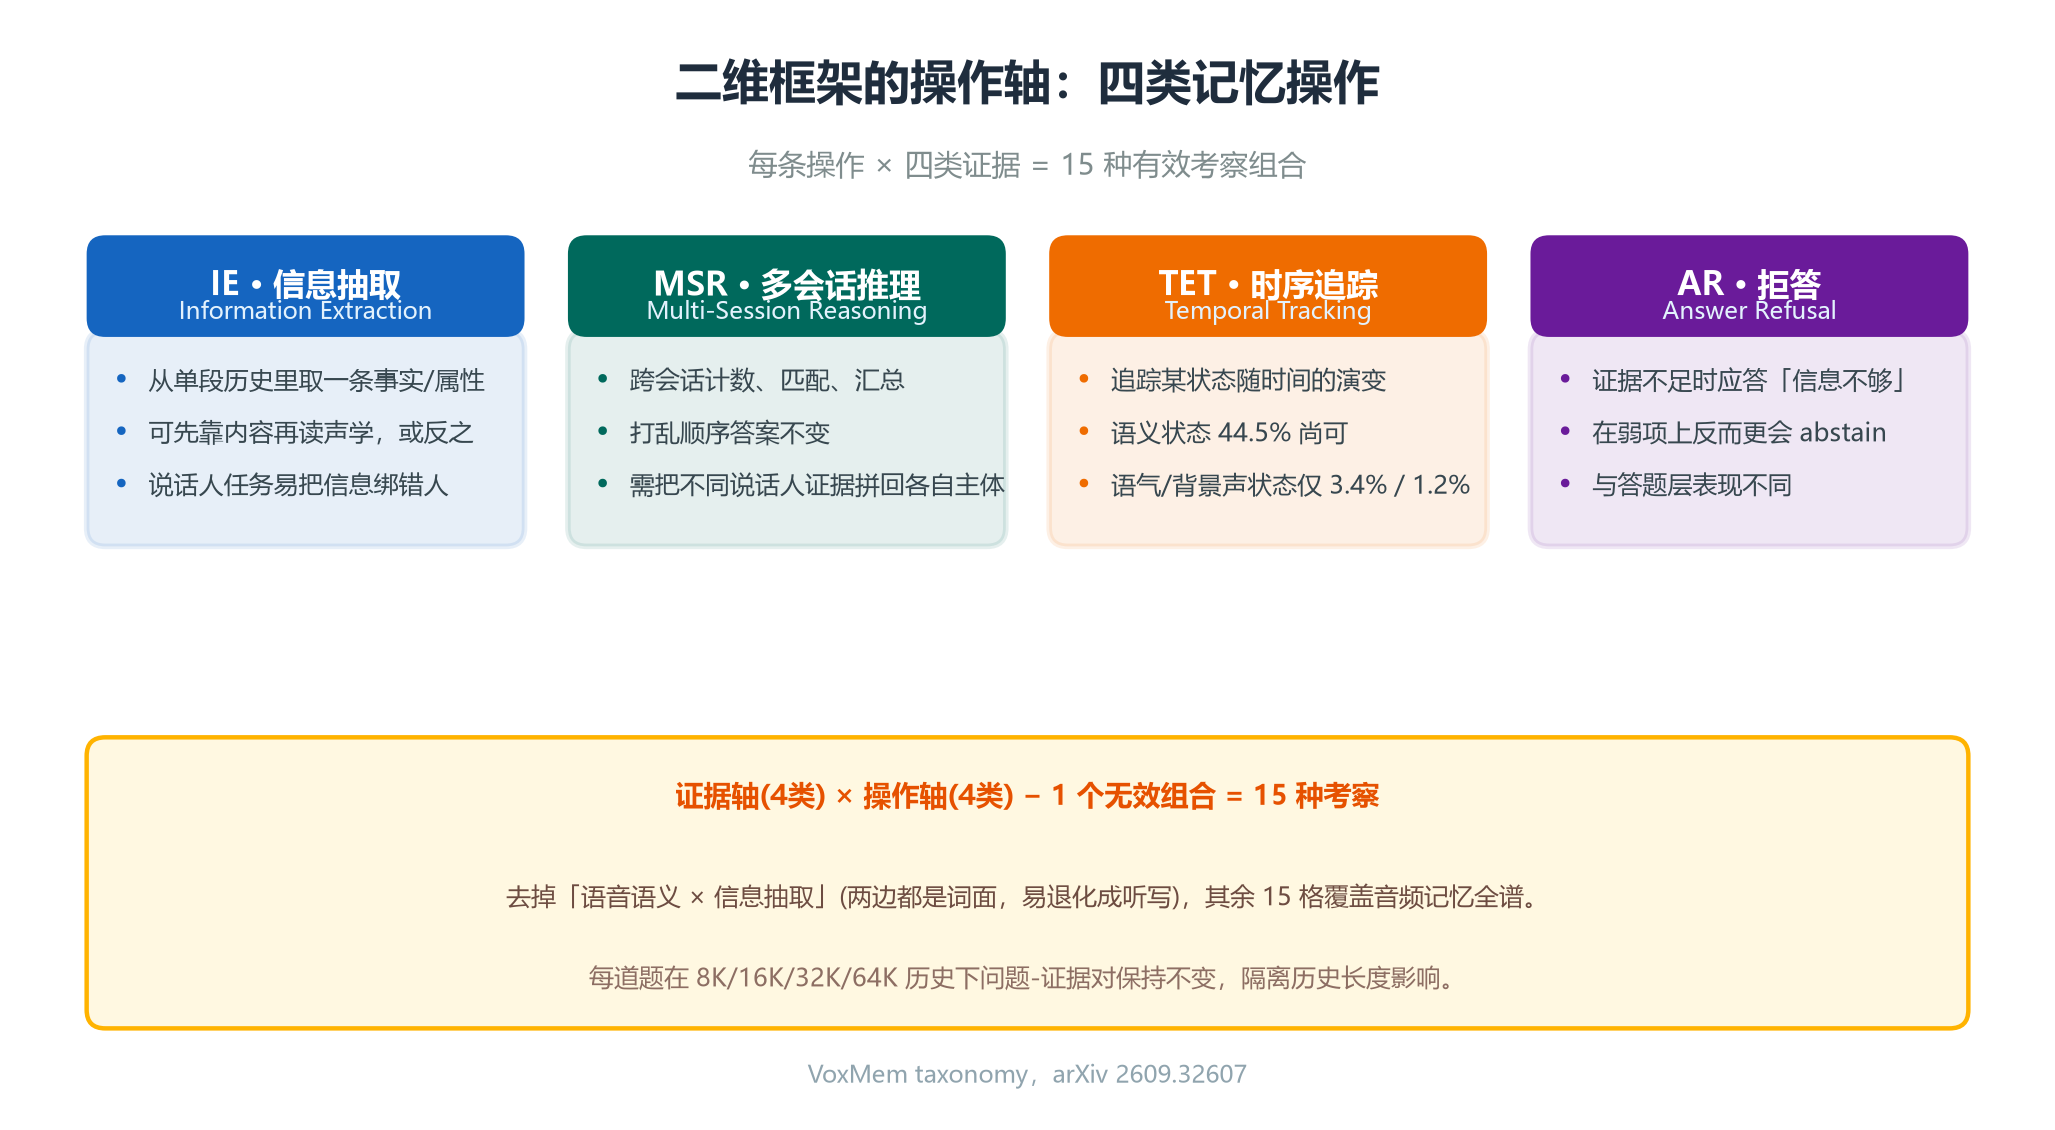
证据轴(4 类):语音语义、说话人身份、副语言线索、环境声。 操作轴(4 类):
- 信息抽取(IE):从单段历史里取出一条事实或属性。
- 多会话推理(MSR):跨多个会话计数、匹配、汇总,打乱顺序答案不变。
- 时序追踪(TET):追踪某个状态随时间怎么演变。
- 拒答(AR):证据不足时,应当回答"信息不够",而不是硬编。
两轴相乘是 4×4=16 格,论文去掉了"语音语义 × 信息抽取"这一格——因为两边都是词面,容易退化成听写,留它没意义,于是还剩 15 种有效组合。这 15 格覆盖了音频记忆的全谱,比只问"能不能复述一句话"严格得多。比如"三次会话里,谁先提到预算超支?"属于说话人身份 × 多会话推理;"他提预算时的语气,是从犹豫变成了坚定吗?“属于副语言 × 时序追踪。一个问题要同时锁定"证据类型"和"操作”,才能说清模型到底缺哪块能力。
(图三:四类记忆操作各自的考察重点与难点)
为了把"历史长度本身的影响"单独拎出来,VoxMem 在 8K、16K、32K、64K token 四个上下文预算下,让每道题的问题与其证据严格保持不变——四档历史是嵌套的,只往里塞无关的填充会话来拉长。于是准确率随档位的变化,只能归因于"历史变长",排除了题目难度混杂。这个"题目固定、只变长度"的设计,是 VoxMem 相对旧基准最关键的改进之一:过去很多长上下文测试在不同长度用不同题,掉分到底是"记不住长历史"还是"题变难了"根本说不清;VoxMem 把变量钉死,于是 8K 到 64K 的每一分下滑都能归因于历史变长本身。
数据怎么来、质量怎么控,是这份基准容易被忽略的功夫。每条历史由证据会话、干扰会话、填充会话组成:干扰会话和证据话题相近但取值不同,配合一个只看文本、准确率仅 51%~56% 的分类器验证,确保模型没法靠表面话题匹配找到答案。语音用 TTS 合成——每位用户固定音色、用风格控制注入语气、以 10dB 信噪比混入环境声,而且用户侧和助手侧文本都不提及说话人、语气或背景声,防止答案从文字泄漏;每个带线索的轮次还保留一份"去线索"配对版用于质检。最终的转录消融显示:在 audio-native 题目上,纯文本基线准确率从 46.2% 掉到 4.4%——换句话说,这些题"光看字"基本答不上来,必须听音频。
五、15 个模型实测:记词可以,记人记声崩了
VoxMem 在 15 个 LALM 上做了系统评测,覆盖 audio-specialist 开源、omni-modal 开源和专有 API(如 Qwen3.8-Omni-Flash、Gemini-3.1-Pro、Gemini-3.8-Flash 等)。所有模型都通过原生音频接口接收用户轮次,不给水转写、不给 ASR 前端——逼着模型真的去"听"。
结论很扎心:32K 上下文下,没有任何一个模型整体准确率超过 40%,最强的是 Qwen3.8-Omni-Flash,也只到 38.5%;闭源模型平均 33.0%,开源平均 21.9%。
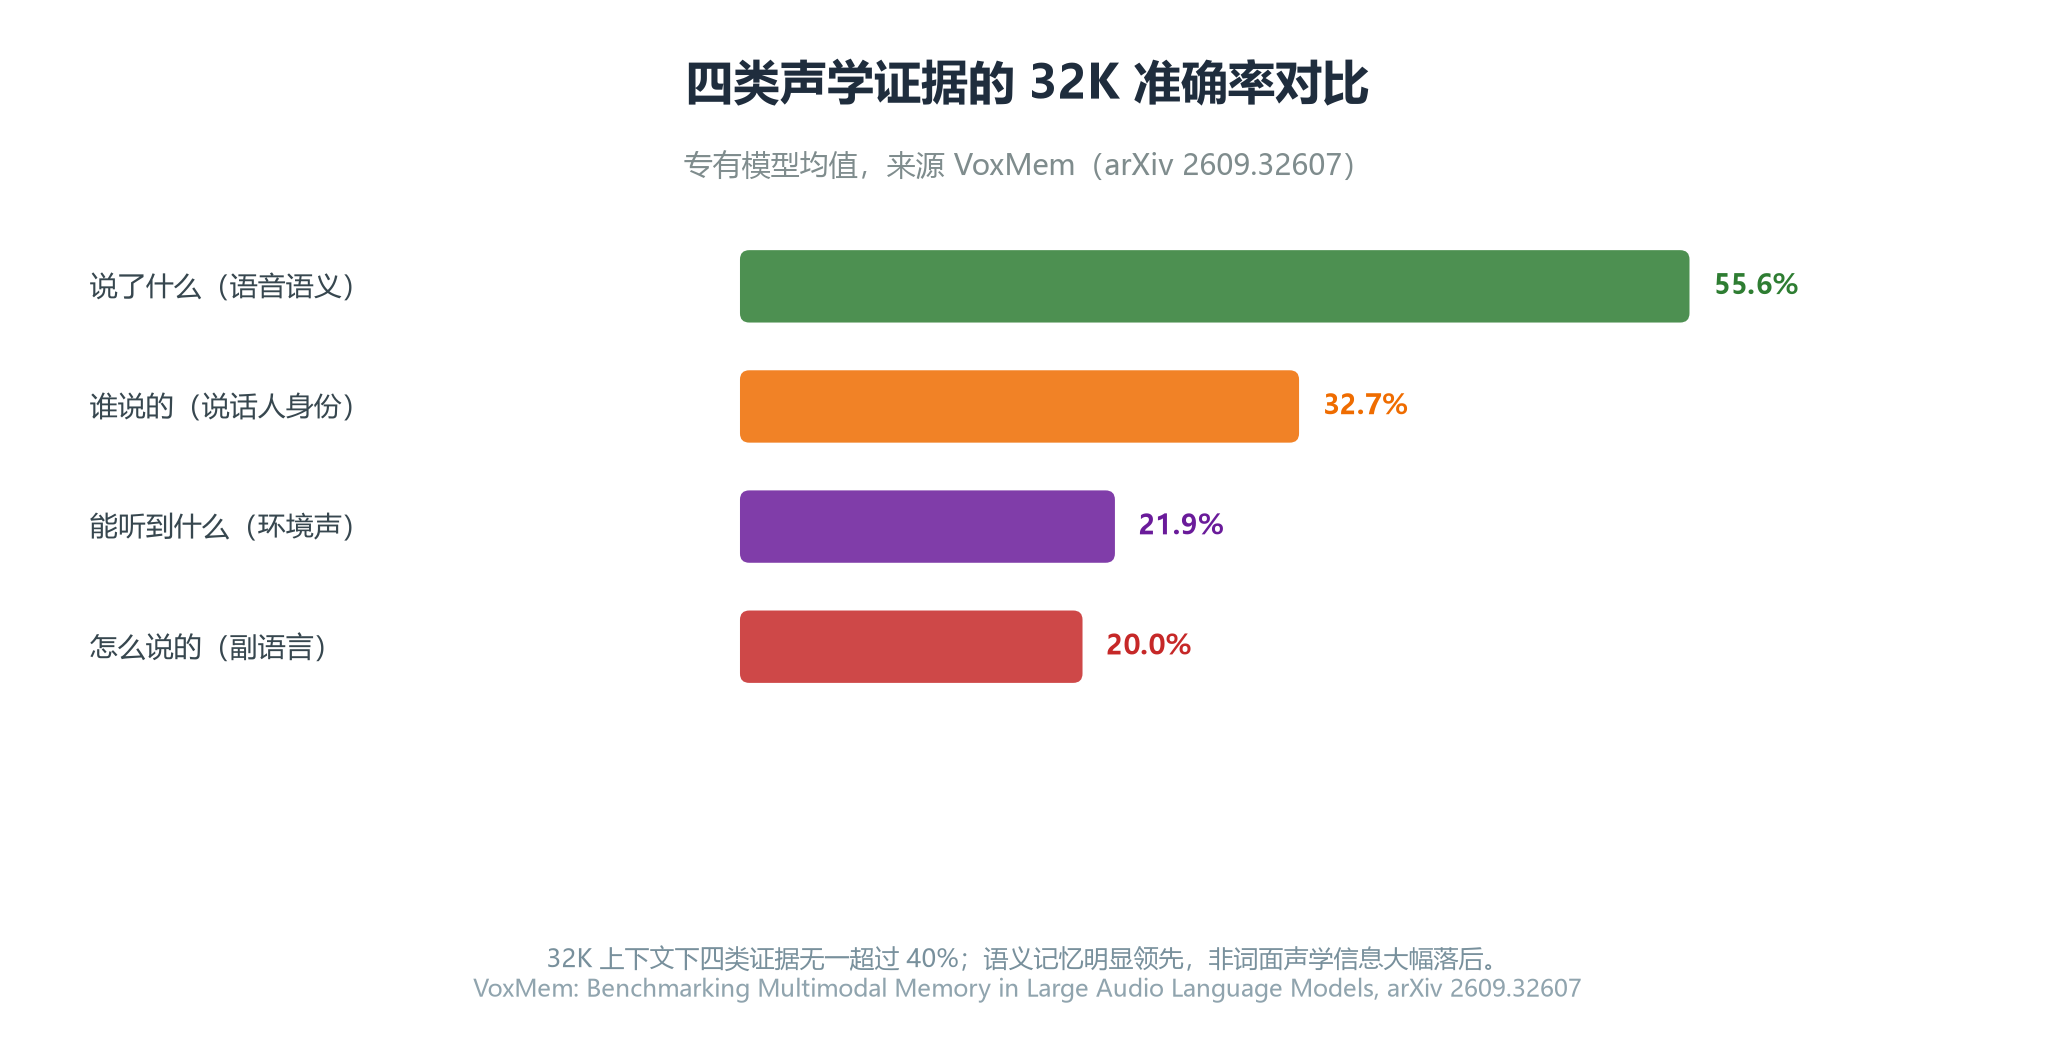
按证据类型拆开看,差距更刺眼(32K 下专有模型均值):
| 说了什么(语音语义) | 55.6% | 词面信息,转写就能拿 |
| 谁说的(说话人身份) | 32.7% | 声纹绑定的答案 |
| 怎么说的(副语言) | 20.0% | 语气、语速、情绪 |
| 能听到什么(环境声) | 21.9% | 背景里的声音 |
(图一:四类声学证据的 32K 准确率对比,来源 VoxMem 论文)
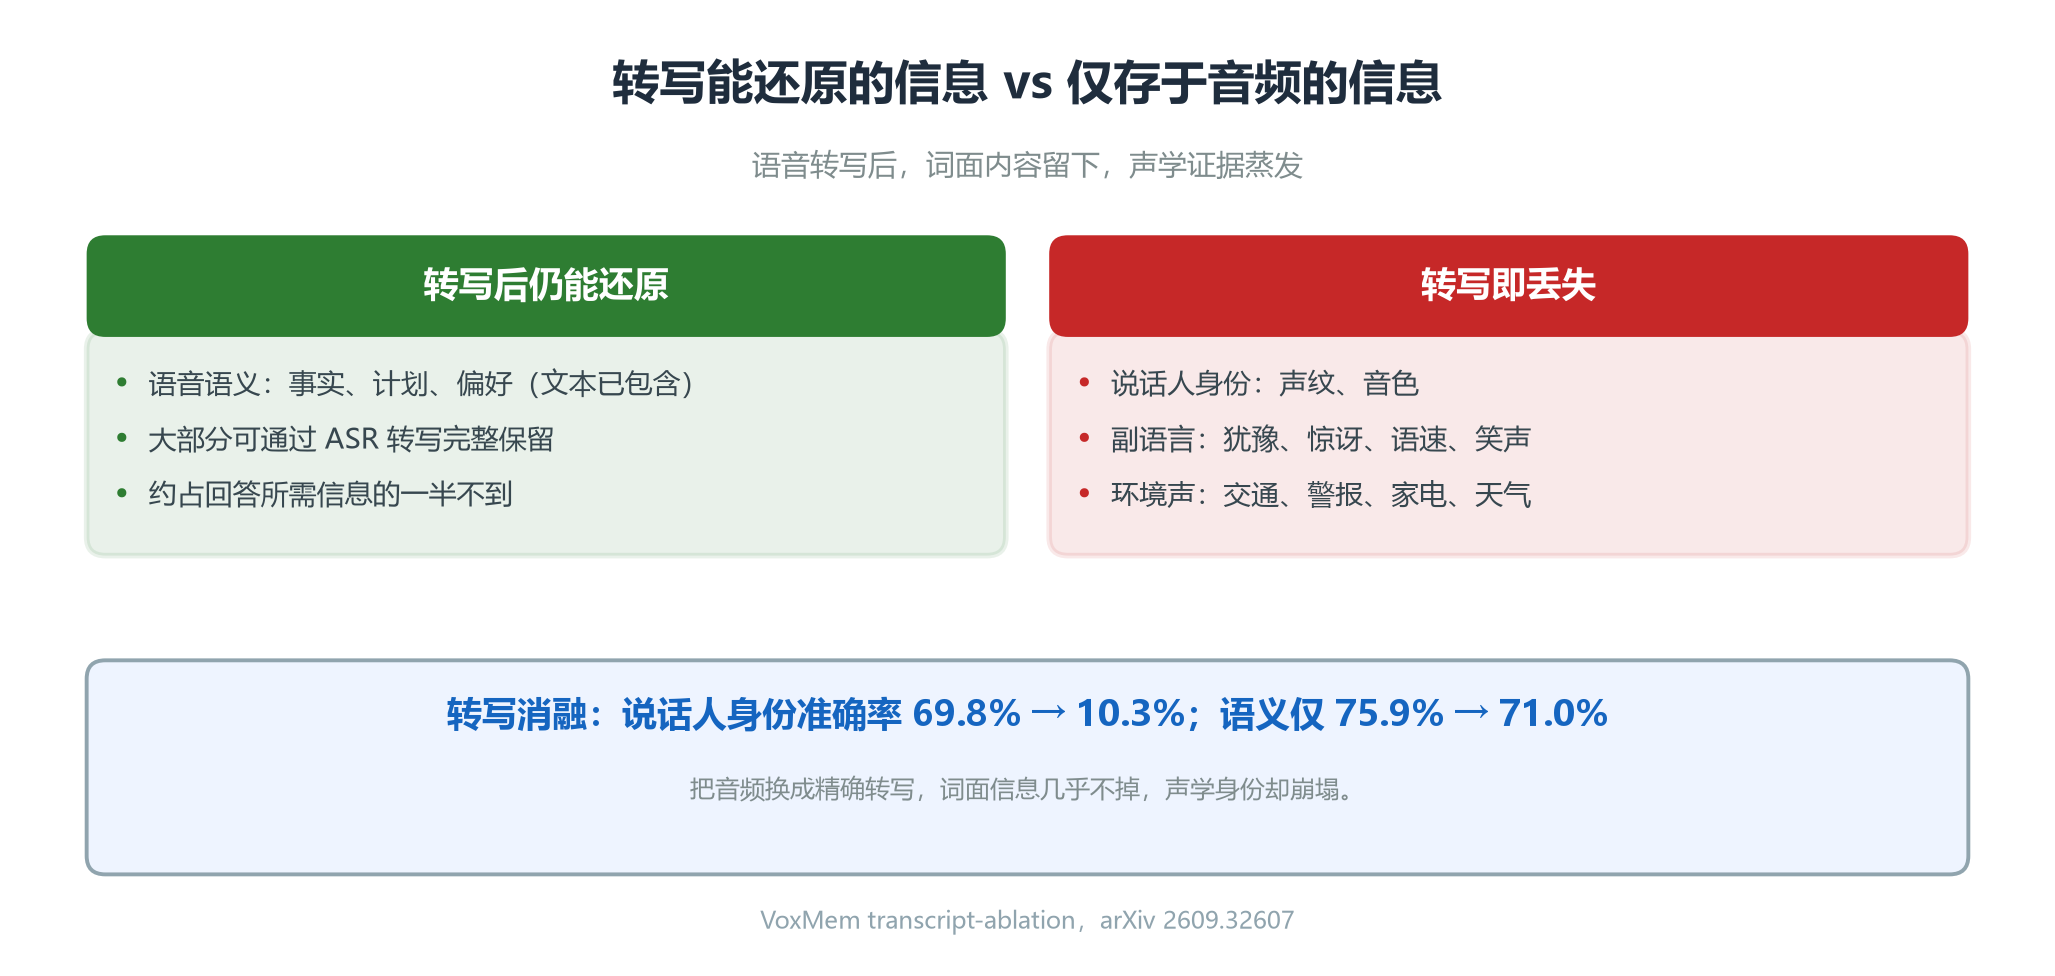
一个很能说明问题的对照是转写消融:把音频换成精确转写后,说话人身份准确率从 69.8% 暴跌到 10.3%,而语义准确率只从 75.9% 微降到 71.0%。这说明"转写优先"的架构能兜住内容记忆,却几乎兜不住身份记忆——声学身份随转写一起蒸发了。
(图二:转写能还原的信息 vs 仅存于音频、转写即丢失的信息)
再看"记状态"这件事,崩得更彻底。时序追踪(TET)在语义上还有 44.5%,但到了副语言状态变化只剩 3.4%、环境声状态变化仅 1.2%——模型基本追不动"语气是怎么变的"“背景声是什么时候出现的”。
分模型看,表现最好的是 Qwen3.8-Omni-Flash(38.5%),闭源平均 33.0%、开源平均 21.9%——开源与闭源在"非词面声学记忆"上的差距,比在纯语义任务上更夸张。论文还指出,不同证据类型的失败模式是"质"的不同,而非同一瓶颈的轻重之分:说话人记忆卡在跨会话关联,副语言和环境声更多卡在"压根没取到线索"。这意味着单纯加强文本推理救不了后两者。
对产品团队来说,这个分数板的读法很直接:如果你的语音助手今天靠"转写+检索"干活,它在"谁说的"上大概率不到三成准——家庭多用户、会议纪要这类场景,先别指望它分清发言主体。
错误模式也不是均匀分布的,这点对工程排查特别有用:
- 说话人任务 48% 是绑定失败(binding failure):模型取对了事实,却把它安错了人——记忆和主人没绑上。
- 副语言任务 63% 是定位失败(localization failure):关键的声学线索压根没被取到,连推理的原材料都没有。
- 环境声错误则分裂为定位失败(41%)和"硬答"(39%)两类。
有意思的是,拒答层和答题层表现不同:模型恰恰在最不擅长用声学证据的地方,更懂得说"信息不够"。这说明"该不该闭嘴"和"能不能答上"是两件事,不能混为一谈。
六、现在就能跑:用 VoxMem 给语音助手做体检
VoxMem 是开源的(代码 MIT 许可,数据集 CC BY-NC 4.0),GitHub 仓库 swagshaw/voxmem 自带数据集拉取脚本,不需要手动下载。想给自己家的语音助手做个体检,有两条路可走。
路径一:官方完整跑分(含专有 API 模型)
# 1) 克隆并装依赖(Python 3.9+)
git clone https://github.com/swagshaw/voxmem
cd voxmem
pip install -r requirements.txt
pip install "datasets" # 可选:自动把音频解码成数组
# 2) 先跑冒烟测试,验证流程通了(abstain 基线必须在拒答题上得 1.0、可答题上得 0.0)
python run_voxmembench.py –config 8k_speaker_information \\
–model abstain –allow-abstention –limit 25 –out predictions_smoke.jsonl
python score_voxmembench.py –predictions predictions_smoke.jsonl –judge exact-match
# 3) 正式跑 32K 子集(以某个音频 API 模型为例)
export OPENAI_API_KEY=你的密钥
python run_voxmembench.py –config 32k \\
–model openai:gpt-4o-audio-preview –allow-abstention \\
–out predictions_32k.jsonl
# 4) 打分(judge 可用 openai:gpt-4o-mini)
python score_voxmembench.py –predictions predictions_32k.jsonl \\
–judge openai:gpt-4o-mini –out metrics_32k.json
–config 支持按证据类型切片,比如 32k_speaker_information 只跑说话人维度(约 2.8 GB 而非完整 32K 的 15+ GB),机器显存不够时很实用;脚本支持断点续跑,中断不丢进度。
路径二:本地开源模型 / 无 API 也能体验
没有专有 API 额度时,用 –adapter 接本地权重即可:
python run_voxmembench.py –config 8k_paralinguistic_information \\
–model 你的本地模型名 –adapter your_adapter.py \\
–model-dir /path/to/weights –allow-abstention \\
–out pred_local.jsonl
更轻量的替代:直接拿论文里的"转写消融"思路做个对照实验——把同一段历史分别喂给"音频模型"和"先 ASR 转写再喂文本模型",看副语言、说话人维度的差距。这不需要跑完整基准,就能直观感受"转写优先"架构丢了多少信息。
跑完别只看总分。VoxMem 的评分按证据类型和记忆操作分层,重点看三个数:说话人维度的准确率(绑人能力)、副语言与环境声维度(听声能力)、以及拒答层的精确率(该闭嘴时有没有闭嘴)。总分高但拒答层乱答,比总分低更危险——它意味着模型在没听清的时候还在硬编。
七、冷静视角:这把尺子量得准,也有边界
VoxMem 的价值不用夸大也站得住:它第一次把"音频记忆"按证据类型和记忆操作拆开,让失败有了可定位的坐标。但对研究和选型来说,有几处边界要先看清楚。
- 语音是 TTS 合成的。每位用户固定音色、统一风格控制、10dB 信噪比混环境声,和真实世界的说话人差异、嘈杂现场仍有距离。真实场景的声学复杂度可能让某些失败更明显,也可能让另一些被合成数据掩盖。
- 只评了 15 个模型。结论适用于当前这一代 LALM,不能自动外推到更新或架构不同的系统。
- 数据是非商业许可(CC BY-NC 4.0)。做学术和内部评测没问题,要把评测集嵌进商用产品前,需要自查授权条件。
- "更长上下文"不是解药。VoxMem 和另一份同期基准 Vox-Infinity(沿轮数/轮长拉长、发现明显的"近因效应")互相印证:把历史塞进更大窗口,不等于能在需要时取回并正确使用。VoxMem 自己的数据也显示,历史变长时各证据类型的可用度都在下滑,而且速率不同。
落到工程上,最实在的启示是:一个"先转写、后记忆"的语音助手,能兜住"说了什么",却几乎兜不住"谁说的、怎么说的、现场有什么"。要做长期多会话的语音产品,需要的是可被检索地保留说话人、韵律、环境证据,再加上专门的跨会话推理机制和"证据不足就拒答"的不确定性感知——光把上下文窗口拉大,补不上这个洞。
对架构选型还有一个具体提醒:如果你今天用"ASR + 文本模型 + 向量检索"搭语音助手,VoxMem 的结果等于提前告诉你——这套链路对"说了什么"够用,对"谁说的、怎么说的"基本失明。要么在转写之外额外保留并索引说话人声纹、韵律特征和环境标签,要么干脆让音频模型原生参与记忆检索。两条路都不便宜,但这是把语音助手从"听得懂一句话"推向"记得住一段关系"必须过的坎。
总结
VoxMem 用"声学证据类型 × 记忆操作"的二维框架,把音频大模型的记忆能力拆成了 15 种可定位的考察,第一次系统证明:模型记得住"说了什么",却严重记不住"谁说的、怎么说的、现场有什么声音",而且历史越长差距越大。对做语音助手、家庭多用户助理和客服机器人的团队,它是目前最贴近真实体验的一把体检尺——开源、可直接复现,也给出了清晰的失败坐标。下一步值得盯的是:在"保留非词面声学信息并维持其跨会话关联"这件事上,今年会有哪些架构真正把 40% 的天花板顶破。