Linux 读写信号量 rwsem 源码解析:读者并发读取与写者独占的公平性调度
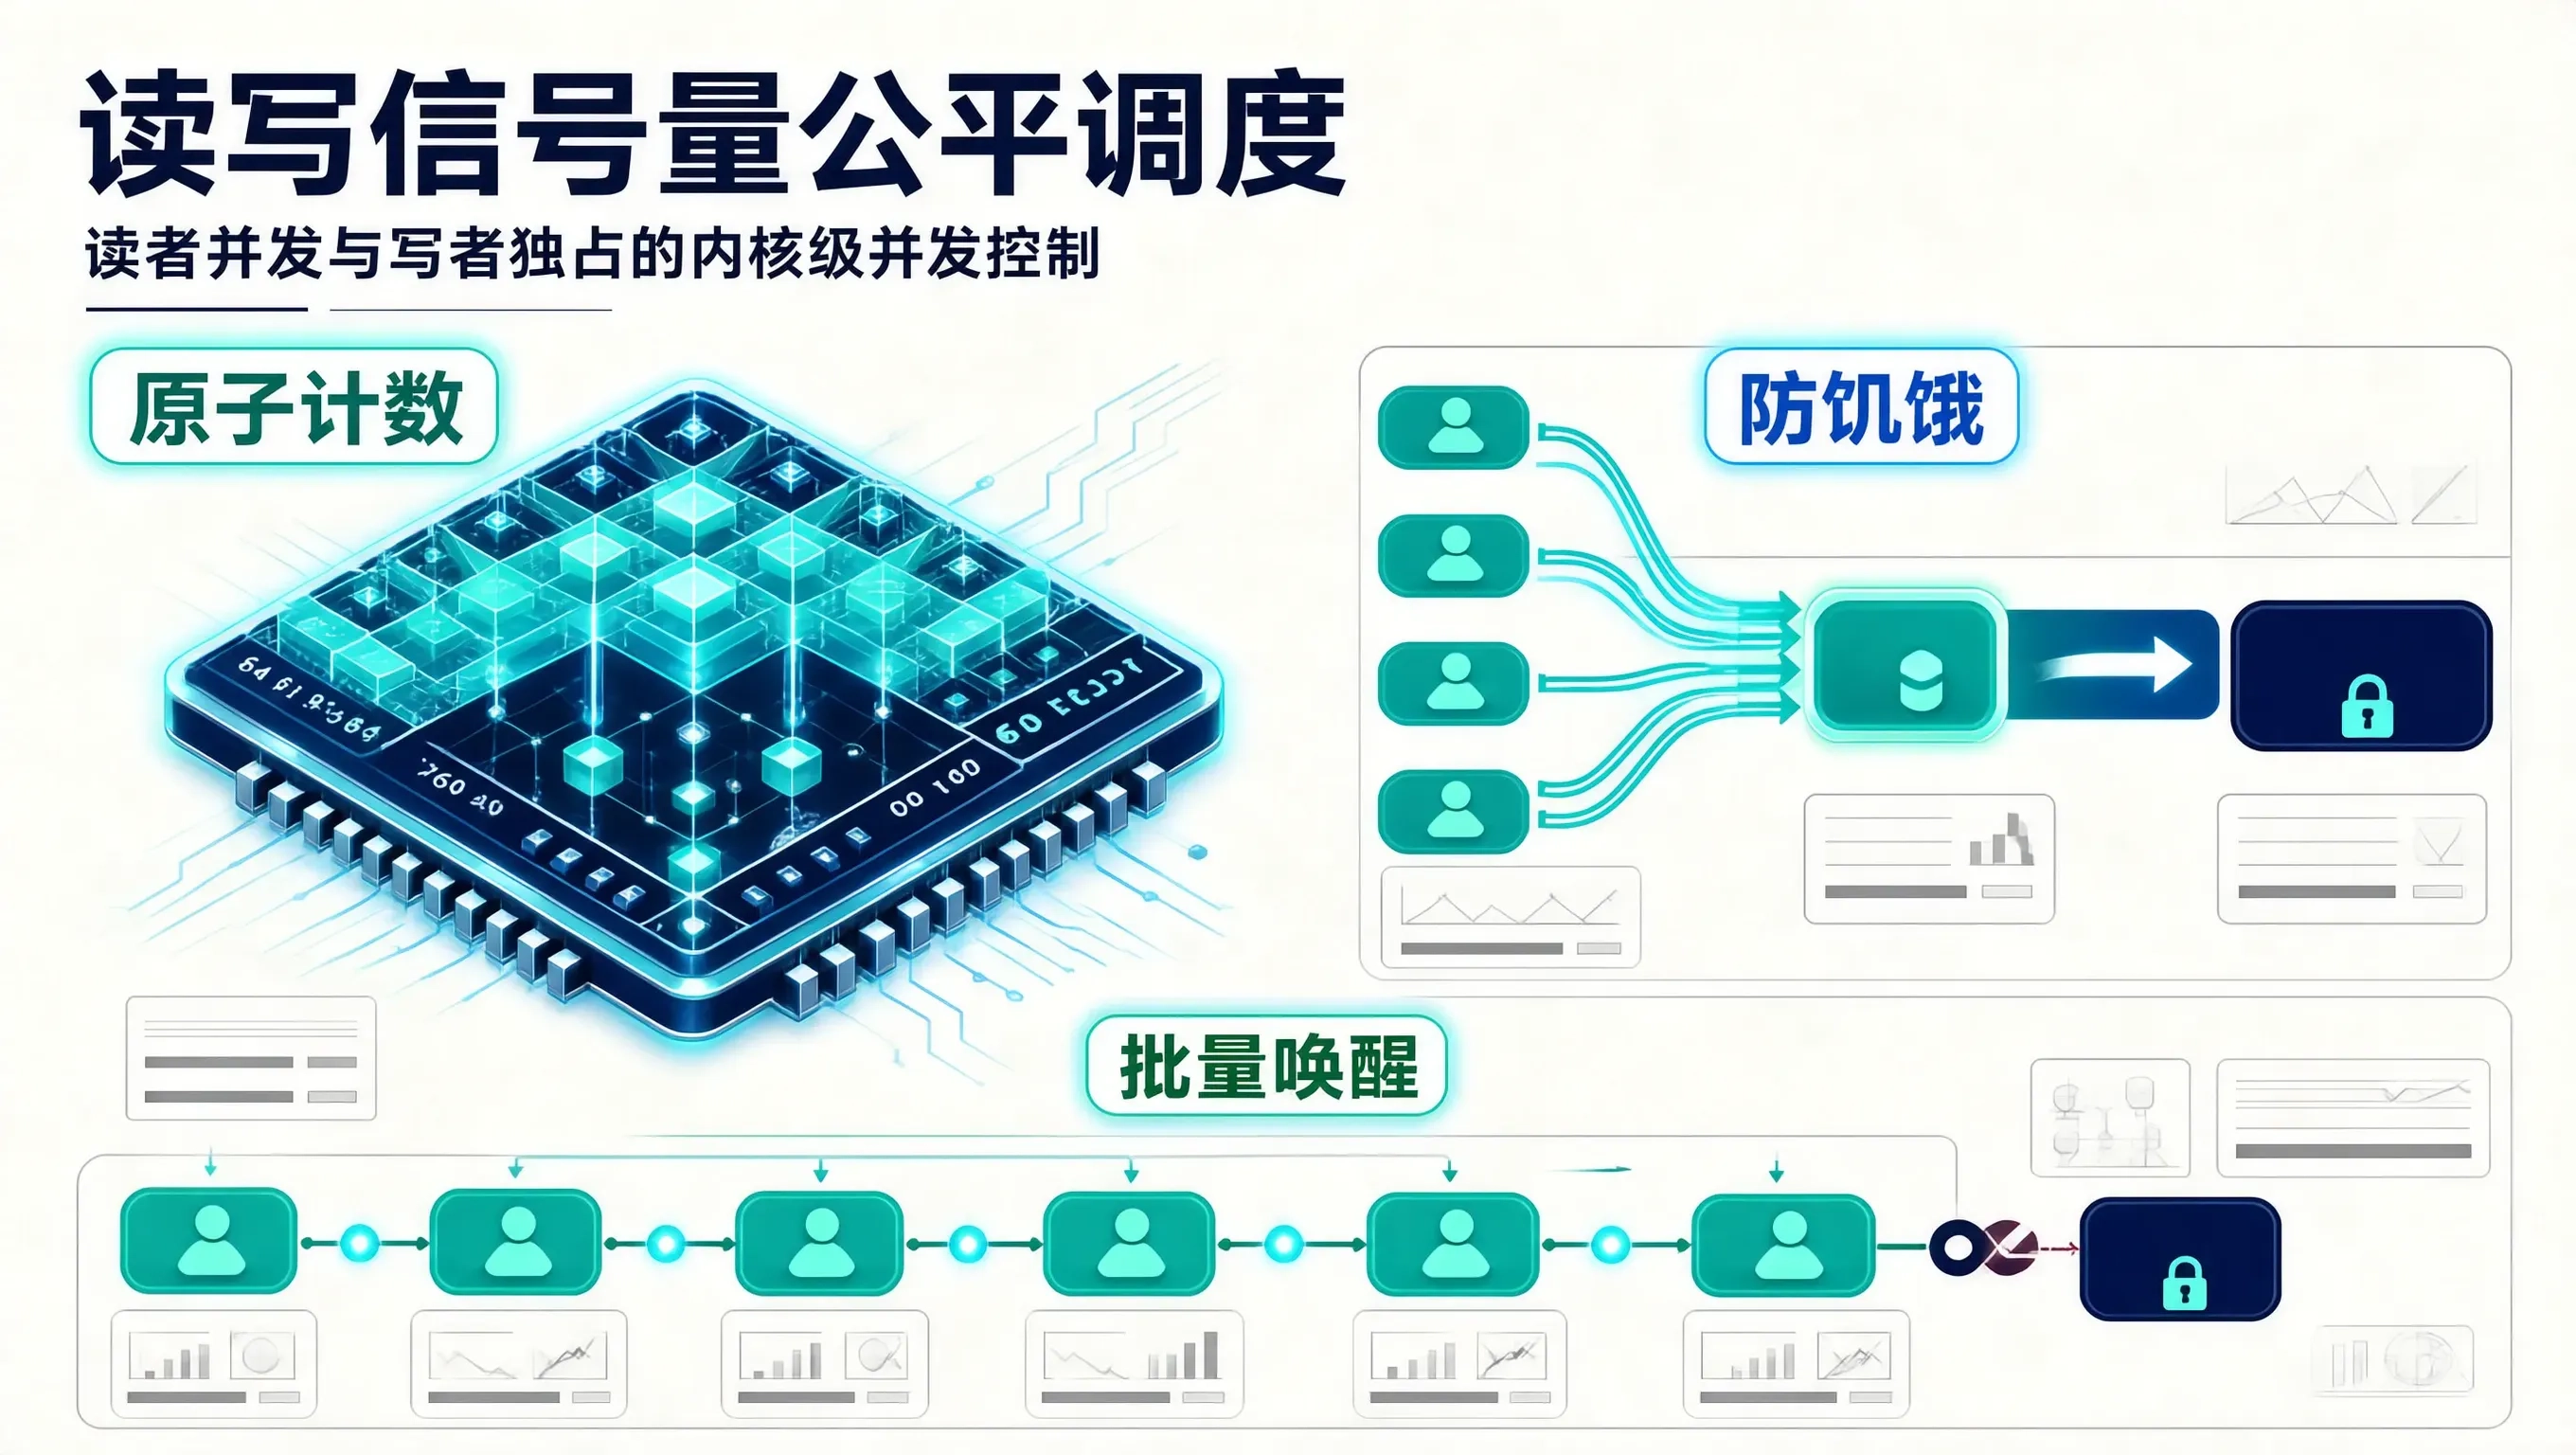
在多核 Linux 系统中,面对“读多写少”的高并发共享数据结构(如进程虚拟地址空间管理结构体 mm_struct->mmap_lock、VFS 目录树缓存等),互斥锁(Mutex)会导致所有只读操作串行化,形成严重的性能瓶颈。
为了支持多个读者并发读取、同时保证写者的独占互斥,Linux 内核提供了读写信号量(Reader/Writer Semaphore,简称 rwsem)。
但传统的读写锁设计极易引发**“写者饥饿(Writer Starvation)”**——如果源源不断的读者持续发起读锁请求,写者可能被无限期阻塞挂起。现代 Linux 内核(Linux 5.x/6.x)在 struct rw_semaphore 中实现了一套极其精妙的基于原子计数与排队队列的公平性调度机制。
一、struct rw_semaphore 核心数据结构与原子计数编码
内核中 include/linux/rwsem.h 的核心结构体定义如下:
struct rw_semaphore {
atomic_long_t count; /* 复合原子状态计数器 */
atomic_long_t owner; /* 写者持有时指向写者 task_struct */
#ifdef CONFIG_RWSEM_SPIN_ON_OWNER
struct optimistic_spin_queue osq; /* MCS 乐观自旋锁队列 */
#endif
raw_spinlock_t wait_lock; /* 保护等待队列 wait_list 的自旋锁 */
struct list_head wait_list; /* 等待唤醒的读者/写者链表 */
#ifdef CONFIG_DEBUG_RWSEMAPHORE
void *magic;
#endif
};
count 字段(atomic_long_t)是整套机制的灵魂,它在 64 位体系下的位域布局如下:
63 8 7 6 5 4 3 2 1 0
+———————————————+—+—+—+—+—+—+—+—+
| Reader Count (当前并发读者计数值) | H | W | Reserved | L | W |
+———————————————+—+—+—+—+—+—+—+—+
│ │ │ │
│ │ │ └── RWSEM_WRITER_LOCKED (0x1)
│ │ └────── RWSEM_WRITER_LOCKED
│ └───────────────────────── RWSEM_FLAG_WAITERS (0x200)
└───────────────────────────── RWSEM_FLAG_HANDOFF (0x400)
- Bit 0 (RWSEM_WRITER_LOCKED = 1):表示当前有写者持有了该锁。
- Bit 8 (RWSEM_READER_BIAS = 0x100):读者计数的基本步长,每次 down_read 成功,count 便原子增加 0x100。高位累加即代表读者总数。
- Bit 9 (RWSEM_FLAG_WAITERS = 0x200):等待队列中有正在排队的任务(读者或写者)。
- Bit 10 (RWSEM_FLAG_HANDOFF = 0x400):开启顶端写者/读者强制移交,防止饥饿。
二、读锁与写锁路径源码剖析
1. 读者快速加锁路径(down_read)
/* kernel/locking/rwsem.c */
static inline bool __down_read_fastpath(struct rw_semaphore *sem)
{
/* 尝试直接原子累加读者步长 RWSEM_READER_BIAS (0x100) */
if (atomic_long_add_return_acquire(RWSEM_READER_BIAS, &sem->count) > 0)
return true;
return false;
}
如果在加锁前,count 没有写者锁定标志(Bit 0 为 0)且没有设置 WAITERS 标志,原子加法后结果必然大于 0,读者瞬间拿到锁,无需任何额外开销;若返回负值或包含等待标记,说明有写者持锁或有等待者,进入慢速路径 rwsem_down_read_slowpath。
2. 写者快速加锁路径(down_write)
static inline bool __down_write_fastpath(struct rw_semaphore *sem)
{
/* 仅当 count 严格为 0 (既无读者也无写者且无等待者) 时,CAS 设置为 RWSEM_WRITER_LOCKED */
if (atomic_long_cmpxchg_acquire(&sem->count, 0UL, RWSEM_WRITER_LOCKED) == 0UL) {
atomic_long_set(&sem->owner, (long)current);
return true;
}
return false;
}
写者要求必须在“绝对空闲”状态下才能命中 Fastpath。
三、公平性调度与防写者饥饿(Anti-Starvation)机制
传统读写锁最致命的缺陷是写者饥饿。Linux 内核是如何做到公平调度的?
时间轴演进:
[读者 A 持锁读取]
│
▼
[写者 B 尝试加锁] ──> 失败,进入等待队列,设置 count |= RWSEM_FLAG_WAITERS
│
▼
[读者 C 到达] ────> 发现 count 包含 WAITERS 标志!
尽管读者 A 仍在读取,读者 C 仍然【被禁止插队】,必须挂入等待队列
│
▼
[读者 A 释放 (up_read)] ──> 唤醒队首写者 B ──> 写者 B 获得独占权执行
核心调度防饥饿逻辑
四、读者批量唤醒(rwsem_wake)
当写者完成操作调用 up_write 释放锁时,唤醒逻辑展现出极高的并发吞吐设计:
static void rwsem_wake(struct rw_semaphore *sem)
{
struct rwsem_waiter *waiter;
raw_spin_lock_irqsave(&sem->wait_lock, flags);
waiter = list_first_entry_or_null(&sem->wait_list, struct rwsem_waiter, list);
if (waiter->type == RWSEM_WAITING_FOR_WRITE) {
/* 如果队首是写者,仅唤醒单体写者 */
wake_up_process(waiter->task);
} else {
/* 如果队首是读者,级联连续唤醒所有紧随其后的读者! */
list_for_each_entry_safe(waiter, next, &sem->wait_list, list) {
if (waiter->type == RWSEM_WAITING_FOR_WRITE)
break; // 遇到写者截断,保持公平顺序
wake_up_process(waiter->task);
}
}
raw_spin_unlock_irqrestore(&sem->wait_lock, flags);
}
等待队列拓扑:
[Head] ──> [读者 1] ──> [读者 2] ──> [读者 3] ──> [写者 1] ──> [读者 4]
└────── 批量唤醒 ──────┘ │
写者阻断点 (停止唤醒)
五、性能特征与工程选型建议
| struct mutex | 读写频率均等、独占互斥 | 无 (单线程) | 低 | 否 (不可在中断中使用) |
| rw_semaphore | 读远多于写、临界区较长 (可睡眠) | 极高 (并发共享) | 中等 (需排队等待读者清零) | 否 (可睡眠锁) |
| rwlock_t (自旋锁版) | 读多写少、临界区极短 (纳秒级) | 高 (自旋) | 高 (自旋消耗 CPU) | 是 (中断安全) |
| RCU (Read-Copy-Update) | 极致只读 (读写比 > 100:1) | 零锁开销 | 较高 (需等待宽限期) | 是 (无锁免睡眠) |
在内核模块或驱动开发中,如果共享数据结构需要支持并发读且临界区内可能涉及内存分配(kmalloc)、I/O 交互等可能导致睡眠的操作,rw_semaphore 是兼具高吞吐与公平性的最佳选择。