01 什么是 AI Agent?跟普通 LLM 应用的本质区别?
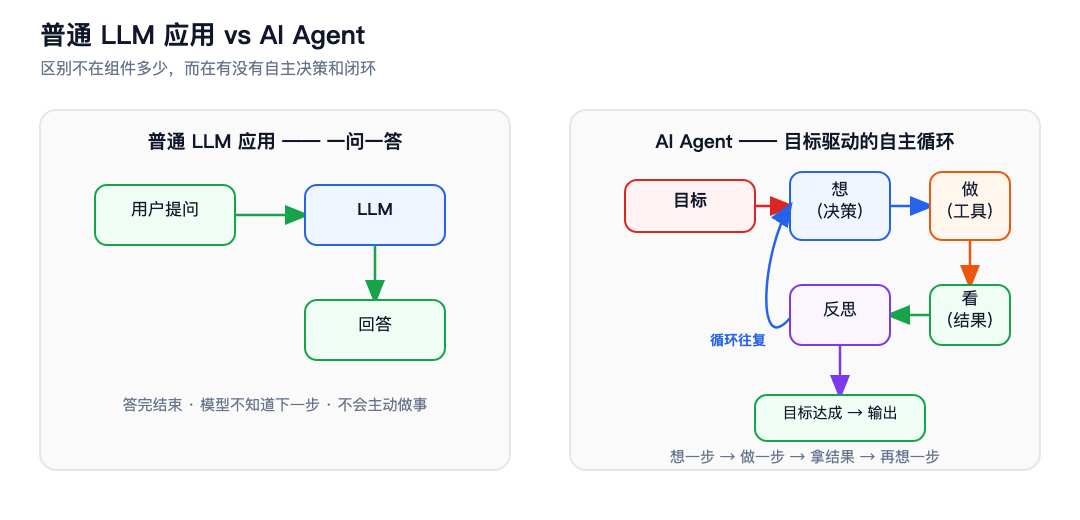
两者本质区别,一张表分清:
| 交互模式 | 单轮映射:问 → 答 | 目标驱动的循环:想 → 做 → 看 → 再想 |
| 决策权 | 用户决定每一步 | Agent 自主决定下一步 |
| 与外部世界交互 | 无 | 调工具、查数据、执行操作 |
| 终止条件 | 生成完就结束 | 目标达成 / 达到上限 / 人工终止 |
| 典型例子 | 翻译、摘要、问答 | 工单诊断、自动化运维、深度调研 |
普通应用答完就结束;Agent 拿到目标自己拆任务、自己决定下一步是思考还是调工具,循环到目标达成——关键三个词:自主决策、目标驱动、循环闭环。
为什么 Agent 天然是循环结构?这要追到模型的生成机制:
用户:“帮我查订单 12345 的物流,有延迟就通知客户”
↓ 想:需要先查订单
↓ 做:query_order(“12345”)
↓ 看:已发货,但物流显示"派送延迟"
↓ 想:有延迟,需要发邮件
↓ 做:send_email(客户邮箱, “您的订单延迟”)
↓ 看:发送成功
↓ 答:“订单存在延迟,已通知客户”
LLM 是自回归模型,每次只生成一个 token,看不到全局,没法一次性规划完整方案再执行,只能"想一步 → 做一步 → 拿结果 → 再想一步"。Agent 的循环不是设计出来的,是模型生成机制决定的。
高频追问:“Agent 会越用越聪明、自我进化吗?”
不会自我训练——你用的 LLM 权重是冻结的,除非重新训练/微调。所谓"变聪明",是另外三个层面在积累:
▪ 记忆:用户偏好、历史结论沉淀下来
▪ 工具:修 bug、加参数、改描述,越用越顺
▪ 流程:prompt 调优、反思逻辑迭代
一句话:模型权重 ❌,记忆、工具、流程 ✅。
能把"行为层面进化 ≠ 权重训练"讲清,反而加分。
总结:Agent 和普通 LLM 应用的区别不在组件多少,而在有没有自主决策和闭环。Agent 的循环是被自回归生成机制逼出来的。
02 什么时候用 Workflow、单 Agent、多 Agent?
别背定义,先看三个例子,各干各的活。
例子一:退款进度查询——Workflow
用户问"我的退款到哪了",系统的活永远是三步:
检索订单和退款记录 → 拼进回复模板 → LLM 生成回复
问一百个用户,走的都是这条路:步骤固定、没有分支,模型只在"生成"这一步出场,连"要不要再查一次"都轮不到它决定。路径能预先写死的任务,代码直接编排,这就是 Workflow——可控、便宜、稳定。
例子二:线上工单诊断——单 Agent
用户报"App 更新后闪退",下一步查什么,取决于上一步查到了什么:
查崩溃日志 → 发现是 OOM → 下一步查内存配置、查最近上线的代码
→ 发现是网络超时 → 下一步查接口耗时、查网关配置
→ 什么都没查到 → 下一步让用户录屏、问机型和系统版本
分支由中间结果决定:越查越知道下一步查什么,查到什么时候算够也只有现场才能判断。写代码时你根本不知道这个工单是 OOM 还是超时——路径没法枚举,决定权只能交给模型自己。
注意"单"不是只做一步:它照样"想→做→看→再想",可以调十次工具跑二十轮。"单"指的是只有一个决策中心——循环里只有一个 LLM 在拿主意。
例子三:代码生成 + 审核——多 Agent
一个 Agent 写排序函数,写完交给另一个审核 Agent。关键在审核者不重读代码干想,而是把代码丢进沙箱跑单元测试:
生成 Agent 写代码 → 审核 Agent 跑测试 → 报"边界条件挂了"
→ 失败信息拿回去改 → 再跑,直到全绿
"边界条件挂了"这个执行结果,是写代码时不存在的新信息——单个 Agent 重读自己的输出永远拿不到它。新信息进来了,分工才有意义。
三个例子摆完,差别就清楚了:
| 流程 | 预先定义的固定步骤 | LLM 自主决定下一步 | 多个 Agent 分工协作 |
| 可控性 | 高,可预测 | 中,可能跑偏 | 低,需要协调机制 |
| 成本/延迟 | 低 | 中 | 高 |
| 适用场景 | 步骤明确、路径固定 | 步骤不确定、需灵活决策 | 单 Agent 信息/能力不够 |
| 例子 | RAG 流程、工单分流 | 工单诊断、深度调研 | 生成 + 审核分离、多视角评审 |
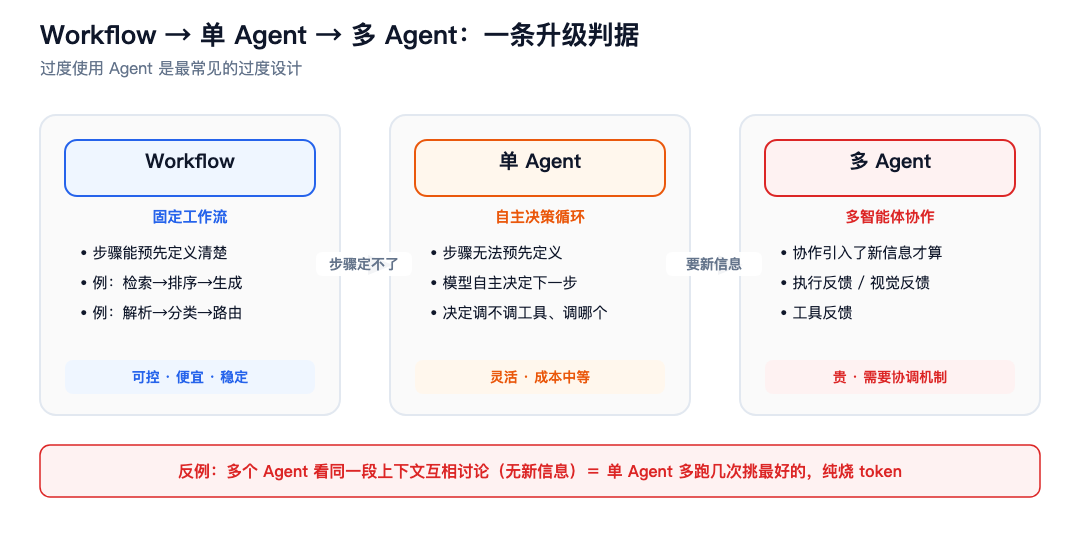
选型就看两条:路径写得死用 Workflow,写不死才上单 Agent;要不要拆多 Agent,看拆完能不能多出新信息。
面试最容易在这步翻车:为了多 Agent 而多 Agent。拆之前先问自己三个问题,都答"是",拆才有意义:
一,有没有新信息? 新信息不是第二个模型变聪明了,是审核者干活带回来的:跑测试拿到报错、截图看到渲染崩了、调工具查出事实对不上。
二,为什么不自己审自己? 单 Agent 自审容易自我确认:上下文里还留着刚才写作时的思路,重读自己的输出,看什么都像对的,人查自己的作文也是这毛病。
三,光换个角色够吗? 不够。几个 Agent 围着同一段文本互相挑毛病,跟单 Agent 多跑几次挑最好的打平,纯烧 token。
视角拆干净、验证靠执行,两件事凑齐,多 Agent 才站得住。
真被追问"单 Agent 自己跑测试行不行?“——行,那等于把验证动作内化进一个循环,判据还是那条"有没有新信息”,跟几个 Agent 无关。多 Agent 只是把"干净视角 + 执行验证"制度化的常见结构,不是唯一做法。
多 Agent 常见三种搭法:对等协作互相挑刺,管理者模式拆活派活(多数业务够用),去中心化走消息总线 + 共享状态(大规模并行才用得上)。
总结:步骤可预定义用 Workflow,需要自主决策上单 Agent,协作能拿到新信息才上多 Agent。没有新信息的多 Agent 辩论,等于烧钱。
03 ReAct、CoT、Plan-and-Execute、Self-Refine 怎么选?
四个范式先看全景对比:
| CoT | 纯推理:想→想→想→答 | ❌ / ❌ | 答案就在眼前:数学、阅读理解、代码审查 |
| ReAct | 推理+行动交替:想→做→看→想 | ✅ / ✅ | 需要外部实时数据的探索任务 |
| Plan-and-Execute | 先列完整计划再逐步执行 | 可选 / ❌ | 任务可分解、步骤相对明确 |
| Self-Refine | 做→自审→改→再审 | 可选 / ✅ | 需要高质量输出 |
CoT 是地基,不调工具、不碰外部世界,答案在眼前就够用。比如这道题:
用户:“笼子里共 35 个头、94 只脚,鸡兔各几只?”
↓ 想:设鸡 x 只,兔就是 35-x 只
↓ 想:鸡 2 只脚、兔 4 只脚,列式 2x + 4(35-x) = 94
↓ 想:解得 x = 23
↓ 答:“鸡 23 只,兔 12 只”
题干里的条件就够推出答案,全程没碰外部世界一下。中间每一步"想"都显式写出来——思维链的"链"就是这么回事。
ReAct 给 CoT 加上"手"。为什么必须加?Agent 要查 DB、查日志、调 API,这些都是模型肚子里没有的实时数据,不伸手就只能瞎编(幻觉)。比如:
用户:“明天去杭州出差,需要带伞吗?”
↓ 想:杭州明天的天气模型不知道,得先查
↓ 做:get_weather(“杭州”, “明天”)
↓ 看:小雨,15~20℃
↓ 想:有雨,提醒带伞
↓ 答:“明天杭州有小雨,记得带伞,15~20℃”
和上面对比:CoT 全程只有"想",ReAct 多了"做"和"看"——"看"这一步拿到的,就是模型自己给不出的实时数据。
代价也有:容易死循环、token 越滚越大、一步错带偏全局。好在每个缺点都有工程解法,第 06 题专门讲怎么容错、怎么防跑飞。
Plan-and-Execute 治 ReAct 的短视。比如"写季度经营报告":ReAct 边查边写,查完数据容易急着下结论,单步看着都合理,整体漏了"对比上季"。先让 Planner 想全局、列清单,再逐个执行:
ReAct(边想边做):
想 → 做 → 看 → 想 → 做 → 看 → … 灵活,但容易在局部打转
Plan-and-Execute(先想全局):
① Planner: 拆成子任务清单 [查数据, 对比上季, 分析原因, 出图表, 写总结]
② Executor: 逐个执行
③ (可选) Re-planner: 执行中根据结果修正剩余计划
③ 是保险丝:执行中发现计划不对(比如某个数据源根本拿不到数),当场修正剩余清单,不用推倒重来。
Self-Refine 换了个战场:ReAct 的循环在执行层——调工具、看结果、再调;Self-Refine 的循环在评审层——做出来、审、改、再审。报告写完自己挑毛病:口径对不对、结论有没有证据撑着,挑出来就修。它就是 Reflection 机制的具体实现。
实际项目怎么用?混合:
用户大任务
→ Plan-and-Execute 拆成子任务清单
→ 每个子任务用 ReAct 灵活执行(调工具、看结果、调整)
→ 最终输出过一遍 Self-Refine(自审 → 修正 → 定稿)
纯 Plan 太死板,纯 ReAct 太短视。用词坑:CoT 别叫"闭环",它是单次顺序推理,真正的闭环是 ReAct。
总结:CoT 管"想",ReAct 加上"做",Plan-and-Execute 先想全局,Self-Refine 做完再审。生产环境混着用:Plan 拆解、ReAct 执行、Refine 把关。
04 Function Calling 的完整流程?
先焊死一条铁律:模型只做决策,不执行。
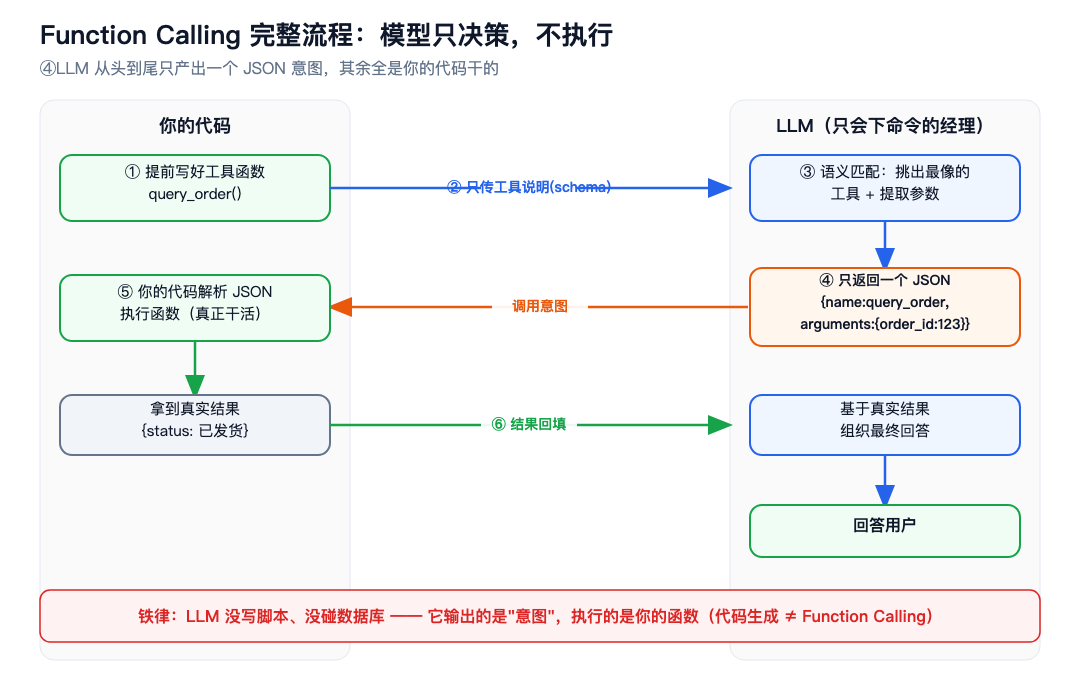
完整流程 6 步,用代码走一遍:
1. 你提前写好的工具函数(你写的,不是 LLM 写的)
def query_order(order_id: str) -> dict:
return db.query(“SELECT * FROM orders WHERE id = ?”, order_id)
2. 告诉 LLM「我有哪些工具」——只传说明文档,不传函数本身
tools = [{
“name”: “query_order”,
“description”: “根据订单号查询订单信息”,
“parameters”: {
“type”: “object”,
“properties”: {“order_id”: {“type”: “string”, “description”: “订单号,如 12345”}},
“required”: [“order_id”],
},
}]
3. 用户问题 + 工具说明发给 LLM
response = llm.chat(messages=[{“role”: “user”, “content”: “帮我查订单 12345”}], tools=tools)
4. LLM 返回的不是结果,是一个 JSON——“我想调 query_order,参数 123”
它做的只是语义匹配:用户说"查订单",和 description 最接近的就是 query_order
{“name”: “query_order”, “arguments”: {“order_id”: “123”}}
5. 你的代码根据 JSON 调用第 1 步的函数
if response.tool_call.name == “query_order”:
result = query_order(**response.tool_call.arguments) # 真正干活的是这里
6. 结果回填给 LLM,让它组织最终回答
llm.chat(messages=[
{“role”: “user”, “content”: “帮我查订单 12345”},
response.assistant_message, # 原样放回,让模型看到自己的决策
{“role”: “tool”, “tool_call_id”: “call_123”, “content”: json.dumps(result)},
])
LLM 从头到尾只产出了第 4 步那个 JSON,没写脚本、没碰数据库。类比:你是老板,提前招好员工(函数);LLM 是只动嘴的经理,写纸条"让查订单的人查单号 123";框架代码是传令员,拿纸条找到员工干活,把结果拿回来。
和"代码生成"的区分:Function Calling 里 LLM 输出的是调用意图(一个 JSON),执行的是你预先写好、注册好的函数;代码生成里 LLM 输出的是一段可运行的代码文本,工具是它现场生成的,由沙箱负责跑。
加分层:Pydantic 参数校验——一次定义,两个用途:
from pydantic import BaseModel, Field
class QueryOrderInput(BaseModel):
order_id: str = Field(description=“订单号,如 12345”)
days: int = Field(default=7, description=“查询最近几天,默认 7”)
用途① 调用前:自动生成 JSON Schema 给 LLM 看(参数怎么填)
用途② LLM 返回参数后:校验,脏参数拦住
QueryOrderInput(order_id=“12345”, days=7) # ✅ 通过
QueryOrderInput(order_id=12345, channel=“小程序”) # ❌ ValidationError,进不了业务函数
注意两个细节:
▪ 校验发生在 LLM 返回参数之后,不是调用之前。链路:定义模型 → 转 schema 给 LLM → LLM 返回参数 → Pydantic 校验 → 通过才进函数。
▪ 校验有两道闸:Pydantic 只管格式(类型、必填、枚举),业务合法性(订单号存不存在、金额是不是负数)在函数内部再校验。
总结:模型选工具 = 把工具描述和用户意图做语义匹配。模型是"决策",不是"执行"——执行的永远是你的代码。
05 MCP 是什么?跟 Function Calling 什么关系?
MCP(Model Context Protocol)是 Anthropic 提出的开放协议,标准化"模型怎么接外部工具和数据源"。类比:MCP 是工具界的 USB-C 接口——以前每个工具都得写定制适配,有了 MCP,工具按协议暴露一次,任何支持 MCP 的 Agent 插上就用。
和 Function Calling 的关系:
| 是什么 | 模型的一种能力 | 工具的一种协议 |
| 解决什么 | 模型怎么表达"我要调哪个工具" | 工具怎么标准化接入 |
| 类比 | 经理会下命令 | 员工统一用 USB-C 接口 |
| 谁定义的 | 各模型厂商的 API | Anthropic 提出的开放标准 |
两者正交,不存在谁封装谁。 模型用 FC 表达调用意图,底层工具走 MCP 还是手写,模型不关心——它看到的就是一堆工具的名字、描述、参数。
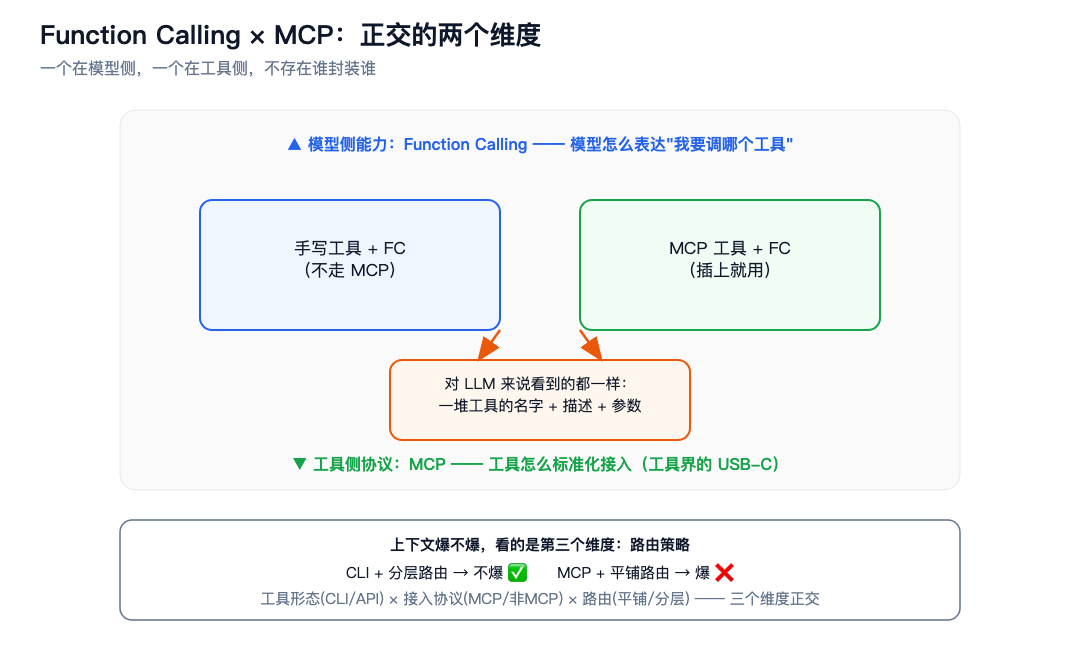
衍生题:工具太多(几十上百个)怎么办? 全塞进上下文会爆炸。先立框架——一个工具体系有三个独立维度,各答各的题:
▪ 工具形态——工具本身长什么样:一条 CLI 命令、一个专用函数(像 04 题的 query_order)、还是一次 HTTP 调用。它管"单个工具怎么实现"
▪ 接入协议——工具怎么暴露给模型:你自己手写注册,还是走 MCP 标准。它管"工具怎么复用"——走 MCP 写一次,任何支持 MCP 的 Agent 插上就用;手写注册,换个框架就得重接一遍
▪ 路由策略——几十上百个工具怎么组织给模型看:全部平铺塞进提示词、分层下钻、还是用到才检索。它管"规模大了怎么不失控"
网上常有人争:"MCP 的工具一多就撑爆上下文,还是直接用 CLI 靠谱。"这就是把维度搅成一团的典型。三个维度是正交的,谁也不决定谁:MCP 不强迫你平铺,CLI 也不天然分层,专用函数照样能走 MCP 接进来。看三个真实搭配:
▪ CLI + 手写注册 + 分层:Claude Code 自带的工具就是这路数——精挑十几条按场景组织,稳得住 ✅
▪ 函数 + MCP + 分层:MCP Server 把 db.query、mail.send 按组暴露,模型先选 Server、再选具体工具
▪ 任意形态 + MCP + 平铺:有人一口气接十几个 MCP Server、上百个工具全塞进提示词,光工具定义就吃掉几千 token,开局就爆 ❌
三个搭配摆一起就看清了:形态和协议怎么选都行,爆不爆只看路由。路由的玩法主要有三种:
▪ 分层工具路由:先选大类、再选具体工具,像目录树下钻。适合工具几十上百个的场景
▪ 按需检索工具:把工具描述也存进向量库,先检索出相关的再给模型。适合工具库大且动态的场景
▪ 工具命名空间:按组起名(db.query、mail.send 这种),像代码包一样逐层定位。适合分类清晰的工具集
MCP 天生就是 Server → Tool 两层结构,做分层路由一点问题没有——骂 MCP 撑爆上下文,属于骂错了对象。
总结:FC 解决"模型怎么表达调用",MCP 解决"工具怎么标准化接入"——一个在模型侧、一个在工具侧,正交、可配合。工具一多会撑爆上下文,但爆不爆只看路由(平铺、分层、按需检索),跟工具形态、接入协议都无关——MCP 天生就是 Server → Tool 两层结构,做分层路由一点问题没有。
06 工具调用失败怎么容错?怎么防止 Agent 无限循环?
容错先分清两种失败的位置,这是最容易混的:
▪ A. 解析失败:发生在执行之前——tool_call 压根不是合法 JSON。处理:Pydantic 校验 + 重试 + 兜底
▪ B. 执行失败:JSON 解析成功了、函数执行才报错。处理:把错误反馈给模型,让它调整参数或换工具
被问"JSON 解析失败怎么办",答"本地先调一下看通不通"——那是 B 的处理,答偏了,A 阶段你连它想调哪个工具都没解析出来。
三类高频失败,处理思路各不相同:
▪ 解析失败:校验环节拦住,带错误信息让模型重试一次,再不行走兜底
▪ 超时:指数退避重试几次,全失败就把"工具暂时不可用"回喂给模型,让它决定换工具还是降级回答,别让整个任务跟着崩
▪ 数据太大:在进 LLM 之前先瘦身——工具层精简字段、分页,Agent 层摘要压缩,超大的落盘或存向量库
代码走一遍:
① 解析失败:校验 → 重试 → 兜底
try:
args = QueryOrderInput(**response.tool_call.arguments) # Pydantic 校验
except ValidationError as e:
# 带错误信息重试一次,让模型自己修正
retry_response = llm.chat(messages=[…, {“role”: “tool”, “content”: f"参数错误: {e}"}])
# 再失败走兜底:默认值 / 降级不调工具直接回答
② 超时:指数退避 + 软失败
for delay in [1, 2, 4]: # 1s → 2s → 4s
try:
result = call_tool(args, timeout=delay)
break
except Timeout:
sleep(delay)
else:
# 软失败:把超时信息回喂给模型,让它决定换工具还是降级回答
# 千万别让整个任务崩掉;区分网络超时(可重试) vs 业务慢(如转账不能盲目重试)
result = “工具暂时不可用”
③ 数据太大:三层
工具层:精简字段 / 分页
Agent 层:摘要压缩——注意发生在【进 LLM 之前】,先瘦身再进上下文
summary = small_model.summarize(huge_result, query=current_question)
超大数据:落盘或存向量库,不内联
防死循环——四道防线:
▪ 最大轮次上限:State 里维护计数器,超 N 次强制终止。注意话术——说"强制终止/降级输出",别说"卡住"
▪ 完成标记:Planner/反思节点判断目标达成,置 done,主动结束而不是被动超限
▪ 结果校验:每轮检查结果达没达标,达标即停,校验产出判断
▪ 人工介入:高危操作或反复失败时暂停,交人审批(Human-in-the-Loop)
注意"校验"和"标记"是两步:校验产出判断,标记产出动作,因果链是 校验通过 → 标记完成 → 终止循环。
在 LangGraph 里的落地长这样:
class State(TypedDict):
messages: Annotated[list, add_messages]
iteration: int # 防线①:计数器
def should_continue(state):
if state[“iteration”] >= 5: # 防线①:超限强制终止
return “end”
if state.get(“done”): # 防线②:完成标记
return “end”
if last_message.tool_calls:
return “tool”
return “end”
框架层还有兜底:recursion_limit(默认 25 步),防止真跑飞
app.invoke(state, config={“recursion_limit”: 25})
业务层计数器管精确控制,框架层 recursion_limit 管兜底,两层缺一不可。
总结:解析失败用校验兜底,超时软失败回喂模型,数据太大进 LLM 前压缩。防跑飞四道防线:上限兜底、达成即停、反思校验、人工兜底。
07 短期/长期记忆、知识库、日志,怎么区分?
四个东西一张表分清:
| 短期记忆 | 当前对话窗口的内容 | 随上下文 | 压缩/溢出即丢 |
| 长期记忆 | 用户专属偏好、历史结论 | 语义检索 | 反复改写、合并、淘汰 |
| 知识库(RAG) | 公共业务文档:手册、制度 | 语义检索 | 走审核流程更新 |
| 执行日志 | 这次跑了什么流程 | 按时间存文件 | 只增不改 |
短期记忆是个特例:当前对话窗口本身就是它,不需要任何设计,压缩、溢出自然就丢——怎么对付"满了"的问题,是第 08 题的事。
说白了:知识库存公共的、不变的;记忆存私人的、会积累的;日志是流水账。
比如同一个客服 Agent:
▪ 退换货政策手册是知识库——所有用户共用、规则不变
▪ "这位客户住上海、偏好顺丰"是记忆——只属于他、下次还得用
▪ "3 月 8 日他来查过一次物流"是日志——记一笔就完,不影响下次怎么回复他
判断"是不是记忆"就一条:存进去的东西,后面会不会被语义检索出来、影响下一次决策。 用户说"我花生过敏",下次点餐这条被捞出来、菜单自动避开——参与决策,是记忆;"这轮对话耗时 2 分钟"只备查、从不影响回复——不参与决策,是日志。
生命周期三个动作:
▪ 写入:用户明确说"记住这个",或对话中自动提取可复用的偏好/事实
▪ 检索:每轮对话开始时,拿当前问题检索相关记忆,拼进上下文
▪ 淘汰:时间衰减(越久权重越低)、相似记忆合并、容量上限按重要性淘汰
一个偏好的一生:
用户:“以后报告都用黑色封面”
↓ 写入:偏好存进记忆库
↓ 下个月做汇报:检索出这条拼进提示词 → 封面自动变黑
↓ 半年没做报告:权重衰减、容量告急 → 最先被淘汰
记忆冲突怎么处理?场景:用户先说"住北京",后说"搬上海"。两个流派:
▪ 写入时消歧(Mem0 v2):发现矛盾当场 UPDATE/DELETE 旧记忆,库永远干净一致。但删错不可逆——用户说过"我不吃辣",某次点单又说"今天微辣",长期偏好可能被当矛盾删掉。而且每条都要检索 + 二次 LLM 判断,贵
▪ 只追加 + 检索时推理(Mem0 v3):两条带时间戳的事实并存,查询时语义检索 + 时间排序取最新。不会有不可逆丢失的问题、LLM 调用也少,代价是库会变大、依赖检索排序的质量——但排序错了改个规则就能修,删除错了可没救
v2 风格:写入时消歧
memory.upsert(“用户住在北京”) # 后来…
memory.upsert(“用户搬到上海”) # → UPDATE:把北京那条改掉
v3 风格:只追加
memory.add(“用户住在北京”, timestamp=“2025-01”) # 保留
memory.add(“用户搬到上海”, timestamp=“2025-06”) # 并存
查询时:语义检索 + 时间排序 → 返回"用户现在住在上海"
总结:判断是不是记忆就一条——会不会被语义检索出来影响决策。冲突处理,追加比删除安全,因为删除不可逆。
08 上下文满了怎么办?溢出和腐化有什么区别?
两个问题本质不同:
| 本质 | 装不下了 | 装得下,但找不到 |
| 表现 | 任务失败、报错 | 不报错,决策质量悄悄下降 |
| 隐蔽性 | 明显,立刻发现 | 隐蔽,从外面看还在正常干活 |
| 解法 | 压缩、滑动窗口、外置 | 主动提炼、结构化、清理噪声 |
腐化的原因:注意力有限,上下文越长,每个 token 分到的注意力越少,无关内容占了大头,有用信息越来越难被"看见"。像在巨大图书馆找书,无关的书越多越难找。
它最阴的地方是不报错:客服 Agent 聊到第 80 轮,退款记录明明还在第 20 轮的上下文里躺着,用户再问"退款到账没",模型回一句"没有找到相关信息"——任务照常跑,答案悄悄错了。
所以上下文管理不能等满了才动手,要主动做减法。
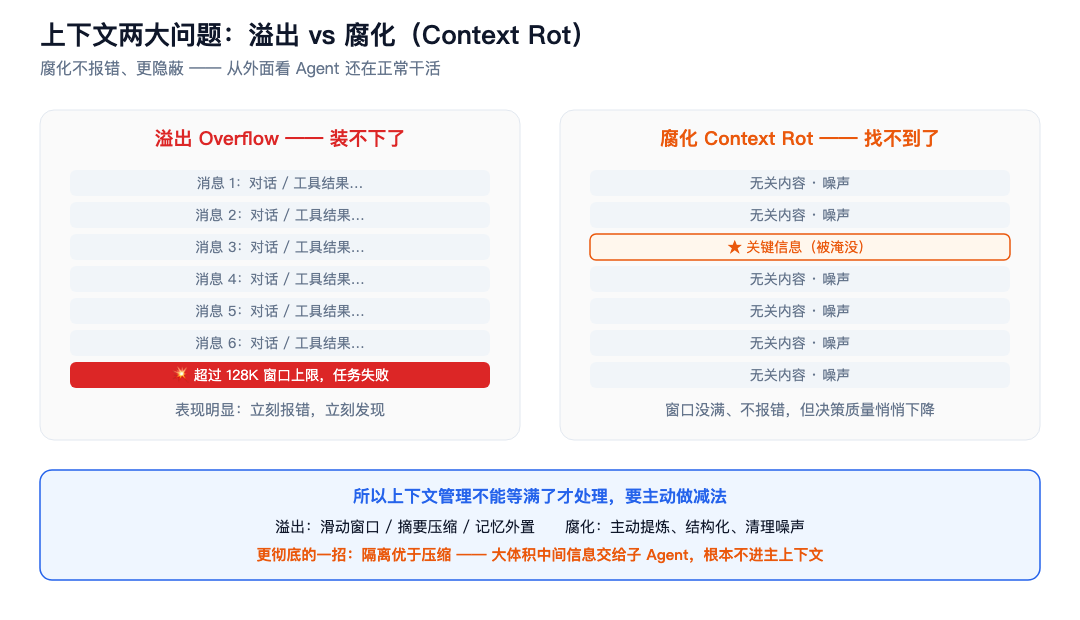
工程上三层方案:
第一层:治溢出三件套
▪ 滑动窗口:只留最近 N 轮、前面砍掉。简单、token 可控,但早期重要信息会丢
▪ 摘要压缩:旧对话压成摘要替代原文。能保留关键信息,但压缩可能丢细节
▪ 记忆外置:关键信息存向量库、按需检索。不会因滑动丢失,但需要额外基建、有延迟
第二层:隔离优于压缩
压缩是信息进了上下文再做减法,费 token 还有损。更好的做法:让大体积中间信息根本不进主上下文。
主 Agent 任务:“在代码库中找到处理支付回调的函数”
方案A 主 Agent 亲自搜:十几个文件数万 token 进主上下文 → 找到后全成永久噪声
方案B 委派子 Agent:主上下文只增加两条消息——
任务描述 + 结论(“函数在 src/payment/callbacks.py”)
中间数万 token 随子 Agent 一起销毁
Claude Code 的 Task 工具、Deep Research 的检索子 Agent,都是这个套路。
第三层:成本账 + KV Cache 三铁律
Agent 每次调 LLM 都带全部历史,成本是累积的:
第 1 轮: 1000 token
第 2 轮: 2000 token (含第1轮)
第 3 轮: 3000 token (含前两轮)
总消耗: 6000 ≠ 3×1000=3000 轮次越多,差距越大
省钱的核心是让 KV Cache 尽量命中,三条铁律:
▪ system 和工具定义定了就别改——任何改动(哪怕一个空格)都可能让缓存失效,越靠前影响越大
▪ 动态信息追加到末尾,别塞进 system
▪ 用标准 API 格式,别自己拼字符串
一个真实事故:某客服 Agent 每天 10 万次对话,工程师在 system 里加了一行 Current time: {{now}},结果:
首字延迟: 0.5s → 3~5s (涨了 6~10 倍)
月度账单: 几乎翻倍
原因: 时间戳每次不同 → system 变了 → 后面所有 token 缓存全失效
还有个成本真相:优化节省不能相加。实测数据——仅稳定前缀(吃 KV Cache)省 28.3%,仅压缩历史省 17.5%,两个一起上只省 30.0%,而不是 28.3% + 17.5% = 45.8%。为什么?压缩历史的同时也压短了能命中缓存的前缀。多项优化必须放在一起实测。
总结:溢出是装不下,腐化是装得下但找不到,后者不报错更隐蔽。治溢出靠压缩和隔离——隔离优于压缩;治成本靠 KV Cache 三铁律。别让模型被动检索,要主动给它提炼好的知识。
09 RAG 的完整链路?怎么检索得更准?
RAG 就是开卷考试:纯 LLM 闭卷,答不上就编;RAG 先翻书找到相关内容再照着答。
核心不是生成,是检索到对的那一段——检索错了,生成再强也白搭。
完整链路两个阶段:
▪ 离线建索引(一次性或定期跑):文档加载 → 分块 → 向量化 → 存入向量库
▪ 在线查询(每次提问都跑):提问 → 向量召回 top 20-50 → 重排取 top 3-5 → 拼 Prompt → 生成
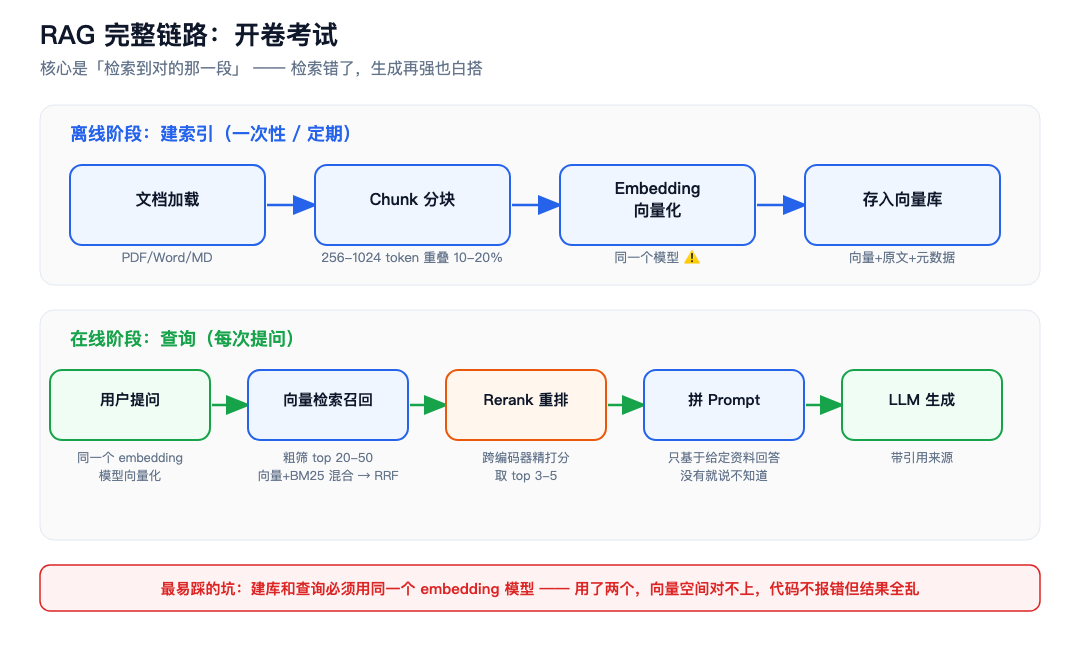
光看链路有点抽象,用"公司制度问答助手"把两条链路各走一遍。
离线案例:把《差旅报销制度》变成可检索的库
原始文档:《差旅报销制度 v3.2》(8000 字)
↓ 加载:解析成纯文本,标题层级保留
↓ 分块:按"章节 → 段落"递归切,"市内交通报销标准"单独成一块
(约 256 token),和邻块重叠 15%,防关键条款卡在切分线上
↓ 向量化:每个块过 embedding 模型,变成一串向量
↓ 入库:向量 + 原文 + 元数据(标题路径:制度/差旅/交通)存进向量库
产出:几百个"制度片段",等员工来问
在线案例:员工问"去上海出差打车能报吗"
员工:“去上海出差,打车能报吗?上限多少?”
↓ 召回:问题转向量,粗筛 top 30——“市内交通报销标准”“住宿标准”
"出差审批流程"都进来了(快,但噪声多)
↓ 重排:跨编码器逐条精读,"市内交通报销标准"排到第 1,
"住宿标准"是噪声被压下去
↓ 拼 Prompt:取 top 3 片段塞进提示词
↓ 生成:照着片段答——“市内交通实报实销,单日上限 200 元”
注意在线案例的最后一步:答案里每个数字都来自检索到的片段——要是召回里压根没有"交通标准"那段,生成再强也只能编。
⚠️ 两个阶段必须用同一个 embedding 模型——用了两个,向量空间对不上,检索结果全错。而且是隐性 bug:代码不报错,结果就是乱的。
检索质量三层优化:
一,混合检索。 先搞清两种检索方式怎么干活:
▪ 向量检索(稠密检索):把问题和文档都变成一串数字(向量),语义相近的内容,向量在空间里也挨得近——它比的是"意思",不是字面。搜"小狗",能找出只写了"幼犬"的文档。叫"稠密",是因为这串数字几乎每一位都有值
▪ BM25(稀疏检索):经典关键词打分——看你搜的词在文档里出没出现、出现几次、这个词本身有多稀有。它比的是"字面命中"。叫"稀疏",是因为只有命中的关键词位置记分,其他位置全是 0
两种方式的盲区正好互补:向量懂语义但字面模糊——搜"HTTP-403",返回的可能是泛泛的"服务器错误"讨论,就是抓不到那个错误码;BM25 字面精确但不懂同义词——搜"kitty",找不到只写了"cat"的文档。
所以两个都跑、结果合并。合并用 RRF(倒数排名融合):两路得分尺度不同(向量 0~1,BM25 几十分),没法直接加权,RRF 只看排名:
RRF 得分 = Σ 1/(60 + rank)
例:某文档稠密排第2、稀疏排第3:
1/(60+2) + 1/(60+3) = 0.0161 + 0.0159 = 0.032
另一文档稠密排第1、稀疏排第50:
1/(60+1) + 1/(60+50) = 0.0164 + 0.0091 = 0.0255 ← 反而更低!
两路都靠前的赢——这就是"融合"的意义。
二,Rerank 重排。 上面召回的结果"沾边就算",粗得很,直接喂给 LLM 既浪费 token 又容易答偏,所以加一道精排。为什么不干脆全用精读?库里几百个片段,逐条精读太慢太贵。所以分两步:
▪ 召回(粗筛):用双编码器。文档的向量在离线建库时就算好存着了,来一个问题只需算一次问题向量、比个距离,几百条瞬间扫完——快就快在文档能提前算。但它只能拿"问题的意思"和"文档的意思"各比各的,看不到两者对在一起的细节,精度一般,先筛出 20-50 条再说
▪ 重排(精读):用跨编码器。把问题和文档拼成一段文本一起读,逐词对照着打分,判断准得多。代价是没法提前算——每个问题都得把这 20-50 条逐条现读一遍,慢。只对粗筛结果做,精选 top 3-5 条进 Prompt
类比:召回像猎头看简历初筛——扫一眼学历技能就筛掉大半;重排像面试官坐下来深聊——一个一个谈过,才知道谁真的合适。
三,Agentic RAG。 传统 RAG 是条件反射:不管问什么,先检索再回答。Agentic RAG 把"查不查、查几轮"的决定权交给模型自己判断——多了这层决策,才配叫"Agentic":
▪ 需要私有/实时数据 → 查。"我上周的报销批到哪一步了?"这种信息只在内部系统里,模型肚子里没有,必须检索
▪ 常识就够答 → 不查。"什么是增值税?"教科书知识直接答——省成本、降延迟,还避免检索回来一堆无关文档干扰答案
▪ 多跳复杂问题 → 查多轮。“哪些费用最容易报销被驳回?“第一轮查"驳回原因”,发现各制度说法不一;换关键词再查"发票规范”,两轮结果对上了才敢下结论
传统 RAG 是"图书馆只许搜一次就得写报告",Agentic RAG 是研究员反复查阅、交叉验证,材料够了再动笔。
两个高频追问:
Chunk 切多大? 太大主题混杂、向量被稀释;太小语义不完整(“该公司收入增长 3%”——哪家?)。经验起点:
切分策略: 递归/结构感知(按标题→段落→句子递归切)
块大小: 256-1024 token
重叠: 10%-20%(防止关键信息卡在切分线被切断)
检索效果怎么量化? 三个指标:recall@k——该找的捞到了吗;MRR——第一个正确答案排第几;nDCG——整份列表排得好不好。
总结:RAG 是开卷考试,核心是检索到对的那一段。向量管语义、BM25 管关键词,RRF 融合、跨编码器精排;检索有成本,让 Agent 按需决策查不查。
10 怎么评估一个 Agent 好不好?怎么持续迭代?
指标层:任务完成率、端到端延迟、工具调用次数、token 消耗、幻觉率。任务完成率是硬指标,其余四个是成本和质量的护栏——完成率上不去,省钱省延迟都没意义。
评测层分两种:
▪ 能机械判定的任务(写了文件、改了配置):用验证器核实机器可独立复核的事实——不是听 Agent 自述"全部完成"
▪ 开放式任务(生成报告、处理投诉):用 LLM-as-Judge 按评分细则打分
验证器参考 SWE-bench 的做法,把"修复完成"拆成两个独立命题:
FAIL_TO_PASS: 修复前失败、修复后通过 → 证明问题确已解决
PASS_TO_PASS: 修复前后均通过 → 证明没引入新缺陷
只检验前者,Agent 可以删改测试断言蒙混;只检验后者,等于没检验。两组同时检验才可信。
迭代层:跑评测 → 看失败 case → 定位是 prompt、工具还是规划的问题 → 改 → 再跑,A/B 对比;定期换新测试集防过拟合。
三个认知,一个比一个值钱:
一,评测可以自动化,优化不能自动化。 "让 Agent 自己迭代优化"是错的——它怎么自动优化?自己改自己的代码吗?真正的闭环:
跑评测(自动) → 失败归因(AI辅助定位 + 人分析) → 改prompt/工具/规划(人决策) → 再跑
二,Pass@k vs Pass^k,差一个符号差一个世界。
| 定义 | k 次里至少成一次 | k 次每次都成(且不触发一票否决项) |
| 公式 | 1-(1-p)^k | p^k |
| 衡量 | 能力上限:“能不能偶尔创造奇迹” | 业务可靠性:“能不能稳定交付” |
| 适用 | 科研探索、开放式创作 | 支付、退款、权限变更 |
数字最说明问题——单次成功率 p=0.6,跑 5 次:Pass@5 = 1 – 0.4⁵ ≈ 99.0%,看起来几乎必成;Pass^5 = 0.6⁵ ≈ 7.8%,连续五次不出错依然很难。
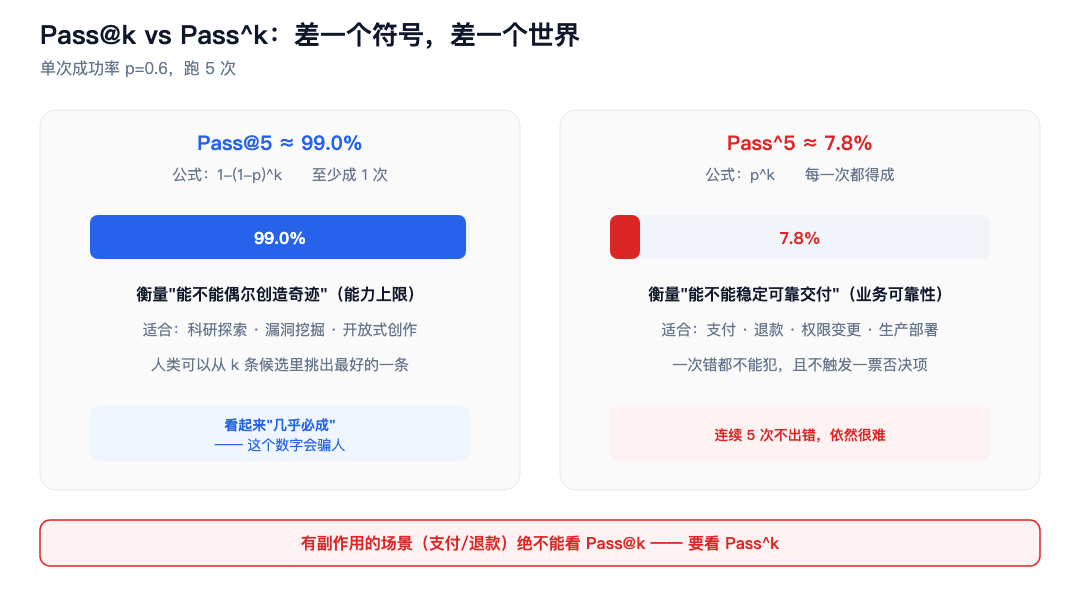
有副作用的场景绝不能看 Pass@k,那个数字会骗人。
三,失败归因要归"首个错误",且要归对层。
根因是轨迹中第一个导致偏离的错误,后面的报错多是连锁反应:
edit_file 返回 old_string 匹配失败
→ 连续三次重试未写入
根因: 第一次编辑错误(1个) 后果: 三次重试(不是3个独立问题)
归对层,是分清问题出在 Harness 还是模型——Harness 就是围着模型转的那圈"脚手架":工具定义、观察通道、循环框架这些。归错层,改进方向全错。经典案例——AndroidWorld 记账任务:
现象: Agent 32步完成任务、报告"做完",验收发现记录根本不存在
回看: 第8步思考里写着 “I cannot actually see the content of the image”
第11步四条开销数据凭空出现(幻觉编造)
根因: 不是"模型不会OCR"——这个 Agent 是纯文本的,观察空间里根本没有图像
是 Harness 的观察通道缺失
如果归错: 归成"模型能力不行" → 去换模型/做OCR微调 → 钱花错地方
总结:评测可以自动化,优化不能自动化。Pass@k 看能力上限,Pass^k 看业务可靠性。归因定位首个错误,且归对到 Harness 还是模型——归错了,改进方向全错。
写在最后
10 道题就三层骨架:是什么(Q1 本质、Q2 选型、Q3 范式)→ 怎么干(Q4 调工具、Q5 协议、Q6 可靠性、Q7 记忆)→ 怎么变好(Q8 上下文与成本、Q9 检索、Q10 评估)。
写到这里,文章就写完了,就和大家随便唠唠吧。
去年的招聘岗位其实就很少,今年受 AI 冲击,就业就更难了,好几个从我们组离职的同学,到现在都没有找到工作,然后也有个非常好的朋友,年初被裁,到现在已 gap 大半年。
有时也会为他们担忧,隔段时间就会问问情况,特别是拖家带口、背负房贷的同学。
再回到我自己,也是历史长河中的一粒尘埃,再过两年我也 40,隐约感觉这一行也要到头了,以后的路该怎么走,其实我也没完全想好。
换作之前的我,肯定会非常焦虑,不过现在已经释然了,走一步看一步吧。
不管未来的路如何,我觉得心态非常重要,越是艰难的环境,心中越需要正能量。
喜欢于东来说的一段话:
找不到工作,去球;
欠别人钱,去球,慢慢还;
啥事儿影响心情的,都别往心里去,人活着,首先得快乐。
今天就聊这么多,我们下期见。
普通人如何抓住AI大模型的风口?
领取方式在文末
2026年入行AI大模型的黄金窗口!!!
AI产业正迎来前所未有的爆发式增长。 从DeepSeek以百万年薪重金招募顶尖研究员,到百度、阿里、腾讯等头部企业加速推进AI Agent商业化布局,再到国家层面持续出台政策,大力扶持数字经济与AI人才培育体系,多重信号清晰指向一个共识:AI的“黄金十年”已全面开启
在产业浪潮的强劲推动下,AI人才争夺战日趋白热化。技术迭代与场景落地双轮驱动,催生海量高价值岗位。放眼未来,AI领域的职业发展前景广阔无垠,正涌现出大量高潜机遇,堪称一片值得深耕的**“人才蓝海”**。
脉脉数据显示📊:
2026年1-2月,AI岗位数量同比增长约12倍,增速远超新经济行业整体增幅;AI岗位在全部新经济岗位中的占比也从2025年同期的2.29%跃升至26.23%,几乎占据新经济招聘市场的四分之一。
与此同时,AI新发岗位平均月薪高达60738元,较新经济行业整体平均月薪48189元高出约26%。
这一切都说明一件事:2026年,正是入行AI大模型的黄金窗口❗️❗️
最佳学习路线
只要你真心想学习AI大模型技术,这份精心整理的学习资料我愿意无偿分享给你,但是想学技术去乱搞的人别来找我!
在当前这个人工智能高速发展的时代,AI大模型正在深刻改变各行各业。我国对高水平AI人才的需求也日益增长,真正懂技术、能落地的人才依旧紧缺。我也希望通过这份资料,能够帮助更多有志于AI领域的朋友入门并深入学习。
真诚无偿分享!!!
vx扫描下方二维码即可
加上后会一个个给大家发
【附赠一节免费的直播讲座,技术大佬带你学习大模型的相关知识、学习思路、就业前景以及怎么结合当前的工作发展方向等,欢迎大家~】
大模型全套学习资料展示
自我们与MoPaaS魔泊云合作以来,我们不断打磨课程体系与技术内容,在细节上精益求精,同时在技术层面也新增了许多前沿且实用的内容,力求为大家带来更系统、更实战、更落地的大模型学习体验。
希望这份系统、实用的大模型学习路径,能够帮助你从零入门,进阶到实战,真正掌握AI时代的核心技能!
01 教学内容
-
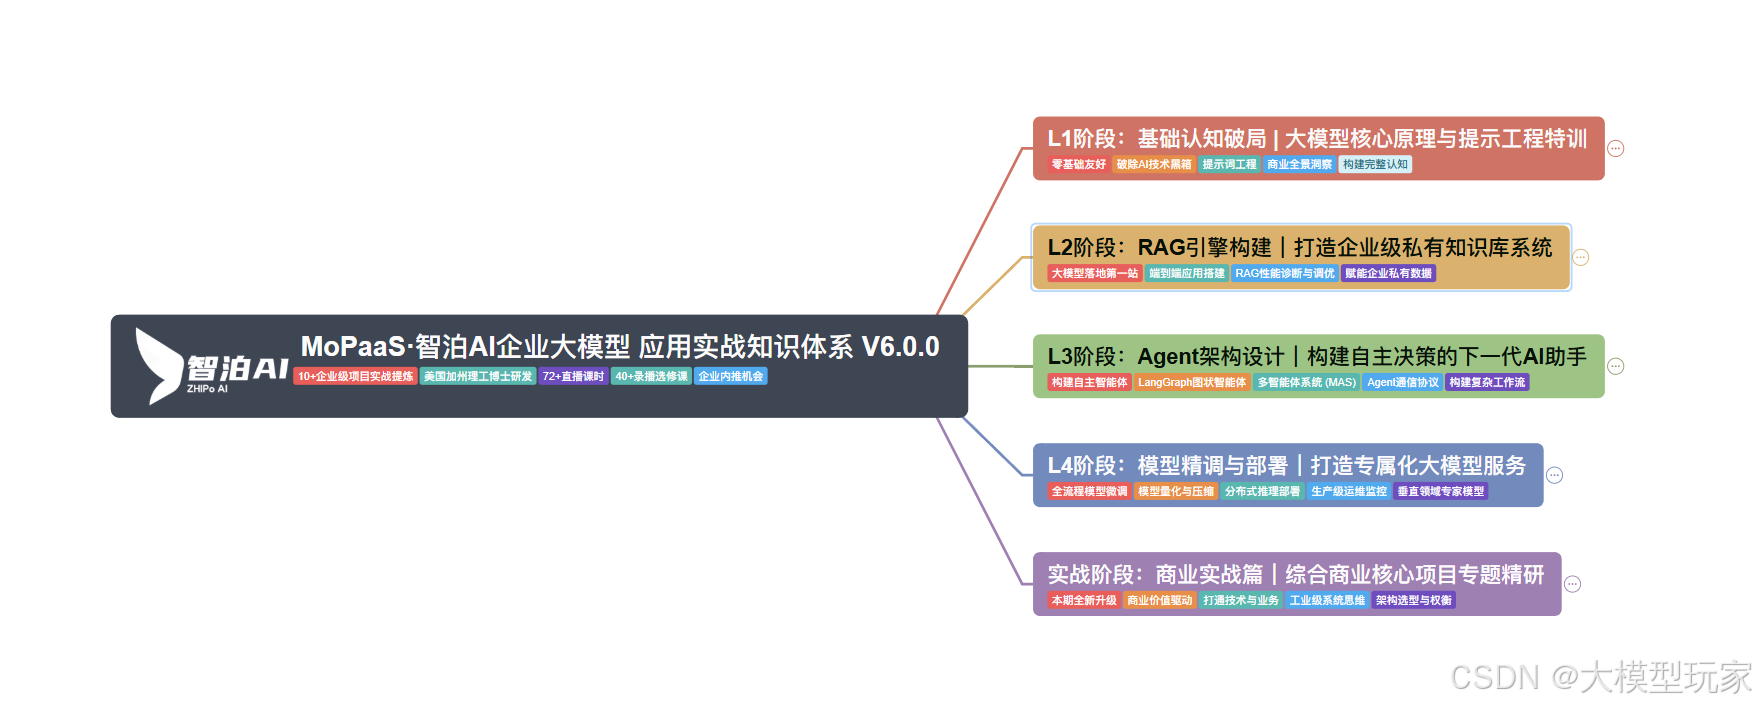
从零到精通完整闭环:【基础理论 →RAG开发 → Agent设计 → 模型微调与私有化部署调→热门技术】5大模块,内容比传统教材更贴近企业实战!
-
大量真实项目案例: 带你亲自上手搞数据清洗、模型调优这些硬核操作,把课本知识变成真本事!
02适学人群
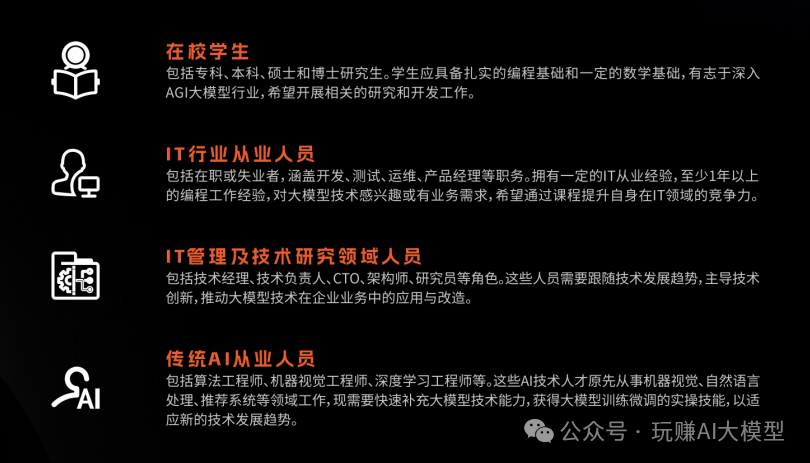
应届毕业生: 无工作经验但想要系统学习AI大模型技术,期待通过实战项目掌握核心技术。
零基础转型: 非技术背景但关注AI应用场景,计划通过低代码工具实现“AI+行业”跨界。
业务赋能突破瓶颈: 传统开发者(Java/前端等)学习Transformer架构与LangChain框架,向AI全栈工程师转型。
vx扫描下方二维码即可
【附赠一节免费的直播讲座,技术大佬带你学习大模型的相关知识、学习思路、就业前景以及怎么结合当前的工作发展方向等,欢迎大家~】
本教程比较珍贵,仅限大家自行学习,不要传播!更严禁商用!
03 入门到进阶学习路线图
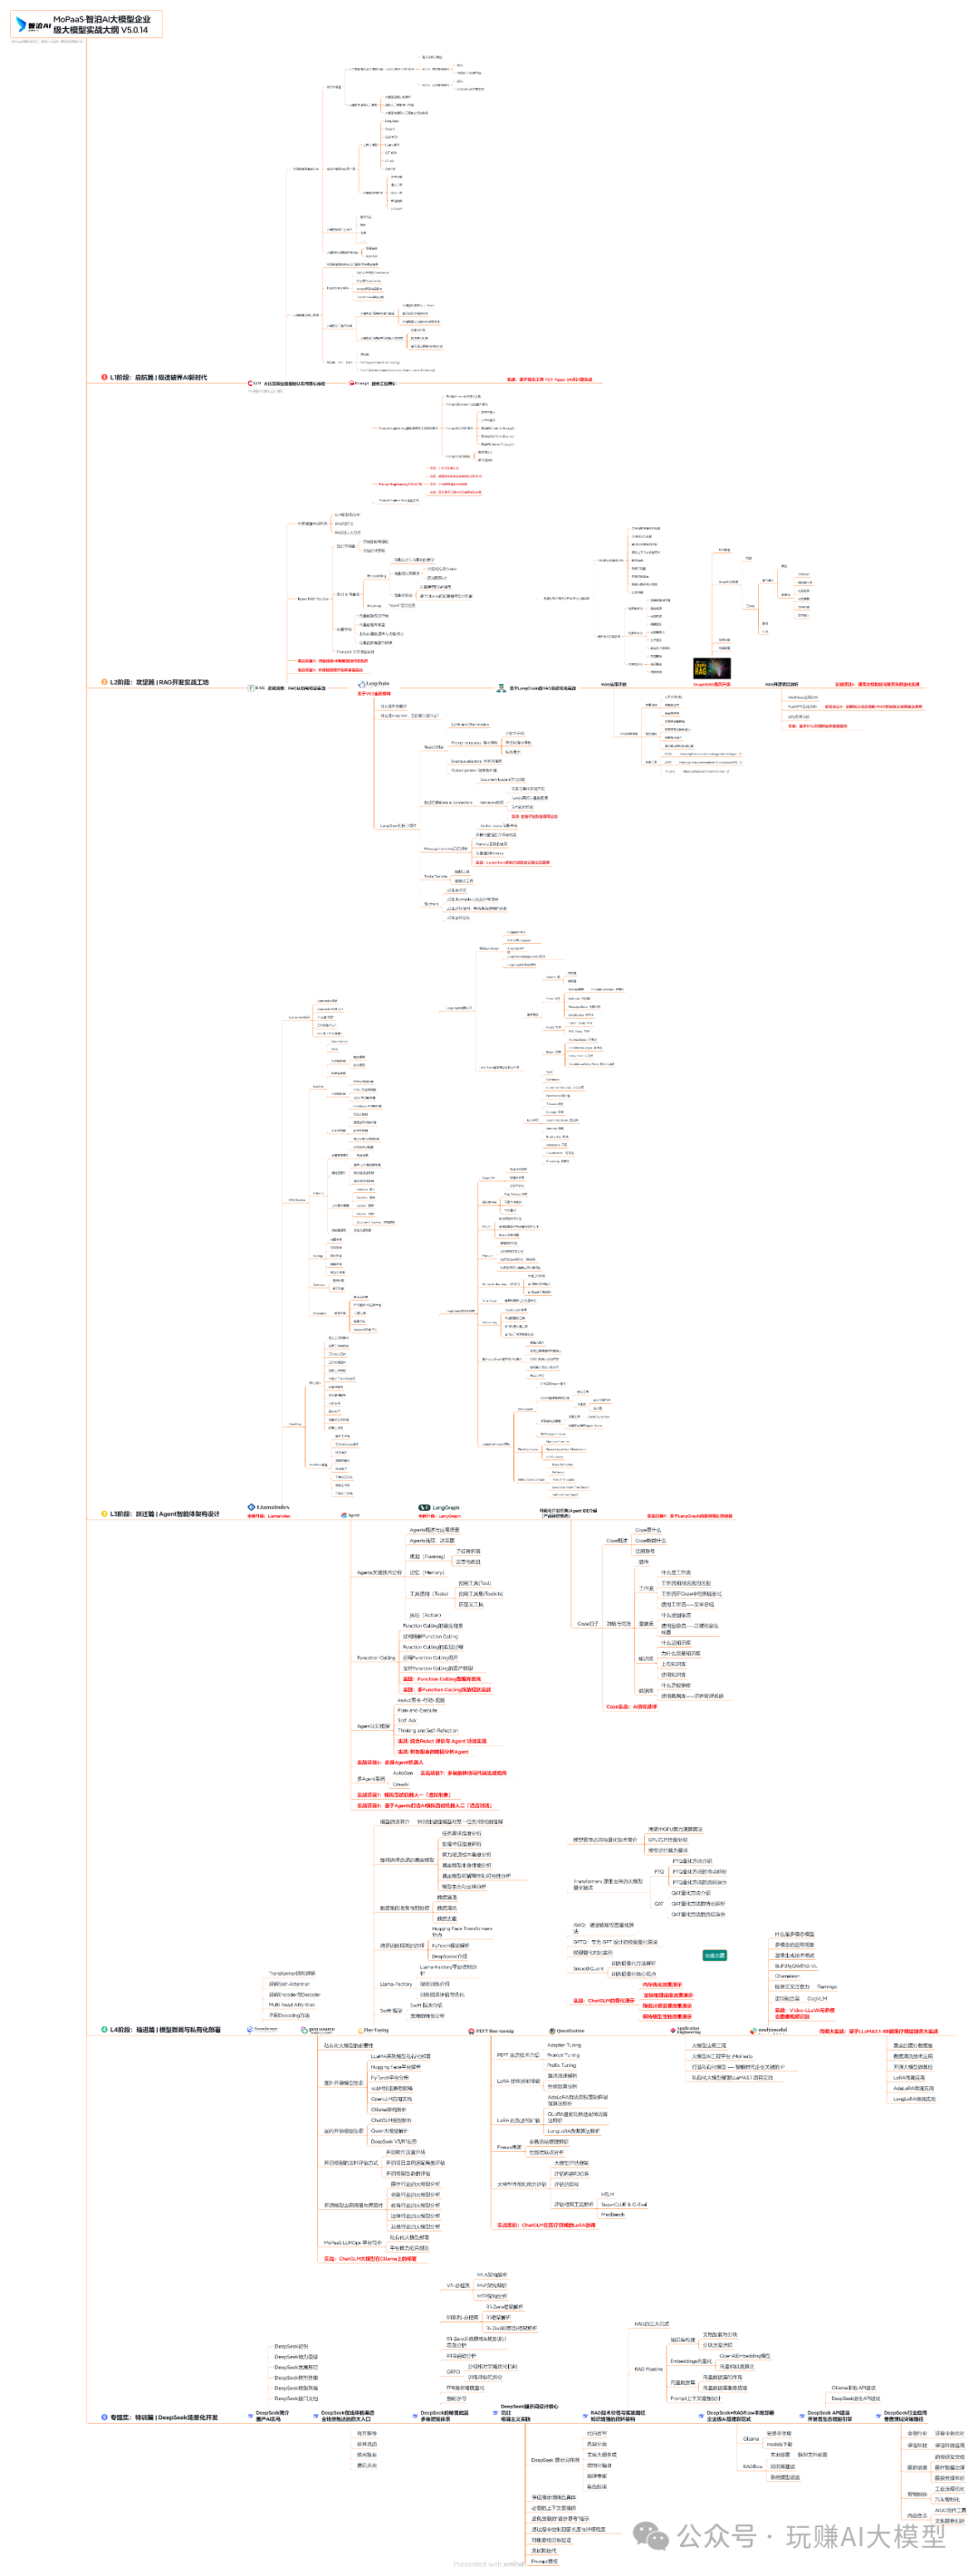
大模型学习路线图,整体分为5个大的阶段:
04 视频和书籍PDF合集
从0到掌握主流大模型技术视频教程(涵盖模型训练、微调、RAG、LangChain、Agent开发等实战方向)
新手必备的大模型学习PDF书单来了!全是硬核知识,帮你少走弯路(不吹牛,真有用)
05 行业报告+白皮书合集
收集70+报告与白皮书,了解行业最新动态!
06 90+份面试题/经验
AI大模型岗位面试经验总结(谁学技术不是为了赚$呢,找个好的岗位很重要)
07 deepseek部署包+技巧大全

由于篇幅有限
只展示部分资料
并且还在持续更新中…
人工智能大潮已来,不加入就可能被淘汰。如果你是技术人,尤其是互联网从业者,现在就开始学习AI大模型技术,真的是给你的人生一个重要建议!
真诚无偿分享!!!
vx扫描下方二维码即可
加上后会一个个给大家发
【附赠一节免费的直播讲座,技术大佬带你学习大模型的相关知识、学习思路、就业前景以及怎么结合当前的工作发展方向等,欢迎大家~】