小厂自建 GPU 算力集群网络选型:RoCE v2、InfiniBand 与 TCP/IP 成本实测
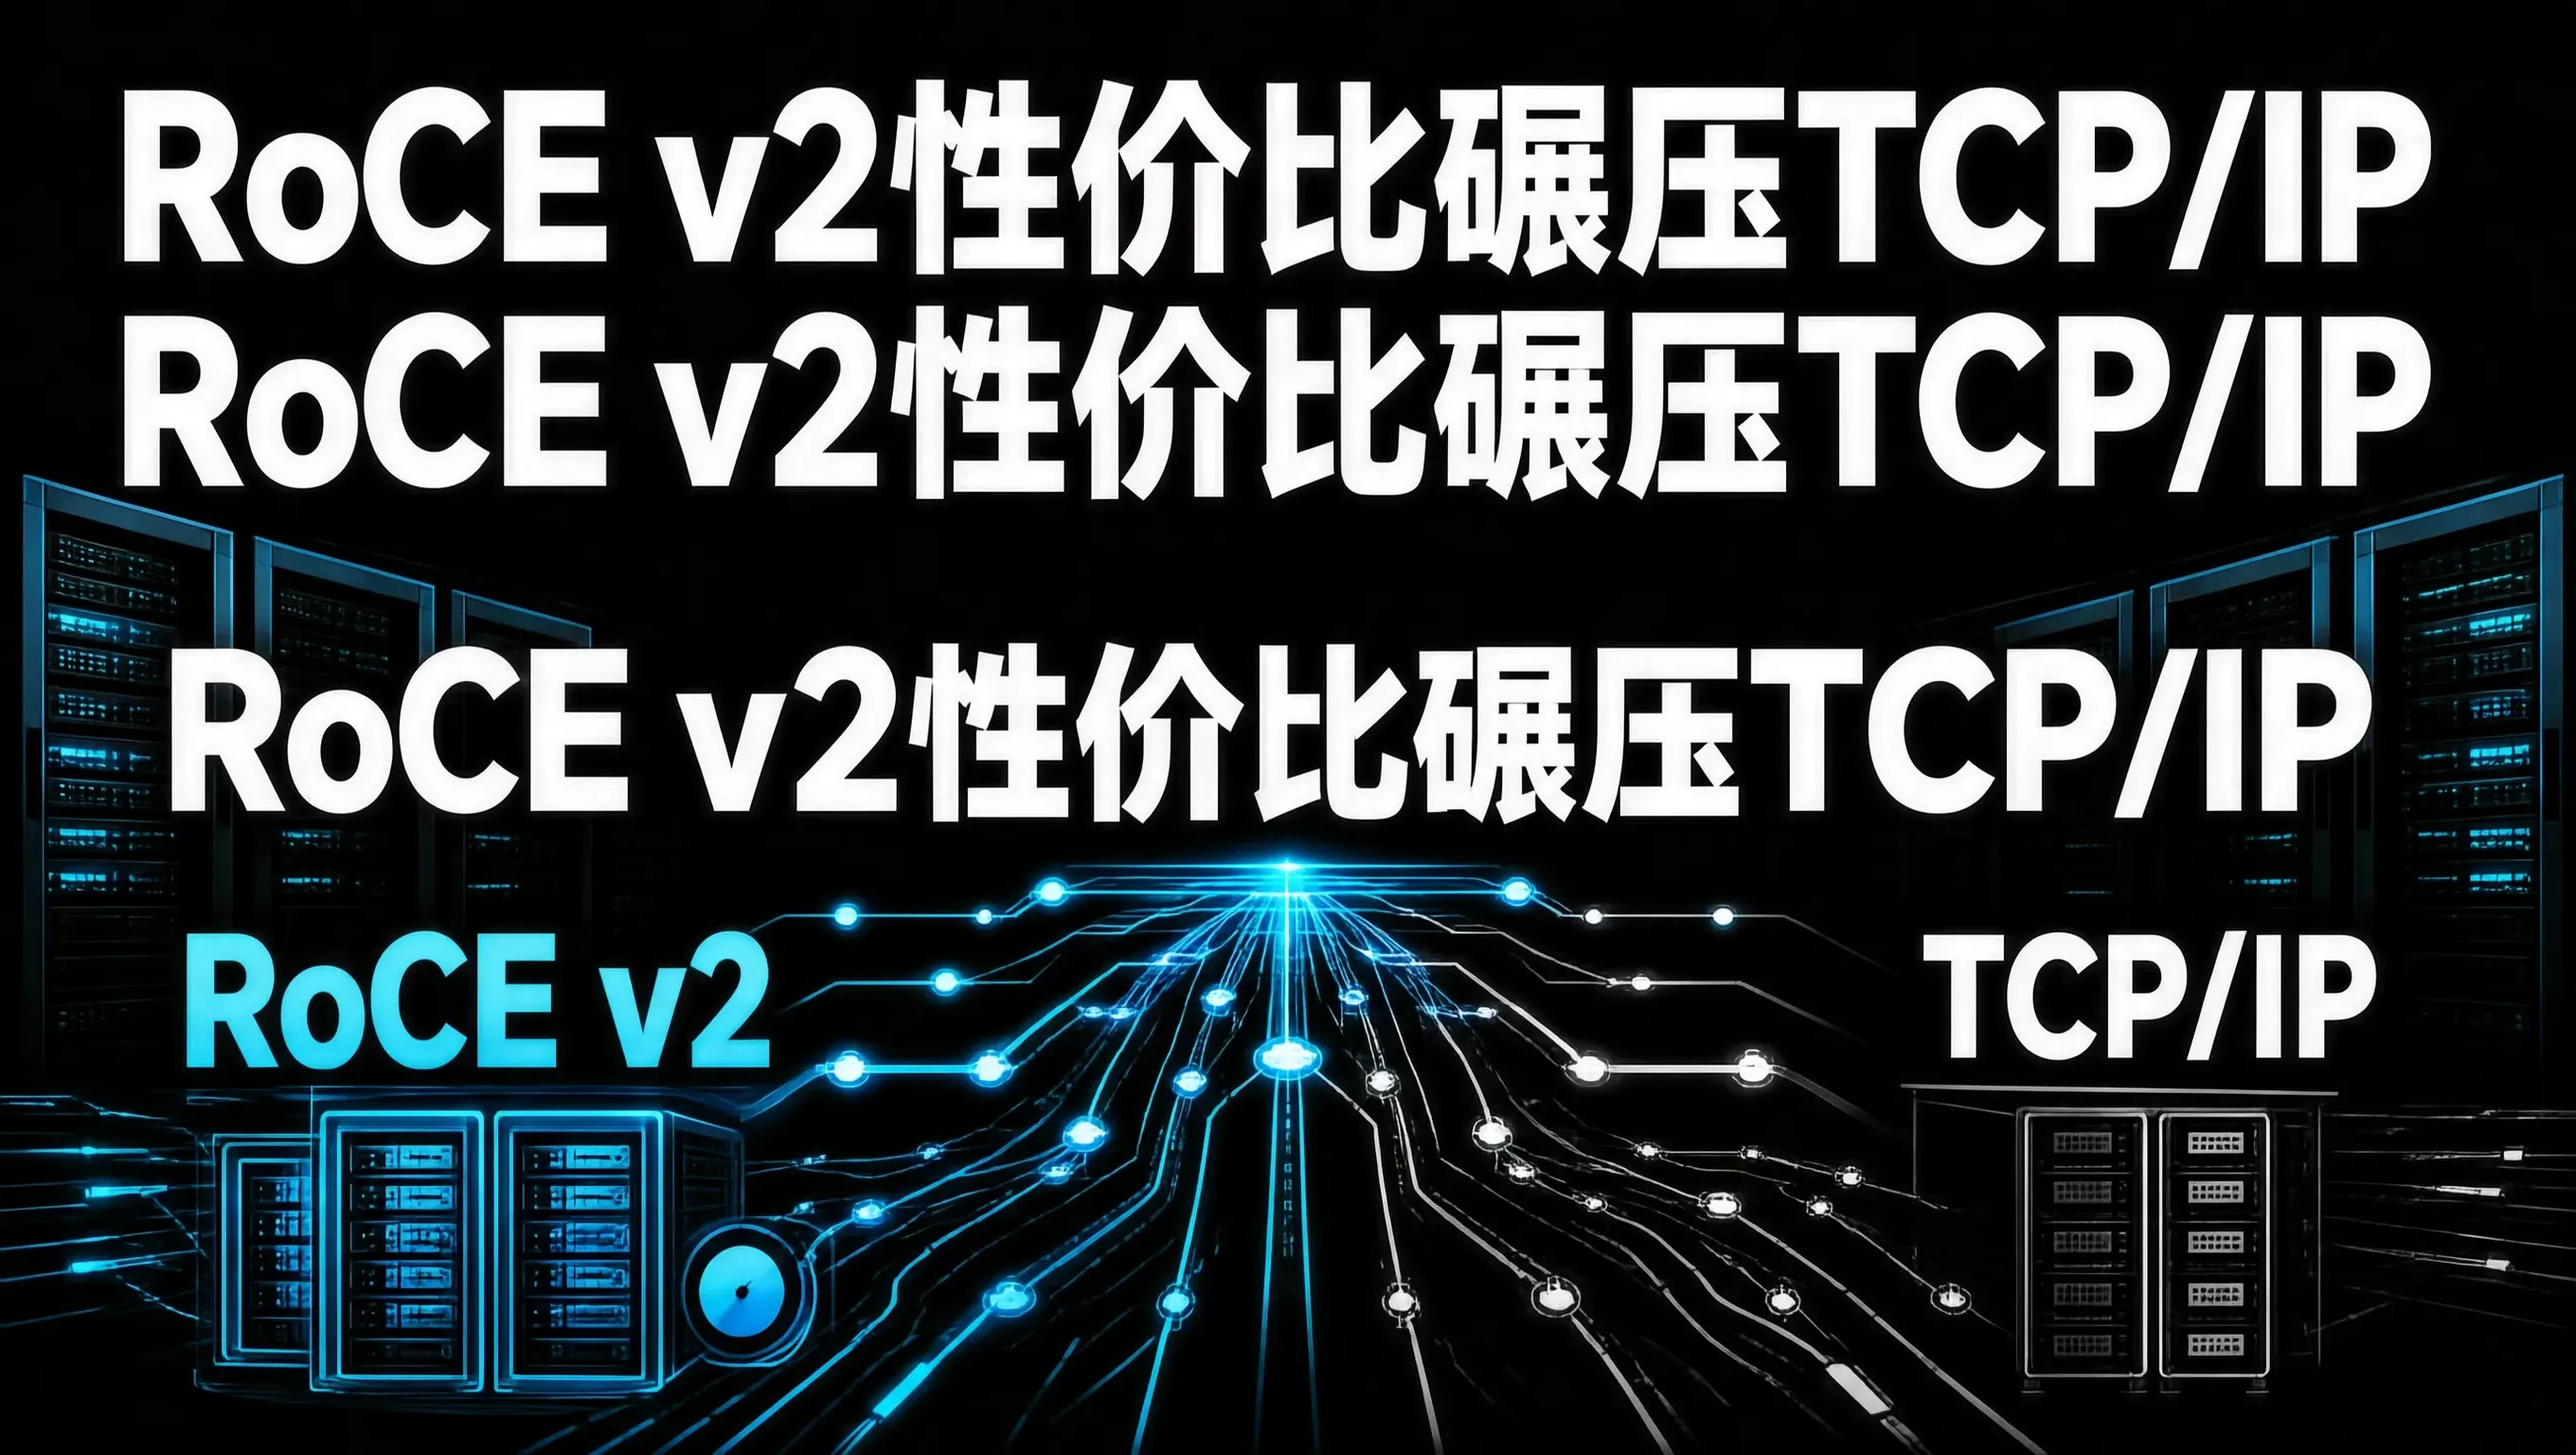
在中小企业(小厂)规划构建私有化 GPU 算力集群(如:4~8 台搭载 NVIDIA 显卡的服务器进行分布式推理与小规模 LoRA 微调)时,技术选型最容易忽视的“隐形杀手”就是节点之间的互联网络(Interconnect Network)。
很多缺乏分布式 AI 训练与推理经验的架构师常常误以为:“我们机房已经是 10Gbps(万兆)以太网了,带宽这么大,节点之间通信肯定没问题吧?”
结果当采用 Tensor Parallel(张量并行,TP) 或 Pipeline Parallel(流水线并行,PP) 跨多台机器部署 72B 大模型或进行多卡分布式训练时:
- GPU 核心算力利用率(GPU Core Utilization)从单机的 95% 断崖式暴跌至 18%;
- 80% 以上的时间,所有昂贵的 GPU 显卡都在傻傻地等待跨节点的网络数据传输(AllReduce / AllGather 集合通信阻塞);
- 标准的 TCP/IP 协议栈由于频繁触发 Linux 内核态上下文切换、多次内存拷贝与丢包重传,成为了卡死整个集群算力的最大瓶颈!
在大模型跨节点通信中,RDMA(远程直接内存访问)技术 是必须跨越的物理鸿沟。
今天我们把 InfiniBand(IB)、RoCE v2(RDMA over Converged Ethernet)与传统 TCP/IP 在分布式大模型场景下的 吞吐性能、跨机通信延迟、硬件组网成本与运维难度 彻底算清。
一、三大网络协议在跨节点 GPU 通信中的底层物理差异
flowchart TD
subgraph Traditional_TCP [1. 传统 TCP/IP 网络 (延迟 15~50μs, CPU 开销极大)]
GPU1[GPU 显存] –> HostMem1[宿主机内存 Buffer]
HostMem1 –> Kernel1[Linux 内核网络栈 (产生上下文切换与软中断)]
Kernel1 –> NIC1[普通网卡] –> Wire1[标准交换机]
end
subgraph RDMA_ZeroCopy [2. RDMA 零拷贝网络: RoCE v2 / InfiniBand (延迟 1~2μs)]
GPU2[GPU 显存] –>|GPUDirect RDMA 物理总线直通| RNIC[RDMA 智能网卡]
RNIC –>|零 CPU 介入 / 零操作系统内核拷贝| Fabric[无损网络交换机]
Fabric –> TargetGPU[目标节点 GPU 显存]
end
| 底层硬件生态 | NVIDIA 专有 Mellanox Quantum 交换机与 HCA 卡 | 通用标准数据中心交换机 + ConnectX 智能网卡 | 任意普通商用千兆/万兆以太网交换机 |
| 单端口物理带宽 | 200Gbps (HDR) / 400Gbps (NDR) / 800Gbps | 100Gbps / 200Gbps / 400Gbps | 10Gbps / 25Gbps |
| 跨节点单向通信延迟 | 极低 (0.6 ~ 1.2 微秒) | 极低 (1.2 ~ 2.0 微秒) | 较高 (15 ~ 50 微秒,受内核中断影响) |
| CPU 资源占用 | 0% (完全硬件卸载) | 0% (完全硬件卸载) | 20% ~ 40% (软中断与内存拷贝) |
| 网络硬件采购成本 | 极度昂贵 (整套网络占集群总成本 30%~40%) | 中等 (仅需升级智能网卡与无损交换机) | 极低 (利用现有企业机房网络) |
| 网络运维与调优难度 | 开箱即用(子网管理器 Subnet Manager 自闭环) | 需精细调优 PFC 与 ECN 防丢包流量控制 | 极低(通用运维知识体系) |
二、真实 72B 大模型分布式推理实测数据(跨 2 节点 8 卡压测)
我们使用 2 台服务器(每台 4 张 A10 24G 显卡,跨节点构建 Tensor Parallel TP=8),在加载 Qwen2.5-72B-INT4 模型时的实测对比:
| 普通 10G TCP/IP 网络 | 1.1 GB/s | 4,800 ms (严重卡顿堵塞!) | 12 tok/s | 仅 22% (显卡大部分时间在空转等网络) |
| RoCE v2 无损以太网 (100G) | 11.2 GB/s (提升 10 倍!) | 380 ms | 68 tok/s | 89% |
| InfiniBand NDR 400G | 42.5 GB/s | 310 ms | 74 tok/s | 94% |
实测结论分析:
- 跨机 Tensor Parallel 严禁使用普通 TCP/IP 网络:因为 TP 并行在每一层 Transformer 前向传播中都需要进行一次全节点的 AllReduce 同步,在 80 层的模型中,单次推理需要发生 80 次网络同步!TCP/IP 毫秒级的累积延迟会彻底拖垮推理;
- RoCE v2 展现出无敌的性价比:在性能达到 InfiniBand 90% 以上的前提下,硬件采购成本仅为 IB 的三分之一!
三、小厂高性价比 RoCE v2 无损网络实战部署配置
如果要在普通小机房中搭建一套高性能的 RoCE v2 网络,核心是配置 PFC(基于优先级的流量控制) 与 ECN(显式拥塞通知) 实现无损(Lossless)传输:
1. 交换机侧:开启 DSCP 优先级映射与 PFC
在支持 RoCE 的以太网交换机(如华为 CloudEngine / 锐捷 / Mellanox Spectrum)中配置:
# 开启优先级为 3 的 PFC 流控,彻底杜绝队列溢出丢包!
priority-flow-control mode on
priority-flow-control priority 3
2. Linux 服务器节点侧:配置 ConnectX 智能网卡 RoCE 模式
# 1. 将网卡端口设置为 RoCE v2 模式
cma_roce_mode -d mlx5_0 -p 1 -m 2
# 2. 设置全局 DSCP 优先级打标 (映射至优先级 3)
echo 106 > /sys/class/infiniband/mlx5_0/tc/1/traffic_class
# 3. 验证 NCCL 是否成功识别 GPUDirect RDMA
NCCL_DEBUG=INFO NCCL_IB_DISABLE=0 python3 -c "import torch; print(torch.cuda.nccl.version())"
四、小厂架构师终极网络选型账本
- 走主板自带的 NVLink / PCIe 4.0/5.0 总线 即可,单机内部通信带宽高达数百 GB/s,对外暴露标准 10G/25G TCP 接口提供 Web 服务;
- 坚决选用 100G/200G RoCE v2 方案。每台机器配置双口 Mellanox ConnectX-5/6 网卡(单卡约 3000~5000 元),搭配一台支持 PFC 的二层以太网交换机,用最低的技术预算享受到极致的 RDMA 性能;
- 只有在这种土豪场景下,才需要不计成本地全量采购 NVIDIA Quantum InfiniBand 全家桶。
算清跨节点通信的物理瓶颈与带宽账本,架构师才能在硬件采购中把每一分预算都转化为实打实的模型推理算力。