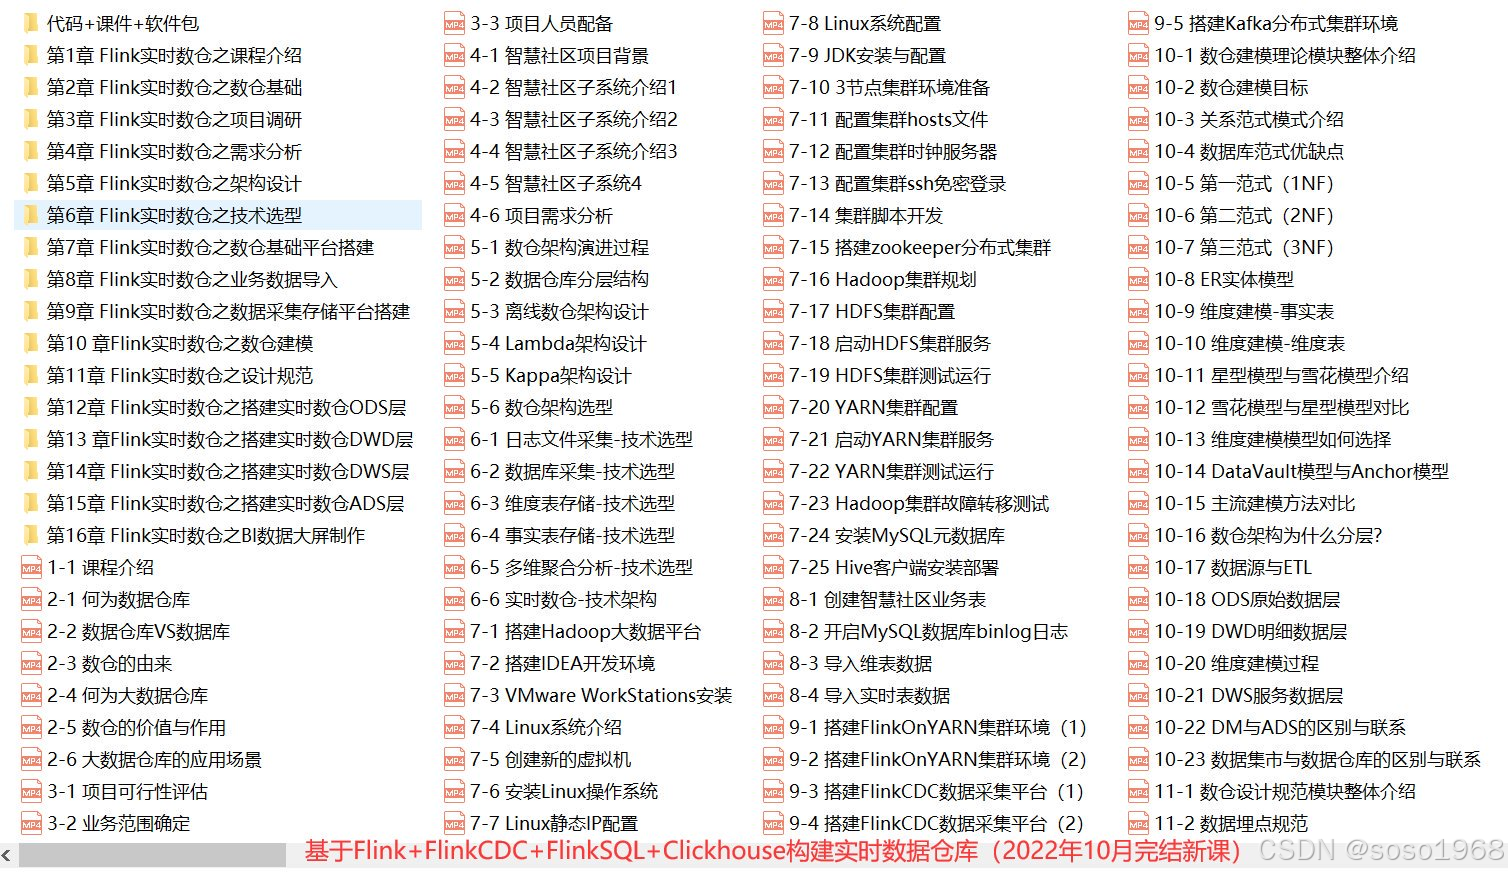
 文件链接: https://pan.baidu.com/s/1DGfYvCSmYSf60wo83-tMCg?pwd=1688 提取码: 1688
一、数据接入层:FlinkCDC 的核心机制
博客将 FlinkCDC 定义为实时数仓的数据接入关键环节,其角色是实时监听 MySQL、PostgreSQL 等数据库的 binlog 日志,将数据库的增删改操作转换为流式事件 。
| 全量加增量同步机制 | 覆盖历史数据初始化与后续实时变更两类同步路径 |
| 断点续传原理 | 保证同步任务中断后可从上次位点恢复,不丢不重 |
| 多表实时同步 | 支持将 MySQL 多表数据同步到 Kafka 或直接进入 Flink 计算任务 |
从算法逻辑角度来看,博客描述的数据接入路径为“binlog 监听 → 变更事件转换 → 流式接入”,但并未给出该路径的具体实现代码或状态管理细节 。
二、实时计算层:FlinkSQL 的计算逻辑
博客指出 FlinkSQL 将流式数据处理抽象为标准 SQL 操作,开发者可用 SQL 语法完成流表定义、维表关联、窗口聚合、双流 Join 等复杂计算逻辑 。
博客列出的 FlinkSQL 核心计算逻辑包括:
上述逻辑共同构成 FlinkSQL 实时计算层的主要算法骨架,但博客未提供任何一条示例 SQL,也未解释窗口触发机制、状态 TTL 或 Join 中的 keyby 策略 。
三、数据服务层:ClickHouse 的存储与查询逻辑
博客将 ClickHouse 定位为结果存储与分析引擎,核心机制包含分布式表与本地表设计、MergeTree 引擎家族、分区与排序键设计、查询优化 。
| 分布式表 / 本地表设计 | 支撑集群水平扩展与多节点查询 |
| MergeTree 引擎家族 | 列式存储与后台合并的底层基础 |
| 分区与排序键设计 | 决定数据组织方式与查询裁剪范围 |
| 查询优化手段 | 保障实时写入与查询性能达到生产要求 |
博主并未给出建表语句、分区粒度选择或排序键字段设定,因此这些机制仅停留在概念层,未形成可拆解的代码逻辑 。
四、整体架构中的算法链路
博客将实时数仓架构划分为数据接入层、实时计算层、数据服务层三层,并参照离线数仓提出 ODS、DWD、DWS、ADS 分层设计 。
从算法编排视角看,各层之间的流转逻辑为:
- ODS 承接接入的原始业务数据;
- DWD 进行清洗、标准化、维度补充;
- DWS 面向主题做轻度聚合;
- ADS 按应用需求输出最终结果。
整体数据流为“FlinkCDC 接入 → FlinkSQL 计算 → ClickHouse 查询”,这是一条完整的实时事件处理链路,但博客对其中的状态管理、checkpoint、容错恢复、窗口触发等算法细节均只字未提 。
五、结论
该博客的核心价值在于技术栈选型与架构地图,而非代码实现。若要深度拆解 FlinkCDC 的断点续传算法、FlinkSQL 窗口聚合的执行计划、ClickHouse 排序键与索引的底层原理,需要从该课程提供的实际工程源码或配套实验中获取,博客正文本身不满足这一需求 。
参考来源
- 【课程资料】基于Flink+FlinkCDC+FlinkSQL+Clickhouse构建实时数据仓库