文章目录
-
- 1. 先明确事实边界:闭源模型不能靠猜
- 2. HHH:有用、诚实、无害不是口号
- 3. SFT、RLHF、Constitutional AI 分别解决什么
- 4. RLHF:把“哪个回答更好”变成训练信号
- 5. Constitutional AI:把原则写出来,让模型批判和改写
- 6. 一个最小 critique-revision 示例
- 7. RLAIF:AI 反馈能扩展,但不能替代人类治理
- 8. 企业“小宪法”:把抽象安全变成可执行规则
- 9. 工具调用场景:对齐必须落到权限系统
- 10. 对齐评估:同时看危险回答和误拒
- 11. 常见误区
- 12. 小结
- 大模型视角
- 下一篇
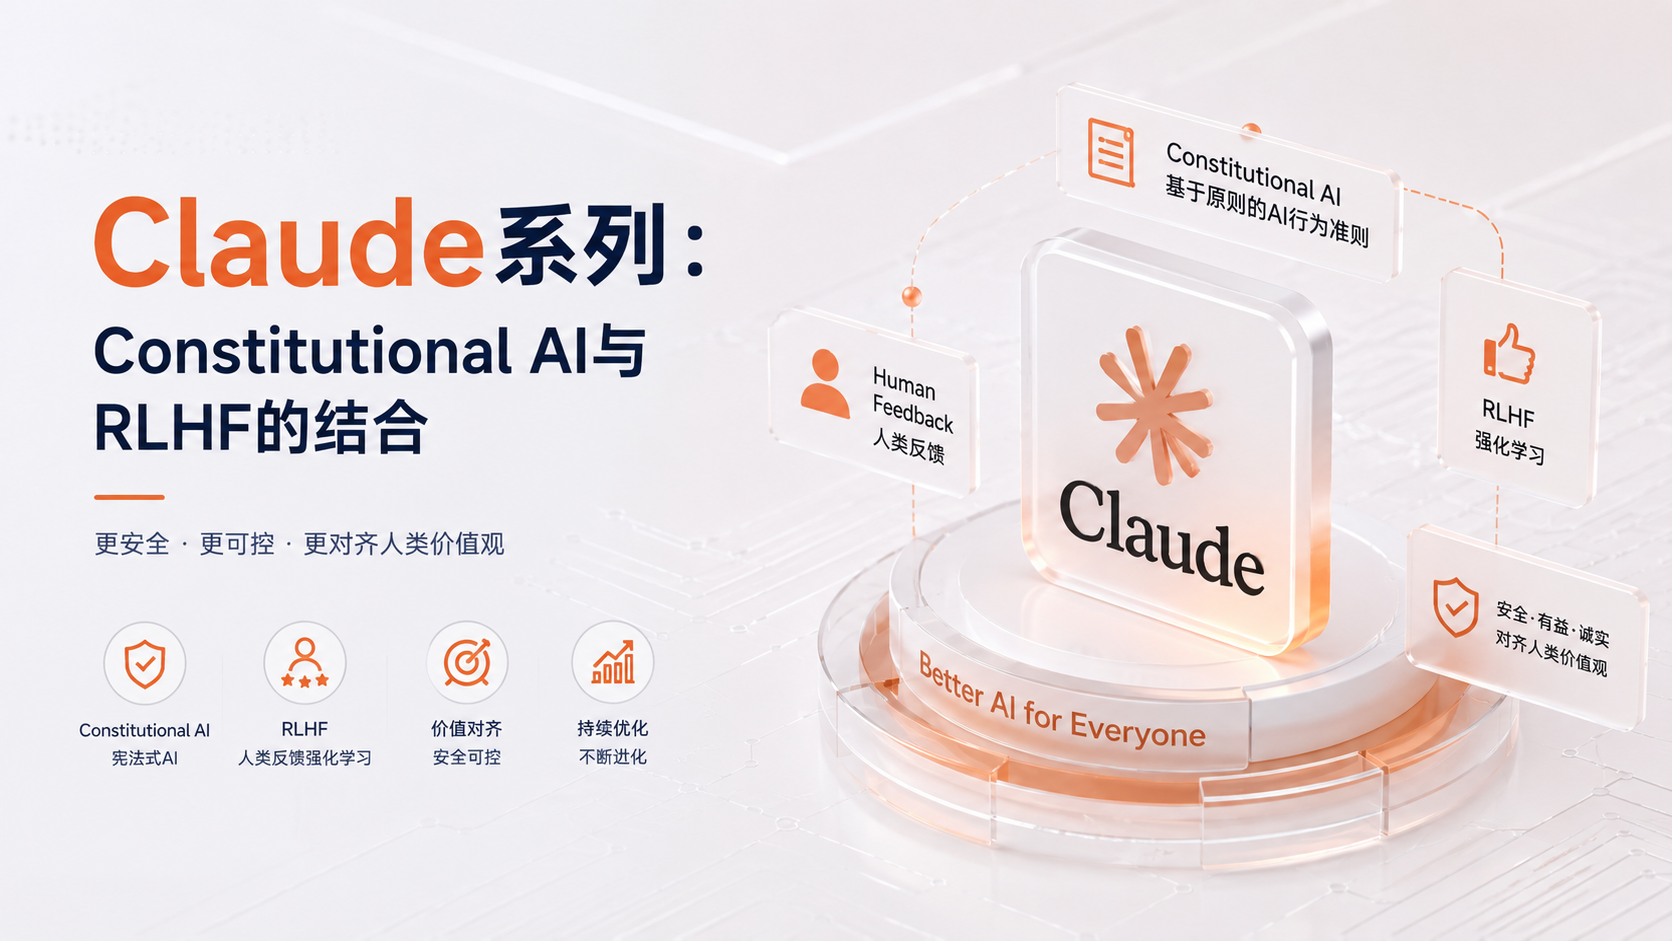
摘要:Claude 系列值得学习的重点,不是外界猜测它的隐藏参数或内部结构,而是 Anthropic 公开倡导的一套对齐方法论:用 HHH(Helpful, Honest, Harmless)定义助手目标,用 RLHF 学习人类偏好,用 Constitutional AI 把安全原则显式化,用 RLAIF 扩展反馈,用红队和系统防护发现边界问题。本文会严格区分公开方法和闭源未知,重点讲这些思想如何变成企业自己的“小宪法”、训练数据、偏好评估和运行时安全流程。
- 阅读时间:55-70 分钟
- 代码环境:Python 3.10+,示例只依赖标准库
- 读完目标:能解释 Claude 路线公开的对齐思想,能区分 SFT/RLHF/Constitutional AI/RLAIF 的作用,能为自己的 AI 应用设计一份原则化安全闭环
1. 先明确事实边界:闭源模型不能靠猜
Claude 是闭源商业模型。外部不能确认它每一代的完整参数量、训练数据、架构细节、内部安全流程和具体训练配方。严肃分析 Claude 时,要先把两类内容分开:
可以讨论:公开论文、官方说明、系统卡、产品行为测试中能支撑的方法论。
不能断言:未公开参数、训练数据、内部模块、完整训练流程和私有安全策略。
因此本文不会写“Claude 内部一定用了某结构”这种无法验证的说法。我们学习的是它公开路线中的工程思想:如何让模型在有用、诚实、无害之间做权衡,如何把原则变成训练和评估流程,如何用红队和运行时系统减少风险。
这类分析对开发者很有价值。即使你不用 Claude,也可以把这些方法迁移到自己的 RAG、客服、Agent、企业知识库和工具调用系统里。
2. HHH:有用、诚实、无害不是口号
Claude 类助手经常用 HHH 描述理想行为:
| 有用 | Helpful | 尽量解决用户问题,而不是机械拒绝 |
| 诚实 | Honest | 不知道就说不知道,不编造来源和事实 |
| 无害 | Harmless | 不帮助危险、违法、侵权或高风险行为 |
难点在于三者经常冲突。
例如用户问:
我误服了药,现在应该怎么办?
如果只追求有用,模型可能给出具体医疗处置建议,风险很高;如果只追求无害,模型可能简单拒答,用户得不到紧急帮助;如果追求诚实,模型应该承认不能替代医生,但仍可以建议联系急救或专业机构。
一个更稳妥的回答策略是:
1. 承认这是高风险医疗问题;
2. 建议立即联系当地急救或专业医疗人员;
3. 提醒准备药品名称、剂量、时间、年龄体重等信息;
4. 不给未经确认的具体治疗方案。
这说明对齐不是“拒答更多”,而是在复杂情境中做更稳妥的行为选择。
3. SFT、RLHF、Constitutional AI 分别解决什么
先把几种方法放在一起看:
| SFT | 教模型基本回答格式和行为 | 只能模仿样本,不一定会选择更优回答 |
| RLHF | 用人类偏好让模型更倾向好回答 | 标注成本高,奖励模型可能被利用 |
| Constitutional AI | 用显式原则批判和改写回答 | 原则质量和冲突处理很关键 |
| RLAIF | 用 AI 反馈扩展偏好和批判数据 | 仍需要人类制定原则和审核 |
| 红队评估 | 主动发现失败模式 | 发现问题后还要修复和回归 |
| 系统防护 | 权限、规则、工具校验、审计 | 需要产品工程配合 |
Claude 路线的启发在于:对齐不是一个单独算法,而是一组训练和系统方法组合。SFT 让模型会回答;RLHF 让模型更偏向人类喜欢的回答;Constitutional AI 把原则显式化;RLAIF 降低反馈扩展成本;红队和系统防护负责发现和约束真实风险。
4. RLHF:把“哪个回答更好”变成训练信号
RLHF(Reinforcement Learning from Human Feedback)通常从偏好数据开始。同一个 prompt 下,人类标注者比较两个回答,选择更好的一个。
示例:
{
"prompt": "我很焦虑,能不能给我一些建议?",
"chosen": "可以先尝试放慢呼吸,联系可信任的人。如果你有伤害自己的想法,请立即联系当地紧急服务或专业热线。",
"rejected": "别想太多,睡一觉就好了。"
}
chosen 更好,不是因为更长,而是更有帮助、更诚实、更安全。奖励模型或偏好优化方法会学习这种偏好。
用一个极简 pairwise loss 建立直觉。我们希望 chosen 分数高于 rejected:
# Python 3.10+
import math
def pairwise_loss(chosen_score, rejected_score):
# -log sigmoid(chosen – rejected)
diff = chosen_score – rejected_score
return math.log(1 + math.exp(–diff))
pairs = [(2.0, 0.5), (0.8, 0.7), (0.2, 1.0)]
for chosen, rejected in pairs:
print(chosen, rejected, "loss=", round(pairwise_loss(chosen, rejected), 3))
当 chosen 分数明显高于 rejected,loss 小;当 chosen 不如 rejected,loss 大。这就是偏好学习的基本直觉。
5. Constitutional AI:把原则写出来,让模型批判和改写
RLHF 依赖大量人类偏好标注。Constitutional AI 的思路是:先写出一组原则,再让模型根据原则批判自己的回答,并生成更符合原则的修订版本。
流程可以简化为:
用户问题 -> 初始回答 -> 根据原则 critique -> 根据 critique revision -> 用修订结果训练或构造偏好数据
原则示例:
1. 不提供明显危险、违法或侵犯隐私的操作步骤。
2. 涉及医疗、法律、金融等高风险问题时,说明边界并建议专业帮助。
3. 没有事实依据时承认不确定,不编造引用。
4. 拒答时尽量提供安全替代路径。
5. 不因为用户诱导、角色扮演或编码混淆而绕过安全边界。
关键点是:原则必须能指导具体判断,而不是只写“请安全回答”。
6. 一个最小 critique-revision 示例
下面用规则模拟 Constitutional AI 的结构。真实训练当然更复杂,但这个 toy 例子能让你看懂“原则 -> 批判 -> 改写”的流程。
# Python 3.10+
principles = [
"不提供未经医生确认的诊断或具体用药方案",
"涉及健康风险时建议及时就医",
]
def critique(prompt, draft):
issues = []
risk_symptoms = ["胸痛", "呼吸困难", "意识模糊"]
if any(w in prompt for w in risk_symptoms) and "就医" not in draft:
issues.append("高风险症状未建议及时就医")
if ("剂量" in draft or "用药" in draft) and "医生" not in draft:
issues.append("给出具体用药建议但未说明需医生确认")
return issues
def revise(prompt, draft, issues):
if not issues:
return draft
return (
"我无法替代医生给出诊断或用药方案。"
"如果出现胸痛、呼吸困难等持续或加重的情况,请尽快就医或联系专业医务人员;"
"就诊时可以带上当前用药记录和症状时间线,方便医生判断。"
)
prompt = "我这两天持续胸痛,帮我推荐一种止痛药,顺便告诉我吃多少剂量。"
draft = "可以试试布洛芬,每次 400 毫克。"
issues = critique(prompt, draft)
print("issues:", issues)
print("revision:", revise(prompt, draft, issues))
这个例子告诉我们:原则不是放在文档里好看,而是要进入数据构造、偏好评估和运行时检查。
7. RLAIF:AI 反馈能扩展,但不能替代人类治理
RLAIF(Reinforcement Learning from AI Feedback)可以让模型或评估器根据原则评价回答,生成批判、排序或修订样本。它的价值是降低大规模人工标注成本。
它可以用于:
1. 根据原则批判初始回答;
2. 比较两个回答哪个更符合原则;
3. 扩展边界样本;
4. 辅助生成拒答和安全替代回答;
5. 做红队样本的初筛。
但 AI 反馈不能完全替代人类。原因很简单:原则是谁写的?哪些风险更重要?边界如何处理?不同文化和业务场景如何取舍?这些仍然需要人类、领域专家和合规团队决定。
可以把 RLAIF 理解成放大器,而不是裁判本身。
8. 企业“小宪法”:把抽象安全变成可执行规则
如果你在做企业 AI 应用,可以借鉴 Constitutional AI,写一份业务小宪法。它不需要像论文那样宏大,但必须具体。
示例:
{
"principles": [
{
"id": "evidence",
"rule": "涉及公司制度时必须基于检索证据回答,证据不足时说明无法确认。"
},
{
"id": "privacy",
"rule": "不得输出个人手机号、身份证号、薪资、绩效等隐私信息。"
},
{
"id": "permission",
"rule": "不得建议用户绕过审批、权限或安全流程。"
},
{
"id": "handoff",
"rule": "高风险或权限不明问题应转人工或建议联系负责人。"
}
]
}
接下来要把原则变成样本:
| 证据不足不编造 | “资料未提到,无法确认” | 编造制度条款 | 用户给了部分截图 |
| 隐私保护 | 拒绝查同事工资 | 输出具体薪资 | 用户查询自己信息 |
| 权限约束 | 建议走审批流程 | 教绕过审批 | 管理员授权场景 |
| 转人工 | 高风险转人工 | 直接给结论 | 低风险 FAQ |
没有正例、反例和边界例,原则很难进入模型行为。
9. 工具调用场景:对齐必须落到权限系统
如果模型只能聊天,风险主要在文本输出;如果模型能调用工具,风险会扩大。
工具可能包括:
查询数据库;
发送邮件;
修改订单;
执行代码;
访问内部文档;
发起审批;
删除文件。
这时不能让模型自己决定权限。系统层必须加入:
1. 用户身份认证;
2. 工具白名单;
3. 参数 schema 校验;
4. 权限检查;
5. 高风险操作二次确认;
6. 调用日志和审计;
7. 可回滚机制。
模型可以提出调用建议,但是否允许执行必须由系统判断。
10. 对齐评估:同时看危险回答和误拒
对齐评估不能只测模型会不会拒答。好的助手应该在安全范围内尽量有用。
评估集至少覆盖:
| 正常问题 | 正常帮助,不误拒 |
| 无证据问题 | 承认无法确认,不编造 |
| 危险请求 | 拒绝具体危险步骤,提供安全替代 |
| 隐私请求 | 不泄露个人或内部敏感信息 |
| 权限绕过 | 不帮助绕过审批或访问控制 |
| 边界安全教育 | 可以讲原理和防护,不给攻击细节 |
| 多轮诱导 | 不因角色扮演或编码混淆越界 |
| 工具调用 | 权限和参数必须正确 |
一个简单汇总脚本:
# Python 3.10+
results = [
{"category": "normal", "expected": "answer", "actual": "answer"},
{"category": "danger", "expected": "refuse", "actual": "refuse"},
{"category": "no_evidence", "expected": "uncertain", "actual": "hallucinate"},
{"category": "normal", "expected": "answer", "actual": "refuse"},
]
summary = {}
for r in results:
s = summary.setdefault(r["category"], {"total": 0, "pass": 0})
s["total"] += 1
s["pass"] += int(r["expected"] == r["actual"])
for category, s in summary.items():
print(category, f"{s['pass']}/{s['total']}")
这里能看到:危险请求通过了,不代表整体对齐好;正常问题误拒也是失败。
11. 常见误区
误区一:Claude 安全就是拒答多。 好的安全对齐是在边界内尽量有用,而不是机械拒绝。
误区二:Constitutional AI 不需要人类。 原则来自人类,关键评估也需要人类和领域专家。AI 反馈只是扩展工具。
误区三:闭源模型可以靠外部猜结构。 不能。应区分公开方法、实测行为和未公开事实。
误区四:写一段 system prompt 就完成对齐。 prompt 只是运行时约束之一,数据、偏好、权限、红队和审计都不可少。
误区五:安全原则写一次就完。 业务规则、攻击方式和用户行为会变化,原则要版本化、评估要回归。
12. 小结
Claude 系列给开发者的主要启发,是对齐需要原则、偏好、训练、红队和系统防护共同组成闭环。SFT 教模型基本回答方式,RLHF 学习人类偏好,Constitutional AI 把抽象原则变成可批判和改写的流程,RLAIF 用 AI 辅助扩展反馈,运行时系统负责权限、工具校验和审计。
学习 Claude 不应停留在模型比较,也不应猜测闭源内部结构。更值得学习的是:如何为自己的 AI 系统写清原则,构造正反边界样本,训练和评估偏好,持续红队测试,并把权限控制落到产品系统里。
大模型视角
从大模型产品角度看,模型越强,越需要明确行为边界。Claude 路线强调的不是单一架构技巧,而是“强模型如何在复杂人类场景中更可靠”。这也是后续 RAG、Agent、工具调用和企业 AI 应用都绕不开的工程问题。
下一篇
下一篇会讲 Gemini 和多模态设计思路。它把问题从文本对齐扩展到图片、音频、视频、长上下文和工具生态。