每年双 11 大促备战阶段,全链路压力测试往往会产出一份长达数十页的性能汇总报表。在很多团队的汇报 PPT 里,大屏幕上经常展示着令人心旷神怡的折线图:平均响应时间(Average Latency)平稳地贴在 85 毫秒的低位,甚至连 P90 延迟都稳定在 150 毫秒以内。技术负责人往往很容易在此刻长舒一口气,判定“系统容量已经完全满足大促 SLA”。
然而,在大模型与多智能体(Multi-Agent)深度介入的生产架构中,迷信平均值或者粗糙的百分位数,是导致线上大面积翻车的最大麻醉剂。
在随后的破坏性演练中,我们经常捕获到真实的业务投诉:线上明明平均时延很低,但客服后台却不断收到高价值 VIP 用户的投诉,称其在发起某个多轮复杂对话或商品智能导购时,界面卡死整整 12 秒没有响应。调出全链路分布式追踪(Distributed Tracing)一查,现场令人背脊发凉:在几百万个看似平稳的请求背后,有大约 0.8% 的请求遭遇了长达 8 到 15 秒的极端长尾延迟!
在大模型 Agent 协作链条中,一个顶层任务通常由 4 到 6 个子 Agent 并行检索或串行反思组成。根据概率论中的独立事件乘法原理:
$$P_{failure} = 1 – (1 – 0.008)^5 \\approx 3.94%$$
这意味着,仅仅 0.8% 的微观单点离群点,在链路级联放大后,会让整整近 4% 的终端用户遭遇彻底的服务瘫痪!在大促千万级日活冲击下,这意味着成千上万个高净值订单的直接流失。
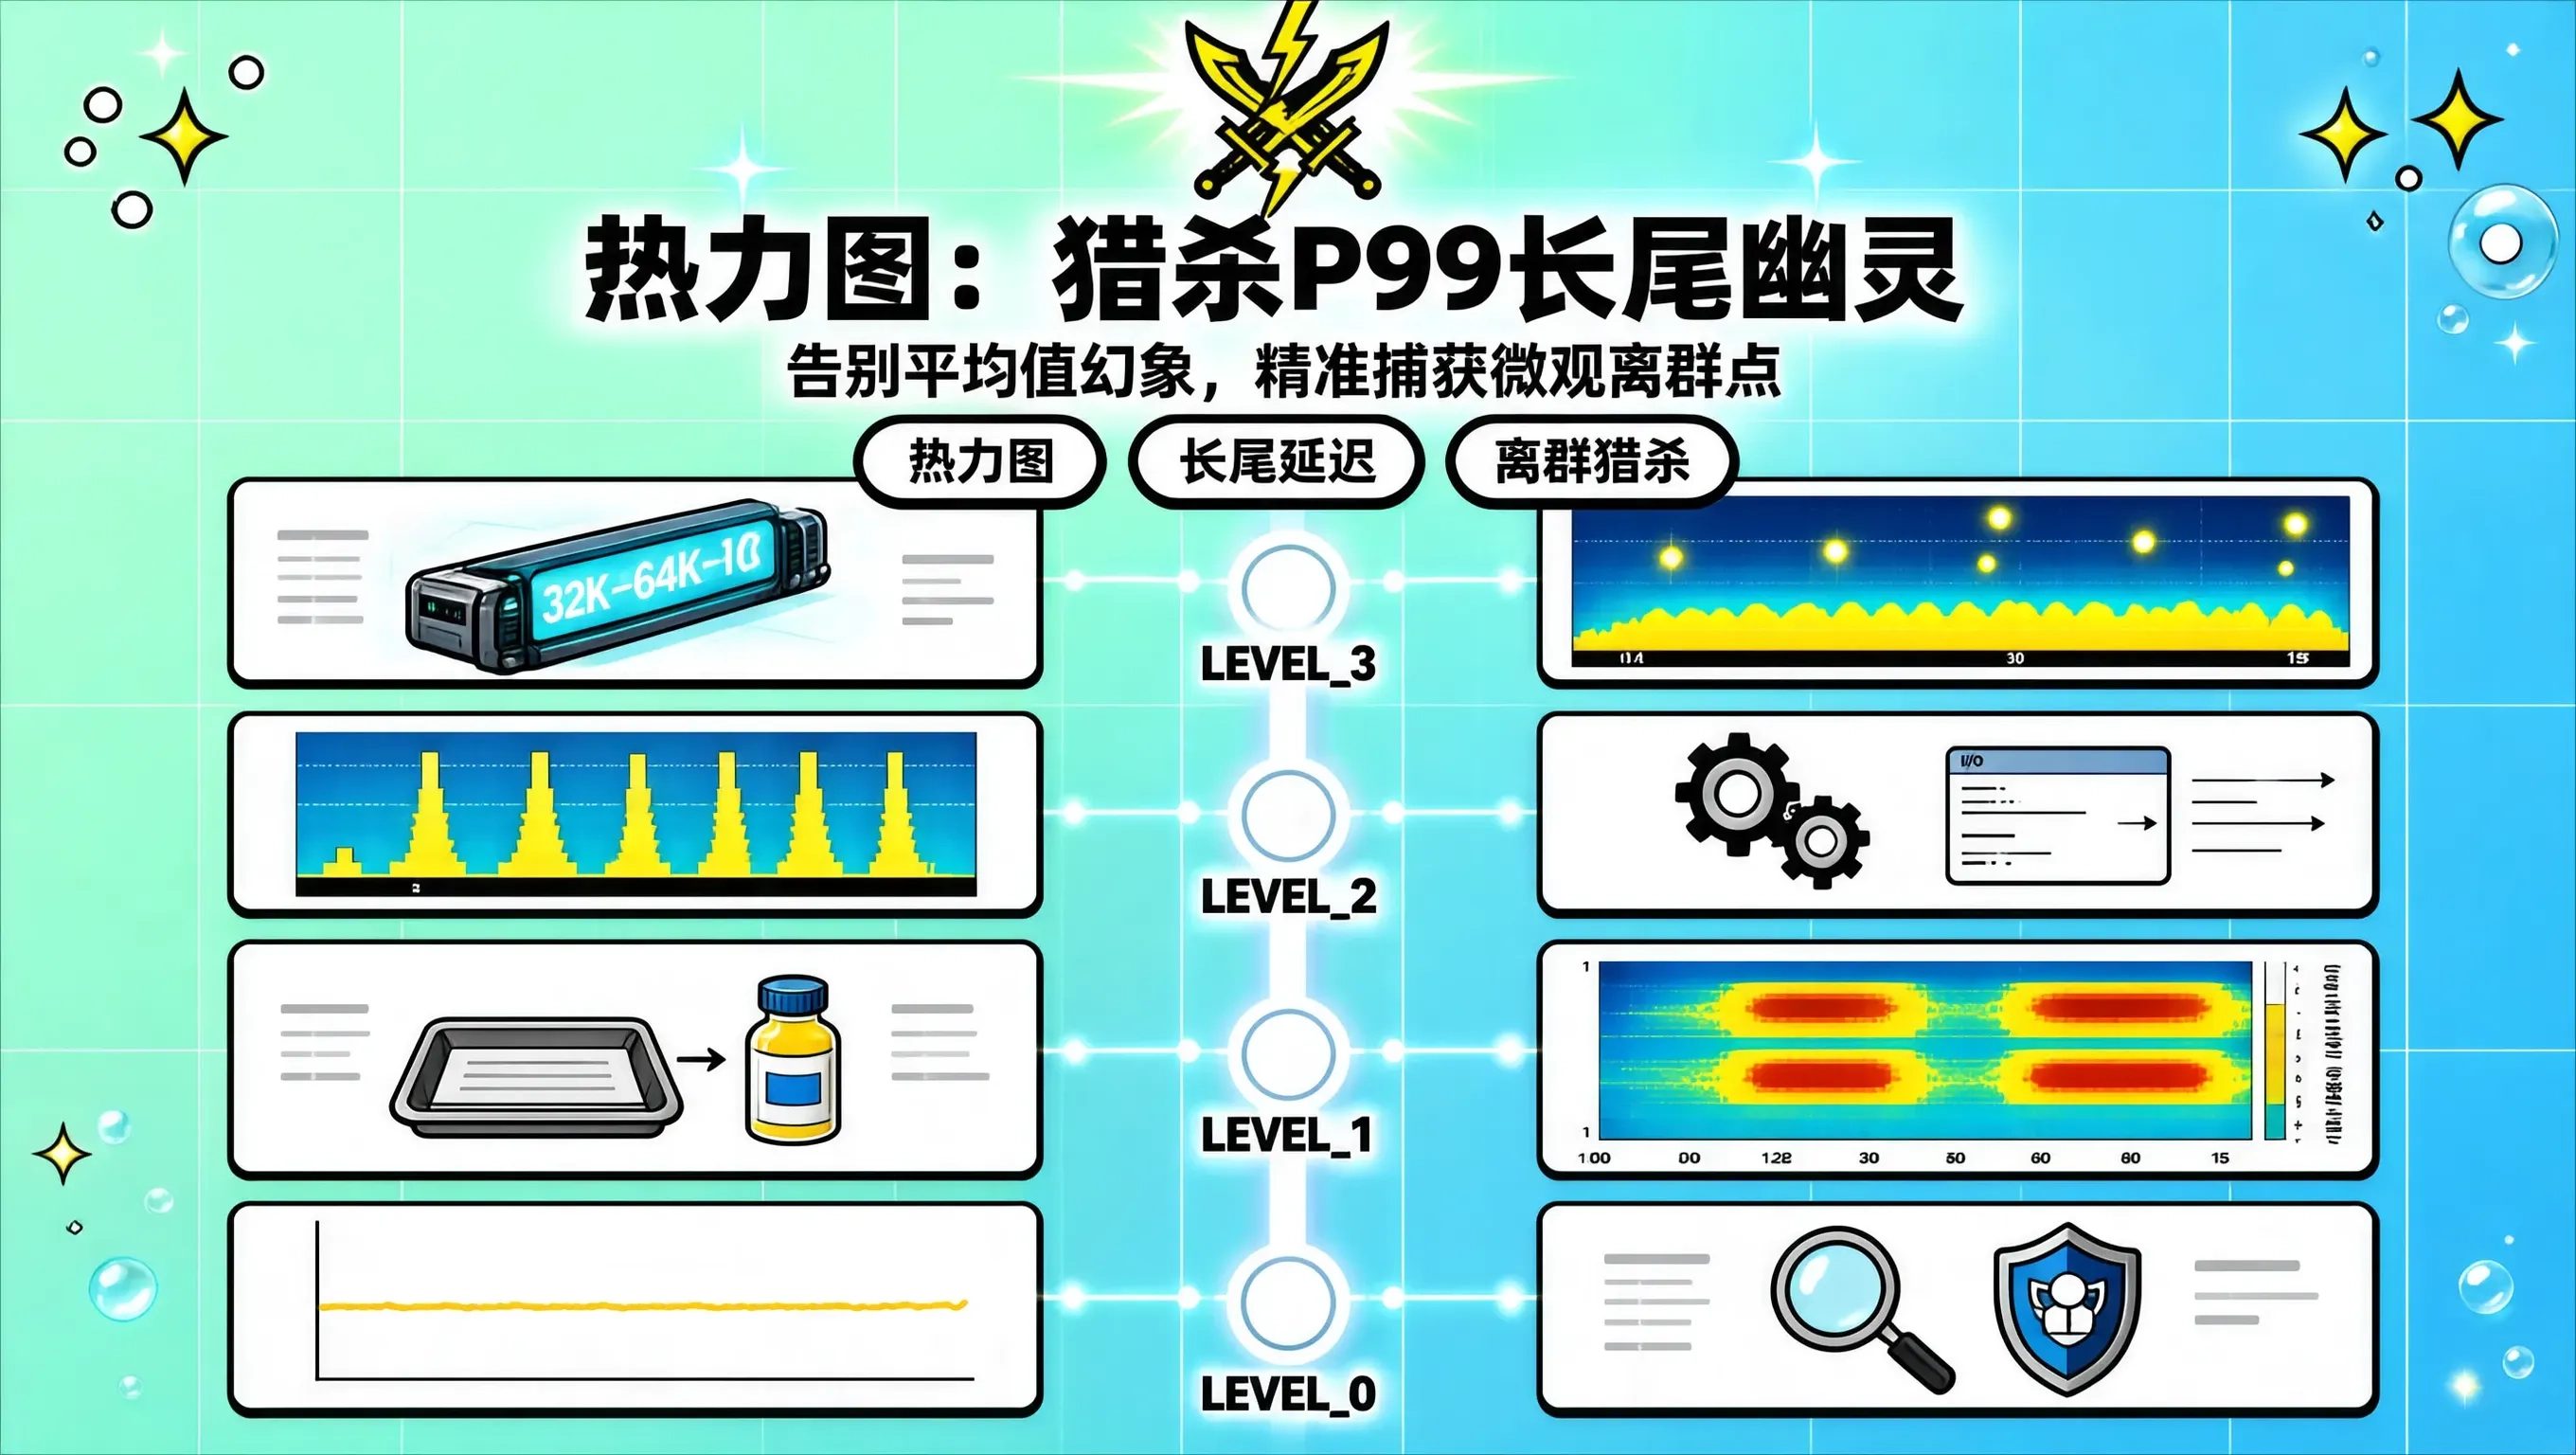
传统的平均值折线图彻底抹平并掩盖了这片致命的长尾。要看清真相,必须借助 高精度端到端延迟热力图(Latency Heatmap),将微观世界的离群点纤毫毕现地暴露在阳光之下。
折线图的虚假平静 vs 延迟热力图的离群原形
传统折线图视图 (平均值彻底掩盖长尾)
延迟
80ms │──────────────────────────────── (看起来极其平稳完美!)
└────────────────────────────────► 时间
延迟热力图视图 (高分辨率 2D 分布热力矩阵)
延迟
15s │ * * ** * * (极度危险的离群悬浮星云!长尾请求卡死 15 秒!)
│
800ms│ ══════════════════════ (第二高发区: Cache Miss 慢分支,双峰分布暴露)
│
20ms │ ▓▓▓▓▓▓▓▓▓▓▓▓▓▓▓▓▓▓▓▓▓▓ (第一高发区: Cache Hit 快分支)
└────────────────────────────────► 时间
1. 为什么传统监控图表看不见“离群点”
很多工程师感到困惑:“我明明在 Grafana 上配了 P99 曲线,为什么还是漏掉了这些慢请求?”
原因在于传统时序数据库与图表组件的数据聚合机制:
延迟热力图(Heatmap)则完全不同:它的横轴是时间,纵轴是采用对数刻度(Logarithmic Scale)细分的高度密集的时延分段(Buckets),颜色的深浅代表该时延段落内的请求发生频次。它不做任何有损的平均化,哪怕在 10 万个请求里只有 1 个请求耗时 12 秒,在热力图顶部的空白深色背景上,也会像黑夜中的萤火虫一样,清晰浮现出一颗亮白色的离群孤点。
2. 深度剖析:热力图呈现的三大经典病态模式
在长达两周的双 11 全链路压测中,通过延迟热力图,我们成功破获并根治了潜伏在推理系统内部的三大幽灵病灶:
病态一:上下平行的“双峰分布(Bimodal Distribution)”
热力图表征:系统在同一时间段内,没有呈现单条平稳的光带,而是清晰地分裂出上下两条平行的高亮横轴——一条集中在极低的 18 毫秒,另一条集中在较高的 750 毫秒。
病灶根因定位:这直接印证了推理引擎底层的 前缀缓存(Prefix Caching)命中率撕裂。处于 18 毫秒下光带的请求,其输入 Prompt 命中了已有的共享 System Prompt KV Cache,直接跳过了耗时的 Prefill 预填充阶段;而处于 750 毫秒上光带的请求,由于客户端输入的 Prompt 头部带有微小的随机时间戳或用户 ID,导致前缀哈希全量失效,被迫从头执行全量矩阵乘法。工程治理解法:在 API 网关层推进 Prompt 结构化对齐规范,将动态用户变量强制移入末尾,前置静态系统指令,直接将 Prefix Caching 命中率拉升至 92%,上层慢光带彻底消融。
病态二:规律性纵向突刺的“梳状形态(Comb Pattern)”
热力图表征:平缓的光带上,每隔严格的固定时间(例如整整 60 秒),就会像梳子的牙齿一样,垂直向上窜出一条贯穿整个纵轴的细细高亮光柱。
病灶根因定位:这典型的时序确定性,立刻锁定了后台定时任务或垃圾回收对底层 I/O 的瞬时霸占。深入排查发现,某中间件 Agent 每隔 60 秒在本地执行一次全量 metrics 序列化落盘,瞬间打满本地磁盘队列,导致同机运行的推理容器在读取权重共享内存时遭遇微秒级等待。工程治理解法:将所有运维 Agent 的落盘日志由同步刷盘改为基于内存环形队列的异步流式上报,彻底消除了周期性梳状突刺。
病态三:悬浮在右上角的“孤立星云(Floating Clusters)”
热力图表征:绝大部分请求集中在 100 毫秒以内,但在热力图最顶部的 8 到 15 秒高延迟区域,漂浮着一团稀疏却持续存在的斑点。
病灶根因定位:通过与分布式链路跟踪(OpenTelemetry Trace)结合,提取这些离群斑点的 TraceID,真相大白:这些请求是由于外部爬虫或者异常调试账号,频繁提交高达 32K 到 64K 超长上下文(Extreme Context) 的复杂任务。一个超长请求霸占了多达 40 个连续显存块,将整个并行组的计算节拍全部拖慢。
3. 生产级 Prometheus 热力图配置实操
要绘制出具备工业级穿透力的高分辨率热力图,必须在 Prometheus 客户端精细规划 Histogram 的 Bucket 分布,并在 Grafana 中精准呈现:
步骤一:在推理网关中注入非线性对数 Bucket
package metrics
import (
"github.com/prometheus/client_golang/prometheus"
)
var (
// RequestLatencyHeatmapBuckets 专为大模型端到端时延定制的非线性对数桶 (单位: 秒)
// 在 10ms 到 200ms 的快区、以及 2s 到 15s 的慢区分别提供高密度分辨率
RequestLatencyHeatmapBuckets = []float64{
0.01, 0.02, 0.03, 0.05, 0.08, 0.12, 0.18, 0.25, 0.35, 0.5,
0.75, 1.0, 1.5, 2.0, 3.0, 4.5, 6.0, 8.0, 10.0, 15.0, 20.0,
}
EndToEndLatencyHistogram = prometheus.NewHistogramVec(
prometheus.HistogramOpts{
Namespace: "ai_inference",
Subsystem: "gateway",
Name: "e2e_request_duration_seconds",
Help: "大模型端到端全链路耗时分布高分辨率直方图",
Buckets: RequestLatencyHeatmapBuckets,
},
[]string{"model_id", "route_type"},
)
)
步骤二:Grafana 热力图 PromQL 查询
在 Grafana Panel 中选用 Heatmap 图表组件,配置如下 PromQL 查询(注意必须使用 rate 配合 [1m] 小步长,并按照 le 标签聚类):
sum(rate(ai_inference_gateway_e2e_request_duration_seconds_bucket{model_id="DeepSeek-V4-Pro"}[1m])) by (le)
在 Display 设置中,Color Scheme 选择 Spectral 或 Inferno,Y-Axis 开启 Logarithmic (base 2)。如此一来,整套集群的微观性能脉动,化作一幅能够实时洞察每一丝裂痕的动态画卷。
4. 架构师的一线避坑铁律
在应用高分辨率热力图监控时,有两个严重的性能反噬陷阱必须高度警惕:
没有清晰的度量,就没有精准的治理。通过用高分辨率延迟热力图取代麻痹人心的平均值报表,我们把大模型分布式系统中每一个隐秘的死锁、每一次缓存的失真、每一波长尾的侵蚀全部精准捞出,在大促洪峰来临前为全网核心业务排尽了最后一颗暗雷。