网络通信这事,说到底就是两台机器隔着千山万水递数据。可数据怎么递、递给谁、递得靠不靠得住,光靠嘴说没用,得有一套实实在在的编程接口来落地。
本文就从网络通信的本质出发,把TCP和UDP这两兄弟的脾气先掰扯清楚,一个稳字当头,一个快字优先,各有各的活法。接着系统梳理Socket编程里最常用的那套API,再顺手把sockaddr这些核心数据结构拆开看,弄明白它们到底在背后管着什么。一层一层往下走,帮你在脑子里搭出一套完整的Socket编程知识体系,往后写网络程序,心里不慌。
目录
一、端口号的底层实现原理补充
1.1 端口号与进程之间的关联机制
1.1.1 基于哈希表的底层查找
1.2 接收数据如何交付给目标进程
1.2.1 从Linux“一切皆文件”理解Socket的使用方式
二、Socket编程基础:从通信本质到传输层接口
2.1 理解Socket与网络通信的本质
2.1.1 Socket的标识作用与进程间通信
2.1.2 什么是Socket
2.2 应用程序如何使用传输层服务
2.2.1 传输层相关系统调用
2.3 TCP与UDP:两种典型的传输层协议
2.3.1 TCP协议(Transmission Control Protocol)
2.3.2 UDP协议(User Datagram Protocol)
三、网络字节序与主机字节序
3.1 字节序的基本概念
3.1.1 大端序与小端序
3.2 TCP/IP网络通信中的字节序规定
3.3 字节序转换API:从主机序到网络序
3.3.1 函数命名规范与参数含义
四、Socket常用接口与网络地址结构
4.1 Socket编程常用API
4.1.1 核心API的功能与用途
4.2 网络地址结构:sockaddr家族
4.2.1 sockaddr:通用地址结构
4.2.2 sockaddr_in:IPv4地址结构
4.2.3 in_addr:IPv4地址字段结构
4.3 sockaddr的统一设计:从接口抽象到协议扩展
4.3.1 sockaddr与sockaddr_in的结构对比
4.3.2 系统底层如何根据地址族进行处理
4.3.3 从统一接口理解多态思想与协议家族扩展
一、端口号的底层实现原理补充
1.1 端口号与进程之间的关联机制
1.1.1 基于哈希表的底层查找
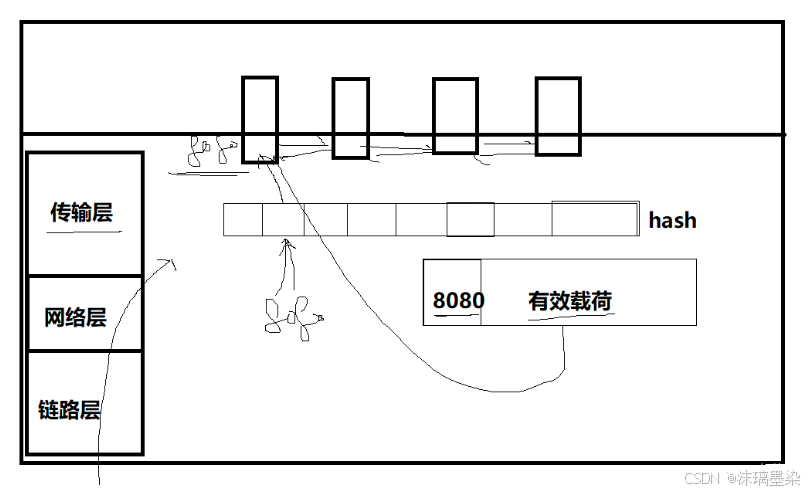
数据从网络传入,一路穿过链路层、网络层,来到传输层,层层解包。到了这一层,内核拿到报头里的端口号,比如8080,转身就去一张内核维护的哈希表里查。
这张表不是普通的数组,而是链式哈希结构:每个哈希桶挂一条链表,专门用来管理连接。进程创建并绑定端口的那一刻,系统就已经把它的PCB按端口号挂进了对应的哈希桶里。于是,端口号一索引,顺着链表一摸,立刻就能定位到对应的PCB。
数据该交给谁,瞬间有了答案。平均O(1)的查找效率,让端口到进程的映射快得几乎无感。这就是传输层能在海量连接中精准投递的底层底气。
1.2 接收数据如何交付给目标进程
1.2.1 从Linux“一切皆文件”理解Socket的使用方式
Linux的设计哲学里,有一句人尽皆知的话:一切皆文件。Socket也不例外。在内核眼里,它就是一个文件,带着一块属于自己的内核缓冲区。
数据交付:内核根据端口号,顺藤摸瓜找到目标进程的PCB,然后把解包得到的有效载荷,直接拷贝进这个Socket对应的内核缓冲区里。
上层读取:应用程序通过文件描述符去读那块缓冲区,网络那头千里迢迢送来的数据,就这么安安静静地躺在那儿,等着被取走。
二、Socket编程基础:从通信本质到传输层接口
2.1 理解Socket与网络通信的本质
2.1.1 Socket的标识作用与进程间通信
-
IP 地址:在互联网中唯一标识一台主机。
-
端口号(Port):在一台主机上唯一标识一个网络进程。
-
IP + Port:两者一组合,就能在互联网里精确定位到某个特定进程。
网络通信,说到底,就是两个互联网进程代表各自用户,隔着网络交互。通信双方由{srcIp, srcPort, dstIp, dstPort}这个四元组唯一标识,源IP、源端口、目的IP、目的端口,四个坐标一定,整条连接就锁死了。
所以,网络通信的本质,就是跨主机的进程间通信。而Socket,就是这套通信在编程层面的抓手。
2.1.2 什么是Socket
把IP和Port拼在一起,就是所谓的套接字(Socket)。
Socket这个词,字面意思就是“插座”或者“插口”。放在网络编程的语境里,它还真就是个插座,应用程序只要往这个接口上一“插”,就接进了网络通信的世界。
套接字分两种:网络套接字和本地套接字。我们这里只聊网络套接字。网络这套搞明白了,本地套接字自然也就通了。
2.2 应用程序如何使用传输层服务
2.2.1 传输层相关系统调用
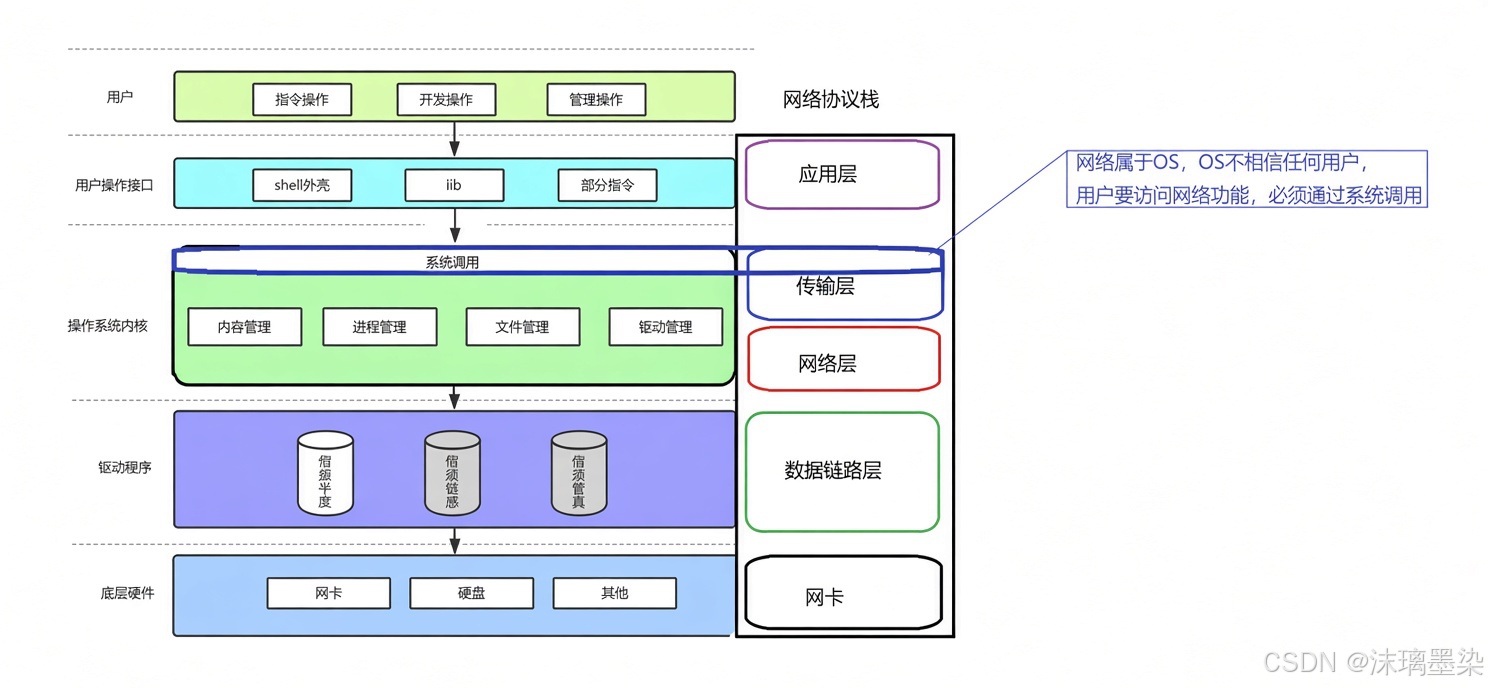
传输层,本身就是操作系统内核的一部分。它不是什么外挂模块,而是长在内核里的器官。
搞懂了操作系统和网络协议栈的关系,一件事就顺理成章了:想通过网络协议栈通信,就必须走传输层提供的系统调用接口。这是唯一的路,没有旁门左道。应用程序再上层,也得老老实实从这儿过。
2.3 TCP与UDP:两种典型的传输层协议
2.3.1 TCP协议(Transmission Control Protocol)
TCP,传输控制协议,几个关键特性得先记住:
-
传输层协议:工作在网络模型的传输层。
-
有连接:通信之前,双方必须先建立连接。你可以先粗暴地理解成——打电话,你“喂”我“喂”,聊上了,连接才算通。
-
可靠传输:带确认、带重传,保证数据准确无误地送到对面。
-
面向字节流:数据以无边界的字节流形式传输。就像水龙头接水,一拧开,水哗哗地流,你分不出哪一滴是哪一滴。
-
顺便说一句,文件流和面向字节流,本质上没太大区别,只是表述角度不同而已。
2.3.2 UDP协议(User Datagram Protocol)
UDP,用户数据报协议,性格跟TCP截然不同:
-
传输层协议:同样工作在传输层。
-
无连接:发数据前不用打招呼,抄起来就发。
-
不可靠传输:尽力而为,送到算数,丢了、乱了,概不负责。
-
面向数据报:以独立的数据报文为单位传输,数据边界保留得清清楚楚。收发快递,一个包裹就是一个包裹,不会混在一起。
当然,这俩肯定不是三言两语就能讲完的。TCP和UDP的详细拆解,后面会专门开篇。眼下最要紧的,是先建立概念,然后立刻动手,写出我们的第一个服务器代码。
最后补一句:可靠和不可靠,都是中性词。可靠能做更多事,但也更复杂;不可靠简单粗暴,但自有其用武之地。TCP和UDP,各自奔赴不同的应用场景,不能一概而论。这个认知先揣着,后面再深究。
三、网络字节序与主机字节序
3.1 字节序的基本概念
3.1.1 大端序与小端序
内存和磁盘文件里,多字节数据都面临一个绕不开的问题:字节到底按什么顺序排列?于是就有了大端(big-endian)和小端(little-endian)之分。
先看一个例子。假设有一个32位的整数0x12345678,它占四个字节:
大端序:高位字节放在低地址,低位字节放在高地址。内存里从低到高依次是:12 34 56 78。
小端序:低位字节放在低地址,高位字节放在高地址。内存里从低到高依次是:78 56 34 12。
同一个数,两种排法,顺序完全反过来。大端像人类读数字,从左到右,高位在前,符合阅读习惯;小端则是反着来,最低位在开头。x86架构的机器大多用小端,而部分RISC架构(如早期的 SPARC)则偏爱大端。
网络数据流,同样需要一套明确的字节存储与传输顺序,否则两边理解不一致,数据就乱了。规则是这样的:
-
发送端:通常把发送缓冲区里的数据,按内存地址从低到高的顺序发出去。
-
接收端:把从网络上收到的字节,依次保存到接收缓冲区里,同样按内存地址从低到高的顺序存。
-
网络数据流的规定:先发出的数据放在低地址,后发出的数据放在高地址。
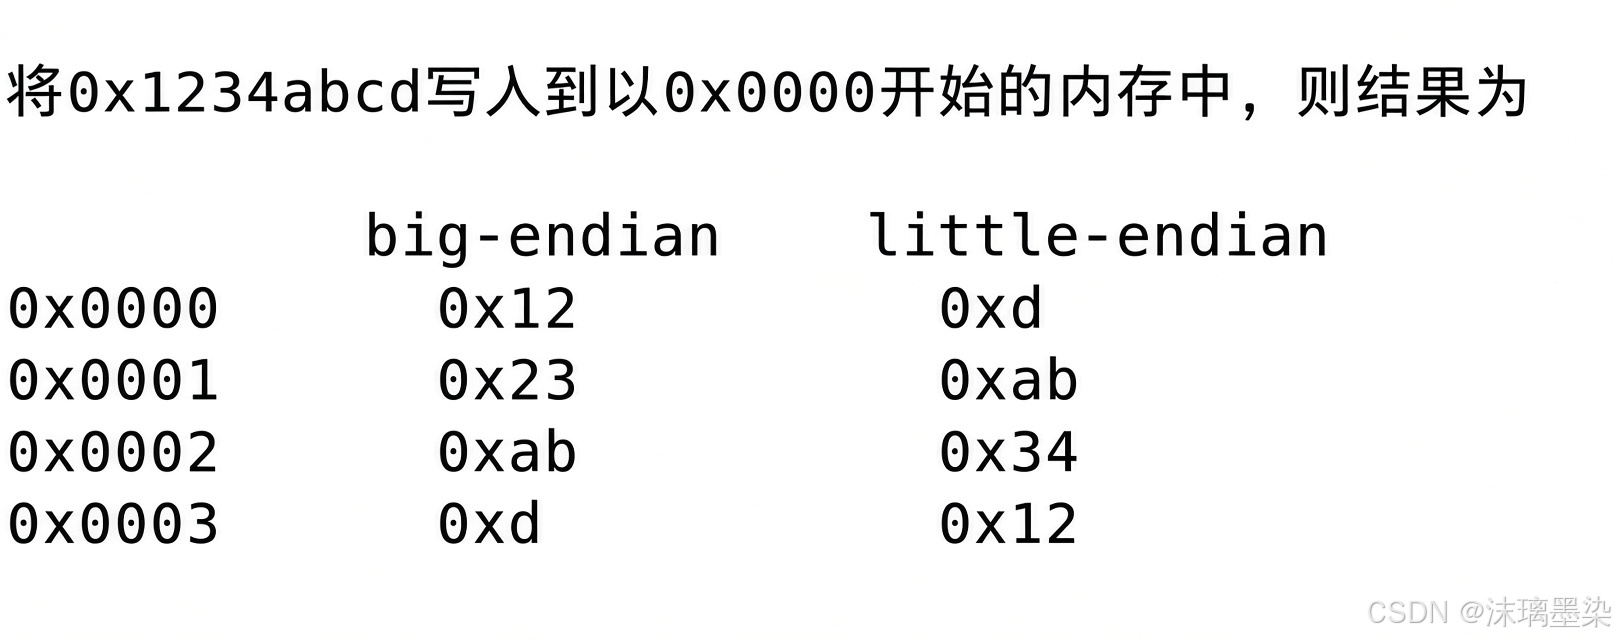
那么问题来了:网络字节序,到底定的是大端还是小端?
答案是:大端。
TCP/IP 协议族明确规定,网络字节序采用大端序。也就是说,不管你的主机本身是大端还是小端,数据一旦上网,统统得转成大端。
为什么一定要规定大端?
目前其实没有一个放之四海皆准的合理解释。有一种流传较广的说法是:大端更符合人类的阅读习惯。我们平时写数字,从左到右就是高位在前,123就是一百二十三,先读到的“1”代表百位。网络数据按大端传输,人对着抓包工具看的时候,数字顺序跟日常书写一致,调试起来也顺眼些。
当然,这只是个偏“人性化”的猜测。真正的原因,或许要追溯到早期网络协议设计时的历史选择,一旦定下来,后来的人就都跟着走了。标准这东西,有时未必是“最优解”胜出,而是“先定下来的那个”胜出。
3.2 TCP/IP网络通信中的字节序规定
TCP/IP协议把话撂在这儿了:网络数据流,一律采用大端字节序。 低地址存高字节,这就是数据上网时的“官方语言”。
强制要求,没有商量余地,只要数据要发到网络上,就必须是大端。
至于主机本身是大端还是小端,网络不管。你只需要知道:
-
小端机:发之前,先把数据转成大端,再送出去。
-
大端机:什么都不用动,直接发。
主机内部怎么存,是你自己的事;一旦上网,就得说大端这门“普通话”。这样,不同架构的机器碰在一起,数据才能对得上号,不会鸡同鸭讲。
3.3 字节序转换API:从主机序到网络序
网络编程要保证可移植性,同一份C代码,不管在大端机还是小端机上编译,都得跑得起来。为此,头文件<arpa/inet.h>提供了一组转换API:
#include <arpa/inet.h>
uint32_t htonl(uint32_t hostlong); // 32 位:主机序 → 网络序
uint16_t htons(uint16_t hostshort); // 16 位:主机序 → 网络序
uint32_t ntohl(uint32_t netlong); // 32 位:网络序 → 主机序
uint16_t ntohs(uint16_t netshort); // 16 位:网络序 → 主机序
行为很干脆:
-
主机是小端,这些函数就把参数翻个个儿,转成大端再返回。
-
主机是大端,什么都不做,原封不动把参数还给你。
3.3.1 函数命名规范与参数含义
四个函数名看着像乱码,其实拆开一看就懂:
- h:host,主机字节序。
- n:network,网络字节序。
- l:long,32位长整数,常用于IP地址转换。
- s:short,16位短整数,常用于端口号转换。
串起来读,htonl就是“主机序转网络序,处理32位数”,ntohs就是“网络序转主机序,处理16位数”。名字本身就是说明书,念一遍就知道它是干嘛的。
一个小规律:h打头的,是主机转网络;n打头的,是网络转主机。l结尾的管32位,s结尾的管16位。 记住这个口诀,四个函数就再也不会搞混了。
四、Socket常用接口与网络地址结构
4.1 Socket编程常用API
Socket API,是系统层递给我们的一套抽象网络编程接口。它把底层那些复杂的协议细节统统藏起来,只留几个简单函数,让我们能像打电话一样,两台机器说连就连上。
常用的核心函数,就这么几个:
// 创建 socket 文件描述符(TCP/UDP,客户端和服务器都要用)
int socket(int domain, int type, int protocol);
// 绑定端口号(TCP/UDP,服务器端)
int bind(int socket, const struct sockaddr *address, socklen_t address_len);
// 开始监听 socket(TCP,服务器端)
int listen(int socket, int backlog);
// 接收请求(TCP,服务器端)
int accept(int socket, struct sockaddr* address, socklen_t* address_len);
// 建立连接(TCP,客户端)
int connect(int sockfd, const struct sockaddr *addr, socklen_t addrlen);
这几个函数,各有各的戏份。
socket是起点,相当于先买一台电话机,没有它,后面什么都别谈。bind是给电话机报装一个固定号码,别人才能打进来。listen是开机候客,告诉系统“我这个号码随时可以接听”。accept是电话铃响了,接起来,跟对方建立通话。至于connect,那是客户端的动作,拿起电话,拨号,主动呼叫对方。
4.1.1 核心API的功能与用途
-
socket:创建套接字,返回一个文件描述符。这是所有网络通信的起点,没有它,后面的一切都无从谈起。
-
bind:把套接字和指定的本地地址(IP + 端口)绑在一起。服务器端靠它“挂上号”,客户端才知道该往哪儿打。
-
listen:把套接字切到监听模式,摆好姿势,等着客户端上门。TCP服务器端的专属动作。
-
accept:阻塞等待,直到有客户端来敲门。一旦接住,就返回一个全新的套接字,专门负责跟这个客户端后续的通信。同样是TCP服务器端的活儿。
-
connect:客户端主动出击,向指定的服务器发起连接请求。TCP客户端只有这一个动作,但缺了它,连接就建不起来。
4.2 网络地址结构:sockaddr家族
Socket API是一层抽象出来的网络编程接口,它不挑底层协议,IPv4、IPv6,甚至后面要讲的 UNIX Domain Socket,都能往上套。可问题来了:各种网络协议的地址格式,压根不一样。
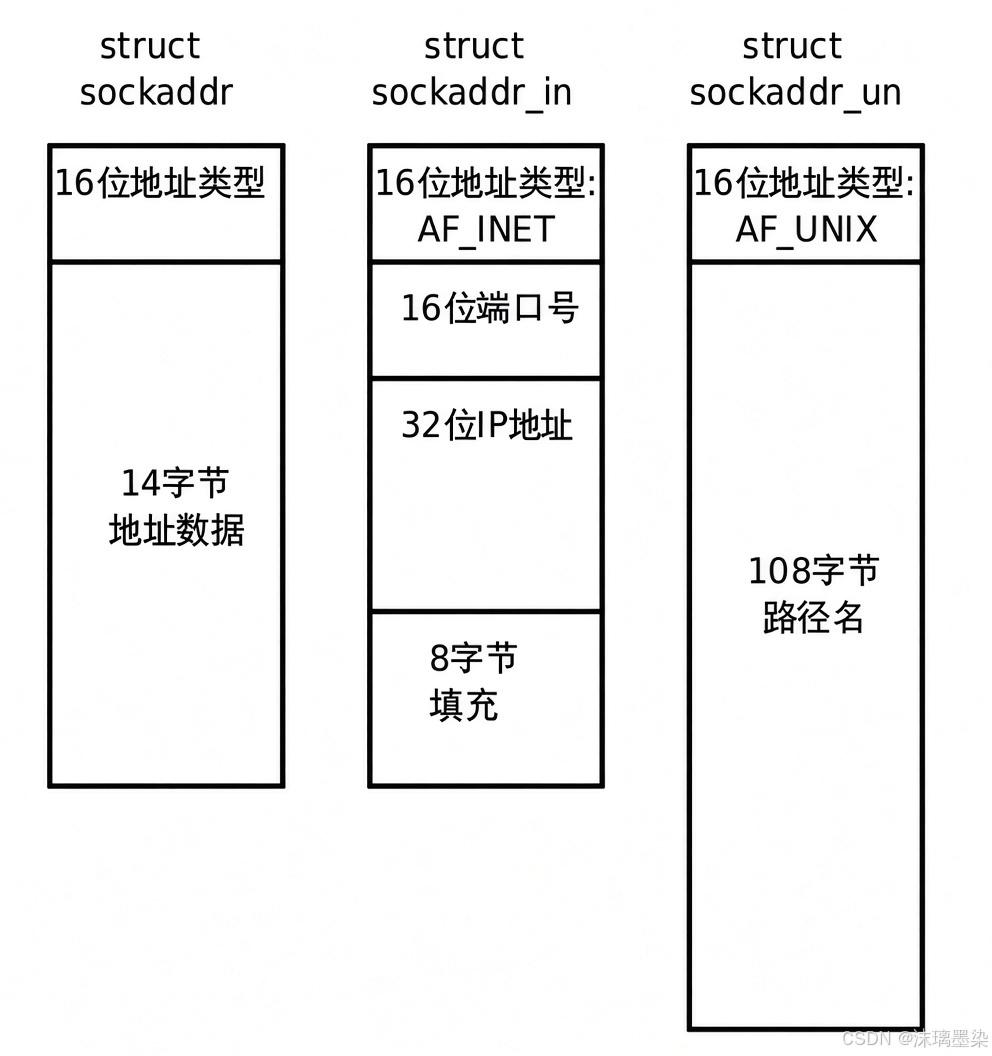
IPv4和IPv6的地址格式,定义在<netinet/in.h>里。IPv4地址用sockaddr_in结构体表示,里面装着16位地址类型、16位端口号,再加32位IP地址。
IPv4和IPv6的地址类型,分别用常量AF_INET、AF_INET6标记。这样一来,只要拿到某个sockaddr结构体的首地址,哪怕不知道它具体是哪一种,看一眼地址类型字段,就能推断出结构体里装的是什么内容。
Socket API统一用struct sockaddr *类型来表示地址参数。用的时候,强制转成sockaddr_in就行。这么做的好处,是程序通用性拉满,同一个接口,既能收IPv4,又能收IPv6,还能收UNIX Domain Socket,各种类型的sockaddr指针来者不拒。
4.2.1 sockaddr:通用地址结构
sockaddr是所有地址结构的“祖宗”,定义在<sys/socket.h>里:
struct sockaddr {
sa_family_t sa_family; // 地址家族,2 字节
char sa_data[14]; // 地址数据,14 字节
};
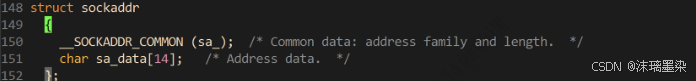
就两个字段,简单得有点寒酸。
sa_family:地址家族,用来标识这是哪种协议的地址。IPv4是AF_INET,IPv6是AF_INET6,UNIX Domain Socket是AF_UNIX。它就像一张标签,告诉系统“后面那串数据该怎么解读”。
sa_data:地址数据,14个字节的通用缓冲区。具体存什么,取决于sa_family的值。IPv4的话,里面塞的是IP地址和端口号;换了别的协议,内容就完全不一样了。
这个结构体,说白了就是个“通用信封”。它只保证两件事:信封上有个标签(sa_family),里面有个能装14字节的袋子(sa_data)。至于袋子里具体装什么,得看标签怎么写。
问题是,14个字节对IPv4来说刚刚好,可对IPv6来说就不够用了。所以sockaddr本身几乎不会直接使用,它更像一个抽象基类,真正的活儿都交给具体的派生结构去干。IPv4有sockaddr_in,IPv6有sockaddr_in6,UNIX Domain Socket有sockaddr_un。它们各自定义自己需要的字段,但首字段都是sa_family,这样才能跟sockaddr无缝互转。
这就是为什么Socket API统一用struct sockaddr *接收地址参数,不管传进来的是哪个具体结构,只要首字段是sa_family,系统就能认出它的类型,然后按对应格式去解读。一套接口,通吃所有协议,C语言的多态,在这儿体现得淋漓尽致。
4.2.2 sockaddr_in:IPv4地址结构
sockaddr_in是IPv4的专属地址结构,定义在<netinet/in.h>里:
struct sockaddr_in {
sa_family_t sin_family; // 地址家族,AF_INET
in_port_t sin_port; // 16 位端口号,网络字节序
struct in_addr sin_addr; // 32 位 IP 地址,网络字节序
char sin_zero[8]; // 填充字段,凑数用的
};
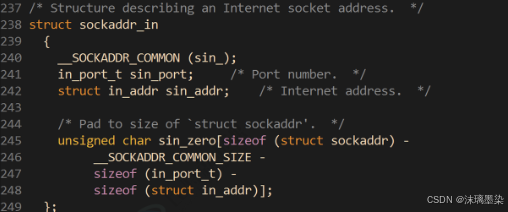
四个字段,各司其职。
sin_family:地址家族,固定填AF_INET。这就等于给这个结构体贴了个标签,“我是IPv4地址”。
sin_port:16位端口号。注意,它必须用网络字节序,也就是大端。所以你拿到端口号之后,得先 htons 转换一下再填进去。忘了转,端口号就会高低字节颠倒,连接死活建不起来。
sin_addr:32位IP地址,类型是struct in_addr。这个结构体更简单,就一个字段:
struct in_addr {
in_addr_t s_addr; // 32 位 IP 地址,网络字节序
};
同样,它也得是网络字节序。我们平时习惯的192.168.1.1是点分十进制字符串,塞进s_addr之前,得先用inet_pton或者inet_addr转成二进制大端格式。
sin_zero[8]:8个字节的填充,纯凑数。为啥要凑?因为sockaddr_in总共16字节,而通用的 sockaddr 结构里,sa_data也是14字节,加上sa_family的2字节,正好16。为了让两者大小一致,方便互相强转,sockaddr_in就补了8个字节的零。用的时候记得用memset清零,别让垃圾数据混进去。
跟sockaddr的关系
sockaddr_in和sockaddr大小一样,都是16字节,而且首字段都是sa_family。所以两者可以互相强转:
struct sockaddr_in addr;
// 填充 addr…
bind(sockfd, (struct sockaddr*)&addr, sizeof(addr));
一个容易踩的坑
sin_addr和sin_port都必须是网络字节序,但sin_family不用,它是给本机看的,主机字节序就行。很多人第一次写,把三个字段全转了,结果sin_family被转得面目全非,连接直接失败。记住:端口和IP转网络序,family不转。
4.2.3 in_addr:IPv4地址字段结构
sockaddr_in里那个sin_addr,类型是struct in_addr。它是IPv4地址在代码里的“真身”,专门用来装那32位IP地址。定义也在<netinet/in.h>里:
typedef uint32_t in_addr_t;
struct in_addr {
in_addr_t s_addr; // 32 位 IPv4 地址,网络字节序
};
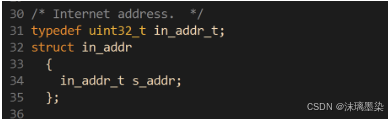
结构体简单到只有一个字段,但就这一个字段,装下了整个 IPv4 地址空间。
s_addr:32位整数,大端存放
s_addr本质上就是一个32位无符号整数,但这个整数不是随便存的,它必须是网络字节序,也就是大端。
我们平时写192.168.1.1,那是给人看的点分十进制字符串。它在内存里长什么样?四个字节,从左到右依次是192、168、1、1。而作为32位整数,大端序下高位字节在低地址,正好跟书写顺序一致。所以s_addr里存的,就是这四个字节按大端排好的二进制。
怎么把字符串塞进s_addr?
最常用的函数是inet_pton:
#include <arpa/inet.h>
struct in_addr addr;
inet_pton(AF_INET, "192.168.1.1", &addr);
inet_pton会把点分十进制字符串转成二进制,并且自动按网络字节序填进addr。一步到位,不用再手动htonl。
老一点的写法是inet_addr:
struct in_addr addr;
addr.s_addr = inet_addr("192.168.1.1");
inet_addr直接返回网络字节序的32位整数,赋值给s_addr就行。但它有个坑:转换失败时返回INADDR_NONE,也就是255.255.255.255,没法区分“地址无效”和“真的就是广播地址”。所以新代码更推荐inet_pton。
反过来,想把s_addr变回字符串,用inet_ntop:
char buf[INET_ADDRSTRLEN];
inet_ntop(AF_INET, &addr, buf, sizeof(buf));
printf("%s\\n", buf); // 输出 192.168.1.1
几个特殊地址
系统预定义了几个常用的in_addr值:
- INADDR_ANY:0.0.0.0,表示“本机任意IP”。服务器bind的时候最常用它,意思是“不管哪个网卡来的连接,我都收”。
- INADDR_LOOPBACK:127.0.0.1,回环地址,自己跟自己通信用的。
- INADDR_BROADCAST:255.255.255.255,广播地址,局域网内所有主机都能收到。
手动赋值时的坑
如果你想直接给s_addr赋一个整数,比如addr.s_addr = 0xC0A80101;,那得先搞清楚字节序。0xC0A80101按大端解读是192.168.1.1,但如果你在小端机上直接这么写,内存里实际排布会变成01 01 A8 C0,对应1.1.168.192,完全不是你要的地址。
正确姿势是用htonl转一下:
addr.s_addr = htonl(0xC0A80101);
或者干脆用inet_pton,让它替你处理所有字节序问题。
4.3 sockaddr的统一设计:从接口抽象到协议扩展
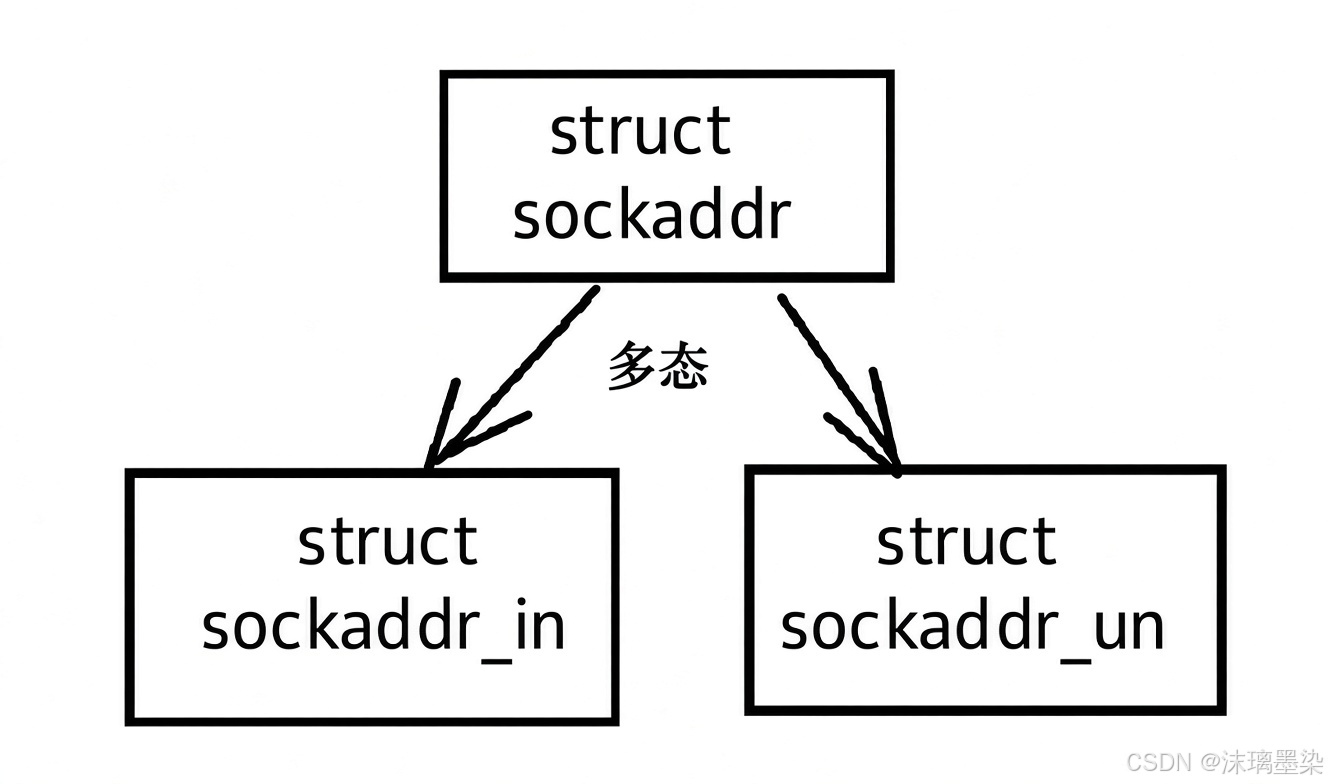
4.3.1 sockaddr与sockaddr_in的结构对比
实际用的时候,我们不会直接去碰sockaddr那个“空壳”,而是根据具体的通信场景,定义对应的结构体,填好之后,再强制转换成struct sockaddr *,递给Socket API。
拿两种最常见的场景来看:
网络通信(IPv4)——用struct sockaddr_in:
- 前16位:地址类型,填AF_INET
- 16位端口号
- 32位IP地址
- 最后8字节填充
四个字段拼起来,16个字节,把一台主机在互联网上的坐标定得死死的。
本地通信(UNIX Domain Socket)——用 struct sockaddr_un:
- 前16位:地址类型,填 AF_UNIX
- 后面跟着108字节的路径名
同样是地址结构,一个装的是IP加端口,一个装的是文件路径。内容天差地别,可它们都顶着同一个“通用外壳”,sockaddr。传进Socket API的时候,统统强转成struct sockaddr *,系统看一眼开头的sa_family,就知道该按哪套规则去解读。
这就是所谓的“协议多态”。同一个接口,接收不同格式的地址,靠的就是首字段的类型标签。IPv4也好,UNIX Domain Socket也罢,甚至以后要加的IPv6,都能塞进这同一套框架里。底层的差异被屏蔽,上层只管调同一个函数,写起来自然顺手。
4.3.2 系统底层如何根据地址族进行处理
Socket API拿到那个被强转过的struct sockaddr指针之后,怎么知道该按哪套规则来处理?答案全在结构体最前面的那16位里。
它读一眼地址家族标识,心里就有数了:
if (address->sa_family == AF_INET) {
// 是 IPv4,转成 sockaddr_in,走网络通信
} else if (address->sa_family == AF_UNIX) {
// 是本地套接字,转成 sockaddr_un,走本地通信
}
一个字段,一次判断,后面的数据该按什么格式解读,瞬间清晰。sa_family就像快递单上的“目的地类型”,看到“省外”,就按省际规则处理;看到“同城”,就换同城那套流程。数据本身没变,解读方式跟着标签走。
4.3.3 从统一接口理解多态思想与协议家族扩展
Socket API这套设计,精髓就一句话:用什么通信,就传什么结构体,但接口还是同一个。
你传sockaddr_in进来,它走网络;你传sockaddr_un进来,它走本地。底层的判断和转换,系统自己扛,上层只管调同一个函数。这种“头部字段标类型、通用指针做转接”的做法,其实就是C语言里对面向对象多态思想的一次经典复刻,没有虚函数,没有继承,靠一个字段和一次强转,硬是把多态给实现了。
更妙的是,这套框架天生为扩展而生。将来就算冒出新的通信方式,比如IPv6要全面铺开,只需要按规范定义一个新的地址结构体,照样塞进这个接口里。现有的代码一行不用改,Socket API照样认得它。这种“接口不变、结构体随便加”的扩展能力,就是这套设计最值钱的地方。
如果这篇文章对你有帮助,别忘了点个赞、点个收藏、点个关注。你的每一次反馈,都是我继续硬核输出的最大动力。