技术论文:InfiniteTalk: Audio-driven Video Generation for Sparse-Frame Video Dubbing(arXiv: 2508.14033)
开源地址:github.com/MeiGen-AI/InfiniteTalk项目主页:https://meigen-ai.github.io/InfiniteTalk/
出品团队:美团、中国科学院自动化研究所等
一、引言:视频配音的保真困境——嘴动了,表演却缺席
把一段中文配音塞进英文演讲视频,让电影中的角色"开口说"另一种语言,这看似成熟的能力背后,藏着一个长期被行业回避的问题:视频配音(video-to-video 换声)这条技术线上,现有方法只修嘴。
需要先划清边界:这个批判针对的是"在一段已有视频上替换音轨、重绘口型"的配音任务,而不是整个音频驱动数字人领域——后者从单张图像重新生成说话视频,头部姿态与表情生成早已是标配(详见第二章)。配音任务的独特约束在于:人物身份、背景、镜头轨迹必须与原视频严格一致,这比"从一张图生成一段新表演"难得多。
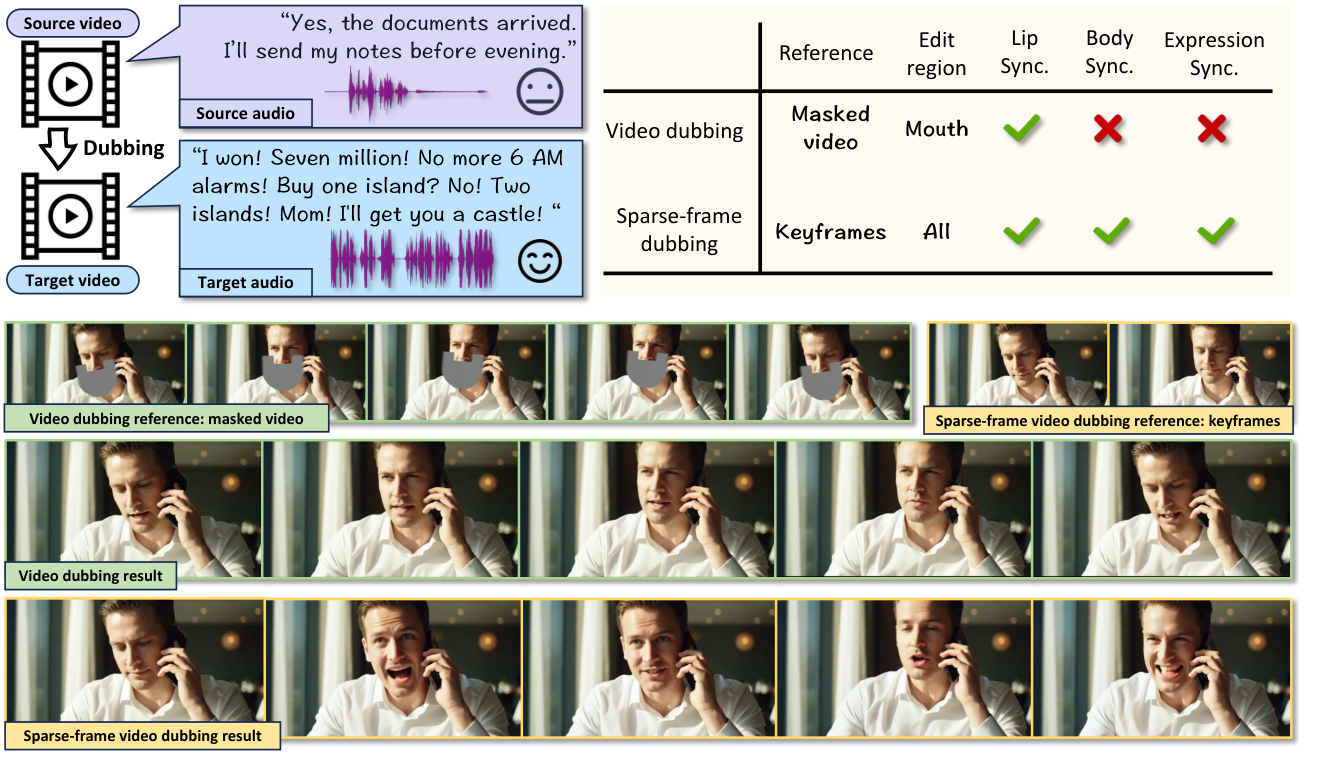
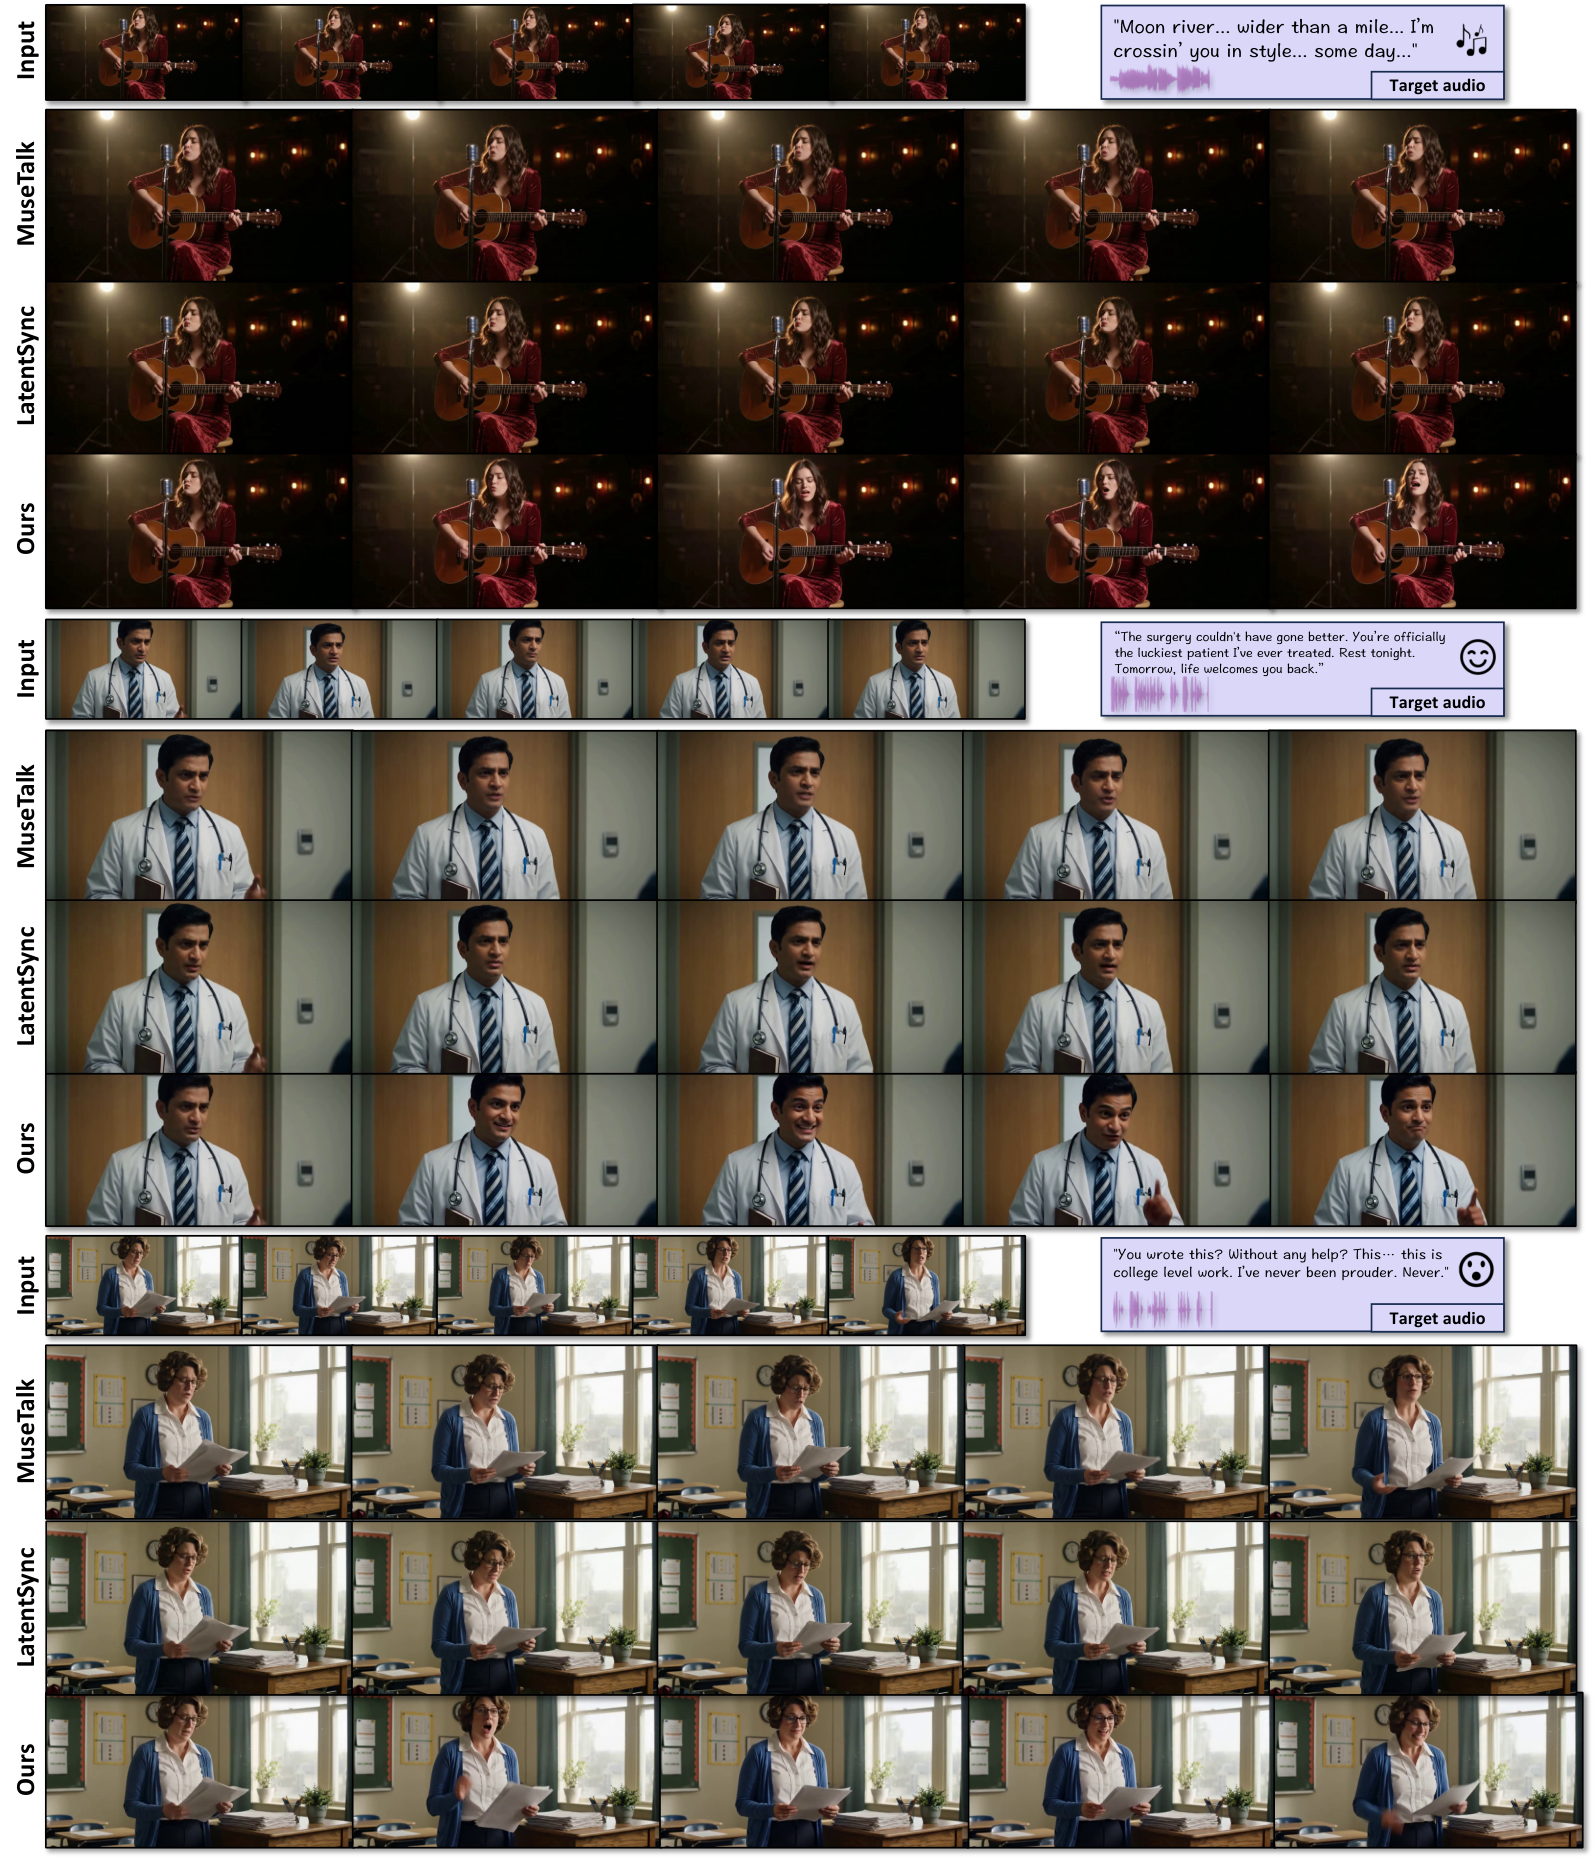
无论是早期的 Wav2Lip,还是后来的 MuseTalk、LatentSync,它们的技术路线本质相同——把人物嘴部区域挖出来,按照新音频逐帧重绘,视频其余部分原样保留。这样做的后果是:当配音者用激动的语调说出"这简直不可思议"时,画面里的人却端坐如钟、面无表情、双手纹丝不动。人的大脑对"视听不一致"极其敏感,唇部对了,头、手、表情却与语音节奏脱节,那种说不清道不明的"假",正是数字人长期无法跨越的恐怖谷。而这个"假"的根源不是模型不够强,恰恰藏在配音范式最核心的保真约束里——它是护城河,也是天花板。第二章将先拆解这个约束,再看 InfiniteTalk 如何绕过它。
2025 年 8 月,美团与中科院自动化所等团队放出了 InfiniteTalk,提出了一个全新的任务范式——稀疏帧视频配音(Sparse-Frame Video Dubbing):不再只改嘴,而是只保留稀疏的关键帧作为"锚点",把表情、头部运动、身体动作全部解放出来,让生成模型根据音频"重新演绎"整段表演,同时保住人物身份、背景、标志性手势与镜头轨迹,并且支持无限时长的流式生成。项目在 GitHub 开源后迅速收获数千星标,被社区视为音频驱动数字人方向的强力选手。
本文将从问题本质出发,逐步拆解 InfiniteTalk 的三层核心设计——流式生成架构、软条件机制、相机运动保持,并讨论它的工程化落地与未来边界。
二、范式融合:从"口腔重绘"到"稀疏帧配音"
2.1 先厘清两条技术线:谁在"动脸动头",谁"只修嘴"
音频驱动数字人领域长期并行着两条技术线,目标与约束截然不同,混在一起讨论是很多误读的根源:
|
音频驱动人像生成 |
从一张图像 + 一段音频,重新生成一段说话视频 |
SadTalker(CVPR 2023)、PD-FGC(arXiv 2022.11,解耦控制头部姿态/视线/表情)、DreamTalk(2023.12,情感化表情与头部运动)、Hallo(2024.06,扩散模型同步生成唇/表情/头部姿态)、EchoMimicV2(arXiv 2024.11,CVPR 2025 正式发表;半身动画,音频经"头部局部注意力"协调头身动作)、IMTalker(arXiv 2025.11,ACM MM 2025;隐式运动迁移 + 显式头部姿态与视线控制) |
早已"动脸动头"——头部姿态、表情、乃至半身手势的生成,在 InfiniteTalk 之前三四年就是这条线的主战场 |
|
视频配音 |
在一段已有视频上替换音轨,其余画面须与原片严格一致 |
Wav2Lip、MuseTalk、LatentSync |
确实只修嘴——保真约束(身份、背景、镜头不能变)使它们退化为嘴部局部重绘 |
换言之,"只修嘴"不是整个领域的短板,而是配音范式为了保真做出的自我阉割;反过来,音频驱动人像生成虽然能演,但大多从单图出发、以短片段为主,一旦自回归拉长,身份漂移、色彩漂移的老毛病照样出现——本文第三章要讲的误差累积,对这条线同样致命。
2.2 传统配音范式的保真天花板
传统视频配音在技术上是一个局部图像修复问题:嘴部区域有监督信号(音频),其余区域没有理由去改变。这条路线的指标(唇形同步分数)可以刷得很高,但它从定义上就放弃了"表演"。
而真实的人类表达是全身性的:说话时点头、挥手、挑眉、倾身,这些动作与语音的韵律、情绪强耦合。论文一针见血地指出:传统方法"口型对了、表演死了",这在短视频里尚可忍受,在影视译制、虚拟主播、长时间讲解视频里则完全不可接受。
2.3 稀疏帧与范式融合的边界
InfiniteTalk 的贡献既不是第一个让数字人动头动脸的(那是音频驱动人像生成线的既有能力),也不是第一个做视频配音的。它的创新是两条技术线的融合——把音频驱动生成的"全身表现力"注入视频配音的"原片保真"约束中,并且用流式架构把时长限制彻底拿掉。需要区分的是:IMTalker 等音频驱动人像生成工作确实证明了数字人能“动脸动头”,但它们生成的是全新表演,无法保住原片的身份、背景与镜头,其能力并不能直接迁移到配音场景。真正没有被填上的空白,是下面三者的交集:视频转视频 + 全身重演绎 + 无限时长。此前无限时长只有 StableAvatar 这个同期工作同样实现了无限长序列人像动画,但它只做图像转视频、进不了配音场景。
InfiniteTalk 的思路是反直觉的:既然整段原视频会束缚生成,那就把大部分原视频扔掉,只留几帧。
- 保留的:稀疏的关键帧,负责锚定人物身份、背景、标志性手势、镜头轨迹这些"不能变"的东西;
- 解放的:帧与帧之间的全部动态——表情、头部、身体动作交给生成模型,根据新音频"即兴演绎"。
这本质上是一个工程哲学的转变:用最小的信息冗余,换取生成模型最大的表达自由度。关键在于"锚"要松紧要可调——锚得太死,模型变成复读机,把参考帧的动作原样复制,违背音频;锚得太松,身份、背景、色彩随时间漂移,长视频必然崩坏。如何训练出一个"会看场合松紧"的模型,正是这篇论文最核心的贡献。
三、朴素方案的两次失败:为什么现成的视频生成模型救不了配音
论文先用两组对照实验,把"直接拿现有图像转视频模型来做配音"的路全部堵死。这组实验本身就是极好的方法论示范:先把朴素方案做到底,看清它死在哪儿,再针对性设计。
3.1 方案 A:图像转视频——误差累积的雪崩
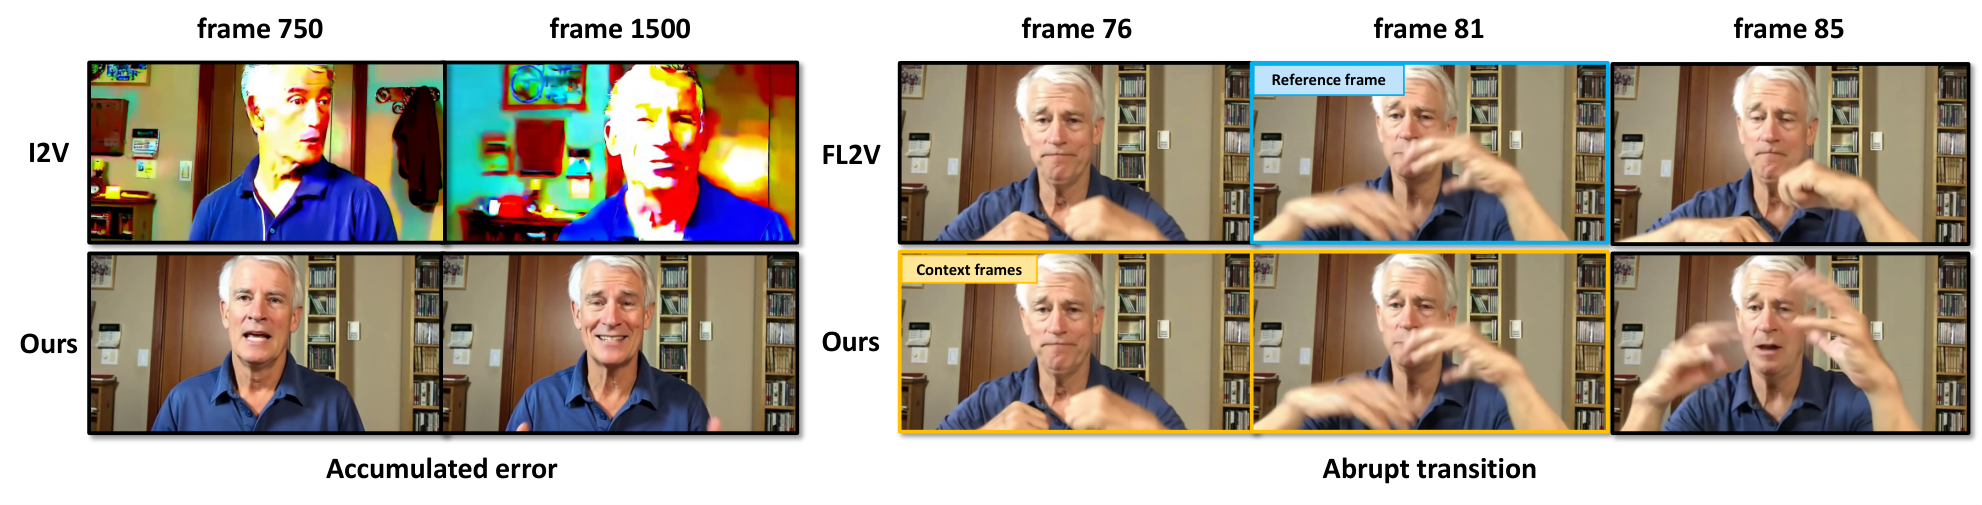
用图像转视频模型做配音,第一段从参考帧出发,后续每段拿上一段的最后一帧当新参考。问题立竿见影:每一次生成都会引入细微的身份偏移和色调偏移,这些误差随段落数线性累积。论文的演示视频中,到第 750 帧时人脸已明显变形,到第 1500 帧时色彩彻底漂移、面目全非。模型没有任何机制"记住"这个人原本长什么样。
3.2 方案 B:首末帧视频——硬条件带来的僵硬与跳变
用首末帧视频模型,每段的首帧、末帧都由源视频给定,天然杜绝了漂移。但代价是:模型被训练成在指定时刻严格复现参考帧的姿态。配音时这会造成荒谬的结果——参考帧里人物正抬手拍额头,模型就会在情绪平淡的语音中间生硬地插入这个动作。更糟的是,块与块之间缺乏运动信息的传递,转场处动作"急刹车",产生明显的跳变。
3.3 两次失败揭示的核心矛盾
这两个失败是对称的,共同指向一个根本的权衡:
- 图像转视频:运动自由,但保真度随时间衰减;
- 首末帧视频:保真度锁定,但运动被参考帧钉死。
稀疏帧配音需要的是第三种东西——软条件(Soft Conditioning):参考帧给的是"基调"而非"剧本",模型该听音频的时候听音频,该对齐身份的时候对齐身份。怎么做到?答案藏在训练时"参考帧怎么选"这个看似无关紧要的细节里。
四、架构解剖:一台流式的扩散 Transformer
4.1 总体设计
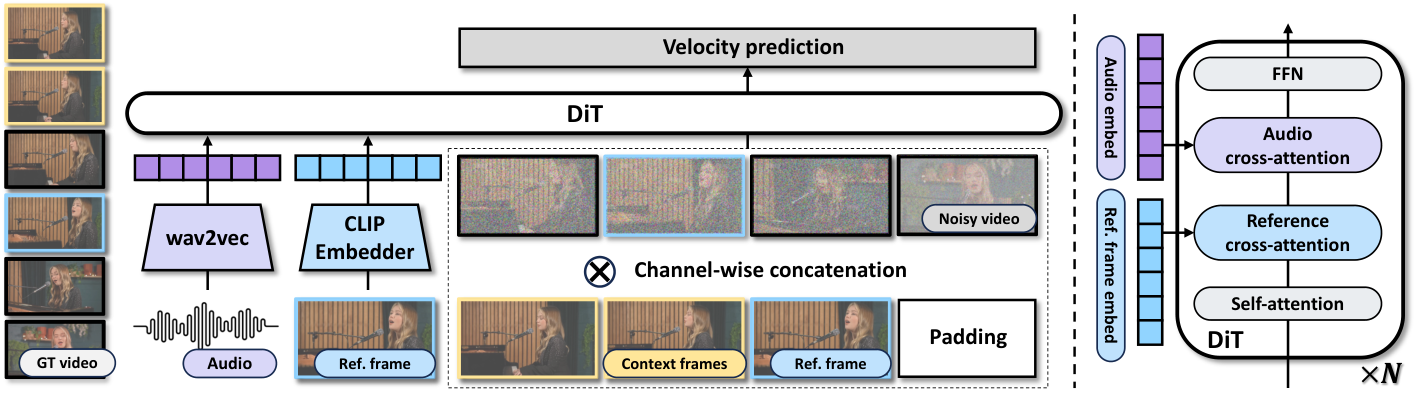
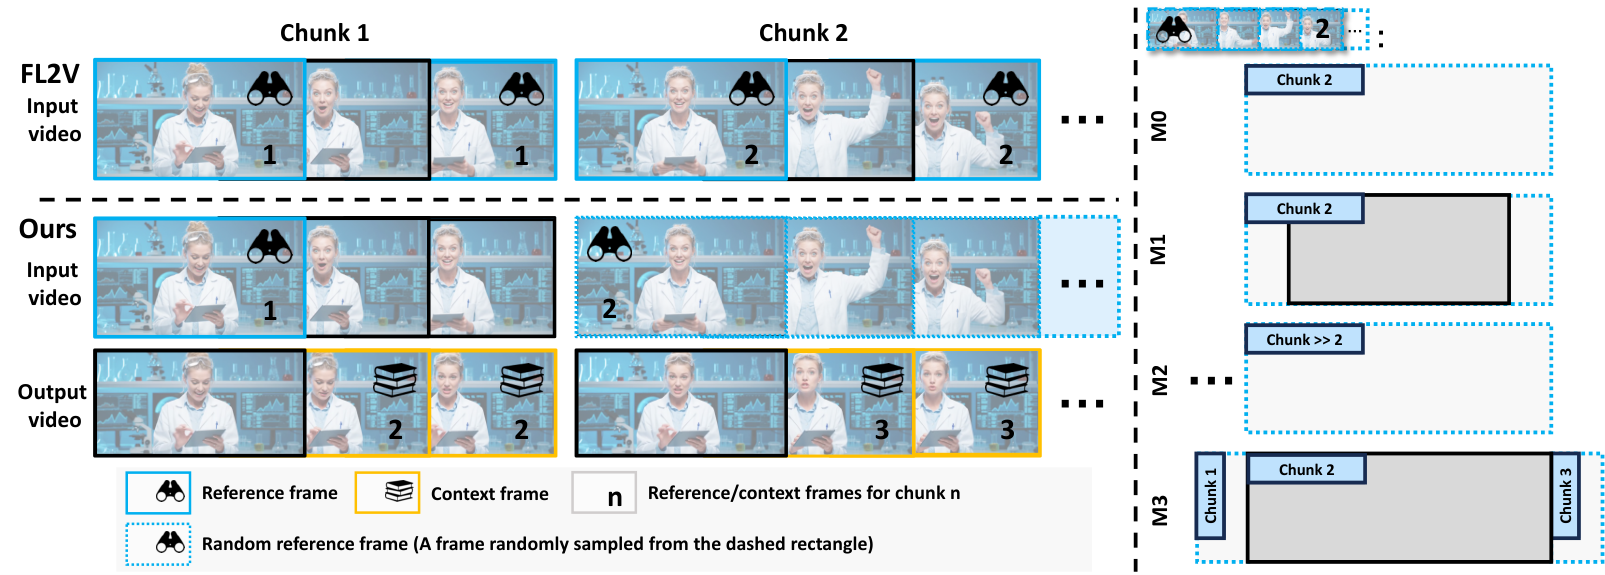
InfiniteTalk 建立在通义万相 2.1(Wan2.1)图像转视频大模型(14B,即 140 亿参数的基座)之上,与团队此前的 MeiGen-MultiTalk 共享同一套扩散 Transformer(DiT)骨干,再通过条件权重后训练得到配音能力——换句话说,14B 是基座的规模,InfiniteTalk 是在基座上"长"出来的条件模块,并非从零独立训练的 14B 模型。整个系统是流式的:视频被切成 81 帧一段的小块逐块自回归生成,相邻块之间保留 9 帧重叠(实际每段新产出 72 帧,重叠部分作为下一段的上下文帧),块间通过"上下文帧"传递运动动量,从而实现无限延伸——只要显存够,视频可以一直生成下去。
训练规模也值得一记(均出自论文第 4 节实验设置):约 2000 小时的说话人视频,由 64 张英伟达 H100 80GB 显卡集群训练。评测统一在 480×480 分辨率下进行。
4.2 三路输入如何进入模型
从结构图可以看到三条条件通路:
三路信息在通道与时间两个维度上分别拼接后进入 Transformer 主干,模型用条件流匹配(Conditional Flow Matching)目标训练。先交代一个阅读提醒:论文对时间变量 t 的方向约定存在内部不一致——式 (1) 的分布插值中 t=0 是噪声、t=1 是数据,而样本插值公式恰好相反(t=0 是数据、t=1 是噪声),正文"从噪声输运到视频"的文字叙述又与前两者之一各执一端。本文统一按样本插值公式的约定呈现。
以下公式忠实引自论文第 3.1 节——第一步,对真实视频隐变量 x₁ 与高斯噪声 x₀ 做线性插值,得到 t 时刻的含噪样本:
x_t =(1 − t) · x₁ + t · x₀, 其中 x₀ ~N(0,I),t ∈ [0,1]
按此约定,t=0 时 x_t 就是真实视频,t=1 时为纯噪声。(顺带一提,论文第 3.3 节的训练描述又把噪声记作 x₁,与第 3.1 节恰好相反——这篇论文的符号约定确实比较随意。)
第二步,论文(式 2)给出的训练目标为:
L_fm =E_{t, x₀, x₁} ‖ v_θ(x_t | y)−(x₁ − x₀) ‖₂²
三点需要解释。其一,注意式中网络只显式写作条件于文本 y——音频与参考帧并不是作为损失函数里的显式条件变量出现的,它们通过前面提到的交叉注意力层在网络结构内部注入;这提醒我们"条件如何进模型"与"损失怎么写"是两个层面的事。其二,按上述标注,(x₁ − x₀) 是"真实视频减噪声"的方向(从噪声指向真实视频);而论文同时声明 v_θ 近似于 dx_t/dt,对插值公式求导得 dx_t/dt = x₀ − x₁,与损失目标的符号恰好相反——这属于论文内部的符号约定不一致,本文直接引用、不代为"修正"。其三,无论符号朝哪边约定,物理图像是不变的:训练时网络在"数据—噪声"连线上学习一个向量场,推理时用常微分方程求解器从纯噪声一端出发,沿学到的场"流"回真实视频。值得强调的是训练数据的朴素——不需要成对的"配音前后"视频,只要有带音轨的说话人视频即可,参考帧从视频中随机采样。这消除了对成对配音数据的依赖,但高质量、音画严格对齐的说话人视频仍需要大量筛选与清洗,数据门槛并没有消失,只是从"成对"变成了"海选"。
4.3 推理时的接力逻辑
推理采用自回归接力:第一段的参考帧取源视频首帧,无需上下文帧;此后每一段,取上一段输出的末尾 9 帧作为上下文帧,取源视频对应位置的第一帧作为参考帧。上下文帧提供"运动惯性",参考帧提供"身份与画面基准",二者各司其职——这正是对第三节两次失败的直接回应。
五、软条件机制:参考帧摆哪儿,控制力就有多强
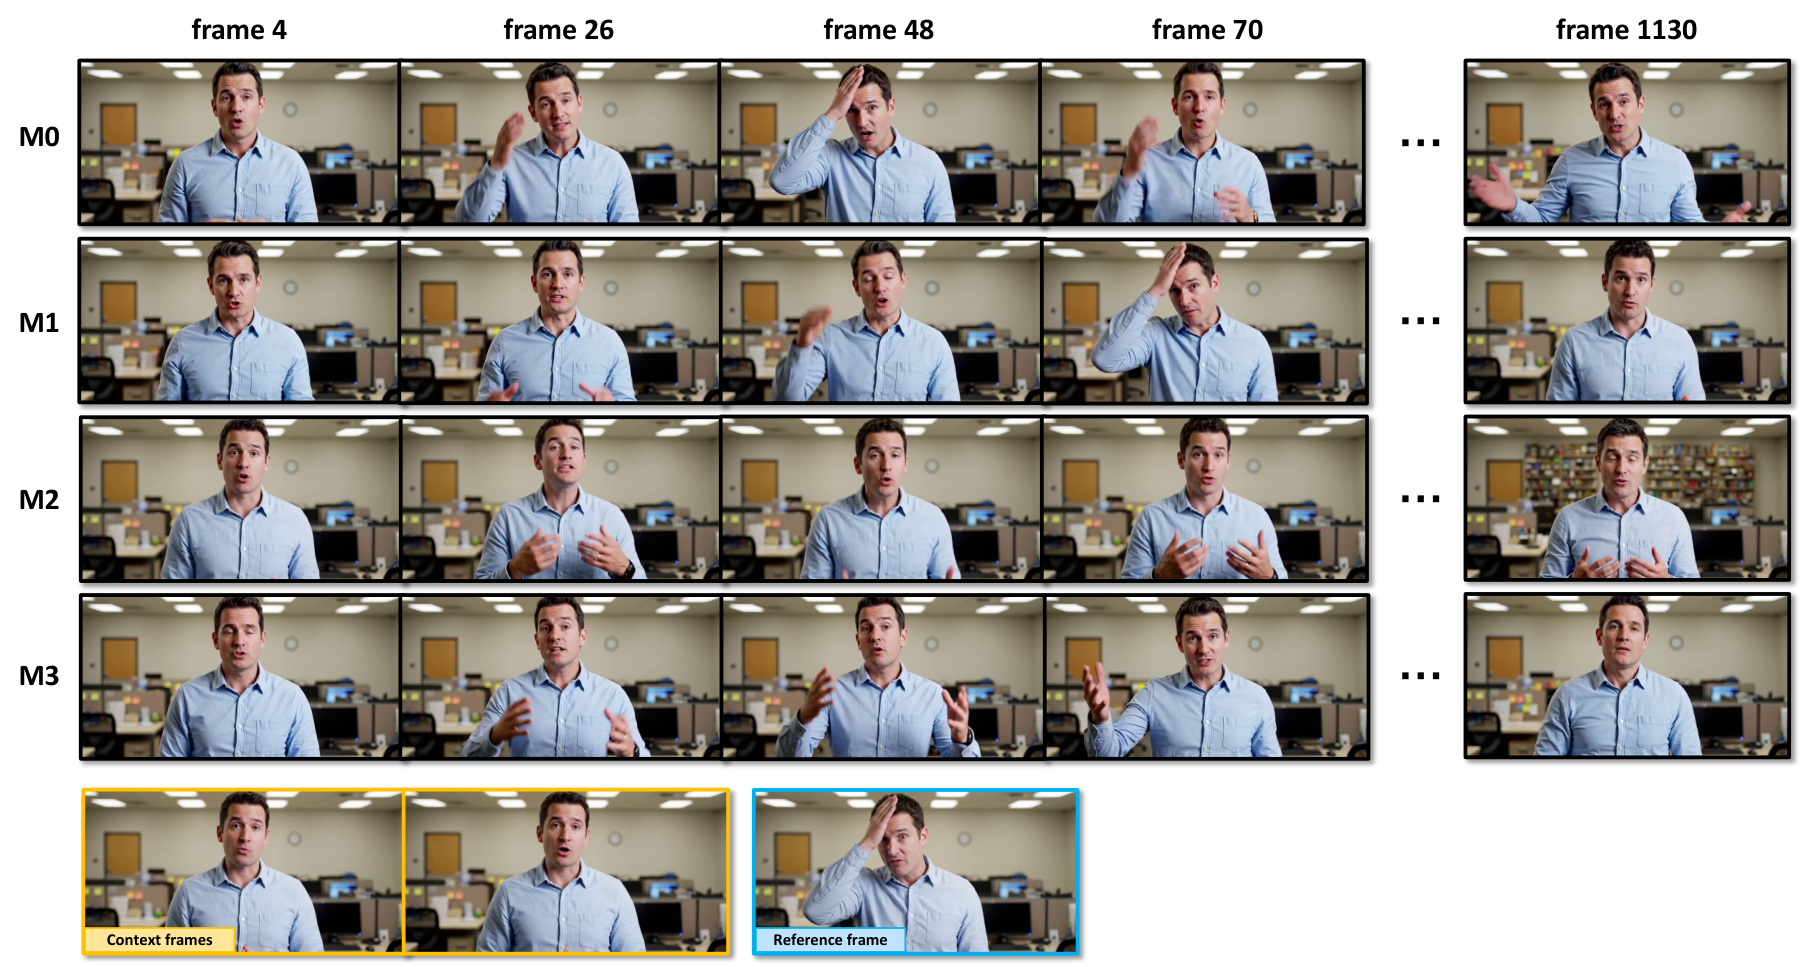
这是全文最精妙、也最具"可迁移价值"的一节。团队训练了四个模型变体,系统性地改变训练时参考帧的采样位置,观察控制强度的变化:
|
M0 |
当前块内均匀随机 |
过强 |
把参考帧动作(如拍额头)复制到任意时刻,破坏音画同步 |
|
M1 |
只取块的首帧或末帧 |
强(等于首末帧模式) |
块边界处强行复现参考姿态,与语音情绪冲突 |
|
M2 |
取自 5 秒以外的时间块 |
弱 |
不复制了,但身份、色彩、背景随时间漂移 |
|
M3 |
取自相邻块(1 秒以内) |
适中 |
既保住身份与镜头,又不复制动作,全身随音频自然演绎 |
这组对比不只是"看起来对",论文在 EMTD 上做了定量消融(FID/FVD 越低越好,Sync-C 越高越好,Sync-D 越低越好):
|
M0(块内随机) |
32.69 |
322.04 |
8.51 |
7.31 |
|
M1(首末帧采样) |
32.21 |
307.21 |
7.96 |
8.11 |
|
M2(远端采样) |
42.17 |
376.53 |
8.23 |
7.44 |
|
M3(相邻块采样) |
32.55 |
312.17 |
8.60 |
7.16 |
M2 的画面质量指标明显劣化(FID/FVD 最高),印证了"控制太弱→画面漂移"的推断;M3 在四项指标上全面最优或并列最优,坐实了"相邻块采样"这一策略的有效性。
结论清晰:块级时间距离是控制强度的主导因素。参考帧离当前生成块越近,控制越"软"——因为模型从上下文帧里已经能看到与参考帧相似的内容,不需要强行对齐;参考帧离得远,控制越"硬"——它成了唯一的信息来源,模型不得不死记硬背。
M3 策略揭示了一个深刻的洞察:软条件不是设计出来的,而是通过训练样本的分布"诱导"出来的——让模型在训练时经常看到"参考帧与上下文相似"的情形,它自然学会在相似时放松、在相异时收紧。这种"以数据分布换行为"的思路,对所有条件生成模型的设计都有借鉴意义。
六、相机控制:让镜头轨迹也听话
参考帧机制提供的是全局的镜头轨迹约束,但每个小块内部的细微运镜(推拉摇移)仍需额外手段。InfiniteTalk 以"即插即用"的方式支持两个外挂模块:
- SDEdit 方式:把源视频按噪声比例混入初始噪声,从中间时刻而非纯噪声开始去噪——相当于给模型一份"带镜头运动的模糊底稿",保留背景好,适合短片段;
- Uni3C 方式:通过一个类似控制网络(ControlNet)的结构显式注入相机运动参数——镜头控制力强,但可能损失部分背景细节。
两种方式各取所需,论文也给出了对比结果:加 Uni3C 的镜头运动与源视频贴合度最高,SDEdit 的画面保真更好但有轻微色偏。

七、实验:有条件领先,且指标本身值得玩味
7.1 定量结果:有条件领先的成色
团队在 HDTF、CelebV-HQ、EMTD 三个基准上测试(面部动态与全身动作兼顾),从每个数据集随机抽 40 条视频、置换音轨模拟真实配音场景(共 120 条),指标涵盖:
- FID / FVD(弗雷歇距离/弗雷歇视频距离):画面真实感与时序连贯性;
- Sync-C / Sync-D(同步置信度/唇距):唇形同步精度;
- CSIM(余弦相似度):身份保持程度。
先看与传统配音方法(MuseTalk、LatentSync)的对比:
|
HDTF |
LatentSync |
16.09 |
48.45 |
8.99 |
6.36 |
0.916 |
|
HDTF |
MuseTalk |
14.20 |
49.13 |
7.17 |
7.90 |
0.933 |
|
HDTF |
InfiniteTalk |
26.11 |
131.65 |
9.35 |
6.67 |
0.775 |
|
CelebV-HQ |
LatentSync |
17.80 |
67.97 |
6.90 |
7.33 |
0.869 |
|
CelebV-HQ |
MuseTalk |
17.62 |
72.07 |
4.16 |
9.86 |
0.857 |
|
CelebV-HQ |
InfiniteTalk |
32.29 |
229.67 |
7.53 |
7.33 |
0.726 |
|
EMTD |
LatentSync |
11.43 |
212.60 |
8.10 |
6.97 |
0.846 |
|
EMTD |
MuseTalk |
14.26 |
46.07 |
5.35 |
9.28 |
0.825 |
|
EMTD |
InfiniteTalk |
32.55 |
312.17 |
8.60 |
7.16 |
0.713 |
再看与音频驱动图像转视频方法(OmniAvatar、MultiTalk、FantacyTalking、Hallo3)的对比:
|
HDTF |
FantacyTalking |
32.06 |
110.36 |
3.78 |
10.80 |
0.684 |
|
HDTF |
Hallo3 |
36.48 |
144.65 |
7.20 |
8.61 |
0.674 |
|
HDTF |
OmniAvatar |
26.63 |
112.49 |
7.06 |
8.63 |
0.752 |
|
HDTF |
MultiTalk |
27.61 |
133.58 |
9.02 |
6.96 |
0.754 |
|
HDTF |
InfiniteTalk |
27.14 |
132.54 |
9.18 |
6.84 |
0.751 |
|
CelebV-HQ |
FantacyTalking |
37.53 |
237.58 |
2.93 |
10.79 |
0.654 |
|
CelebV-HQ |
Hallo3 |
42.36 |
258.65 |
5.63 |
9.12 |
0.591 |
|
CelebV-HQ |
OmniAvatar |
37.41 |
250.67 |
5.88 |
8.68 |
0.703 |
|
CelebV-HQ |
MultiTalk |
34.79 |
230.41 |
7.25 |
7.70 |
0.711 |
|
CelebV-HQ |
InfiniteTalk |
33.96 |
230.12 |
7.41 |
7.59 |
0.713 |
|
EMTD |
FantacyTalking |
36.66 |
298.24 |
3.60 |
11.31 |
0.626 |
|
EMTD |
Hallo3 |
44.71 |
326.94 |
5.68 |
9.56 |
0.512 |
|
EMTD |
OmniAvatar |
29.47 |
308.14 |
6.93 |
8.55 |
0.694 |
|
EMTD |
MultiTalk |
33.80 |
315.33 |
8.13 |
7.50 |
0.702 |
|
EMTD |
InfiniteTalk |
33.27 |
314.68 |
8.34 |
7.36 |
0.709 |
这组数据可以从三个层面理解。第一,对图像转视频类对手(第二张表):InfiniteTalk 的 Sync-C/Sync-D 全面最优或并列最优,且在画质与身份保持上与 MultiTalk 基本打平——这两句话并不矛盾:"全面最优"说的是数值排序,"基本打平"说的是差距幅度,与 MultiTalk 的差距普遍在 0.2 以内,数值上领先、幅度上持平,两件事同时成立。这是"有条件领先"中"领先"的部分。但"领先"的成色要拆开看:论文原文称"唇形同步大幅领先"(by a large margin),这个"大幅"主要体现在与 FantacyTalking、Hallo3、OmniAvatar 的差距上(如 EMTD 上 Sync-C 8.34 对 3.60~6.93);而对最直接的竞品 MultiTalk,差距其实很小(HDTF 上 Sync-C 9.18 对 9.02,Sync-D 6.84 对 6.96),且论文未报告统计显著性检验——读者宜把这部分理解为"小幅但一致地更优",而非压倒性优势。第二,对传统配音方法(第一张表):InfiniteTalk 的 FID/FVD/CSIM 数字明显更差,这不是退步,恰恰是 7.2 要讲的现象。第三,两类表放在一起,正好把"配音"与"生成"两种范式的指标生态摆在了同一张棋盘上。
7.2 一个坦诚的细节:指标会"说谎"
论文中有一个罕见的坦率讨论:传统的"拷贝输入即输出"方法在 FID、FVD、CSIM 上会取得"虚假的优秀"——因为画面根本没动,时序误差自然为零。也就是说,在配音任务上,单一指标无法刻画真实质量,这也是为什么团队设计了人工评测。
7.3 人工评测:结果、范围与局限
7.3 人工评测:结果、范围与局限
先明确范围:本节的人工评测仅针对视频配音范式内部的方法对比(MuseTalk、LatentSync、InfiniteTalk 三者),不涉及音频驱动人像生成线——后者有自己的战场(长视频漂移,见第二章)。
目前的自动指标只能测唇形同步,没有可靠的"全身动作-音频对齐"指标(论文发现音乐领域的节拍一致性指标无法区分方法优劣)。因此团队在 EMTD 上组织了人工评测:17 名参与者、340 份评分,覆盖全部 40 条视频。评分方案设计了五个维度——手势与语调同步、头部与节奏同步、唇形精度、身份一致性、整体自然度;但论文最终只公开了"运动同步"子集的结果(Table 4,标题即注明"运动同步方面的人工评测"),其中手势与头部两个维度合并为"身体动作同步"一列,而身份一致性与整体自然度的评分未见报告。已公开的平均名次如下(越小越好):
|
MuseTalk |
2.57 |
1.92 |
|
LatentSync |
2.32 |
1.92 |
|
InfiniteTalk |
1.11 |
1.09 |
MuseTalk 与 LatentSync 都只重绘嘴部、身体动作均原样保留自源视频。论文原表中 MuseTalk 的身体动作同步列为"—"并注明"不参与比较",未给出数值;本文依据二者身体动作完全相同的说明,将其解读为与 LatentSync 同分——这是本文的推断,不是论文的显式数值。
就已公开的两项结果看,InfiniteTalk 在唇形与身体动作同步上均获第一,且名次差距悬殊——这直接证明了配音类方法"只改嘴"的路线在身体动作维度上的系统性缺失。不过要如实说明三点局限:其一,论文未报告评分者间一致性,也没有置信区间或显著性检验,17 人 340 份评分的规模足以支撑方向性结论,但不宜当作严格统计意义上的"证明";其二,五个维度中只公开了两个,身份一致性与整体自然度的表现无从查证,读者无法排除"在未见报告的维度上表现平平"的可能;其三,评测仅覆盖 EMTD 一个数据集。这三点不否定结果的可信度,但划定了它的边界。
八、上手实测:8GB 显卡的全链路实战
本章是实现全身数字人的一次真实部署。测试环境是消费级台式机:Windows 11、i5-13400F、32GB 内存、RTX 5060 8GB 显存,回答一个社区最关心的问题:没有 24GB 的专业卡,InfiniteTalk 到底能不能跑、怎么跑稳。
8.1 部署形态:ComfyUI 插件 + 脚本化提交
没有走官方命令行脚本,而是选择了社区维护的 ComfyUI 插件形态(kijai 的 WanVideoWrapper 生态):模型按工作流节点组装,脚本读取模板工作流 JSON、动态注入图片与音频路径后提交 REST 接口(POST /prompt),轮询任务完成后从临时目录取回视频——四阶段流水线因此可以全脚本化、可重入:任何一段失败单独重跑即可。核心权重为 13 亿参数的视频扩散模型 + 文本编码器 + wav2vec 音频编码器 + InfiniteTalk 驱动适配层。
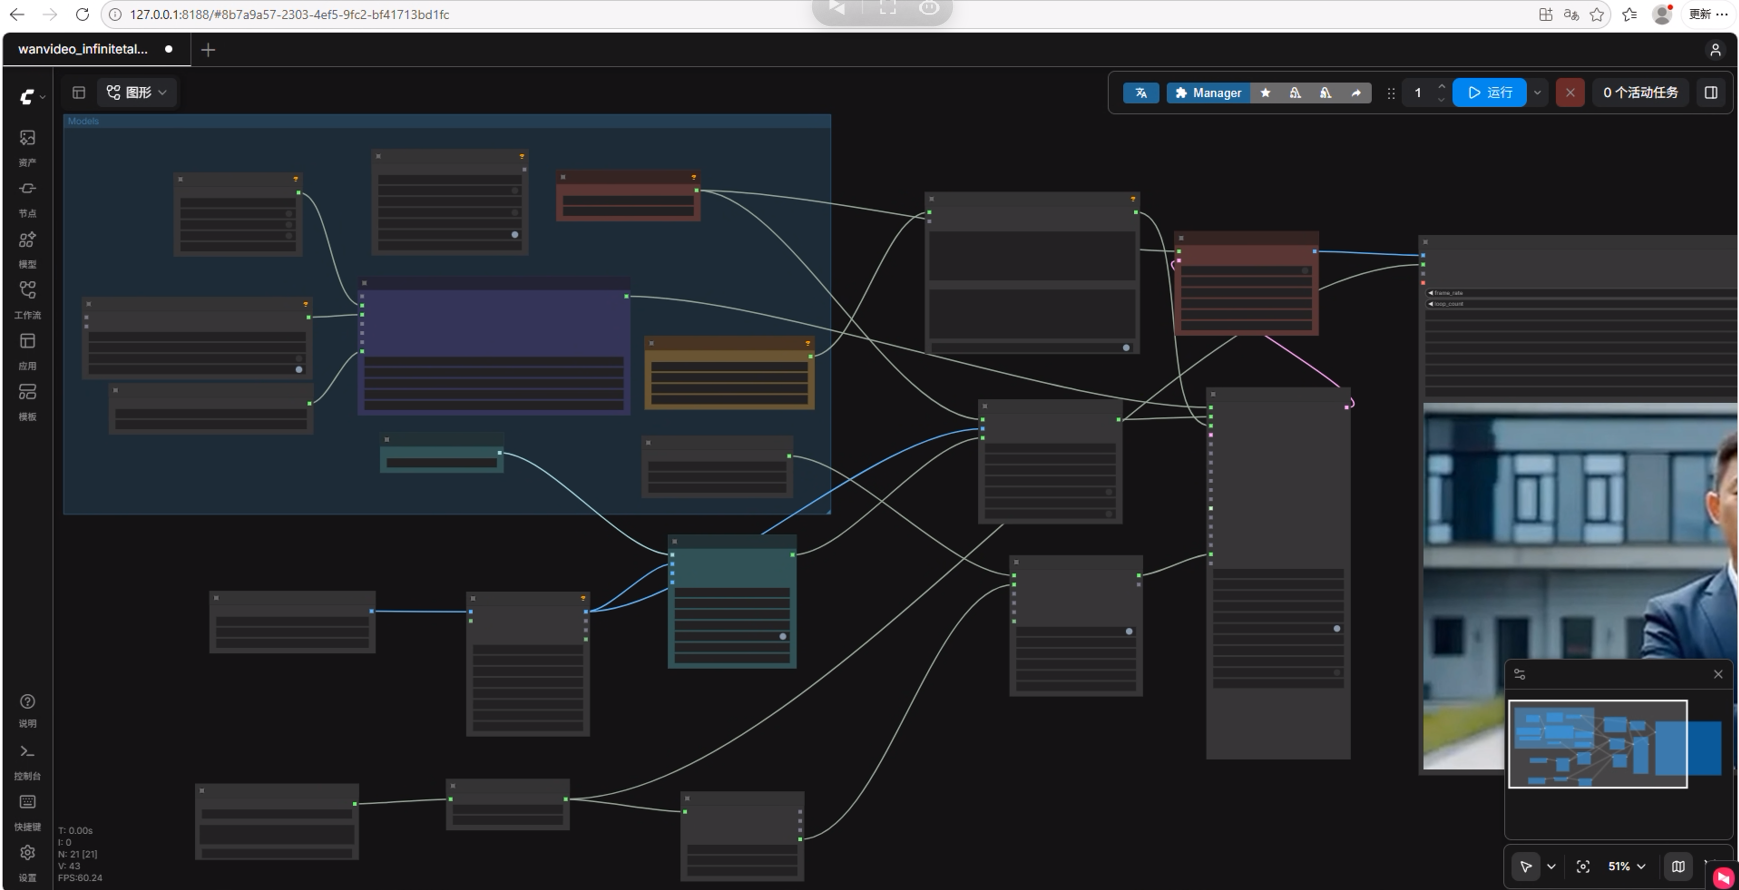
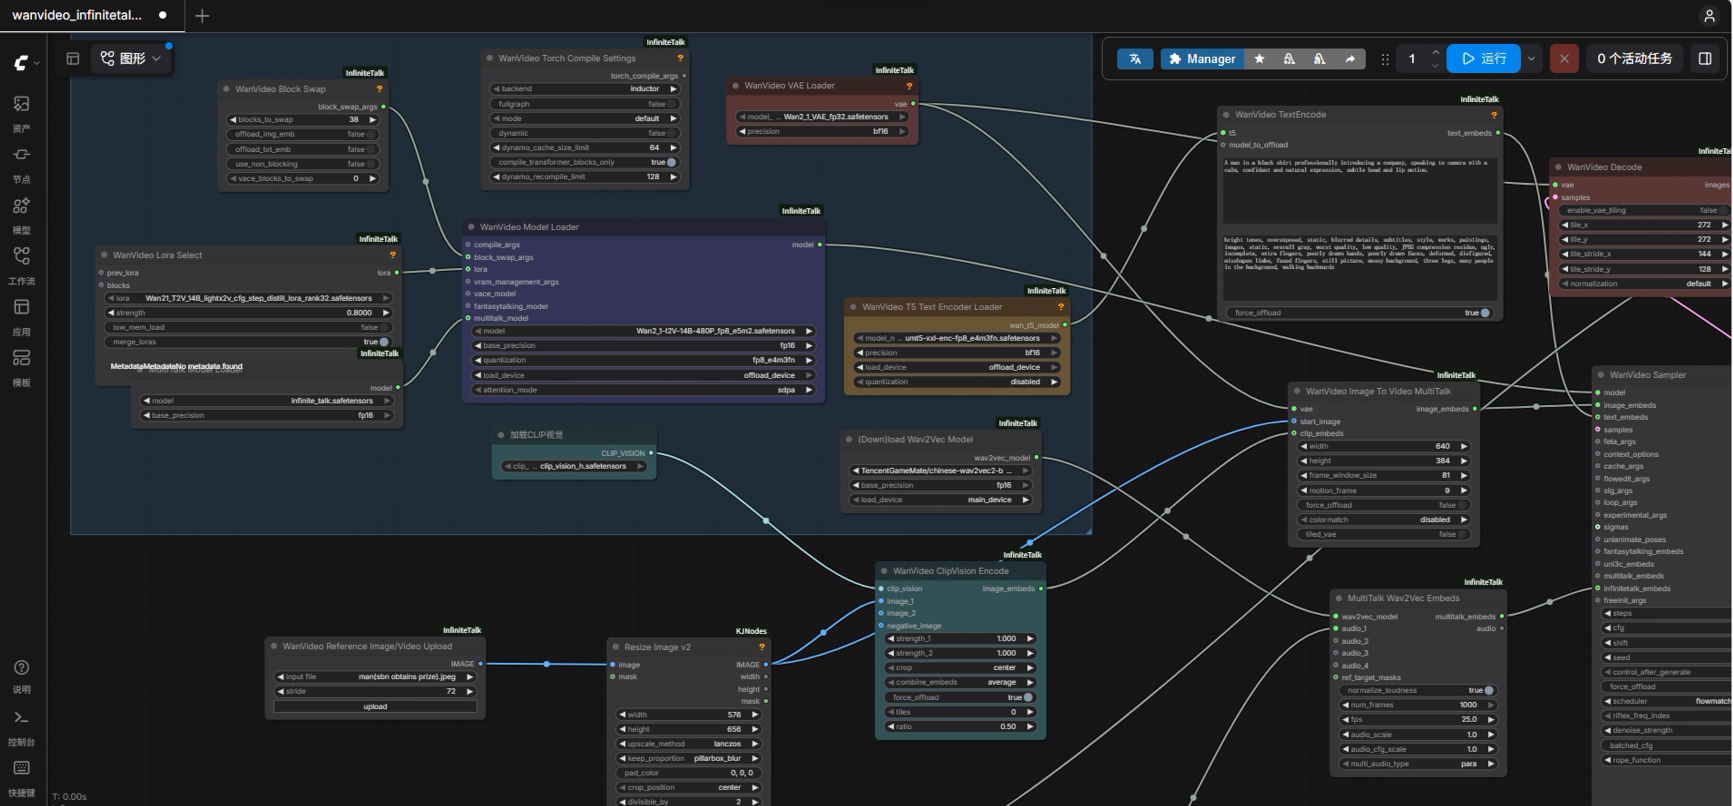
部分运行过程
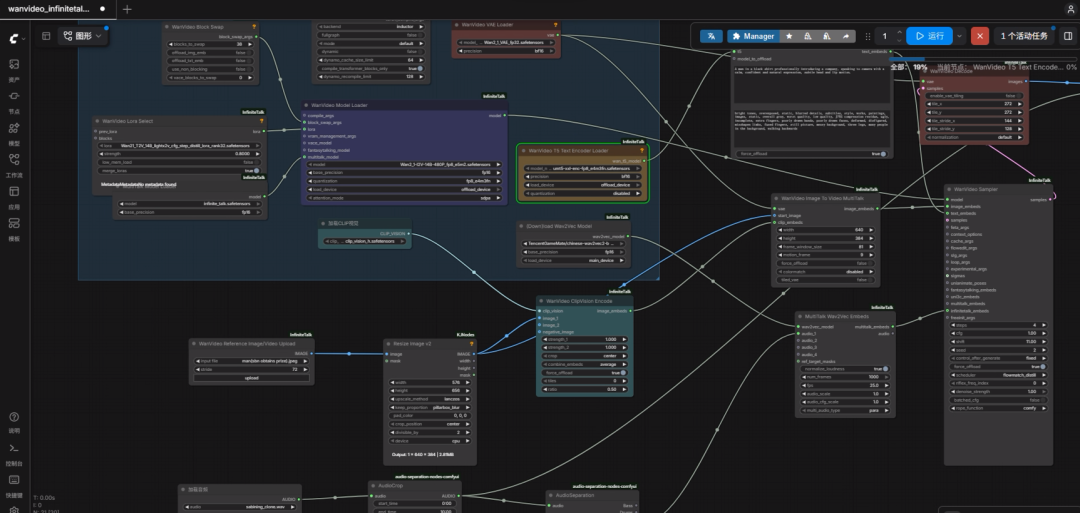
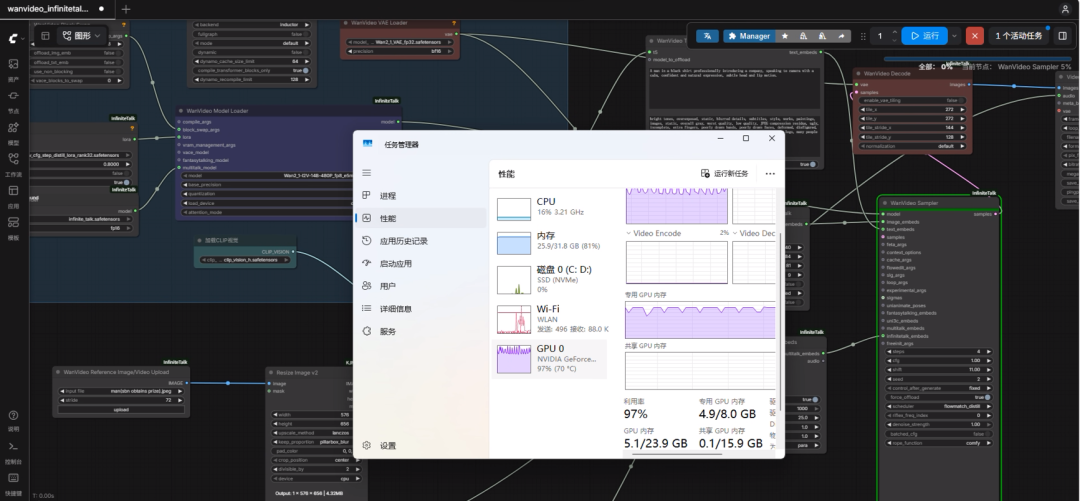
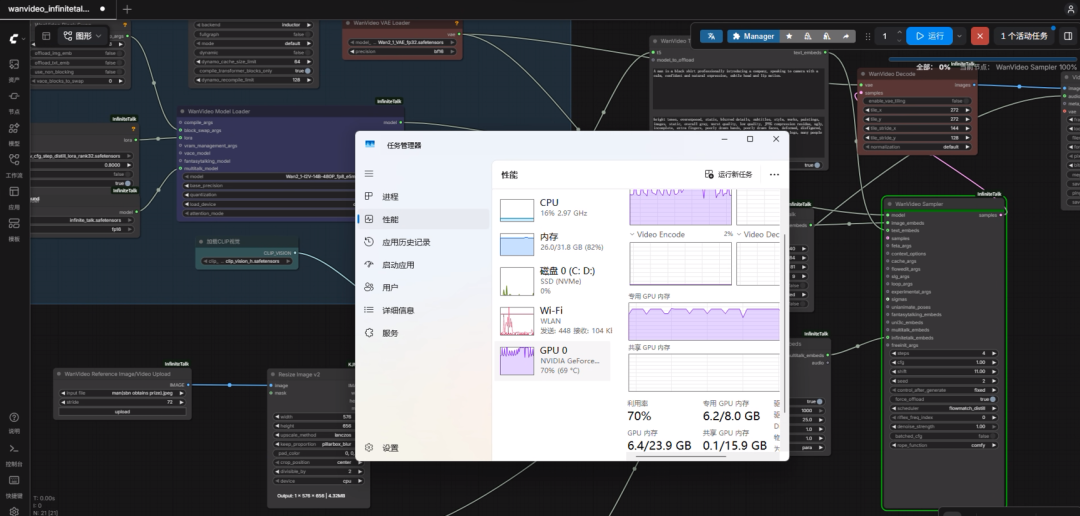
生成视频
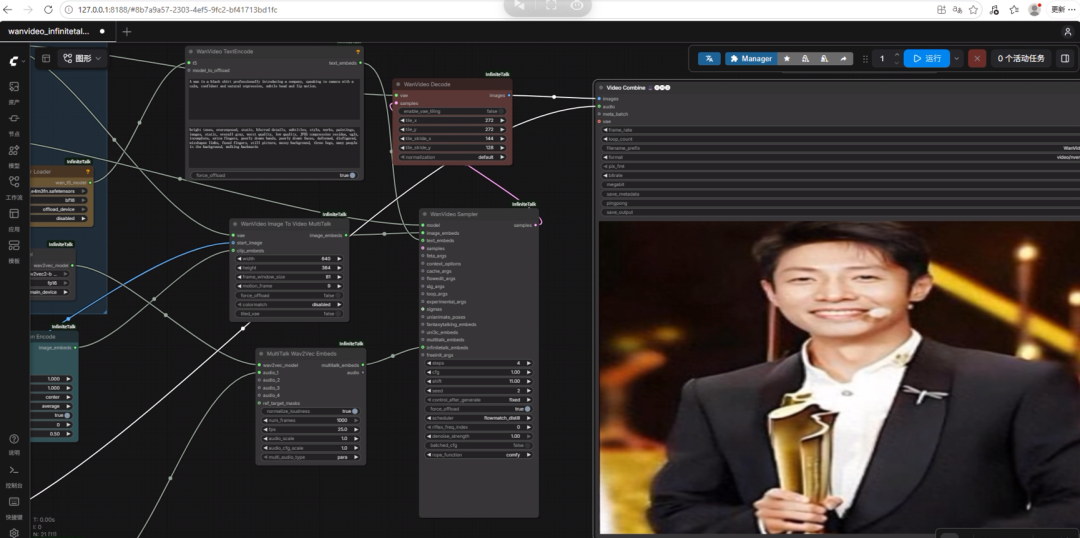
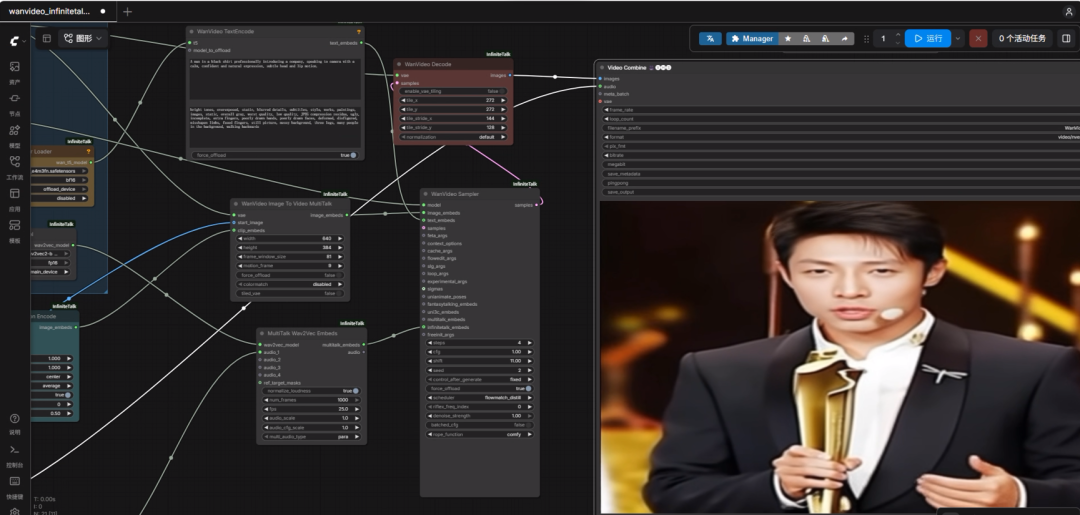
需要说明:官方命令行脚本(generate_infinitetalk.py)自带另一套低显存机制(常驻参数量控制、8 位量化、缓存加速),与社区插件的块交换思路相同但实现独立,且官方脚本的参数更贴近论文原始管线(流式模式、上下文帧数等);本文选择 ComfyUI,看中的是流水线可编排与生态成熟度。因此本章的所有性能数字都特定于这套工作流,不可直接当作通用规格。
8.2 全链路四阶段
实测把数字人视频拆成互相独立的四段流水线,产物全部落盘:
|
1. 语音 |
文案(+参考音频)→ wav |
通义千问 3 语音模型做声音克隆(0.6B,8GB 卡轻松放下);edge-tts 云端兜底 |
|
2. 视频 |
人物图 + 语音 → 无字幕 mp4 |
ComfyUI + InfiniteTalk,按音频切片逐段生成 |
|
3. 字幕 |
语音 → srt |
faster-whisper(medium,CPU int8,转写开销不到生成时间的 1%) |
|
4. 烧录 |
mp4 + srt → 成片 |
ffmpeg + libass |
一个值得记录的体验:用川建国同志的声音克隆环节用 71.6 秒英文参考音频生成 14.4 秒中文克隆语音,GPU 上秒级完成——语音侧早已不是瓶颈,整个数字人流水线的成本和时间都压在视频生成这一段。(由于审核问题不便展示视频)
8.3 显存优化三板斧(8GB 卡的核心战场)
第一板斧:块交换(Block Swap)。 原理是让少量扩散 Transformer 区块常驻显存、其余按需从内存换入换出——用时间换空间。本机实测:40 个区块中只留 2 个常驻、交换 38 个时显存峰值压到 5GB 以内、稳定运行,代价是约 3.5 分钟生成一段 10 秒视频;试过只交换 15 个(25 个常驻),速度快得多但 8GB 直接显存溢出。本机两组对比如下:
|
25 层(交换 15) |
快,但 OOM |
|
2 层(交换 38) |
稳定,约 3.5 分钟/10 秒 |
注意:块交换的默认层数因插件与工作流而异(社区里从交换 20 个到 50 余个的配置都有),"2 层常驻"是本文这套插件与工作流下的实测极值,不是通用建议值。
第二板斧:分辨率换序列长度。 注意力开销与"序列长度"(宽高各除以 16 再相乘、乘以帧数)成正比,这是最有效的调参杠杆。宽高必须是 16 的倍数。本机实测:832×480 在这套工作流下显存溢出,640×384 是速度与画质的平衡点,降到 544×320 还能更快但画质明显受损;配合"像素预算"三档(18 万快 / 25.6 万默认 / 40 万清晰),可以在显存红线内精细换挡。需要说明:社区指南中有"6GB 显存即可跑 480p"的说法,那多基于其他实现(如 8 位量化模型或原生采样器),不同实现间的显存曲线差异很大,本机结论不可直接移植。
第三板斧:碎片整理与系统配合。 插件层面,每 4 个区块执行一次显存缓存清理是速度与稳定的平衡点(每 2 个就太慢:20 分钟一段);系统层面,块交换把压力转移到了内存——本机实测生成前需清出 15GB 以上可用内存(内存需求与交换层数正相关,配置不同差异很大,此为 32GB 内存机器上的经验值),浏览器、下载器、通讯软件合计能吃掉 10GB,不清后台照样失败。8GB 显存的坑往往不在显存,而在内存。
8.4 性能基线与结论
|
640×384、默认像素预算、12 段 × 10 秒 |
约 40 分钟 |
4.9GB 实际分配 |
|
416×608、低像素预算、12 段 × 10 秒 |
41 分 44 秒 |
同上 |
单段 10 秒视频约 3–4 分钟,耗时与音频长度近乎线性——两分钟成片要准备约 40 分钟生成时间。两条结论:其一,8GB 消费卡跑通 InfiniteTalk 是成立的,但"能跑"与"好用"之间隔着一整套调参功课,社区插件的块交换机制是最大功臣;其二,Windows 的 WDDM 显卡驱动是隐形地雷——运行超过 30 分钟可能触发显存映射崩溃,需禁用异步显存分配、禁止可扩展显存段环境变量,迁移到 Linux 可彻底绕开这一限制(ComfyUI 本就是服务形态,迁移成本不高)。这正是第九章"云端化"方向的实测注脚。
九、工程化与生态:低门槛部署的实践
InfiniteTalk 的另一个亮点是把"论文级"能力做成了"产品级"可用性(第八章的 8GB 显卡实战就是这一节的民间验证):
9.1 部署形态与加速生态
- 部署形态齐全:Gradio 图形界面、ComfyUI 工作流节点(社区已有一键部署)、多卡推理、Docker;
- 低显存友好:通过显存参数调优可在消费级显卡运行,官方还提供 8 位量化模型应对显存不足;
- 推理加速全家桶:TeaCache 缓存加速、LCM 蒸馏、稀疏注意力、4~8 步的蒸馏采样;
- 许可宽松:模型以 Apache 2.0 协议开源,生成内容版权归用户。
这套"基座大模型 + 条件权重外挂 + 蒸馏量化加速"的工程范式,正在成为国内大模型团队开源的标配打法——既复用了基座的能力,又把部署门槛压到了社区可承受的范围。
9.2 技术局限
- 图像转视频的超时退化:超过约 1 分钟后色偏加剧,官方建议先用平移/缩放把图片变成视频再驱动;
- 镜头运动仍是弱项:流式模式下镜头只能近似模仿源视频,长视频的精确运镜控制仍是待解问题;
- 多人与泛化:多人权重已发布,但对动漫、动物等非真人域的泛化仍需后续工作。团队后续的 LongCat-Video-Avatar 已用 Whisper 替换 wav2vec 并扩展到风格化域——这是后续工作面向新任务目标的独立技术路线选择,不构成对 InfiniteTalk 音频编码器设计的否定(两者面向的场景与约束不同)。
9.3 产业影响与展望
更深一层看,当"表演"可以被音频重新生成,配音行业的生产关系将被重写——译制片的"口型演员"、虚拟主播的"中之人"、教育视频的真人出镜,都可能被这条技术曲线重新定义。技术局限(9.2)是会随迭代收敛的工程问题,而生产关系的重排一旦发生便不可逆,这或许是稀疏帧配音范式最值得持续观察的地方。
十、结语
InfiniteTalk 的价值,远不止于一个数字人模型。它的真正贡献是一次范式融合:把音频驱动人像生成的全身表现力,装进视频配音的保真约束里,再用流式架构解锁无限时长。方法层面,它示范了一条清晰的技术路线——把"条件生成的控制强度"从模型结构问题转化为训练分布问题,用上下文帧解决长程一致性,用稀疏关键帧换取全身表现力,再把整套系统以开源、低门槛的方式交付给社区。稀疏帧配音这一思路,若能在后续工作中被验证和扩展,有潜力成为音频驱动视频生成的重要范式之一——现在就断言它达到"潜空间扩散"之于图像生成的地位还为时过早,毕竟目前只有一个团队的一个工作。
无限时长的数字人不再是演示视频里的噱头,而是一个开源仓库、一张消费级显卡就能跑起来的现实。接下来要观察的,是它何时从"能看"走到"敢用"——而那个转折点,往往就藏在第八章的实测数据里。
创作不易,禁止抄袭,转载请附上原文标题及其链接。
参考资料
主文献
1. Yang, S., Kong, Z., Gao, F., et al. *InfiniteTalk: Audio-driven Video Generation for Sparse-Frame Video Dubbing*. arXiv:2508.14033, 2025. [论文页面](https://arxiv.org/abs/2508.14033) | [HTML 全文](https://arxiv.org/html/2508.14033v1)
2. InfiniteTalk 开源仓库(Apache 2.0 协议): [github.com/MeiGen-AI/InfiniteTalk](https://github.com/MeiGen-AI/InfiniteTalk)
3. InfiniteTalk 项目主页(含演示视频): [meigen-ai.github.io/InfiniteTalk](https://meigen-ai.github.io/InfiniteTalk/)
基座与组件
4. Wan2.1 通义万相图像转视频基座: [github.com/Wan-Video/Wan2.1](https://github.com/Wan-Video/Wan2.1)
5. wav2vec 2.0 音频编码器: [arxiv.org/abs/2006.11477](https://arxiv.org/abs/2006.11477)
6. MeiGen-MultiTalk(前代多人模型): [github.com/MeiGen-AI/MultiTalk](https://github.com/MeiGen-AI/MultiTalk)
第二章提到的两条技术线代表工作
7. Wav2Lip: [arxiv.org/abs/2008.10010](https://arxiv.org/abs/2008.10010)
8. SadTalker (CVPR 2023): [arxiv.org/abs/2211.12194](https://arxiv.org/abs/2211.12194)
9. PD-FGC (2022): [arxiv.org/abs/2211.14506](https://arxiv.org/abs/2211.14506)
10. DreamTalk (2023): [arxiv.org/abs/2312.06562](https://arxiv.org/abs/2312.06562)
11. Hallo (2024): [arxiv.org/abs/2406.08801](https://arxiv.org/abs/2406.08801)
12. EchoMimicV2 (arXiv 2024.11,CVPR 2025): [arxiv.org/abs/2411.10061](https://arxiv.org/abs/2411.10061)
13. IMTalker (arXiv 2025.11,ACM MM 2025): [arxiv.org/abs/2511.22167](https://arxiv.org/abs/2511.22167)
14. LatentSync: [arxiv.org/abs/2412.10116](https://arxiv.org/abs/2412.10116)
15. MuseTalk: [github.com/TMElyralab/MuseTalk](https://github.com/TMElyralab/MuseTalk)
16. StableAvatar(同期无限时长工作): [arxiv.org/abs/2508.08202](https://arxiv.org/abs/2508.08202)
评测数据集
17. HDTF: [arxiv.org/abs/2007.08552](https://arxiv.org/abs/2007.08552)
18. CelebV-HQ: [arxiv.org/abs/2207.12980](https://arxiv.org/abs/2207.12980)