本文摘要:技能条目从 3 条涨到 40 条后,首字变慢、同一提示还常命中错条目。用离线模拟器把成本拆成常驻总量与命中前扫描量,再按长短序对照重排。重排能压低命中前成本,结论仅适用于本次记录的环境与目录约定。
一、问题与结论
上周团队把 .agents/skills 扩到 40 条,两天后三名工程师同时报障:会话启动到第一个有效动作的间隔变长;同一段 prompt 反复跑,选中的 skill 不稳定;个别约束直接被忽略。这不是 skill 不好用,而是约束进入上下文的成本在累积。
要拆的是两个量:常驻总量随条数单调上涨,命中前扫描量随排列剧烈变化。「条数涨了所以慢」这个抱怨里,真正可控的是后者。真实墙钟耗时必须自测,本文只给离线口径、脚本与校验点,不报告未测量的数值。
记录口径先说清:skill 来源用 git rev-parse HEAD 加抓取日期标识,harness 用 claude –version 原样落盘,全文不引用具体版本号——发现规则随版本变化,结论必须带版本域。另需注意:mattpocock/skills 自述的目录是 .agents,与 Claude Code 实际扫描的目录名是否一致未确认;拷错目录时测出的是「0 条 vs 0 条」。
二、排查与选择依据
排查按三个检查点推进,顺序不能颠倒:
替代方案与取舍
| 人工裁剪常驻集 | 条数 >10 且高频条目少 | 一次性整理成本低 | 条数 <5,收益不明显 |
| 摘要索引 + 正文按需读 | harness 支持按需读取 | 摘要与正文两份维护 | 不支持按需读取,会退化成全量常驻 |
| 约束上移到 CLAUDE.md | 硬约束少且稳定 | 约束总量已大时上移更糟 | 分层后仍超预算 |
| 知识外部化到仓库文档 | 知识更新频繁 | skill 只留触发条件与步骤骨架 | 需要即时准确的现场知识 |
把「一次读完」换成「命中才读」,省下的是常驻总量,代价是多一层组织约定与维护面;只在一个 CLI 内使用时,不必提前抽象成多 harness 结构。选择原则是先量、再裁、再调顺序,最后才谈架构改造,多数团队的收益在第一步就拿完了。
三、关键原理
Skill 是文本资产,不是运行时库:它的成本形态是「被读入 prompt 的字符/token 量」,不是进程开销,所以慢的第一解释应是 input token 与首字延迟,而不是 CPU。
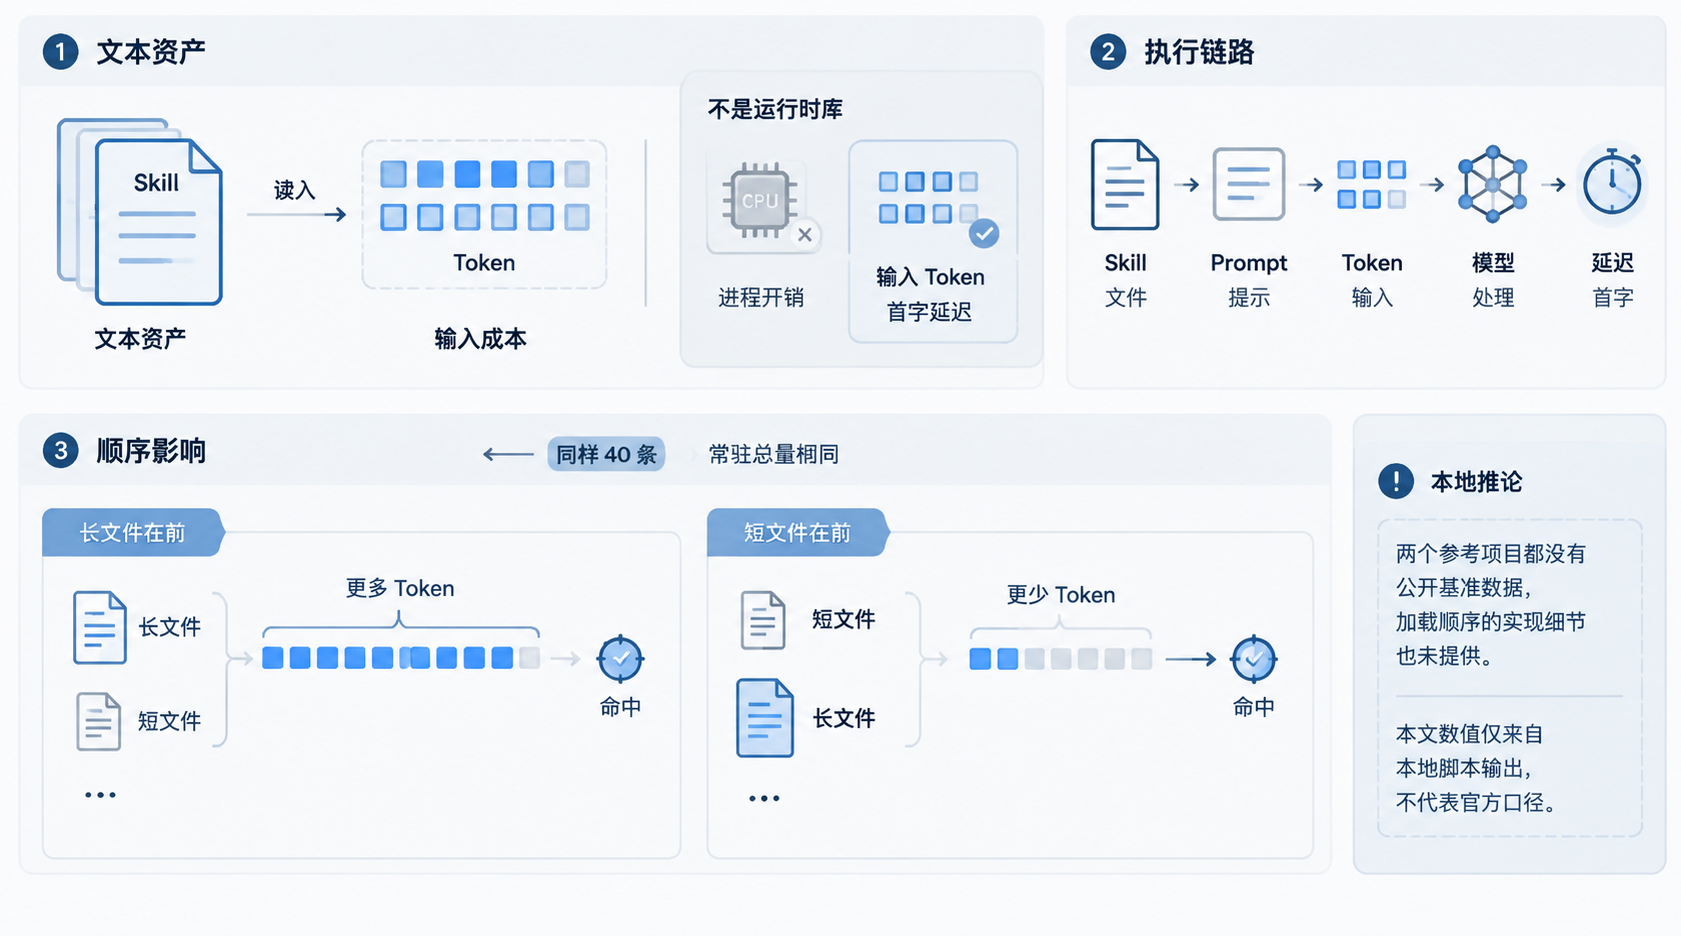
同样是 40 条,长文件排在前面时命中前要扫过的 token 明显多于短文件在前,而常驻总量一行都不变。这正是可以靠顺序控制的部分。
以上是推论:两个参考项目都没有公开「skill 数量 → 延迟/token」的基准数据,加载顺序的实现细节也未提供;本文数值只能来自本地脚本输出,不代表官方口径。
四、可运行示例
环境:Python 3.8+ 标准库,零第三方依赖,离线部分不联网。技能目录 ./skills(40 个 .md),对照组 ./skills_small(3 个)。
python3 skill_load_bench.py –dir ./skills_small –trials 300 –seed 42
python3 skill_load_bench.py –dir ./skills –trials 300 –seed 42
#!/usr/bin/env python3
# skill_load_bench.py — 离线统计常驻总量 vs 命中前扫描量(确定性,零依赖)
import argparse, os, random, sys
def est(text):
return max(1, (len(text) + 3) // 4) # 字符/4 粗估,仅用于横向对比
def load(root):
out = []
for base, dirs, files in os.walk(root):
dirs.sort()
for f in sorted(files):
if f.lower().endswith((".md", ".markdown")):
p = os.path.join(base, f)
with open(p, encoding="utf-8", errors="replace") as fh:
out.append((os.path.relpath(p, root), est(fh.read())))
return out
def cost(order, target, mode):
if mode == "all":
return sum(t for _, t in order), len(order)
s = 0
for i, (name, tok) in enumerate(order):
s += tok
if name == target:
return s, i + 1
return s, len(order)
def pct(xs, q):
xs = sorted(xs)
return xs[min(len(xs) – 1, int(q * (len(xs) – 1)))]
ap = argparse.ArgumentParser()
ap.add_argument("–dir", required=True)
ap.add_argument("–trials", type=int, default=300)
ap.add_argument("–seed", type=int, default=42)
a = ap.parse_args()
if not os.path.isdir(a.dir):
sys.exit(f"目录不存在: {a.dir}")
items = load(a.dir)
if not items:
sys.exit("未找到 .md 文件(请确认目录名与扩展名)")
print(f"skill 数量 = {len(items)} est_tokens = {sum(t for _, t in items)}")
rnd = random.Random(a.seed)
print(f"{'排列':<12}{'命中前 token p50':>16}{'p95':>8}{'文件数 p50':>10}{'相对 A':>8}")
base = None
for name, order in [("A 字典序", items),
("B 长文件在前", sorted(items, key=lambda x: –x[1])),
("C 短文件在前", sorted(items, key=lambda x: x[1])),
("D 随机排列", None)]:
toks, nfiles = [], []
for _ in range(a.trials):
tgt = rnd.choice(items)[0]
o = order if order is not None else rnd.sample(items, len(items))
t, n = cost(o, tgt, "seq")
toks.append(t); nfiles.append(n)
p50, p95 = pct(toks, .5), pct(toks, .95)
if base is None:
base = p50
print(f"{name:<12}{p50:>16}{p95:>8}{pct(nfiles, .5):>10}{p50 / base:>7.2f}x")
all_tok = cost(items, None, "all")[0]
mid = pct([cost(items, rnd.choice(items)[0], "seq")[0] for _ in range(a.trials)], .5)
print(f"全量常驻 = {all_tok} est_tokens | 扫描命中中位 = {mid}")
预期输出(格式示意;数值随本地 skill 文件的字符数变化,排序关系由算法决定):
skill 数量 = <条数> est_tokens = <合计>
排列 命中前 token p50 p95 文件数 p50 相对 A
A 字典序 <p50> <p95> <n> 1.00x
B 长文件在前 <p50> <p95> <n> >1.00x
C 短文件在前 <p50> <p95> <n> <1.00x
D 随机排列 <p50> <p95> <n> ≈1.00x
全量常驻 = <合计> est_tokens | 扫描命中中位 = <中位>
实际输出的校验点有两条:est_tokens 应约等于该目录字符总数 ÷ 4(两组分别核对);B 行相对 A 大于 1、C 行小于 1 且差距明显。若四行数值几乎相同,说明目录没被扫到或样本过小。对照组 ./skills_small 上 B/C 与 A 的差距会明显收窄,这本身就是「规模 vs 顺序」两个量的对照。
响应耗时用 live_latency.py 自测落盘,本文不给数值:
#!/usr/bin/env python3
# live_latency.py — 原始 JSON 落盘,参数以本地 claude –help 为准
import os, subprocess, sys, time
prompt, out = sys.argv[1], sys.argv[2]
os.makedirs(out, exist_ok=True)
for i in range(10):
t0 = time.perf_counter()
r = subprocess.run(["claude", "-p", prompt, "–output-format", "json"],
capture_output=True, text=True)
dt = time.perf_counter() – t0
with open(f"{out}/run_{i:02d}.json", "w", encoding="utf-8") as fh:
fh.write(r.stdout or r.stderr)
print(f"run {i}: wall={dt:.2f}s rc={r.returncode}")
读数纪律:报 p50/p95 而非单次,每组 ≥10 次,两组交替运行以抵消时段性排队。
常见失败有四类:目录约定错位——token 不随条数变化、约束不生效,先用离线脚本确认文件被扫到,再贴一条必然触发的 skill 做正向验证;计时口径错位——方差大于均值差、同配置重跑 p50 漂移超三成,须交替运行并做双指标对照;变量未隔离——成套系统的 memory、instincts 被算到 skill 头上;上下文超限触发截断——表现为质量回退而非变慢,应与延迟分开归因。
五、结论边界与适用范围
边界三条:不跨 harness 外推,affaan-m/ECC 面向 Claude Code、Codex、Opencode、Cursor 等多环境,正说明发现规则与目录约定并不统一;不用单次计时下结论;延迟、token 成本、输出质量分开归因,上下文截断属于质量回退,不算「变慢」。
可迁移的排查顺序:先量常驻总量 → 确认加载生效 → 延迟与 token 双指标对照 → 变量隔离 → 再谈重排或按需读取。适用场景是条数 ≥10、命中不稳定且能固定其余配置;条数 <5、harness 不支持按需读取、或无法把网络噪声分离出来时,不应套用本文做法。
参考资料
- mattpocock/skills
- affaan-m/ECC