黄金周购物热搜刷屏的同一周,我想回答一个更基础的问题:香港人到底在网上花多少钱? 政府统计处的月度零售数据给了完整答案——我把「零售业总销货值」和「网上零售销货值」两张表一起拉了下来:总表 263 个月(2004 年 10 月到 2026 年 8 月)、网上表 80 个月,零鉴权。对账结果有三个反直觉:网购占比五年翻 4 倍(3.3% → 14.6%),但峰值是 2025 年 10 月的单月脉冲,今年已回落到 9% 以下;网上销货值 2025 年创新高,占比却反而下滑;以及一个我差点踩进去的字段陷阱——同一列里混着三种计量单位,按字段名分组会把它们搅成一锅粥。
目录
-
- 一、两张表,和一个会骗人的字段
- 二、share 80 个月:翻 4 倍、平台三年、单月脉冲
- 三、总量:2025 创新高,占比却回落
- 四、三个坑和三条边界
一、两张表,和一个会骗人的字段
两张表都走统计处零鉴权接口:620-67001(零售总销货值)与 620-67031(网上零售销货值),后者自带官方口径的「占零售总销货值百分比」。环境 Python 3.13 标准库即可。先说那个坑:网上表的 sv 字段只有一个值(VAL_ONLINE_RS),但 svDesc 却有三种语义——「百万港元」「占总销货值百分比」「同比 %」混在同一列里。按 sv 分组等于把三种单位搅在一起;正确姿势是先数 svDesc 的取值分布,再按语义拆开:
import json, collections
onl = json.load(open("原始返回/retail_online.bin",
encoding="utf-8-sig"))["dataSet"]
sem = collections.Counter(str(r["svDesc"]).split(" (")[0] for r in onl)
assert set(sem) == {"HK$ million", "% share of total retail sales",
"Year-on-year % change"}
def pick(prefix):
return {str(r["period"]): r["figure"] for r in onl
if r["freq"] == "M" and str(r["OUTLET_TYPE"]) == ""
and str(r["svDesc"]).startswith(prefix)}
onval, share = pick("HK$"), pick("% share")
ms = sorted(share)
assert len(ms) == 80 and (ms[0], ms[–1]) == ("202001", "202608")
print("svDesc 三种语义已拆分;share 序列 80 个月:", ms[0], "→", ms[–1])
另一个小坑记下来:这两张表的 period 是 202608 这种六位无连字符格式——我第一版按 YYYY-MM 解析直接崩了。不同政府接口的期间格式不统一(有的带横杠、有的是六位数、年度行还是四位),解析前先打印三个样本再动手,比背格式省事得多。数据抓取的老规矩也照走:两张表各抓两次、比对内容指纹一致才开始解析;总表 263 个月逐月核对无断档、无空值,VAL_RS 每一格都是整数——这两道前置检查做完,后面所有百分比才有资格被引用。
二、share 80 个月:翻 4 倍、平台三年、单月脉冲
官方占比序列走的是四段:
tot = json.load(open("原始返回/retail_total.bin",
encoding="utf-8-sig"))["dataSet"]
val = {str(r["period"]): r["figure"] for r in tot
if r["freq"] == "M" and r["sv"] == "VAL_RS"}
assert len(val) == 263 and all(isinstance(v, int) for v in val.values())
assert share["202001"] == 3.3 and share["202008"] == 7.1
assert share["202201"] == 9.1 and share["202510"] == 14.6
assert share["202608"] == 8.7
assert max(share, key=share.get) == "202510"
# 交叉验证:官方 share vs 自算 onval/val
bad = [m for m in ms if m in val
and abs(share[m] – onval[m] / val[m] * 100) > 0.05]
assert len(bad) == 1 and bad[0] == "202107"
print("80 个月里 79 个月官方 share 与自算一致;唯一例外 2021-07(舍入级偏差)")
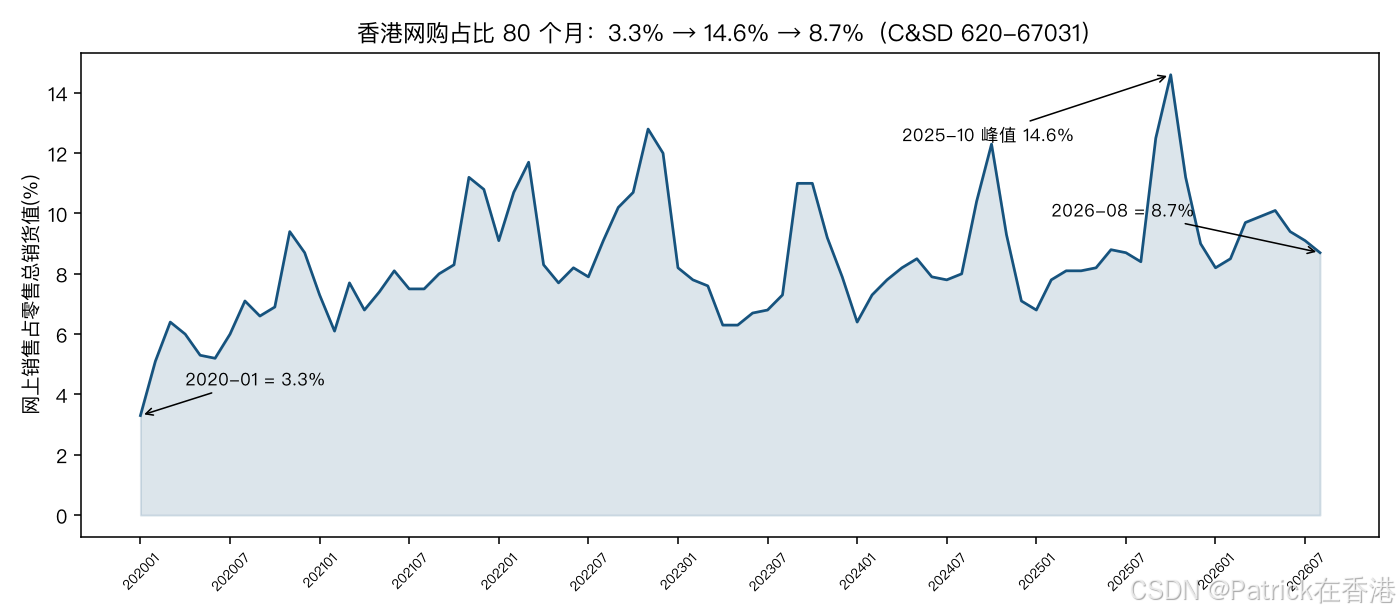
四段是:2020-01 起点 3.3%,疫情头几个月直接翻倍到 7.1%;2022 年 1 月以 9.1% 进入平台期,在 9% 上下横了三年;2025 年 10 月单月冲上 14.6%——全序列最高点,次月就回落到 11.2%;2026 年回到 8-9% 区间,8 月收在 8.7%。曲线是带年度脉冲的锯齿,不是平滑上行:每年第四季都有尖峰,2025 年那个尖只是被垫得最高。这些第四季尖峰的来历不难猜——年末购物季都落在这个窗口,官方统计按月归档,脉冲就留在月度序列里。但注意 2025-10 之前的每个尖峰都在 11-13% 一带,唯独 2025 年那根扎到 14.6%,比前两年高出一截;它是活动节奏还是基数效应,单凭这张表判断不了,能确定的是「占比的顶部在抬升,而中枢没有同步抬升」——峰值创新高、均值还在 9%,这两句话必须同时说。用单月峰值说「香港网购爆发」和用 8.7% 说「网购退潮」,都是只看一个点的误读——官方占比、自算占比、80 个月锯齿,三个视角放在一起才有结论。
三、总量:2025 创新高,占比却回落
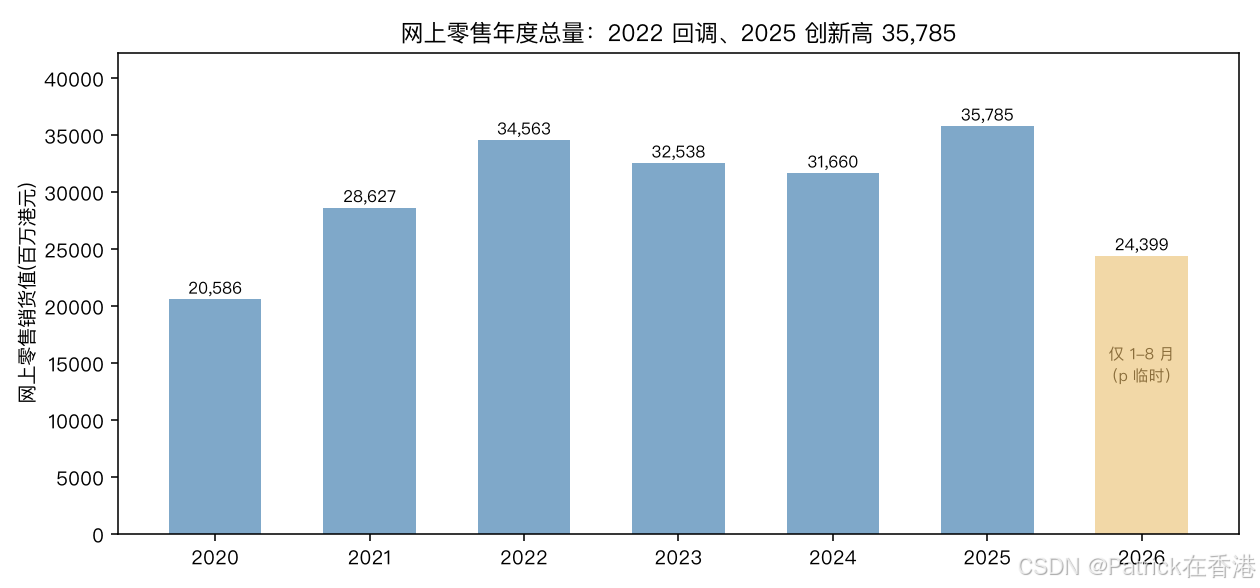
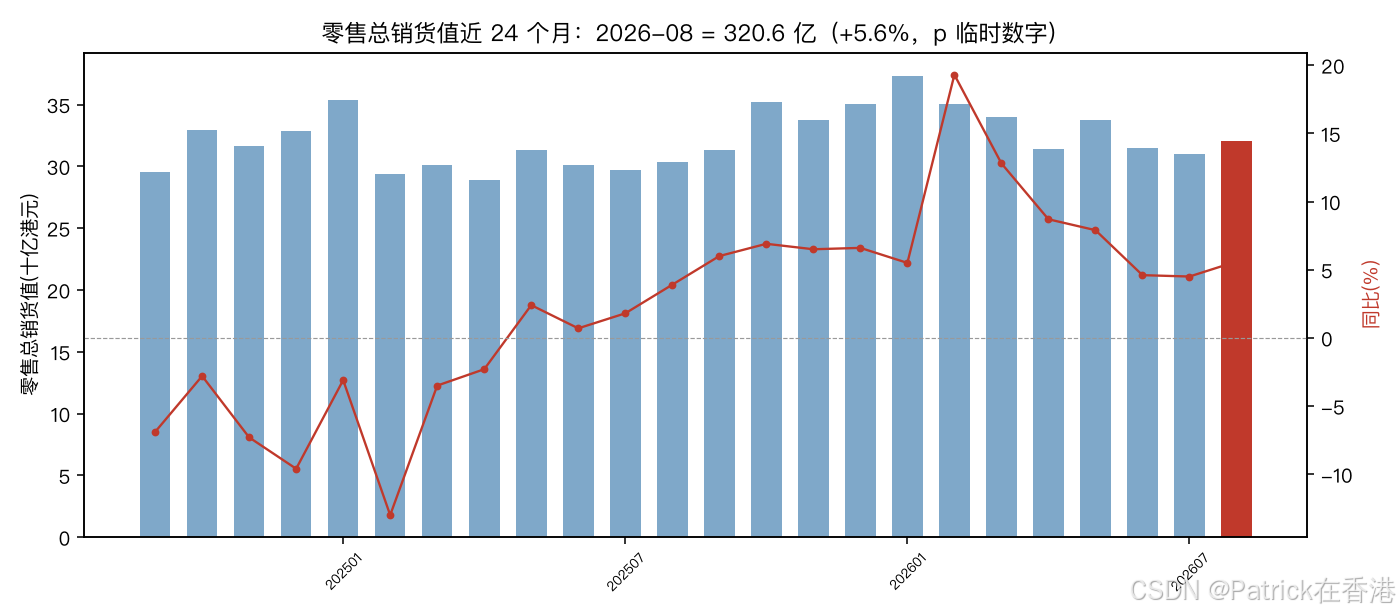
矛盾点在两张表的对照里:网上销货值 2025 年全年 357.85 亿港元,创序列新高;但同期占比反而从峰值回落。解释只有一个——大盘涨得比网上快:零售总销货值 2026 年前 8 个月 2,660.75 亿,同比 +8.5%;8 月单月 320.6 亿,同比 +5.6%。网上盘子在长(2020 年才 205.9 亿),实体盘子长得更快,占比自然被稀释。再看网上盘子自己的形状,还有第四个反直觉:它不是一路向上——2022 年 345.6 亿见顶后,2023、2024 连续两年回调(325.4 亿、316.6 亿),2025 年才重新创新高。疫情催生的线上习惯在 2023 年退过一波潮,两年后才爬回来。占比回落和总量创新高同时发生,说明这不是「线上退潮」,而是「实体恢复更快」——把两张表拆开读和放在一起读,结论完全不同。
yr = collections.Counter()
for m, v in onval.items():
yr[m[:4]] += v
assert yr["2020"] == 20586 and yr["2025"] == 35785
s26 = sum(val[f"2026{mm:02d}"] for mm in range(1, 9))
s25 = sum(val[f"2025{mm:02d}"] for mm in range(1, 9))
assert (s26, s25) == (266075, 245182)
assert round((val["202608"] / val["202508"] – 1) * 100, 1) == 5.6
print(f"网上 2025 = {yr['2025']:,};总销货 2026 前 8 月 +8.5%,8 月 +5.6%")
四、三个坑和三条边界
坑一:p 临时标记。 最新月 2026-08 在两张表里所有行都带「p」(provisional)——临时数字,下期修订。引用最新月必须标注,别拿它做趋势定论。
坑二:恒等式差 1 不一定是错。 网上表的两个分项(无店铺零售 + 其他零售)加总与 Total 在 13 个月里对不平,但差值全部是 ±1(百万港元)——四舍五入噪声,不是数据错误。判断恒等式破没破,先看差值的量级和单位,再下结论;我在罪案表里逐月 diff=0,在这张表就得给 ±1 的容差。
坑三:口径写在备注里。 官方备注写明:只要「通过本地零售商自设网络提交订单」就算网上销售,支付可以线上也可以线下——这个口径比「电商平台成交额」宽,拿它跟内地网零占比直接比是跨口径误用。
边界:月度数据滞后约两个月(最新到 2026-08);网上表只有 2020 年起的数据(总表可回溯到 2004 年);本文只对账官方统计,不构成任何消费或投资判断。
这段 svDesc 拆分和双表交叉验证代码可以直接搬走,收藏备用;如果这篇帮你校准了「香港网购」的体感,收藏+点赞。 你做过「官方占比字段 vs 自算」的交叉验证吗?对不上的时候先查什么?评论区聊聊。这类香港公开数据对账持续更新,关注不迷路。
参考链接