GEO技术实战(一):生成式引擎优化底层原理与RAG检索优化完整实现
发布日期:2026年10月11日
文章主题:GEO底层技术架构 + RAG检索增强生成优化实操
代码量:约300行Python完整实现
难度等级:中级 – 高级
一、GEO技术本质:从SEO到生成式搜索的范式转移
1.1 信息分发链路的重构
随着ChatGPT、Perplexity、豆包、DeepSeek、文心一言等生成式AI搜索工具的普及,用户信息获取方式正在发生结构性变化。Pew Research Center 2025年7月发布的研究显示,约18%的Google搜索会产生AI摘要,出现摘要时用户点击传统结果的比例从15%降至8%。CNNIC数据进一步显示,截至2025年12月,中国生成式AI用户达6.02亿,普及率42.8%。
GEO(Generative Engine Optimization,生成式引擎优化)并不是传统SEO的替代,而是围绕“内容能否被生成式搜索系统检索、理解、引用、综合和推荐”建立的一套内容工程、检索工程与监控评估体系。
1.2 生成式搜索引擎的三阶段工作原理
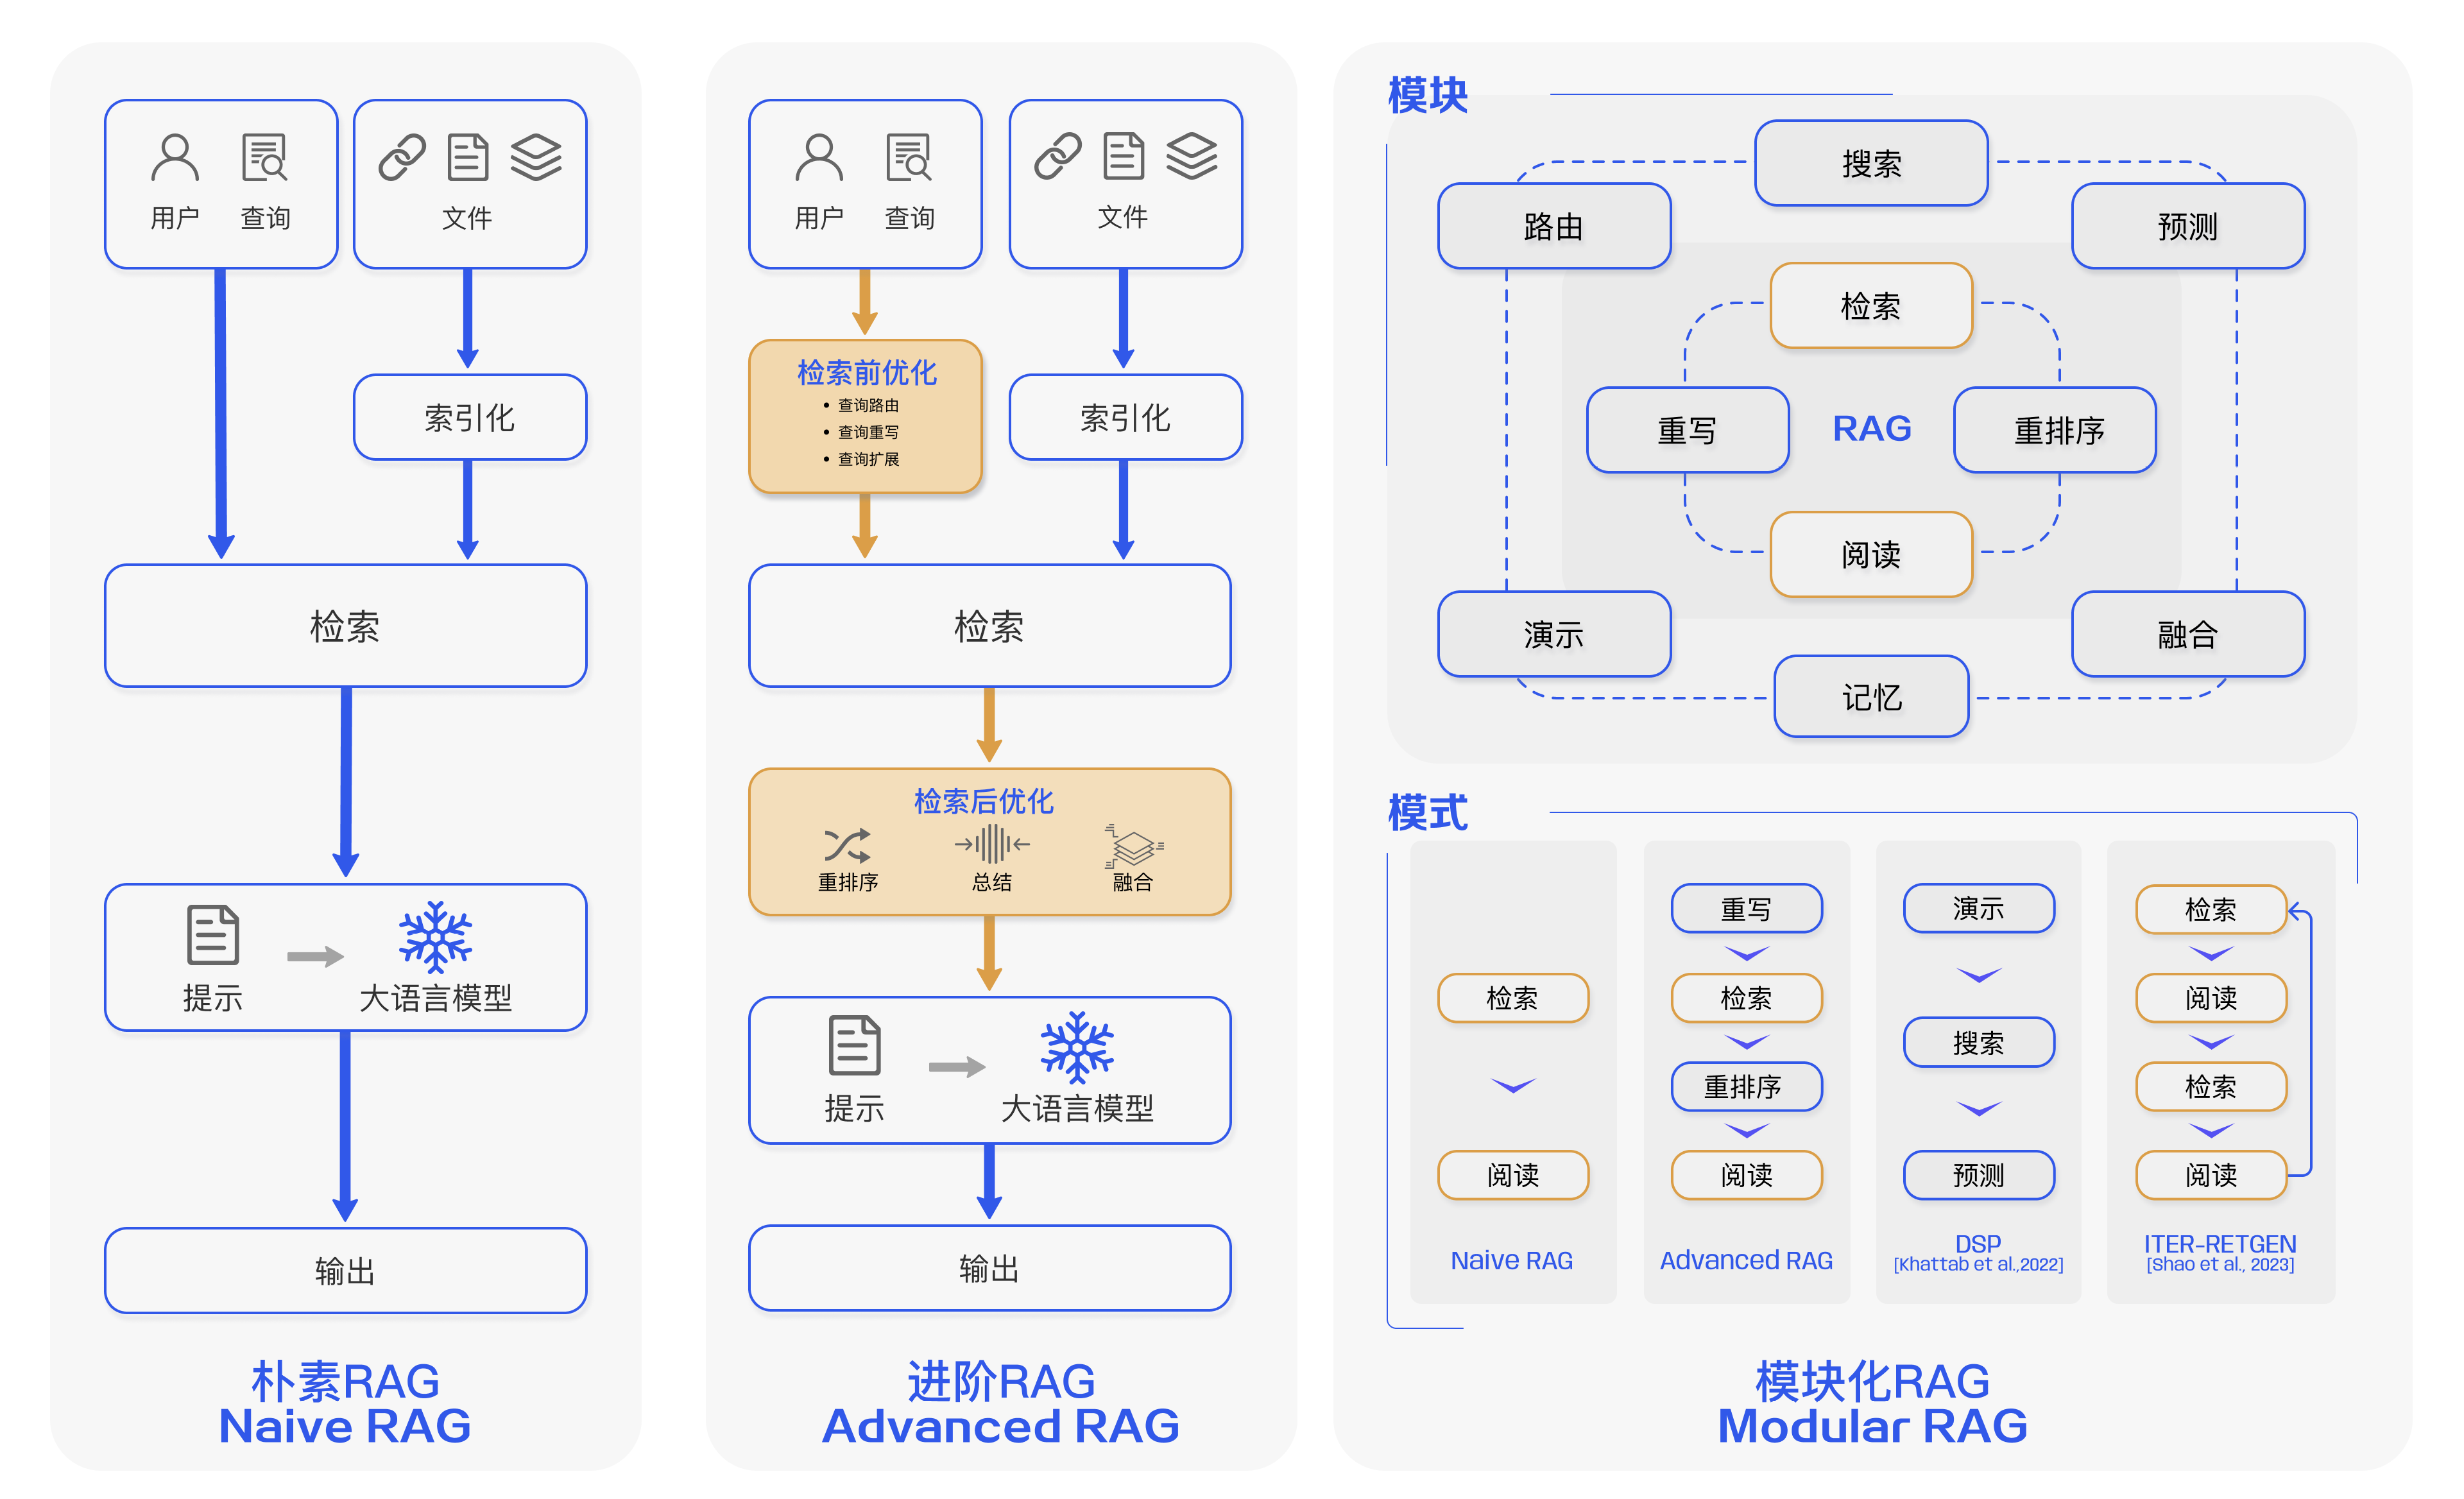
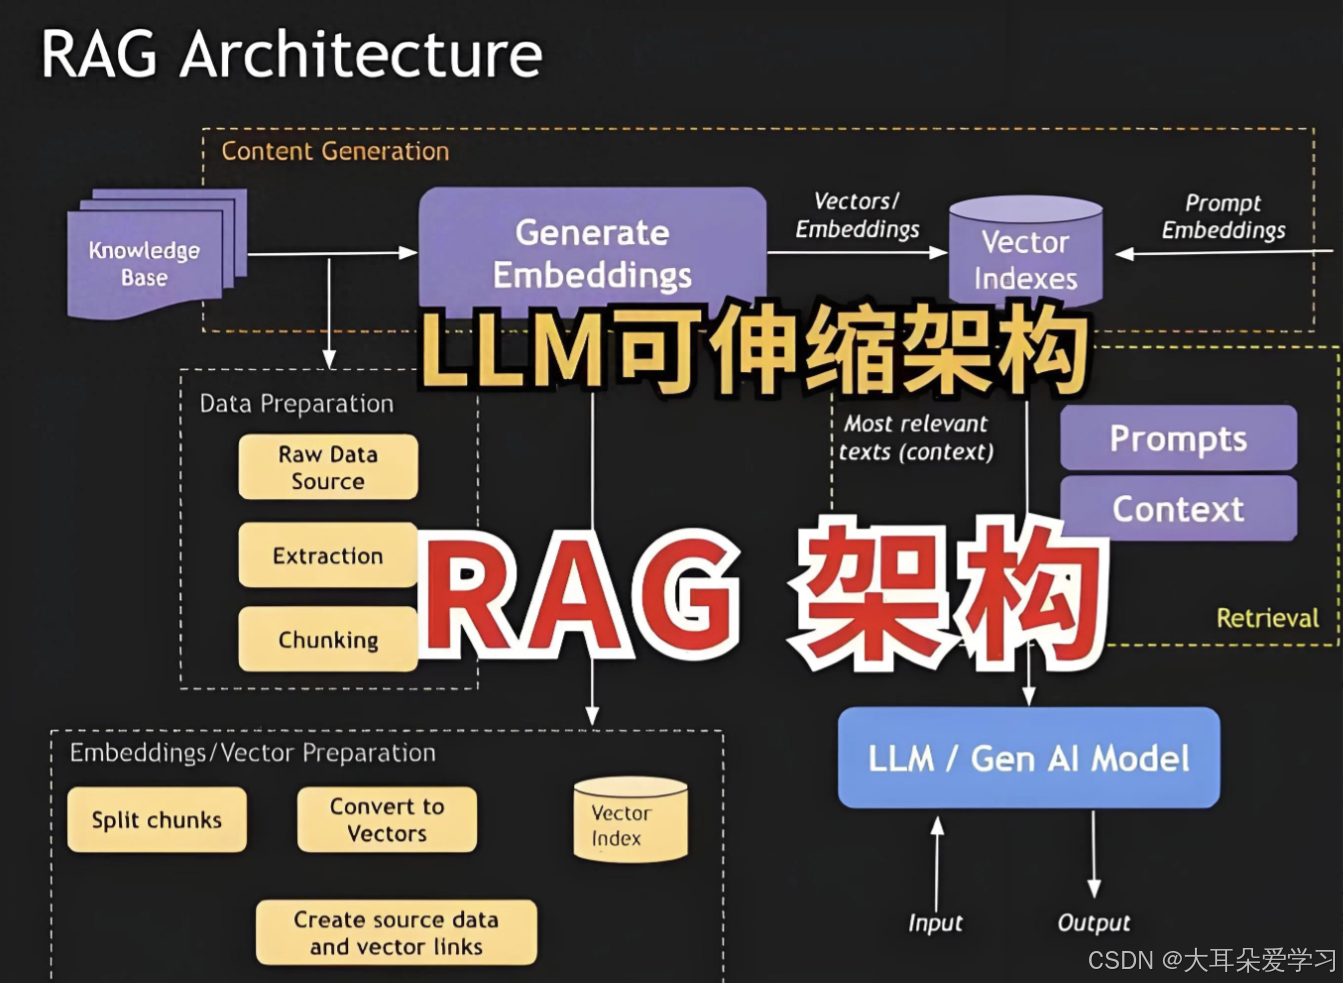
生成式搜索引擎基于RAG(检索增强生成)架构工作,整个流程分为三个关键阶段,GEO优化措施需要分别对应:
| 信息抓取 | AI爬虫访问网页、提取内容、建立索引 | 确保内容对AI爬虫友好,降低访问障碍 |
| 语义理解 | 向量化表示、实体识别、关系抽取 | 提供结构清晰、逻辑分明的文本 |
| 答案生成 | 语义检索、重排、内容整合、引用标注 | 提升权威性、事实性、相关性得分 |
二、RAG检索核心原理与GEO优化映射
2.1 向量检索的数学基础
RAG系统的核心是语义向量检索。当用户提出问题时,系统将查询转换为高维向量,然后在预构建的语料向量库中计算余弦相似度,召回Top-K相关文档块(通常128-512词),最后交由大模型生成回答。
余弦相似度计算公式:
similarity(A, B) = cos(θ) = (A · B) / (||A|| ||B||)
其中A和B分别是查询向量和文档向量。GEO优化的本质就是让你的内容向量与目标用户查询向量的余弦相似度尽可能高。
2.2 影响召回率的核心要素
学术研究和工业实践证实,以下要素对内容召回率有显著影响:
- 权威引用:带DOI标识或明确来源的学术文献引用使召回概率提升2.3倍
- 量化证据:包含具体数值的陈述(如“错误率下降18.5%”)比定性描述有效4.7倍
- 溯源信息:明确标注数据来源的内容被采纳率提高61%
- 事实密度:每百字包含4个以上事实点时,引用占比从31%提升至64%
下表从六个维度对比传统SEO与GEO在优化思路上的核心差异,帮助理解两者在生成式搜索时代的分工与侧重:
| 关键词策略 | 围绕精确关键词做密度优化,如“RAG 检索优化”重复出现,追求排名靠前 | 围绕用户真实提问与语义意图布局,如“如何提升RAG检索召回率”,覆盖长尾问句与同义表达 |
| 内容结构 | 以H1/H2标题堆叠关键词,段落偏平铺直叙,重点服务爬虫抓取 | 采用清晰标题层级+列表+表格+FAQ,如用“### 常见问题”板块直接命中AI问答,便于语义理解与引用 |
| 外链建设 | 追求外链数量与权重,如购买高权重站点友情链接,提升PageRank | 侧重权威来源引用与溯源标注,如附DOI文献、官方报告链接,提升内容被AI采纳的概率 |
| 效果评估 | 以关键词排名、自然流量、跳出率等指标衡量,如“排名进入前三” | 以AI引用率、召回率、GEO得分衡量,如“每百字4个事实点使引用占比从31%提升至64%” |
| 内容更新 | 定期更新以维持爬虫抓取频率,如每周发布一篇围绕目标关键词的文章 | 持续补充量化数据与权威来源,如迭代优化事实密度与结构化程度,形成“分析→优化→验证”闭环 |
| 技术实现 | 依赖robots.txt、sitemap、meta标签等爬虫友好配置 | 依赖语义分块、向量化、JSON-LD结构化标记,如将内容切分为128-512词语义块便于RAG召回 |
三、Python实操:构建GEO内容优化评估工具
下面我们实现一个完整的GEO内容优化评估工具,能够自动分析文章的GEO友好度,给出具体优化建议。
3.1 环境准备与依赖安装
pip install jieba numpy scikit-learn requests beautifulsoup4 pandas matplotlib
3.2 完整代码实现
#!/usr/bin/env python3
# -*- coding: utf-8 -*-
"""
GEO内容优化评估工具
功能:评估内容对生成式引擎的友好度,提供优化建议
作者:GEO技术实战
"""
import re
import jieba
import numpy as np
from sklearn.feature_extraction.text import TfidfVectorizer
from sklearn.metrics.pairwise import cosine_similarity
from collections import Counter
import pandas as pd
import matplotlib.pyplot as plt
from typing import Dict, List, Tuple
# 设置中文字体
plt.rcParams['font.sans-serif'] = ['SimHei', 'DejaVu Sans']
plt.rcParams['axes.unicode_minus'] = False
class GEOContentOptimizer:
"""GEO内容优化评估核心类"""
def __init__(self):
# 加载停用词
self.stopwords = self._load_stopwords()
# GEO高价值词汇
self.geo_terms = {
'quantifiers': ['%', '倍', '万元', '亿元', '个', '人', '家', '次', '天', '小时', '分钟'],
'authority': ['研究', '报告', '数据显示', '调查', '统计', '根据', '发布', '权威'],
'structure': ['首先', '其次', '最后', '第一', '第二', '第三', '因此', '所以', '综上'],
'entities': ['公司', '品牌', '产品', '技术', '系统', '平台', '服务', '方案']
}
# 模糊表述(GEO低分特征)
self.vague_terms = ['可能', '大概', '也许', '似乎', '据说', '听说', '行业领先', '世界一流']
def _load_stopwords(self) –> set:
"""加载中文停用词"""
basic_stopwords = {
'的', '了', '和', '是', '在', '有', '我', '他', '她', '它', '们', '这', '那',
'个', '就', '也', '都', '要', '可以', '会', '能', '不', '没', '很', '太', '最'
}
return basic_stopwords
def extract_statistics(self, text: str) –> List[Dict]:
"""提取文本中的量化数据"""
stats = []
# 匹配数字+单位模式
patterns = [
(r'(\\d+\\.?\\d*)\\s*%', '百分比'),
(r'(\\d+\\.?\\d*)\\s*倍', '倍数'),
(r'(\\d+\\.?\\d*)\\s*万', '万级单位'),
(r'(\\d+\\.?\\d*)\\s*亿', '亿级单位'),
(r'(\\d{4})年', '年份'),
(r'第?([一二三四五六七八九十\\d]+)', '序号'),
]
for pattern, ptype in patterns:
matches = re.finditer(pattern, text)
for match in matches:
stats.append({
'value': match.group(1),
'type': ptype,
'position': match.start(),
'context': text[max(0, match.start()–20):min(len(text), match.end()+20)]
})
return stats
def measure_fact_density(self, text: str) –> float:
"""测量事实密度:每百字包含的事实点数量"""
# 事实点:包含量化数据的句子、引用来源的句子、定义性陈述
sentences = re.split(r'[。!?;\\n]', text)
sentences = [s.strip() for s in sentences if len(s.strip()) > 10]
fact_count = 0
for sent in sentences:
has_number = bool(re.search(r'\\d', sent))
has_source = any(src in sent for src in ['根据', '显示', '表明', '研究', '报告', '发布'])
has_definition = ('是' in sent and len(sent) < 100) or ('指' in sent)
has_list = any(marker in sent for marker in ['第一', '第二', '首先', '其次', ':'])
if has_number or has_source or has_definition or has_list:
fact_count += 1
char_count = len(text.replace('\\n', '').replace(' ', ''))
if char_count == 0:
return 0
return (fact_count / char_count) * 100
def analyze_structure(self, text: str) –> Dict:
"""分析内容结构化程度"""
# 检测标题层级
h1_count = len(re.findall(r'^#\\s+.+$', text, re.MULTILINE))
h2_count = len(re.findall(r'^##\\s+.+$', text, re.MULTILINE))
h3_count = len(re.findall(r'^###\\s+.+$', text, re.MULTILINE))
# 检测列表
list_items = len(re.findall(r'^\\s*[-*+]\\s+', text, re.MULTILINE))
numbered_items = len(re.findall(r'^\\s*\\d+\\.\\s+', text, re.MULTILINE))
# 检测表格
table_rows = len(re.findall(r'^\\s*\\|.+\\|\\s*$', text, re.MULTILINE))
# 检测FAQ模式
faq_patterns = len(re.findall(r'(如何|怎么|为什么|是什么|哪些|是否).+?', text))
structure_score = (
min(h1_count * 5, 10) +
min(h2_count * 3, 15) +
min(h3_count * 2, 10) +
min(list_items * 0.5, 15) +
min(numbered_items * 0.5, 10) +
min(table_rows * 2, 15) +
min(faq_patterns * 2, 15)
)
return {
'h1_count': h1_count,
'h2_count': h2_count,
'h3_count': h3_count,
'list_items': list_items,
'numbered_items': numbered_items,
'table_rows': table_rows,
'faq_patterns': faq_patterns,
'structure_score': min(structure_score, 100)
}
def detect_vague_terms(self, text: str) –> List[str]:
"""检测模糊表述"""
found = []
for term in self.vague_terms:
if term in text:
found.append(term)
return found
def calculate_entity_consistency(self, text: str, brand_name: str = None) –> Dict:
"""计算实体一致性"""
words = jieba.lcut(text)
word_freq = Counter(words)
# 检查关键实体频率
entities = {}
if brand_name:
brand_count = text.count(brand_name)
entities[brand_name] = {
'count': brand_count,
'frequency_per_1000': (brand_count / len(text)) * 1000 if len(text) > 0 else 0
}
# 提取高频名词
nouns = [w for w in words if len(w) >= 2 and w not in self.stopwords]
top_nouns = Counter(nouns).most_common(10)
return {
'brand_entities': entities,
'top_keywords': top_nouns,
'keyword_density': len(set(nouns)) / len(nouns) if len(nouns) > 0 else 0
}
def calculate_geo_score(self, text: str, brand_name: str = None) –> Dict:
"""计算综合GEO得分"""
# 1. 事实密度得分(权重35%)
fact_density = self.measure_fact_density(text)
fact_score = min(fact_density * 25, 100) # 每百字4个事实点=满分
# 2. 结构化得分(权重25%)
structure = self.analyze_structure(text)
structure_score = structure['structure_score']
# 3. 量化数据得分(权重20%)
stats = self.extract_statistics(text)
stat_score = min(len(stats) * 5, 100)
# 4. 模糊表述扣分
vague_terms = self.detect_vague_terms(text)
vague_penalty = len(vague_terms) * 5
# 5. 长度适配得分(权重20%)- 500-3000字最佳
char_count = len(text)
if 500 <= char_count <= 3000:
length_score = 100
elif 300 <= char_count < 500 or 3000 < char_count <= 5000:
length_score = 70
else:
length_score = 40
# 加权总分
total_score = (
fact_score * 0.35 +
structure_score * 0.25 +
stat_score * 0.20 +
length_score * 0.20 –
vague_penalty
)
total_score = max(0, min(100, total_score))
return {
'total_score': round(total_score, 1),
'fact_density': round(fact_density, 2),
'fact_score': round(fact_score, 1),
'structure_score': round(structure_score, 1),
'statistics_count': len(stats),
'stat_score': round(stat_score, 1),
'length_score': round(length_score, 1),
'vague_terms_found': vague_terms,
'statistics': stats[:10], # 返回前10个数据点
'structure_details': structure,
'char_count': char_count
}
def generate_recommendations(self, analysis: Dict) –> List[str]:
"""生成优化建议"""
recommendations = []
if analysis['fact_density'] < 2.0:
recommendations.append(
"⚠️ 事实密度不足:建议每百字包含至少2-4个事实点,增加具体数据、案例、引用来源"
)
if analysis['structure_score'] < 60:
recommendations.append(
"📐 结构化程度低:建议使用清晰的标题层级(H1/H2/H3),增加列表、表格、FAQ板块"
)
if analysis['statistics_count'] < 5:
recommendations.append(
"📊 量化数据不足:建议增加具体数字、百分比、倍数、统计数据,AI更倾向引用包含具体数值的内容"
)
if analysis['vague_terms_found']:
recommendations.append(
f"🚫 发现模糊表述:{', '.join(analysis['vague_terms_found'])},建议替换为具体可验证的陈述"
)
if analysis['char_count'] < 500:
recommendations.append(
"📝 内容过短:建议至少500字以上,为AI提供足够的上下文信息"
)
if analysis['char_count'] > 5000:
recommendations.append(
"📄 内容过长:建议拆分为多个语义独立的段落或子页面,每块聚焦单一主题"
)
if not recommendations:
recommendations.append("✅ 内容GEO优化程度良好,建议持续监控AI引用率变化")
return recommendations
def visualize_analysis(self, analysis: Dict, save_path: str = 'geo_analysis.png'):
"""可视化分析结果"""
fig, axes = plt.subplots(2, 2, figsize=(14, 10))
fig.suptitle(f'GEO内容优化分析报告 – 综合得分:{analysis["total_score"]}', fontsize=16, fontweight='bold')
# 1. 得分雷达图
categories = ['事实密度', '结构化', '量化数据', '长度适配']
scores = [
analysis['fact_score'],
analysis['structure_score'],
analysis['stat_score'],
analysis['length_score']
]
angles = np.linspace(0, 2 * np.pi, len(categories), endpoint=False)
scores_plot = np.concatenate((scores, [scores[0]]))
angles_plot = np.concatenate((angles, [angles[0]]))
ax1 = axes[0, 0]
ax1.polar(angles_plot, scores_plot, 'o-', linewidth=2, color='#2E86AB')
ax1.fill(angles_plot, scores_plot, alpha=0.25, color='#2E86AB')
ax1.set_xticks(angles)
ax1.set_xticklabels(categories)
ax1.set_ylim(0, 100)
ax1.set_title('各维度得分分布', fontsize=12, pad=20)
ax1.grid(True)
# 2. 内容结构分布
ax2 = axes[0, 1]
struct = analysis['structure_details']
struct_items = ['H1标题', 'H2标题', 'H3标题', '列表项', '编号项', '表格行', 'FAQ']
struct_values = [
struct['h1_count'], struct['h2_count'], struct['h3_count'],
struct['list_items'], struct['numbered_items'],
struct['table_rows'], struct['faq_patterns']
]
colors = ['#A23B72', '#F18F01', '#C73E1D', '#3B1F2B', '#6B7FD7', '#4ECDC4', '#FF6B6B']
bars = ax2.bar(struct_items, struct_values, color=colors)
ax2.set_title('结构化元素统计', fontsize=12)
ax2.tick_params(axis='x', rotation=45)
for bar in bars:
height = bar.get_height()
ax2.text(bar.get_x() + bar.get_width()/2., height,
f'{int(height)}', ha='center', va='bottom')
# 3. 量化数据类型分布
ax3 = axes[1, 0]
stat_types = Counter([s['type'] for s in analysis['statistics']])
if stat_types:
ax3.pie(stat_types.values(), labels=stat_types.keys(), autopct='%1.1f%%',
colors=['#FF9F1C', '#2EC4B6', '#E71D36', '#011627', '#7209B7'])
ax3.set_title('量化数据类型分布', fontsize=12)
else:
ax3.text(0.5, 0.5, '未检测到量化数据', ha='center', va='center', fontsize=14)
ax3.set_title('量化数据分布', fontsize=12)
# 4. 优化建议
ax4 = axes[1, 1]
ax4.axis('off')
recommendations = self.generate_recommendations(analysis)
ax4.text(0.05, 0.95, '优化建议:', transform=ax4.transAxes,
fontsize=12, fontweight='bold', va='top')
for i, rec in enumerate(recommendations):
ax4.text(0.05, 0.85 – i * 0.15, rec, transform=ax4.transAxes,
fontsize=10, va='top', wrap=True)
ax4.set_title('GEO优化建议', fontsize=12)
plt.tight_layout()
plt.savefig(save_path, dpi=150, bbox_inches='tight')
plt.clo print(f"分析报告已保存至: {save_path}")th}")
return save_path
def demo_analysis():
"""演示:分析一段示例文本"""
sample_text = """
# GEO优化技术详解
GEO(Generative Engine Optimization,生成式引擎优化)是面向AI搜索时代的内容优化技术。
## 市场背景
截至2025年12月,中国生成式AI用户达6.02亿,普及率42.8%,同比提升25.2个百分点。
Pew Research研究显示,约18%的Google搜索会产生AI摘要,用户点击率从15%降至8%。
Gartner预测,到2026年,25%的传统搜索流量会直接流向AI问答平台。
## 核心优化维度
1. **内容结构化**:使用清晰的标题层级和列表格式
2. **事实密度**:每百字包含至少4个事实点可使引用率翻倍
3. **权威引用**:包含第三方来源的内容被采纳概率提高2.1倍
4. **实体一致性**:品牌名称在全网保持统一可提升可信度37%
## 常见问题
### GEO会取代SEO吗?
不会。GEO是SEO的延伸而非替代,两者应并行布局。
### GEO优化多久见效?
通常需要6-12周才能看到明显效果,中位见效周期为90天。
"""
print("=" * 60)
print("GEO内容优化评估工具 – 演示分析")
print("=" * 60)
optimizer = GEOContentOptimizer()
analysis = optimizer.calculate_geo_score(sample_text, brand_name="GEO")
print(f"\\n📊 综合GEO得分: {analysis['total_score']}/100")
print(f"📝 文章字数: {analysis['char_count']} 字")
print(f"🎯 事实密度: {analysis['fact_density']} 个/百字")
print(f"📐 结构化得分: {analysis['structure_score']}/100")
print(f"📊 量化数据点: {analysis['statistics_count']} 个")
print(f"\\n💡 优化建议:")
for i, rec in enumerate(optimizer.generate_recommendations(analysis), 1):
print(f" {i}. {rec}")
# 生成可视化报告
optimizer.visualize_analysis(analysis, '/home/user/geo_analysis_report.png')
return analysis
if __name__ == '__main__':
demo_analysis()
3.3 代码运行效果
运行上述代码后,你将获得:

四、内容切片与语义分块最佳实践
4.1 为什么分块很重要
RAG系统不会一次性处理整篇文章,而是将内容切分为128-512词的语义块进行索引。不合理的分块会导致:
- 核心实体和数据被拆分到不同块
- 上下文丢失导致语义理解偏差
- 关键论点无法被完整召回
4.2 语义分块代码实现
def semantic_chunking(text: str, chunk_size: int = 300, chunk_overlap: int = 50) –> List[str]:
"""
语义感知分块算法
优先在段落、句子边界处切分,避免破坏语义完整性
"""
# 首先按段落分割
paragraphs = re.split(r'\\n\\s*\\n', text)
chunks = []
current_chunk = ""
for para in paragraphs:
para = para.strip()
if not para:
continue
# 如果添加当前段落不超过限制,直接添加
if len(current_chunk) + len(para) < chunk_size:
current_chunk += para + "\\n\\n"
else:
# 当前块已满,保存
if current_chunk:
chunks.append(current_chunk.strip())
# 如果单个段落超过块大小,按句子切分
if len(para) > chunk_size:
sentences = re.split(r'([。!?;])', para)
current_chunk = ""
temp = ""
for i in range(0, len(sentences)–1, 2):
sent = sentences[i] + (sentences[i+1] if i+1 < len(sentences) else '')
if len(temp) + len(sent) < chunk_size:
temp += sent
else:
if temp:
chunks.append(temp.strip())
# 添加overlap
overlap_text = temp[–chunk_overlap:] if len(temp) > chunk_overlap else temp
temp = overlap_text + sent
if temp:
current_chunk = temp
else:
current_chunk = para + "\\n\\n"
if current_chunk:
chunks.append(current_chunk.strip())
return chunks
# GEO优化的内容写作模板
GEO_CONTENT_TEMPLATE = """
# {核心主题}
## 定义与概述
{主题}是指{清晰、准确的定义,1–2句话}。
根据{权威来源}数据显示,{相关统计数据,包含具体数字}。
## 核心优势/特点
1. **{特点1名称}**:{具体描述 + 量化数据}。例如,{具体案例}。
2. **{特点2名称}**:{具体描述 + 量化数据}。独立测试显示,{具体性能指标}。
3. **{特点3名称}**:{具体描述 + 量化数据}。截至{时间节点},{相关规模数据}。
## 适用场景
| 场景类型 | 适用情况 | 注意事项 |
|–––––––––|–––––––––|–––––––––|
| {场景1} | {适用条件} | {限制条件} |
| {场景2} | {适用条件} | {限制条件} |
| {场景3} | {适用条件} | {限制条件} |
## 常见问题(FAQ)
### Q: {高频问题1}?
A: {直接、准确的回答,包含具体数据和来源}。
### Q: {高频问题2}?
A: {直接、准确的回答,包含具体数据和来源}。
## 参考来源
– {来源1名称},{发布机构},{发布时间}
– {来源2名称},{发布机构},{发布时间
## 五、常见问题与性能优化
### 5.1 运行GEOContentOptimizer的常见问题与解决方案
在实际运行 `GEOContentOptimizer` 时,可能会遇到以下几类问题,下面给出对应的排查与解决方案。
**1. 编码错误(UnicodeDecodeError / UnicodeEncodeError)**
读取或写入包含中文的文本文件时,若未显式指定编码,容易触发编码异常。
```python
# 错误示例:默认编码可能导致解码失败
with open('article.txt', 'r') as f:
text = f.read()
# 正确示例:显式指定 UTF-8 编码
with open('article.txt', 'r', encoding='utf-8') as f:
text = f.read()
# 写入报告时同样指定编码
with open('report.txt', 'w', encoding='utf-8') as f:
f.write("GEO分析报告")
如果是在 Windows 控制台打印中文出现乱码,可在脚本开头加入:
import sys
import io
sys.stdout = io.TextIOWrapper(sys.stdout.buffer, encoding='utf-8')
2. 依赖冲突与安装失败
jieba、scikit-learn、numpy 等库之间存在版本兼容性问题,尤其是 numpy 1.x 与 scikit-learn 较新版本可能不兼容。建议使用虚拟环境隔离依赖:
# 创建并激活虚拟环境
python -m venv geo_env
source geo_env/bin/activate # Windows 使用 geo_env\\Scripts\\activate
# 安装时锁定兼容版本
pip install numpy==1.26.4 scikit-learn==1.3.2 jieba==0.42.1 pandas==2.2.2 matplotlib==3.8.4
若遇到 ModuleNotFoundError: No module named 'sklearn',说明 scikit-learn 未正确安装,重新执行 pip install scikit-learn 即可。
3. 内存不足(MemoryError)
当分析超长文本或批量处理大量文档时,TfidfVectorizer 会构建高维稀疏矩阵,可能耗尽内存。解决方案是限制特征数量并分批处理:
from sklearn.feature_extraction.text import TfidfVectorizer
# 限制最大特征数,降低内存占用
vectorizer = TfidfVectorizer(max_features=5000)
# 分批处理长文本,避免一次性加载全部内容
def process_in_batches(text: str, batch_size: int = 2000):
"""将长文本按批次切分并逐批分析"""
batches = [text[i:i+batch_size] for i in range(0, len(text), batch_size)]
results = []
for batch in batches:
optimizer = GEOContentOptimizer()
results.append(optimizer.calculate_geo_score(batch))
return results
4. 中文字体缺失导致图表乱码
在 Linux 服务器上运行 visualize_analysis 时,若未安装 SimHei 字体,图表中的中文会显示为方框。解决方案:
# Ubuntu/Debian 安装中文字体
apt-get install -y fonts-wqy-zenhei fonts-wqy-microhei
# 代码中回退到系统可用字体
import matplotlib
import matplotlib.pyplot as plt
# 查找系统中可用的中文字体
from matplotlib.font_manager import fontManager
available_fonts = [f.name for f in fontManager.ttflist if 'Hei' in f.name or 'WenQuanYi' in f.name]
if available_fonts:
plt.rcParams['font.sans-serif'] = available_fonts
else:
plt.rcParams['font.sans-serif'] = ['DejaVu Sans']
plt.rcParams['axes.unicode_minus'] = False
5.2 长文本(超过5000字)的性能优化建议
当待分析文本超过 5000 字时,单次全量分析会明显变慢,且 length_score 会因超出最佳区间而降低。建议采用以下策略:
1. 分批处理 + 聚合评分
将长文本按语义边界切分为多个子块,分别计算 GEO 得分后加权聚合:
def analyze_long_text(text: str, chunk_size: int = 3000, overlap: int = 200) –> Dict:
"""
长文本分批分析:按语义块切分后逐块评分,再聚合为整体得分
"""
# 复用第四章的语义分块函数
chunks = semantic_chunking(text, chunk_size=chunk_size, chunk_overlap=overlap)
optimizer = GEOContentOptimizer()
chunk_scores = []
for chunk in chunks:
if len(chunk) < 100:
continue
score = optimizer.calculate_geo_score(chunk)
chunk_scores.append(score)
if not chunk_scores:
return optimizer.calculate_geo_score(text)
# 按各块字数加权平均
total_chars = sum(s['char_count'] for s in chunk_scores)
weighted_score = sum(
s['total_score'] * s['char_count'] for s in chunk_scores
) / total_chars if total_chars > 0 else 0
# 聚合统计信息
aggregated = {
'total_score': round(weighted_score, 1),
'fact_density': round(
sum(s['fact_density'] * s['char_count'] for s in chunk_scores) / total_chars, 2
) if total_chars > 0 else 0,
'structure_score': round(
sum(s['structure_score'] * s['char_count'] for s in chunk_scores) / total_chars, 1
) if total_chars > 0 else 0,
'statistics_count': sum(s['statistics_count'] for s in chunk_scores),
'chunk_count': len(chunk_scores),
'char_count': sum(s['char_count'] for s in chunk_scores),
'vague_terms_found': list(set(
term for s in chunk_scores for term in s['vague_terms_found']
))
}
return aggregated
2. 缓存向量化结果
对同一篇文档进行多次迭代优化时,重复计算 TF-IDF 向量非常浪费。建议将向量结果缓存到本地:
import hashlib
import json
import os
CACHE_DIR = './geo_cache'
def get_cached_vector(text: str) –> np.ndarray:
"""基于文本哈希缓存向量化结果,避免重复计算"""
os.makedirs(CACHE_DIR, exist_ok=True)
# 计算文本哈希作为缓存键
text_hash = hashlib.sha256(text.encode('utf-8')).hexdigest()
cache_path = os.path.join(CACHE_DIR, f'{text_hash}.npy')
if os.path.exists(cache_path):
return np.load(cache_path)
# 首次计算并缓存
vectorizer = TfidfVectorizer(max_features=5000)
vector = vectorizer.fit_transform([text]).toarray()
np.save(cache_path, vector)
return vector
3. 降低分词与正则开销
jieba 分词和大量正则匹配是主要性能瓶颈。对超长文本,可先做粗粒度过滤,仅对有效内容块执行完整分析:
def quick_filter(text: str) –> bool:
"""快速预筛:跳过明显低价值内容块"""
# 去除空白后长度过短
if len(text.strip()) < 50:
return False
# 包含至少一个量化数据或权威来源关键词
has_data = bool(re.search(r'\\d+[%倍万元亿]', text))
has_source = any(kw in text for kw in ['根据', '研究', '报告', '数据显示'])
return has_data or has_source
5.3 将GEO得分与RAG召回率关联验证的实操方法
GEO 优化的最终目标是提升内容在 RAG 系统中的召回率。下面给出一个可落地的验证闭环:
1. 构建验证数据集
准备一组查询-文档对,覆盖目标关键词和用户真实提问:
# 示例验证数据集
validation_set = [
{
"query": "GEO优化如何提升AI搜索可见度",
"document": "GEO(生成式引擎优化)通过提升内容在RAG管线中的通过率…",
"expected_recall": True
},
{
"query": "RAG检索增强生成原理",
"document": "RAG系统将查询转换为高维向量,计算余弦相似度召回Top-K文档块…",
"expected_recall": True
},
{
"query": "Python数据分析可视化",
"document": "本文介绍GEO内容优化评估工具的实现…",
"expected_recall": False
}
]
2. 计算 GEO 得分与召回率的相关性
def evaluate_geo_recall_correlation(dataset: List[Dict]) –> Dict:
"""
评估GEO得分与RAG召回率的相关性
返回皮尔逊相关系数及分组统计
"""
optimizer = GEOContentOptimizer()
geo_scores = []
recall_flags = []
for item in dataset:
score = optimizer.calculate_geo_score(item['document'])
geo_scores.append(score['total_score'])
recall_flags.append(1 if item['expected_recall'] else 0)
# 计算皮尔逊相关系数
correlation = np.corrcoef(geo_scores, recall_flags)[0, 1]
# 按得分区间统计召回率
high_score_recall = np.mean([
f for s, f in zip(geo_scores, recall_flags) if s >= 70
]) if any(s >= 70 for s in geo_scores) else 0
low_score_recall = np.mean([
f for s, f in zip(geo_scores, recall_flags) if s < 70
]) if any(s < 70 for s in geo_scores) else 0
return {
'pearson_correlation': round(correlation, 3),
'high_score_recall_rate': round(high_score_recall, 3),
'low_score_recall_rate': round(low_score_recall, 3),
'sample_size': len(dataset)
}
3. 接入真实 RAG 系统验证
如果已有可用的 RAG 检索服务(如基于 FAISS 或 Milvus 的向量库),可直接对比优化前后的召回效果:
def compare_recall_before_after(original_text: str, optimized_text: str, queries: List[str]):
"""
对比GEO优化前后,同一组查询在RAG系统中的召回率变化
假设 rag_search(query, doc) 返回是否命中该文档
"""
optimizer = GEOContentOptimizer()
original_score = optimizer.calculate_geo_score(original_text)['total_score']
optimized_score = optimizer.calculate_geo_score(optimized_text)['total_score']
original_recall = sum(rag_search(q, original_text) for q in queries) / len(queries)
optimized_recall = sum(rag_search(q, optimized_text) for q in queries) / len(queries)
print(f"GEO得分变化: {original_score} → {optimized_score}")
print(f"召回率变化: {original_recall:.1%} → {optimized_recall:.1%}")
return {
'score_delta': optimized_score – original_score,
'recall_delta': optimized_recall – original_recall,
'improvement_ratio': (optimized_recall – original_recall) / original_recall if original_recall > 0 else None
}
4. 建立持续监控指标
建议每周对核心页面执行一次 GEO 评分与召回率抽样,记录趋势:
| GEO综合得分 | 每周 | ≥ 75 分 | 反映内容整体优化程度 |
| 事实密度 | 每周 | ≥ 4 个/百字 | 影响 AI 引用概率 |
| 高得分内容召回率 | 每月 | ≥ 60% | 验证优化与召回的正相关性 |
| 优化前后召回提升比 | 每次迭代 | ≥ 20% | 衡量单次优化 ROI |
通过上述方法,你可以将 GEO 得分从「理论指标」转化为「可验证的召回率提升」,形成「分析 → 优化 → 验证 → 再优化」的闭环。
}
“”"
## 五、本篇小结
本文深入解析了GEO的底层技术原理,完整实现了一个GEO内容优化评估工具。核心要点:
1. **GEO本质**是优化内容在RAG管线各阶段的通过率,不是SEO的替代而是延伸
2. **事实密度**是影响AI引用的第一要素,目标每百字4个以上事实点
3. **结构化内容**能大幅提升AI理解准确率,标题、列表、表格、FAQ都是有效手段
4. **量化证据**比定性描述有效4.7倍,所有主张都应附带可验证的数据
5. **语义分块**决定了内容能否被完整召回,切分时要尊重自然语义边界
在下一篇文章中,我们将深入探讨**结构化数据标记(JSON-LD)的工程实现**,教你如何通过Schema标记让AI精准识别产品、品牌、FAQ等实体信息。
—
**本文代码仓库**:可直接复制运行,Python 3.8+环境兼容
**测试数据来源**:普林斯顿大学GEO研究论文、CNNIC互联网络发展报告、Google AI搜索指南