在针对大内存数据库(如 Redis、PostgreSQL、MySQL InnoDB)或超大 Java 堆(64GB 以上)进行高并发压力测试时,运维监控与性能剖析工具常常会捕捉到一个反常现象:CPU 的用户态利用率并不高,但整体吞吐量却迟迟上不去,延迟指标的 P99 抖动剧烈。
当我们用 perf top 深入 CPU 指令周期时,往往会发现热点被内核态的内存寻址开销霸占——例如多级页表漫步(Page Table Walk)、native_write_cr3、page_fault 甚至 __handle_mm_fault。这种不见明显慢查询、无死锁等待、单纯因内存访问密集而引发的算力蒸发,底层几乎都指向了同一个隐蔽的硬件级瓶颈:TLB(Translation Lookaside Buffer,页表快表)击穿。
从虚拟地址到物理地址:为何寻址会变成性能杀手?
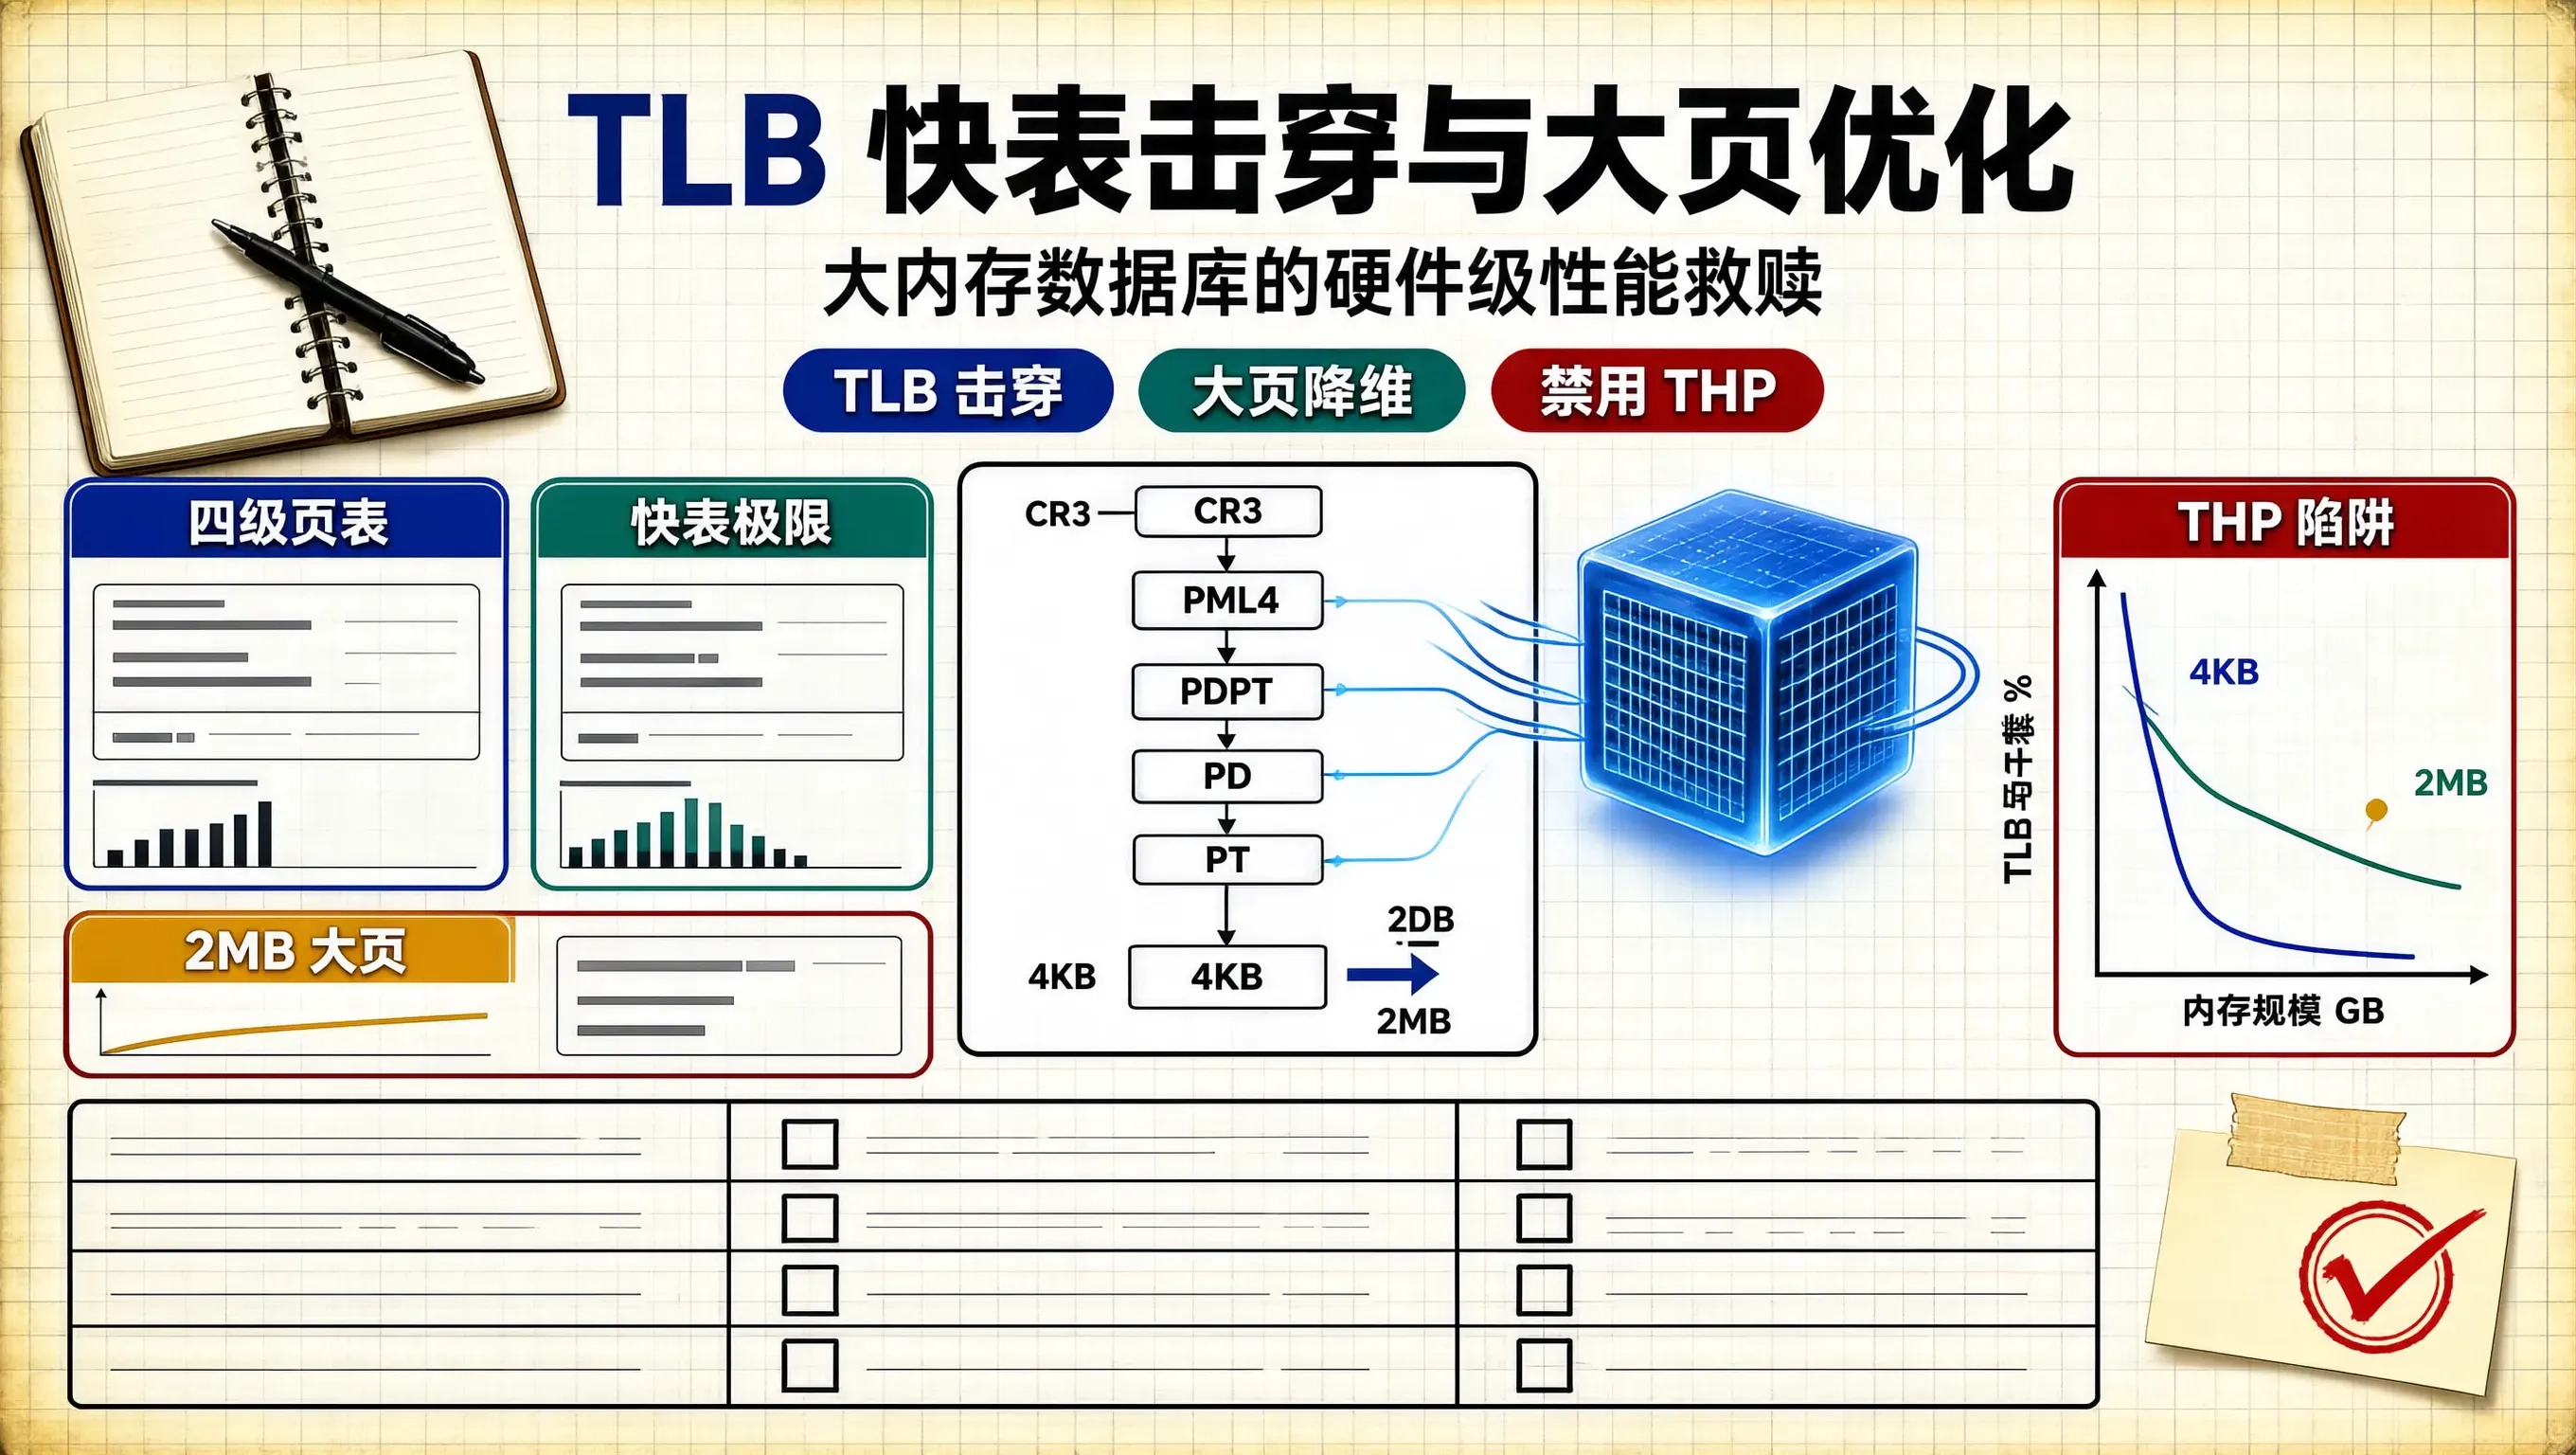
现代操作系统为了实现进程间的地址隔离与物理内存虚拟化,采用了基于分页的虚拟内存机制。在 x86_64 体系结构下,经典的虚拟地址转换依赖于 **4 级页表(4-Level Paging)**结构:
虚拟地址 (64-bit,有效 48-bit):
+———+———+———+———+————-+
| PML4 | PDPT | PD | PT | Page Offset |
| (9-bit) | (9-bit) | (9-bit) | (9-bit) | (12-bit) |
+———+———+———+———+————-+
| | | | |
v v v v v
CR3 寄存器 -> PML4 -> PDPT -> PD -> PT -> 最终物理页面 (4KB)
每个进程的 CR3 寄存器存放了其顶级页表(PML4)的基地址。当 CPU 执行一条最基础的内存读取指令(如 mov (%rax), %rbx)时,如果只靠内存中的页表来完成翻译:
原本一次仅需几十纳秒的普通内存读取,被四级页表层层放大成了 5 次内存总线交互。 内存与 CPU 之间存在着一道巨大的“内存墙”,如果每次访存都发生四级漫步,CPU 将把绝大部分时钟周期消耗在漫长的总线等待上。
TLB 快表的硬件极限与“快表击穿”
为了消除这多出来的 4 次访存,CPU 芯片内集成了一组极其昂贵的 SRAM 高速缓存——TLB(快表)。
TLB 直接缓存了“虚拟页号(VPN)$\\rightarrow$ 物理页框号(PFN)”的映射结果。当 CPU 发起访存时,首先由 MMU 并行检索 TLB。若命中(TLB Hit),只需一个时钟周期即可直出物理地址;若未命中(TLB Miss),硬件 MMU 才会触发“Page Table Walk”,走完四级页表并更新 TLB。
问题在于:TLB 的容量由于芯片面积和访问速度限制,极其微小。
以常见的 Intel Xeon 处理器为例:
- L1 数据 TLB(dTLB):通常只有 64 个条目(Entries);
- L2 TLB(STLB):通常在 1024 到 1536 个条目左右。
在 Linux 默认的 4KB 页大小 下,我们来算一笔账:
- L1 dTLB 能覆盖的内存范围:$64 \\times 4\\text{KB} = 256\\text{KB}$;
- L2 STLB 能覆盖的内存范围:$1536 \\times 4\\text{KB} \\approx 6\\text{MB}$。
试想一下:一台分配了 128GB 内存给 Redis 做缓存或给 JVM 做堆内存的物理服务器,系统总共需要维护 $128\\text{GB} / 4\\text{KB} = 33,554,432$ 个页表项(仅页表本身就占用数吉字节内存)。而 CPU 的硬件快表总共只能罩住区区 6MB 的热点内存!
当应用程序进行大规模随机内存读写(例如散列表探测、B+ 树遍历、全表扫描)时,访存局部性被彻底打碎,TLB 命中率断崖式暴跌,几乎每一次内存访问都会演变为一次完整的 Page Table Walk。CPU 指令流水线频繁停顿,这就是工业界典型的 TLB 快表击穿。
救赎之道:大页(HugePages)带来的降维打击
打破这一困局的核心思路是:放大单页的尺寸,大幅削减页表项总数。
在 x86_64 架构中,除了默认的 4KB 分页,硬件原生支持两种大页:
2MB 大页寻址(减少一层页表):
+———+———+———+———————–+
| PML4 | PDPT | PD | Page Offset (21-bit) |
| (9-bit) | (9-bit) | (9-bit) | |
+———+———+———+———————–+
| | | |
CR3 -> PML4 -> PDPT -> PD —————> 最终 2MB 物理大页
如果将页大小切换至 2MB:
- 同样的 1536 个 L2 TLB 条目,覆盖的物理内存瞬间暴增至:$1536 \\times 2\\text{MB} \\approx 3\\text{GB}$;
- 128GB 内存原本需要 3300 万个页表项,使用 2MB 大页后锐减至仅需 65536 个项;
- 寻址从 4 级漫步缩减为 3 级漫步,不仅 TLB Miss 概率降低数个数量级,即使发生 Miss,解析开销也减少了 25%。
致命陷阱:为什么数据库严禁开启“透明大页”(THP)?
Linux 提供了两种大页实现方式:标准大页(Static HugePages) 和 透明大页(Transparent HugePages, THP)。
初学者往往偏爱透明大页,因为无需修改任何应用代码,内核的后台线程 khugepaged 会自动检测连续的 4KB 物理页并将其合并为 2MB 大页。但在高并发数据库环境中,THP 是导致线上周期性严重卡顿的头号元凶。
Redis、MongoDB、Cassandra、PostgreSQL 官方运维手册中无一例外明确标注:生产环境务必禁用 THP!
其背后的致命缺陷在于:
实战调优:从定量诊断到标准大页部署
在生产环境中,严谨的调优必须基于数据指标驱动。
1. 监测 TLB Miss 的严重程度
通过 Linux 性能计数器工具 perf,可以直接采集硬件级 TLB 统计数据:
# 监测运行中的核心进程(以 PID 为例),采样 10 秒
perf stat -e dTLB-loads,dTLB-load-misses -p <PID> — sleep 10
典型的输出分析:
Performance counter stats for process id '18243':
28,451,200,102 dTLB-loads
4,267,680,015 dTLB-load-misses # 15.00% of all dTLB cache hits
10.001284910 seconds time elapsed
如果 dTLB-load-misses 占总访存操作的比例超过 5%~10%,就意味着 TLB 已经处于严重瓶颈状态,必须考虑大页介入。
2. 彻底禁用透明大页(THP)
首先检查当前系统的 THP 启用状态:
cat /sys/kernel/mm/transparent_hugepage/enabled
cat /sys/kernel/mm/transparent_hugepage/defrag
如果输出显示 [always] madvise never,说明 THP 处于全局强制开启状态。必须执行彻底禁用:
# 运行时动态关闭
echo never > /sys/kernel/mm/transparent_hugepage/enabled
echo never > /sys/kernel/mm/transparent_hugepage/defrag
# 持久化生效:修改 /etc/default/grub,在 GRUB_CMDLINE_LINUX 尾部追加
transparent_hugepage=never
# 重新生成 grub 配置(以 RHEL/CentOS 为例)
grub2-mkconfig -o /boot/grub2/grub.cfg
3. 配置与预分配标准静态大页(2MB)
静态大页需要在系统启动或内存未高度碎片化时向内核静态预留:
# 计算所需大页数量:例如为数据库预留 16GB 空间,每页 2MB,共需 8192 页
echo 8192 > /proc/sys/vm/nr_hugepages
# 持久化写入 /etc/sysctl.conf
vm.nr_hugepages = 8192
sysctl -p
验证大页是否成功划定:
grep -i HugePages /proc/meminfo
HugePages_Total: 8192
HugePages_Free: 8192
HugePages_Rsvd: 0
Hugepagesize: 2048 kB
4. 应用程序接管大页
在底层 C/C++ 层面,可以通过带有 MAP_HUGETLB 标记的 mmap 系统调用直接从内核大页池申请内存:
#include <sys/mman.h>
#include <fcntl.h>
#include <stdio.h>
#include <stdlib.h>
#define LENGTH (256 * 1024 * 1024) // 申请 256MB 内存
int main() {
// 使用 MAP_HUGETLB 与 MAP_ANONYMOUS 申请匿名 2MB 大页
void *addr = mmap(NULL, LENGTH, PROT_READ | PROT_WRITE,
MAP_PRIVATE | MAP_ANONYMOUS | MAP_HUGETLB, -1, 0);
if (addr == MAP_FAILED) {
perror("mmap with MAP_HUGETLB failed");
exit(EXIT_FAILURE);
}
// 在大页上安全执行业务读写
char *ptr = (char *)addr;
ptr[0] = 'K';
// 释放大页映射
munmap(addr, LENGTH);
return 0;
}
在 Java 服务端,若 JVM 分配了 32GB 以上的堆内存,并且机器已完成上述 nr_hugepages 的预分配,可以通过 JVM 参数无缝启用静态大页支持:
java -Xms32g -Xmx32g -XX:+UseLargePages -XX:LargePageSizeInBytes=2m -jar backend-service.jar
在大内存计算与高频缓存系统走向极限性能时,脱离硬件视角的纯软件算法优化终究会撞上天花板。通过厘清 CPU 寻址层级、压制 THP 碎片扰动、合理引入标准 HugePages 抹平快表缺失开销,方能让多核心与超大内存的硬件红利得到真正释放。