告别字体加密困扰:大众点评全站数据采集的Python解决方案
【免费下载链接】dianping_spider 大众点评爬虫(全站可爬,解决动态字体加密,非OCR)。持续更新  项目地址: https://gitcode.com/gh_mirrors/di/dianping_spider
在大数据时代,本地生活服务数据的价值日益凸显,但获取大众点评等平台的数据却面临重重阻碍。传统的爬虫方法在动态字体加密、Cookie验证、IP限制等多重反爬机制面前往往束手无策。本文介绍的Python爬虫框架通过创新的技术方案,实现了对大众点评搜索页、详情页、评论页的全链路数据采集,为数据分析和商业洞察提供了可靠的技术支持。
🎯 价值主张:从数据壁垒到商业洞察的桥梁
大众点评作为中国最大的本地生活服务平台,积累了海量的商家信息和用户评价数据。这些数据对于市场分析、竞品研究、用户行为洞察具有重要价值。然而,平台采用的多重反爬机制——特别是动态字体加密技术——使得传统的数据采集方法效率低下且难以持续。
本项目通过以下核心创新解决了这些挑战:
- 动态字体加密实时破解:无需依赖OCR识别,实时解析字体映射关系
- 智能反爬策略集成:Cookie池轮换、代理IP调度、阶梯式请求频率控制
- 全链路数据采集:支持搜索→详情→评论的完整数据获取流程
- 结构化数据输出:标准化的JSON格式,便于后续分析和可视化
📊 数据采集场景:三层次商业价值挖掘
🔍 搜索结果层:市场格局快速扫描
搜索功能是数据采集的入口点,通过关键词和地理位置筛选,快速获取目标商家的基础信息。这一层数据为市场格局分析提供了基础支撑。
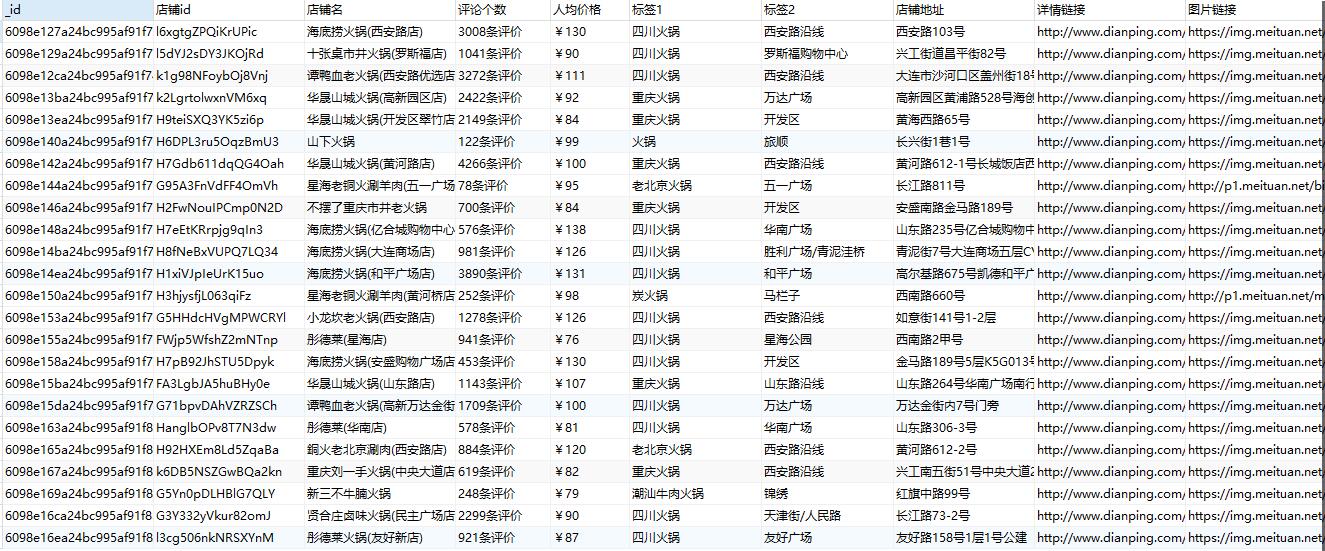
搜索结果包含店铺ID、名称、评分、人均价格、地理位置标签等关键信息,能够快速构建区域内的商家分布热力图。对于连锁品牌扩张、商圈竞争力分析、价格带研究等场景,这些基础数据具有重要参考价值。
🏪 详情数据层:商家档案深度解析
当锁定目标商家后,详情页数据提供了完整的商家档案。这一层数据对于品牌定位、服务优化、竞争分析具有决定性意义。
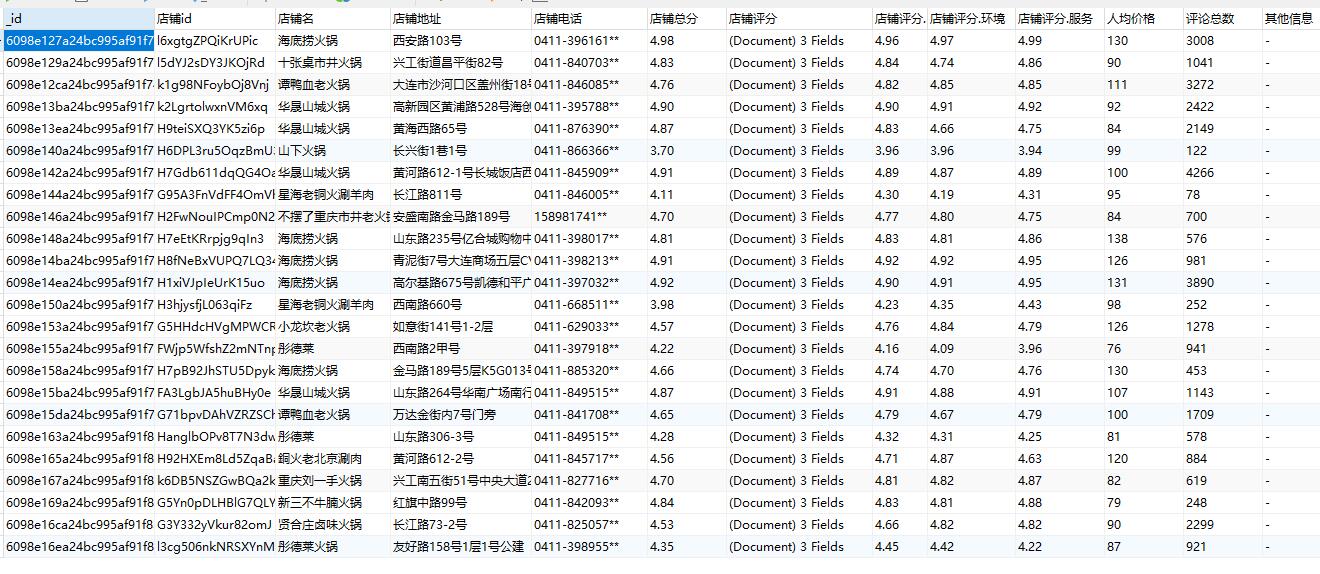
详情页数据不仅包含基础的联系方式和地址信息,更重要的是提供了多维度评分体系——口味、环境、服务三个维度的独立评分。这种精细化评分数据可以帮助商家识别自身优势与不足,也为消费者选择提供了客观参考。
💬 评论数据层:用户心声真实反馈
用户评论是理解消费者需求、发现服务痛点的宝贵资源。通过大规模评论数据采集,可以进行情感分析、关键词提取、趋势预测等深度挖掘。
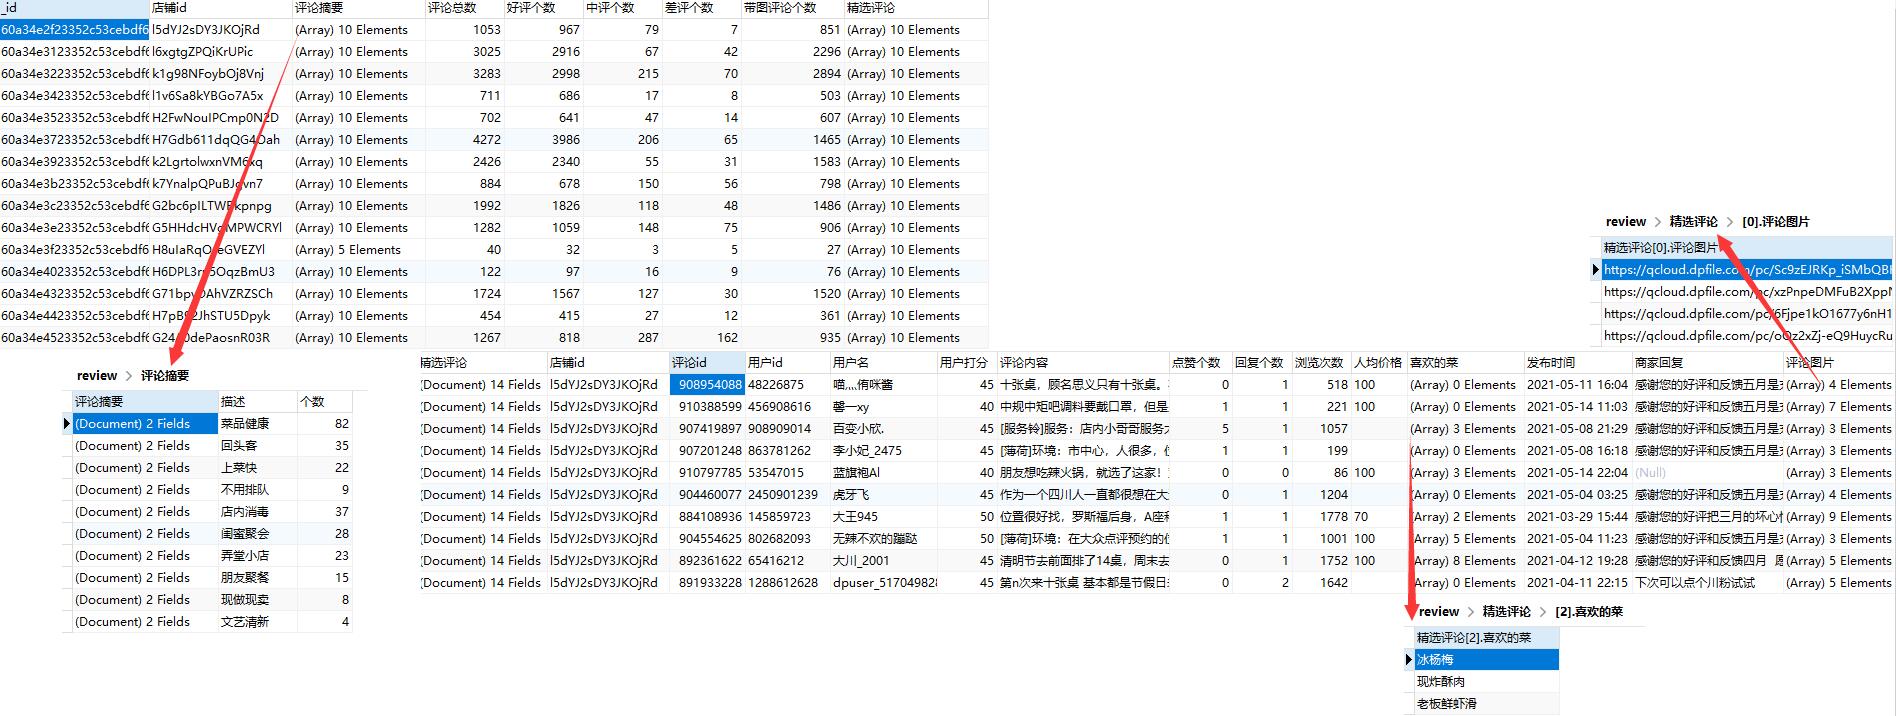
评论数据包含用户评分、评论文本、推荐菜品、消费时间等多维度信息。通过对这些数据的分析,可以:
- 识别热门菜品和消费趋势
- 分析用户满意度影响因素
- 发现服务改进的关键节点
- 监测品牌口碑变化趋势
🛡️ 技术突破:动态字体加密的智能破解
传统方法的局限性
传统的大众点评数据采集通常采用两种方式:手动复制粘贴或基于OCR的图像识别。前者效率极低,后者准确率不高且容易被平台检测。大众点评采用的动态字体加密技术,每次请求返回的字体文件都不同,字符编码与显示内容之间的映射关系动态变化,这给自动化采集带来了巨大挑战。
创新解决方案
本项目通过 utils/get_font_map.py 模块实现了字体加密的实时破解:
# 核心字体映射解析逻辑
def get_font_map(self, font_url):
"""
解析字体文件,建立字符编码到实际内容的映射关系
"""
# 下载字体文件
font_response = requests.get(font_url)
font_file = BytesIO(font_response.content)
# 解析字体文件
font = TTFont(font_file)
# 建立映射关系
cmap = font.getBestCmap()
mapping = {}
# 分析字符编码与实际显示内容的对应关系
for code, name in cmap.items():
# 通过算法确定实际显示内容
actual_char = self.decode_char(name)
mapping[hex(code)] = actual_char
return mapping
这种方法相比OCR识别具有明显优势:
Cookie池与代理IP的协同防御
单一账号和IP的频繁请求极易触发平台的反爬机制。本项目通过智能调度策略实现了可持续的数据采集:
# config.ini 配置示例
use_cookie_pool = True
use_proxy = True
requests_times = 2,3;5,8;15,60
Cookie池管理:系统从 cookies.txt 文件中读取多个有效Cookie,实现自动轮换使用。每个Cookie对应一个真实的用户会话,大幅降低账号被封风险。
代理IP调度:支持HTTP提取和密钥模式两种代理方式,配合 repeat_nub 参数实现IP复用,平衡成本与效率。阶梯式的请求频率控制(requests_times)让系统在初始阶段快速采集,随着请求次数增加自动延长间隔时间。
🚀 实战指南:五分钟开启数据采集之旅
环境准备与快速部署
项目基于Python 3.6+开发,依赖库包括lxml、requests、tqdm、faker、beautifulsoup4、fontTools、pymongo等主流工具。一键安装即可开始:
git clone https://gitcode.com/gh_mirrors/di/dianping_spider
cd dianping_spider
pip install -r requirements.txt
核心配置三要素
打开 config.ini 文件,只需配置三个核心参数即可开始数据采集:
[config]
save_mode = mongo
requests_times = 2,3;5,8;15,60
[detail]
keyword = 火锅
location_id = 19
need_pages = 10
灵活的数据采集模式
项目支持多种采集模式,满足不同场景需求:
# 完整流程:搜索→详情→评论
python main.py
# 仅采集店铺详情(指定店铺ID)
python main.py –normal 0 –detail 1 –shop_id k30YbaScPKFS0hfP
# 仅采集评论数据
python main.py –normal 0 –review 1 –shop_id k30YbaScPKFS0hfP
# 同时采集详情和评论
python main.py –normal 0 –detail 1 –review 1 –shop_id k30YbaScPKFS0hfP
这种模块化设计让用户可以根据具体需求灵活选择采集范围,避免不必要的数据冗余和资源浪费。
📈 数据应用:从原始数据到商业洞察
结构化数据输出
采集到的数据以标准化的JSON格式存储,包含完整的商家信息:

数据结构包含以下核心字段:
- 基础信息:店铺ID、名称、地址、电话、营业时间
- 评分体系:总分、口味分、环境分、服务分
- 消费指标:人均价格、评论总数、收藏数
- 推荐菜品:热门菜品列表和用户推荐
- 用户评价:评论文本、评分、发布时间、推荐菜品
MongoDB存储配置
项目默认支持MongoDB存储,配置简单高效:
[mongo]
mongo_path = mongodb://localhost:27017/
database_name = dianping_data
collection_name = shop_info
这种存储方式具有以下优势:
增量采集与数据更新
通过 utils/cache.py 模块,系统会自动记录已采集的URL,避免重复工作。这对于长期监控和定期更新特别有用:
# 缓存机制实现增量采集
def check_url_cached(url):
"""
检查URL是否已采集,避免重复工作
"""
if url in cache:
return True
else:
cache.add(url)
return False
🔧 性能优化与最佳实践
智能请求频率控制
requests_times 参数采用智能阶梯式控制策略:
requests_times = 2,3;5,8;15,60
这种设计实现了自适应请求节奏:
- 初始阶段(0-2次请求):间隔3秒,快速获取基础数据
- 中期阶段(3-5次请求):间隔8秒,平衡效率与安全
- 长期运行(6+次请求):间隔60秒,最大限度降低风险
错误处理与重试机制
项目内置完善的错误处理和重试逻辑,确保采集任务的稳定性:
资源管理与优化建议
对于大规模数据采集任务,建议采用以下优化策略:
🌟 扩展应用与商业价值
市场竞品分析
通过采集同一区域内同类商家的数据,可以进行多维度的竞品分析:
- 价格区间对比:分析不同品牌的价格定位策略
- 评分分布研究:识别各维度的优劣势分布
- 服务特色分析:发现差异化竞争的关键要素
- 市场份额估算:基于评论数量和评分进行市场占有率估算
用户行为洞察
利用评论数据,深入分析消费者行为模式:
- 消费偏好识别:分析不同人群的消费偏好和价格敏感度
- 季节性趋势分析:识别消费高峰和低谷的时间规律
- 菜品推荐优化:基于用户推荐数据优化菜单设计
- 服务质量改进:从负面评论中发现服务改进机会
商业智能监控
建立长期数据采集机制,实现商业智能监控:
- 评分变化趋势:监控商家评分变化,预警口碑风险
- 新品推出追踪:及时发现竞品新品推出动态
- 促销效果评估:分析促销活动对评分和评论的影响
- 竞争动态预警:监控竞争对手的扩张和服务改进
🎯 开始你的数据采集之旅
大众点评数据采集不仅是技术挑战,更是商业洞察的重要入口。通过本项目提供的完整解决方案,您可以:
无论是市场研究人员、数据分析师、还是商业决策者,这个项目都能为您提供高质量的数据支持。立即开始您的数据采集项目,解锁本地生活服务的商业洞察价值。
下一步行动建议:
通过系统化的数据采集和分析,您将能够更好地理解市场动态、把握用户需求、优化商业决策,在竞争激烈的本地生活服务市场中占据先机。
【免费下载链接】dianping_spider 大众点评爬虫(全站可爬,解决动态字体加密,非OCR)。持续更新 项目地址: https://gitcode.com/gh_mirrors/di/dianping_spider
创作声明:本文部分内容由AI辅助生成(AIGC),仅供参考