Storm 退役与迁移指南:向 Flink/Spark Streaming 的迁移策略与成本评估
随着大数据技术的演进,Apache Storm 已进入维护阶段,官方推荐用户迁移至更先进的实时处理框架。本文将为您详细解析 Storm 退役背景,并提供一套系统化的迁移策略与成本评估方案,助您顺利完成技术栈升级。
1. Storm 退役背景与迁移必要性
Apache Storm 作为开源分布式实时计算系统,自2010年发布以来在实时数据处理领域扮演了重要角色。然而,随着技术发展和社区变化,Storm 的开发已进入维护模式,不再积极进行功能更新,而是专注于错误修复和安全性维护。主要退役原因包括:
- 技术架构局限:Storm 早期设计基于 Tuple 级别的处理模式,在高吞吐场景下性能瓶颈明显
- 资源利用率低:基于 JVM 的进程模型导致内存和 CPU 利用率不如基于 JVM 优化的新一代框架
- 管理复杂性:缺乏内置的状态管理、容错和窗口机制,需要额外组件支持
- 社区活跃度下降:核心贡献者转向 Flink 等新一代框架,社区资源有限
迁移至 Flink 或 Spark Streaming 可带来显著价值:
- 更高的吞吐量和更低的延迟
- 内置的状态管理和容错机制
- 更好的资源利用率和成本效益
- 更活跃的社区支持与持续创新
| Storm迁移决策流程根据业务需求和技术特点判断是否需要迁移以及迁移方向Storm版本低于1.2?是否延迟敏感场景?需要强状态管理?是否是否立即迁移至Flink评估Spark Streaming优先考虑Flink暂缓迁移 |
上图为 Storm 迁移决策流程图,根据当前 Storm 版本、业务延迟需求和状态管理需求,帮助确定是否需要迁移以及迁移方向。对于低于 1.2 版本的 Storm,无论其他条件如何都应尽快迁移;而对于 1.2+ 版本,则需要综合考虑延迟敏感性和状态管理需求来决定迁移优先级。
2. 迁移策略规划与步骤
迁移 Storm 到 Flink 或 Spark Streaming 需要系统化的策略规划和执行步骤,确保业务连续性和最小化风险。
2.1 迁移前评估
在启动迁移前,需要进行全面评估:
- 业务影响分析:识别 Storm 应用中的核心业务流程,确定迁移优先级
- 代码复杂度评估:分析 Bolt 和 Spout 的实现复杂度,识别重构难点
- 依赖梳理:识别 Storm 专用组件和第三方依赖,评估替代方案
- 性能基准测试:记录当前应用的吞吐量、延迟和资源消耗,作为迁移后对比基准
2.2 架构设计
基于评估结果设计新的架构:
- 数据流重设计:将 Storm 的 Tuple 模型转换为 Flink/Spark Streaming 的 DataStream/DStream 模型
- 状态管理方案:设计基于 Flink 状态后端或 Spark Checkpoint 的状态管理机制
- 容错策略:设计新的容错机制,利用 Flink 的一致性检查点或 Spark 的 WAL 机制
- 资源规划:根据新框架特性重新规划集群资源分配
2.3 迁移实施
迁移实施应采用渐进式方法:
3. Flink/Spark Streaming 对比与选型
Flink 和 Spark Streaming 是目前最主流的两种实时计算框架,各有特点,需根据业务需求进行选择。
3.1 技术特性对比
| 处理模型 | 真正流处理,事件时间驱动 | 微批处理,基于 RDD |
| 延迟 | 毫秒级 | 秒级 |
| 状态管理 | 原生支持,多种状态后端 | 需要额外配置 |
| 容错机制 | 基于分布式快照的精确一次 | 基于 RDD 重建和 WAL |
| 复杂事件处理 | CEP 库支持 | 原生支持有限 |
| 机器学习集成 | Flink ML | MLlib |
| 社区活跃度 | 高,持续创新 | 高,但聚焦批处理 |
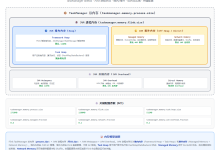
| Flink与Spark Streaming架构对比展示两个框架在数据流处理架构上的主要差异Apache Flink 架构数据源 (Kafka/Pulsar等)Source (事件时间感知)Transformation (流处理算子)State Backend (RocksDB/内存)Sink (输出到存储系统)Checkpoint (分布式快照)精确一次语义Spark Streaming 架构数据源 (Kafka等)Receiver (微批获取)DStream (基于RDD的流)Transformations (RDD操作)Checkpoint (RDD血缘)Sink (输出到存储系统)至少一次语义 |
上图展示了 Flink 和 Spark Streaming 的架构对比。Flink 采用真正的事件驱动流处理架构,支持事件时间感知和精确一次语义,而 Spark Streaming 采用基于 RDD 的微批处理模式,更适合有界数据集和批量处理场景。
3.2 选型决策
选型应考虑以下因素:
- 延迟要求:对毫秒级延迟要求高的场景优先选择 Flink
- 数据量级:超大规模数据流处理可考虑 Flink 的可扩展性
- 状态管理复杂度:复杂状态管理需求优先考虑 Flink 的状态后端
- 现有技术栈:若已在使用 Spark 生态,可考虑 Spark Streaming 降低学习成本
- 团队技能:评估团队对流处理和批处理框架的熟悉程度
| 框架选型决策树根据业务需求和技术特点判断最适合的实时计算框架延迟<100ms?是否需要复杂状态?现有Spark生态?是否是否选择Flink考虑Spark Streaming选择Spark StreamingFlink |
上图为框架选型决策树,帮助根据延迟要求、状态管理需求和现有技术栈选择最适合的实时计算框架。
4. 成本评估与资源优化
迁移成本不仅包括技术实施成本,还需考虑运维成本和资源优化带来的长期收益。
4.1 迁移成本构成
迁移成本主要包括:
- 开发成本:代码重构、API 转换、功能测试等所需人力
- 学习成本:团队培训、新框架学习曲线
- 基础设施成本:新集群资源、存储和网络配置
- 运维成本:监控体系适配、故障排查能力建设
- 业务连续性成本:并行运行期间的额外资源消耗
4.2 资源优化策略
合理的新框架资源规划可降低总体拥有成本:
- 动态资源分配:利用 Flink 的弹性扩缩容或 Spark 的动态资源分配
- 状态后端优化:合理选择 Flink 的状态后端,平衡性能与可靠性
- 并行度调整:根据实际负载调整算子并行度,最大化资源利用率
- 批流融合:利用 Flink 或 Spark 的批流一体化特性,共享计算资源
| 迁移成本分布展示Storm迁移到不同框架的成本分布占比Storm到Flink迁移成本分布开发成本 18%学习成本 27%基础设施 24%运维成本 15%业务连续性 12%Storm到Spark Streaming迁移成本分布开发成本 21%学习成本 18%基础设施 27%运维成本 15%业务连续性 12% |
上图展示了 Storm 迁移到 Flink 和 Spark Streaming 的成本分布对比。可以看到,迁移到 Flink 的学习成本相对较高,而迁移到 Spark Streaming 的基础设施成本相对较高,这反映了两种框架的不同特性和资源需求。
5. 最佳实践与常见问题
5.1 迁移最佳实践
- 增量迁移:优先迁移非核心应用,降低风险
- 流量切换:采用灰度发布逐步切换流量,监控系统表现
- 监控完善:在新系统中添加完善的监控告警,快速发现问题
- 文档同步:及时更新技术文档和运维手册
- 团队培训:提前开展团队培训,确保团队能熟练掌握新框架
5.2 常见问题与解决方案
- 解决方案:实现 Flink 的 TypeSerializer 或 Spark 的 Serializable 接口
- 解决方案:设计状态转换器,将 Storm 的本地状态转换为 Flink 状态后端格式
- 解决方案:根据新框架特性重新设计资源配置策略,利用容器化和自动扩缩容
- 解决方案:使用适配器模式封装差异,简化迁移过程
5.3 最小迁移示例
以下是 Storm 到 Flink 的核心转换示例:
// 原始 Storm Spout 实现
public class RandomSentenceSpout extends BaseRichSpout {
private SpoutOutputCollector collector;
private String[] sentences = {
"the cow jumped over the moon",
"an apple a day keeps the doctor away",
"four score and seven years ago"
};
private int index = 0;
@Override
public void open(Map conf, TopologyContext context, SpoutOutputCollector collector) {
this.collector = collector;
}
@Override
public void nextTuple() {
if (index < sentences.length) {
collector.emit(new Values(sentences[index]));
index++;
}
}
}
// 转换后的 Flink Source 实现
public class RandomSentenceSource extends RichSourceFunction<String> {
private String[] sentences = {
"the cow jumped over the moon",
"an apple a day keeps the doctor away",
"four score and seven years ago"
};
private int index = 0;
private volatile boolean isRunning = true;
@Override
public void run(SourceContext<String> ctx) {
while (isRunning && index < sentences.length) {
ctx.collect(sentences[index]);
index++;
try {
Thread.sleep(1000);
} catch (InterruptedException e) {
isRunning = false;
}
}
}
@Override
public void cancel() {
isRunning = false;
}
}
// 原始 Storm Bolt 实现
public class SplitSentenceBolt extends BaseRichBolt {
private OutputCollector collector;
@Override
public void prepare(Map stormConf, TopologyContext context, OutputCollector collector) {
this.collector = collector;
}
@Override
public void execute(Tuple input) {
String sentence = (String) input.getValue(0);
for (String word : sentence.split(" ")) {
collector.emit(new Values(word));
}
}
@Override
public void declareOutputFields(OutputFieldsDeclarer declarer) {
declarer.declare(new Fields("word"));
}
}
// 转换后的 Flink MapFunction 实现
public class SplitSentenceMapFunction implements MapFunction<String, String> {
@Override
public String map(String sentence) throws Exception {
// 返回第一个单词作为示例
return sentence.split(" ")[0];
}
}
这些示例展示了从 Storm 的 Spout/Bolt 模型到 Flink 的 SourceFunction/MapFunction 的基本转换。实际迁移中,还需要考虑状态管理、窗口处理和复杂事件处理等高级特性的转换。