实 验 结 果 分 析 报 告
大模型驱动文献检索流程的创新探索
—— 五种检索策略的对比实验分析 ——
5 模型 × 策略全景视图
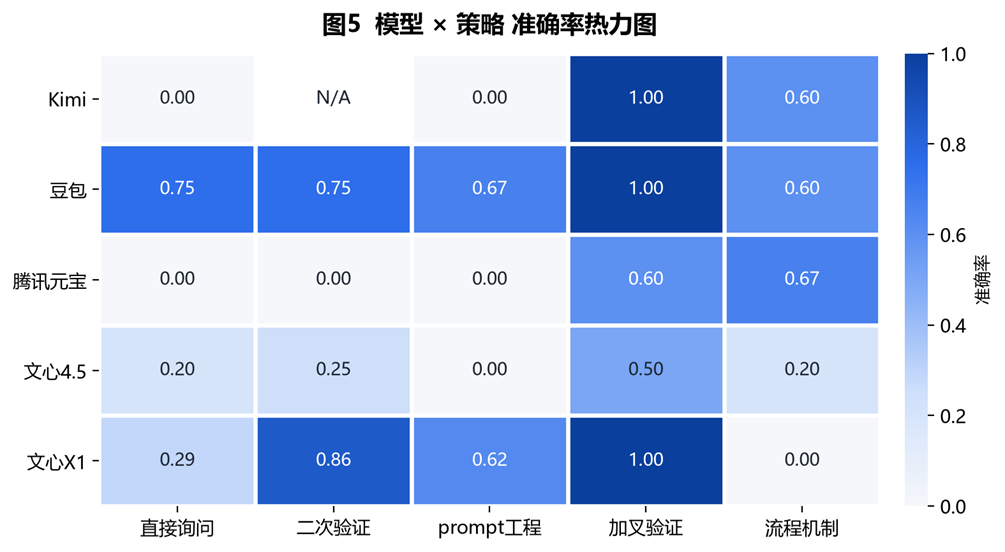
图 5 模型 × 策略准确率热力图。颜色越深准确率越高。横向看「加叉验证」整列均为深色(无浅色单元格);纵向看没有任何一个模型能在所有策略下都保持深色。这张图同时展示了机会(横向策略选择可弥补模型能力)和风险(纵向任何单一模型都有失效场景)。
|
模型 \\ 策略 |
直接询问 |
二次验证 |
prompt工程 |
加叉验证 |
流程机制 |
行均值 |
|
Kimi |
0.00 |
N/A |
0.00 |
1.00 |
0.60 |
0.400 |
|
豆包 |
0.75 |
0.75 |
0.67 |
1.00 |
0.60 |
0.753 |
|
腾讯元宝 |
0.00 |
0.00 |
0.00 |
0.60 |
0.67 |
0.253 |
|
文心 4.5 |
0.20 |
0.25 |
0.00 |
0.50 |
0.20 |
0.230 |
|
文心 X1 |
0.29 |
0.86 |
0.63 |
1.00 |
0.00 |
0.554 |
|
列均值 |
0.247 |
0.464 |
0.258 |
0.820 |
0.413 |
— |
|
热力图揭示的“覆盖-能力”权衡 横向(策略)看,「加叉验证」列是唯一整列达标(≥0.50)的策略——这正是它作为流程基座的底气。纵向(模型)看,5 个模型中没有一个能在全部策略下都保持 ≥0.50,说明模型选型无法被流程优化替代,两者是互补而非替代关系。理想的系统设计应当是:用加叉验证作为统一底座,在其上按模型特性做差异化轻量适配。 |
6 主要结论
|
1 |
加叉验证是唯一被数据支持的普适有效策略 平均准确率 0.820(vs 基线 0.247,提升 +57.3 个百分点),5/5 模型全部正向(p = 0.031),零模型失效,CV = 0.30 为全组最低,中位数达到 1.000。它同时在“效果”和“稳定性”两个维度上占优,是本次实验中唯一可以写进生产流程的策略。 |
|
2 |
无干预的直接询问处于不可用水平 平均准确率仅 0.247,Kimi 与腾讯元宝直接归零(0/20 题正确)。这从量化角度证实:通用大模型在缺少外部检索机制时,文献引用能力不可信,不能直接用于需要文献支撑的研究与写作场景。 |
|
3 |
prompt 工程被证伪:输入侧优化无法约束输出侧幻觉 平均 0.258,与基线 0.247 基本持平(差异 1.1pp,在小样本下不可区分);归零模型 3/5,多于基线的 2/5;CV 1.37 为全组最高。效果无提升、风险更高、稳定性更差。结论是明确的:在强事实依赖的检索任务上,“把提示词写得更好”不能替代“给模型更可靠的证据来源”。 |
|
4 |
流程复杂度与检索质量非单调正相关(过度校正) 文心 X1 在加叉验证下为 1.000,叠加完整流程机制后崩塌至 0.000;豆包在流程机制下从基线 0.75 降至 0.60。流程机制平均增益 +2 正 / 2 负 / 1 平(p = 0.688),无显著改进。无差别堆叠流程环节不仅无效,还会引入新的失效模式。 |
|
5 |
存在明确的“策略敏感型”与“稳定型”模型分层 豆包为稳定型(均值 0.753,σ 0.152),各策略下均 ≥0.60;Kimi 与文心 X1 为策略敏感型(σ 0.490 / 0.411),表现可在 0 与 1 之间剧烈摆动,其性能几乎完全由外部机制决定。不同分层需要不同的流程策略,不存在“一套流程通吃”。 |
|
6 |
模型选型与流程优化是互补关系,不可互相替代 没有任何模型在全部 5 种策略下都保持 ≥0.50(热力图无整列达标行)。同时,「加叉验证」也无法让能力受限的文心 4.5 突破 0.50。结论:选强模型是降低基线风险,叠加交叉验证是压低幻觉上限,二者需并用。 |
7 流程优化建议
建议一:采用“交叉验证优先”的轻量流程骨架
建议将加叉验证作为文献检索流程的默认强制环节,而非可选增强项。具体可采用:多来源独立检索 → 题录字段交叉比对(标题/作者/年份/DOI)→ 不一致项标记并回退二次检索 → 仅输出一致性达标的文献。
▍预期收益
- 跨模型平均准确率 24.7% → 82.0%(+57.3pp)
- 彻底失效模型数 2 → 0,是本实验中最强的单项改善
- 无需更换模型即可获得收益,改造成本低
建议二:拒绝无差别堆叠流程环节
实验已证明多环节串联可能导致归零。文心 X1 的崩塌是明确的警示。工程上应遵守两条约束:
- 环节数量上限:建议核心检索链路不超过 4 个环节,每增加一个环节都应有独立的增益验证数据支撑。
- 逐环节消融验证:每上线一个环节,必须在全部 5 个模型上做 A/B,确认无一模型出现负向增益(参照文心 X1 的 0.857 → 0.000 案例)。
|
反模式警示 不要把“环节更多”当作流程 sophistication 的证明。加叉验证是横向增加证据来源(正确方向),流程机制是纵向增加执行步骤(风险方向)。前者提升事实质量,后者只提升流程长度。 |
建议三:把 prompt 工程的资源从“提问侧”转移到“证据侧”
实验证明 prompt 工程无独立效果。但加叉验证的本质恰恰也可以理解为一种“prompt 层级的改造”——它改变了验证任务的结构(要求模型输出一致性判断而非直接答案)。这提示:prompt 工程无效的原因不是“提示词技术无用”,而是纯约束型提示词不产生新证据。后续 prompt 设计应聚焦于如何组织与呈现多源证据,让模型做“比对”而非“生成”。
建议四:按模型能力分层配置策略
|
模型分层 |
代表模型 |
推荐策略 |
配置要点 |
|
稳定型 |
豆包(σ 0.152) |
轻量交叉验证即可 |
避免重型流程拖累(流程机制下反而降至 0.60) |
|
策略敏感型 |
Kimi、文心 X1 |
强制交叉验证 + 环节精简 |
收益空间最大(+1.00 / +0.71),也最易被冗余流程拖垮 |
|
能力受限型 |
腾讯元宝、文心 4.5 |
交叉验证 + 保留必要脚手架 |
腾讯元宝需流程机制支撑;文心 4.5 需先提升基础能力 |
关键原则:强模型做减法(少环节),弱模型做加法(补脚手架)。用一套固定流程服务所有模型,是本次实验中被数据否定的做法。
8 研究局限与后续实验建议
|
必须说明的方法学局限 以下局限会影响结论的强度,读者应据此判断结论的适用范围: |
|
局限 |
具体表现 |
对结论的影响 |
后续改进 |
|
样本量过小 |
每格约 3~8 题,符号检验最小 p 值仅 0.031 |
统计效力低,“显著”的门槛很高 |
每格提升至 20+ 题,可做 t 检验 / 配对检验 |
|
数据缺失 |
Kimi 的「二次验证」缺失 |
该策略统计基于 4 个模型,代表性下降 |
补测该数据点 |
|
单指标评估 |
仅测量准确率,无召回率、幻觉率、时延、成本 |
无法判断是“漏检”还是“误报”,无法评估工程代价 |
增加 Recall@K、幻觉率、响应时延、单次成本 |
|
无重复实验 |
每个条件仅测一次,未验证随机性 |
无法估计模型输出随机性带来的方差 |
同条件重复 3 次,取均值并报告方差 |
|
无消融实验 |
流程机制作为整体评估,未拆解内部环节 |
无法定位是哪个环节导致文心 X1 崩塌 |
对流程机制做逐环节消融 |
|
后续实验的三个优先方向 ① 消融定位:拆解「加叉验证」内部构成(几路交叉?哪类来源?是否需一致性阈值?),验证其 82.0% 准确率中哪些组件贡献最大。 |
|
② 机制定位:针对文心 X1 的 0.857 → 0.000 崩塌做单变量对照,确认是上下文长度、环节数量还是中间产物污染所致——这是本次实验遗留的最重要问题。 |
|
③ 任务扩展:当前仅测文献检索。可将同一实验范式迁移至“事实问答”“数据分析”“代码生成”等任务,检验“交叉验证优于提示词工程”这一结论的普适性,判断它是一般性规律还是文献任务的特性。 |
9 附录:完整原始数据
|
大模型 |
直接询问 |
二次验证 |
prompt工程 |
加叉验证 |
流程机制 |
|
Kimi |
0.000 |
—— |
0.000 |
1.000 |
0.600 |
|
豆包 |
0.750 |
0.750 |
0.667 |
1.000 |
0.600 |
|
腾讯元宝 |
0.000 |
0.000 |
0.000 |
0.600 |
0.667 |
|
文心 4.5 |
0.200 |
0.250 |
0.000 |
0.500 |
0.200 |
|
文心 X1 |
0.286 |
0.857 |
0.625 |
1.000 |
0.000 |
注:原表中 0.285714 / 0.857143 / 0.666667 等数值按其精确分数形式还原为 2/7、6/7、2/3。单元格底色:绿色 = 该模型最优,红色 = 该模型最差,灰色「——」表示原始数据缺失。
统计指标定义
平均准确率 = Σ(各模型准确率) / 有效模型数 // 等权宏平均,分母剔除缺失值
标准差 = sqrt( Σ(xᵢ – x̄)² / (n−1) ) // 样本标准差,ddof = 1
变异系数 CV = 标准差 / 平均准确率 // 跨模型一致性,越低越稳
相对增益 = 策略准确率 − 基线准确率(直接询问 = 0)
符号检验 p = P(X ≥ 正例数 | n = 非平局配对数, p̂ = 0.5) // 单尾精确二项检验
图表索引
|
图号 |
图名 |
对应章节 |
|
图 1 |
各模型在不同检索策略下的准确率对比(分组柱状图) |
第 2 章 |
|
图 2 |
五种检索策略的综合表现排名(含标准差误差棒) |
第 2 章 |
|
图 3 |
各模型随策略干预强度的性能演化轨迹(折线图) |
第 4 章 |
|
图 4 |
各类策略相对基线的增益分解(含负增益) |
第 4 章 |
|
图 5 |
模型 × 策略准确率热力图 |
第 5 章 |
|
图 6 |
各模型能力画像雷达图 |
第 3 章 |
|
图 7 |
策略稳定性对比(失效数量 + 变异系数) |
第 2 章 |
|
图 8 |
模型维度综合表现与最优策略 |
第 3 章 |