在开发大模型 Agent、RAG 增强应用的时候,大家经常会听到两个词:Function Calling 和 Tool Calling。很多文章直接把它们当成同一个东西,代码里也混着叫。
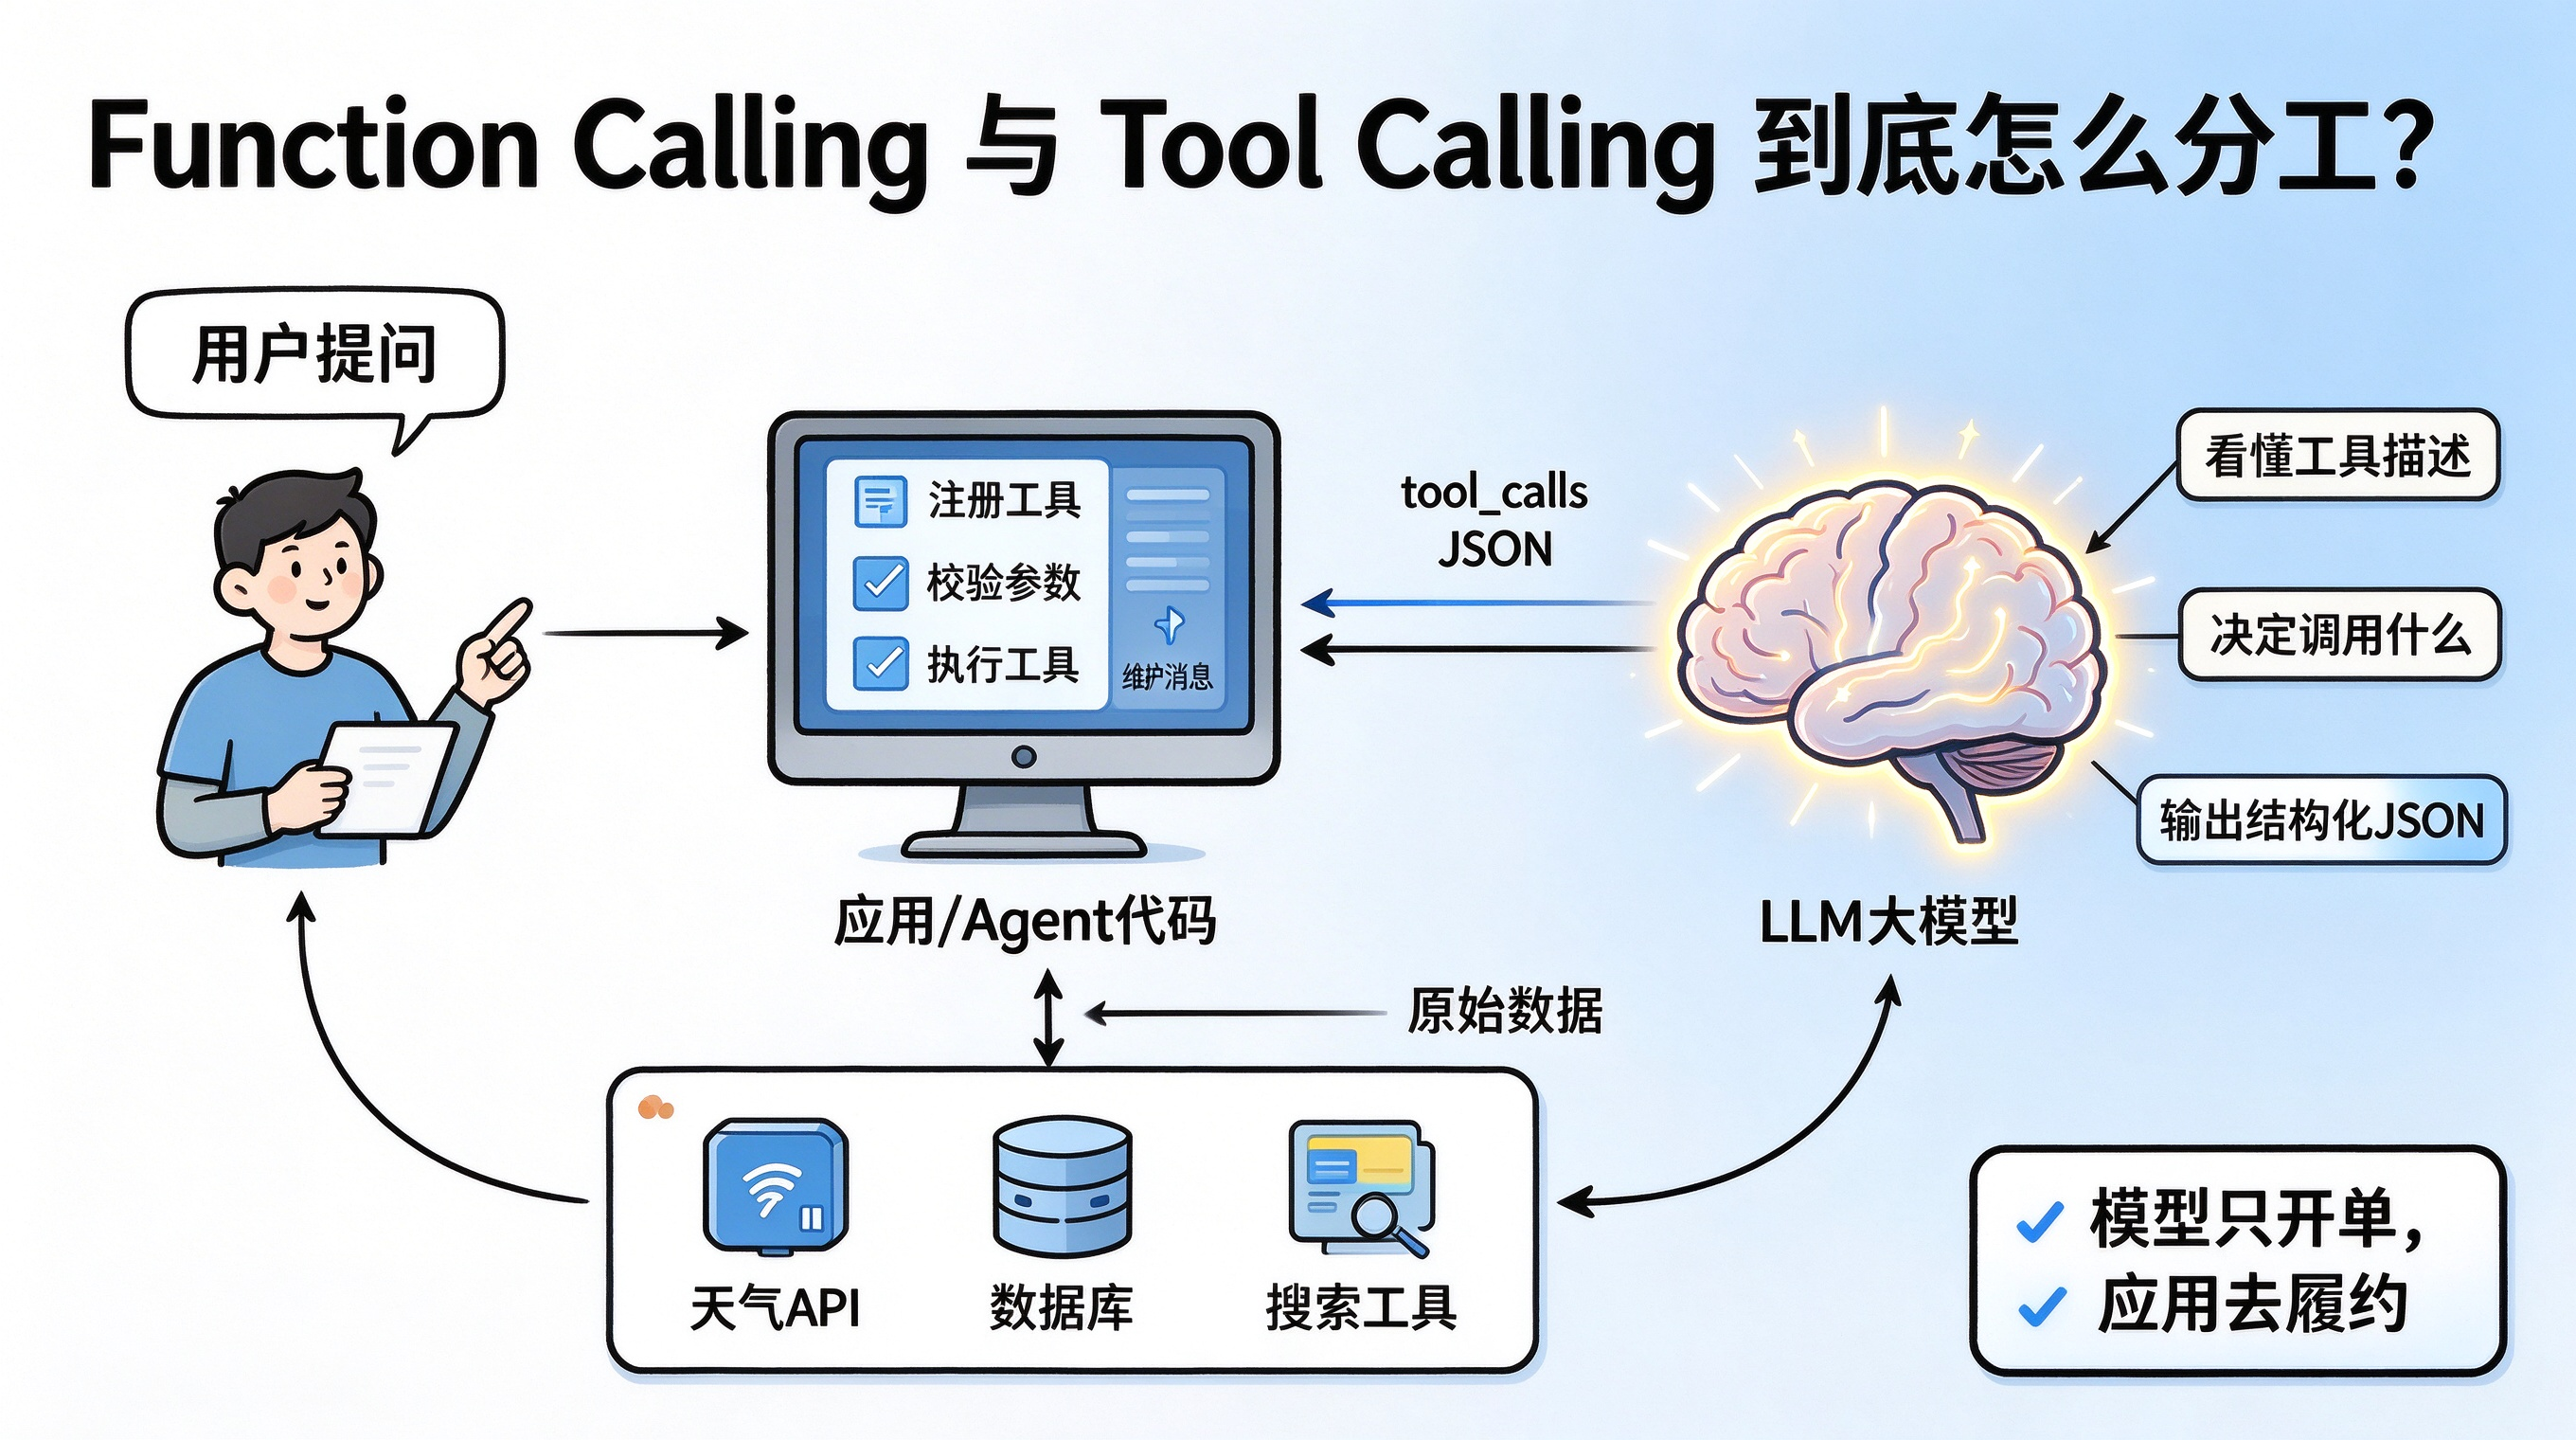
但严格来说二者不是等价概念:Function Calling 是大模型原生能力,Tool Calling 是上层应用范式。
一句话总览:
Function Calling:大模型输出结构化参数,用来调用工具的能力(模型侧能力)。
Tool Calling:一套完整的应用流程,利用 Function Calling 去调用外部工具(应用侧框架)。
1.Function Calling:模型只负责「决定调什么」
1.1 定义:模型的原生能力
Function Calling 是大模型本身具备的能力。
开发者提前给模型描述好一个工具的名字、用途描述、参数结构(JSON Schema)。当模型判断需要使用这个函数获取信息时,它不会直接生成自然语言回答,而是输出一个固定格式的结构化 JSON,包含工具名和参数。
需要说明的是,这里的「原生」是相对于「用提示词诱导」而言的。
在 2023 年 6 月,OpenAI 正式推出 function calling 之前,让模型调用工具的主流做法是在 prompt 里写清工具清单和输出格式,再要求模型输出 JSON,最后由开发者解析。模型经常不守规矩:多写解释、格式跑偏、参数编造。
OpenAI 通过定向指令微调(SFT),让模型学会这套输出格式,再通过 API 的 tools 参数暴露给开发者。此后各家模型陆续跟进,字段名略有差异,但「传入工具描述 → 模型返回结构化调用意图」成了事实标准。
所以「原生」的意思是:这个能力由模型厂商提供,而不是应用开发者用提示词临时拼出来的。
但要注意它的边界:模型的产出物只有一段结构化 JSON。工具怎么执行、结果怎么用,模型一概不管。
1.2 完整示例:从工具描述到返回 tool_calls
我们用一个查询天气的例子,完整走一遍模型侧的过程。
① 工具描述(JSON Schema)
开发者需要告诉模型三件事:工具叫什么、用来做什么、需要什么参数。
| 名称 | get_weather |
| 用途 | 查询城市天气 |
| 参数 | city,字符串,必填 |
把这些信息写成 JSON Schema,就是下面请求体中 tools 字段的样子。
② 第一轮请求
{
"model": "gpt-4o",
"tools": [
{
"type": "function",
"function": {
"name": "get_weather",
"description": "查询城市天气",
"parameters": {
"type": "object",
"properties": {"city": {"type": "string"}},
"required": ["city"]
}
}
}
],
"messages": [
{"role": "system", "content": "你是天气助手"},
{"role": "user", "content": "武汉今天天气怎么样?"}
]
}
③ 模型返回 tool_calls
模型判断需要调用工具,于是并不输出自然语言,而是返回一条携带 tool_calls 的 assistant 消息:
{
"role": "assistant",
"content": null,
"tool_calls": [
{
"id": "call_123",
"type": "function",
"function": {"name": "get_weather", "arguments": "{\\"city\\":\\"武汉\\"}"}
}
]
}
这里有两个细节值得注意:
- content 是 null:模型没有说「人话」,只给出了调用请求;
- arguments 是一个 JSON 字符串,不是对象,使用前需要解析。
1.3 划一条线:到这里,Function Calling 就结束了
模型返回 tool_calls 这一刻,Function Calling 的任务已经全部完成。
回头看,模型做的事情只有四件:
它不能执行函数,不知道执行结果,也不会自己发起第二次请求。
接下来的执行、回填、再请求——没有一件是模型做的。
还需要补充一点:Function Calling 并没有让工具调用变得「可靠」。
它解决的是格式问题:模型输出的是结构化调用请求,程序能稳定接住。但请求内容是不是对的——工具选得对不对、参数填得对不对——仍然是概率问题,FC 不负责。
正因为如此,模型返回之后,应用侧必须做校验、执行和出错处理。这也正是下一节 Tool Calling 存在的理由。

2.Tool Calling:应用负责「把决定变成结果」
Function Calling 负责「决定调什么」,Tool Calling 负责「把决定变成结果」。
模型返回 tool_calls 之后,应用侧还要接着把事情做完,整条链路才算闭环。
2.1 模型返回之后,应用做了什么
接着上面的例子。模型给出了调用请求,接下来轮到应用侧:
应用侧操作(重点)
追加之后,完整的 messages 变成这样:
"messages": [
{"role": "system", "content": "你是天气助手"},
{"role": "user", "content": "武汉今天天气怎么样?"},
// 追加:模型上一轮返回的 assistant 消息(携带 tool_calls)
{"role": "assistant", "content": null,
"tool_calls": [{"id": "call_123", "type": "function",
"function": {"name": "get_weather", "arguments": "{\\"city\\":\\"武汉\\"}"}}]},
// 追加:全新的 tool 结果消息,不是修改旧消息!
{"role": "tool", "tool_call_id": "call_123",
"content": "{\\"city\\":\\"武汉\\",\\"temp\\":24,\\"weather\\":\\"多云\\"}"}
]
然后,应用把这份 messages 连同 tools 定义,再次发送给 LLM:
{
"model": "gpt-4o",
"tools": [
{
"type": "function",
"function": {
"name": "get_weather",
"description": "查询城市天气",
"parameters": {
"type": "object",
"properties": {"city": {"type": "string"}},
"required": ["city"]
}
}
}
],
"messages": [
{"role": "system", "content": "你是天气助手"},
{"role": "user", "content": "武汉今天天气怎么样?"},
{"role": "assistant", "content": null,
"tool_calls": [{"id": "call_123", "type": "function",
"function": {"name": "get_weather", "arguments": "{\\"city\\":\\"武汉\\"}"}}]},
{"role": "tool", "tool_call_id": "call_123",
"content": "{\\"city\\":\\"武汉\\",\\"temp\\":24,\\"weather\\":\\"多云\\"}"}
]
}
对比第一轮请求,唯一的变化是 messages 多了两条:模型自己发起的调用,以及工具返回的结果。
此时模型能读到全部历史:用户提问、自己发起的 tool_calls、工具返回的数据。它会继续推理,判断现在能不能回答,还是需要再调用工具。
如果还需要,应用就重复上面的过程,直到模型不再发起调用。这个重复的过程,就是第 3 节要讲的循环。
2.2 完整链路五步
把上面的流程抽象一下,一个完整的 Tool Calling 链路包含五步:
| ① 工具注册与描述 | 用 JSON Schema 写清工具的名字、用途、参数 | 应用 |
| ② 工具选择 | 从工具列表里挑 0 个 / 1 个 / 多个 | 模型 |
| ③ 参数生成 | 输出结构化 JSON 参数 | 模型 |
| ④ 校验与执行 | 校验参数是否合法,真正调用函数 / API | 应用 |
| ⑤ 结果回填与循环 | 把结果转成 tool 消息,回到第 ① 步 | 应用 |
这张表,就是 Function Calling 和 Tool Calling 的分工全貌。
Function Calling 只覆盖第 ②③ 步。剩下的 ①④⑤——工具怎么描述、参数能不能直接用、工具怎么执行、结果怎么回填、循环怎么继续——全部由应用侧实现。
所以更准确的说法是:
Function Calling 给了应用「动手的资格」,Tool Calling 才是「把整套动作做完的流程」。
还有一个容易被忽略的细节:第 ① 步的工具描述虽然是应用写的,但它是 Function Calling 的输入。描述写得含糊,模型就会选错工具;参数 schema 写得不清,模型就会填错参数。所以这一步既属于 Tool Calling 的准备,也直接决定 Function Calling 的表现。
2.3 为什么它叫「范式」而不是「能力」
「能力」是模型自带的、开箱即用的东西;「范式」是开发者搭建的一整套约定和流程。
- Function Calling 回答的是:模型怎么表达它想调用工具?
- Tool Calling 回答的是:从工具定义到拿到最终答案,整条链路怎么组织?
前者是一个输出能力,后者是一个系统工程。这也是为什么:
- 换一个支持 Function Calling 的模型,工具调用能力还在;
- 但你的参数校验、执行逻辑、循环控制、错误处理,一样都不能少。
还需要说明两个容易混淆的点。
第一,Tool Calling 和 Function Calling 不是严格的包含关系。
从范围上看,Tool Calling 覆盖了模型侧的那一环。但更准确地说,二者的关系是「使用」而不是「包含」:
- 有原生 Function Calling 时,Tool Calling 用它作为模型侧基础;
- 没有时,用 prompt 让模型输出 JSON 也能走完同样的流程,只是可靠性差得多。
第二,Tool Calling 是跨厂商通用的流程范式,但不是统一规范。
各家的链路逻辑一致:
定义工具 → 模型选择 → 生成参数 → 执行 → 回填 → 循环
但协议字段并不相同:
| 工具定义 | tools[].function | tools[] + input_schema | tools[].functionDeclarations |
| 模型返回 | tool_calls | tool_use | functionCall |
| 结果回填 | role: "tool" + tool_call_id | tool_result + tool_use_id | functionResponse |
所以更准确的说法是:范式通用,协议不统一。
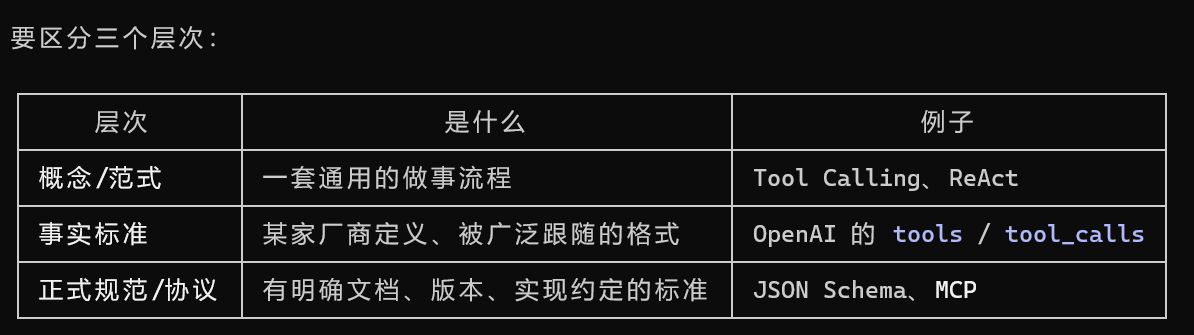
真正被标准化的是另外两样东西:参数描述格式 JSON Schema,以及工具接入协议 MCP。前者定义了工具长什么样,后者定义了工具如何被接入和发现。
换句话说:模型厂商负责「开单」(输出调用请求),开发者负责「履约」(把请求执行到出结果)。
3.Tool Loop:Tool Calling 的核心
2.1 里我们只走了一轮。如果模型看完工具结果,发现信息还不够,又发起下一次调用呢?
应用侧要做的,就是把这个过程重复下去。这个重复的过程,业界通常称为 Tool Loop(工具循环)。
3.1 循环发生在应用侧,因为模型是无状态的
一个很容易想错的地方:
模型上一轮返回了 tool_calls,下一轮它肯定记得自己调过工具吧?
不是的。模型完全无状态。
每一次 API 调用,对模型来说都是一次全新的、毫无记忆的请求。它唯一能看到的东西,就是这次传进去的 messages 数组。
换句话说:
「记忆」不在模型里,而在应用每次重新拼好的 messages 里。
我们能用两个例子直观感受一下。
情况 A:正确回填
"messages": [
{"role": "user", "content": "武汉今天天气怎么样?"},
{"role": "assistant", "content": null,
"tool_calls": [{"id": "call_123", "type": "function",
"function": {"name": "get_weather", "arguments": "{\\"city\\":\\"武汉\\"}"}}]},
{"role": "tool", "tool_call_id": "call_123",
"content": "{\\"city\\":\\"武汉\\",\\"temp\\":24,\\"weather\\":\\"多云\\"}"}
]
模型看到这三条,才能推理出:“我已经查过武汉的天气,结果是 24 度多云,可以回答了。”
情况 B:漏掉 assistant 消息
"messages": [
{"role": "user", "content": "武汉今天天气怎么样?"},
{"role": "tool", "tool_call_id": "call_123",
"content": "{\\"city\\":\\"武汉\\",\\"temp\\":24,\\"weather\\":\\"多云\\"}"}
]
模型会懵:这个结果对应哪一次调用?我什么时候调过工具?——轻则报错,重则再调一次工具。
所以循环的第一步不是"发请求",而是保证历史是完整的。
3.2 循环的四个动作
抛开细节,一个工具循环只有四个动作:
| ① 请求模型 | 带着完整的 messages 和 tools 发起请求 |
| ② 检查返回 | 看模型返回的消息里有没有 tool_calls |
| ③ 执行并回填 | 有 tool_calls 就逐个执行,把结果追加进 messages,回到 ① |
| ④ 输出结果 | 没有 tool_calls,说明模型认为信息够了,直接拿 content 作为最终回答 |
用一个流程图表示:
┌──────────────────────────┐
│ 请求模型(带 messages) │
└────────────┬─────────────┘
▼
┌─────────────────┐
│ 有 tool_calls? │
└───────┬─────────┘
有 │ │ 没有
▼ ▼
┌──────────────┐ ┌──────────────┐
│ 执行工具 │ │ 输出最终回答 │
│ 追加 tool 消息│ └──────────────┘
└──────┬───────┘
│
└────────────► 回到请求模型
3.3 终止条件:循环什么时候停
正常情况下,终止条件是唯一的:
模型返回的消息里,tool_calls 为空。
但只有这一条不够。
真实场景里,循环可能停不下来:
- 工具一直报错,模型反复重试;
- 模型陷入重复调用同一个工具的死循环;
- 模型不断发起新的调用,永远不满足。
所以应用侧必须再加一层兜底:最大循环轮数。
超过轮数就强制终止,并返回一个明确的错误,而不是无限跑下去。
这也是生产环境和 demo 的一个重要区别:demo 只考虑"成功路径",生产必须考虑"失败时怎么退出"。
另外,循环每转一圈,messages 都会变长。轮数越多,上下文压力越大,这也是需要限制轮数的原因之一。工具结果过大的问题,我们会在下一节展开。
最后提醒一句:上面说的是 Tool Loop 的终止条件——「模型不再请求工具」,而不是「任务完成」。这两者的区别,我们会在最后一节展开。
3.4 把它写成代码
把上面的四个动作写成代码,其实就这么短:
def run_tool_loop(messages, tools, max_rounds=10):
for _ in range(max_rounds):
# ① 带着完整历史请求模型
msg = llm.chat(model="gpt-4o", tools=tools, messages=messages)
# ② 关键:把带 tool_calls 的 assistant 消息原样存回历史
messages.append(msg)
# ③ 终止条件:模型不再需要工具
if not msg.tool_calls:
return msg.content
# ④ 逐个执行工具,并把结果回填
for call in msg.tool_calls:
result = execute(call.function.name, json.loads(call.function.arguments))
messages.append({
"role": "tool",
"tool_call_id": call.id,
"content": result,
})
# ⑤ 兜底:防止工具持续失败导致死循环
raise RuntimeError("超出最大轮数")
这段代码里有三处必须做对,否则链路会立刻断掉:
- messages.append(msg):漏了这句,模型下一轮就看不到自己发起过调用,会重复调用;
- tool_call_id:填错或漏填,模型匹配不到结果,整条记录就失效了;
- for call in msg.tool_calls:模型可能一次返回多个调用,只处理一个会导致后续出错。
说明:不同 SDK 对消息对象的序列化方式不一样(例如 OpenAI Python SDK 通常需要 model_dump() 转成 dict),上面的代码重点在流程,不是直接可运行的工程实现。
到这里,循环就转起来了。
但请注意它的出口:“模型觉得可以回答了。”
如果把这个出口换成"事情做完了",循环的性质就变了。这个问题,我们留到最后一节再展开。
4.四个实践中的坑
机制和流程讲完了,但真正写代码时,下面四个坑几乎一定会踩到。
4.1 tool_call_id 对不上
这是最常见、也最容易排查的坑。要理解它,得先把 id 本身搞清楚。
先搞清:这个 id 是谁生成的
很多人的第一反应是:工具是我注册的,id 应该也是我定义的吧?
不是。调用 id 由模型服务在返回响应时生成,不是开发者注册工具时定义的。
这里要分清两样东西:
| 工具名 name | get_weather | 开发者,写在 tools 里 |
| 调用 id tool_calls[].id | call_123 | 模型服务生成,开发者原样使用 |
为什么这样设计?有三个原因。
第一,id 标识的是「一次调用」,不是「一个工具」。
开发者定义的是工具目录:有哪些工具、每个工具叫什么、需要什么参数。模型决定的是:这一次调用哪个工具、调用几次。
同一件工具可能被调用多次。比如并行查询北京和武汉的天气,两次调用的工具名都是 get_weather,完全无法靠名字区分哪次调用对应哪个结果,必须给每次调用分配一个唯一的 id。
可以类比商品编号和订单号:商品编号是商家定义的,订单号是下单系统生成的。同一件商品可以被下很多次单,每次都需要一个独立的订单号。
第二,调用是模型发起的,id 只能由生成响应的一方分配。
请求里只有 tools(工具定义),没有调用 id——因为在模型做出决定之前,根本不存在「这一次调用」。调用 id 是模型返回响应时才产生的信息,开发者没法提前定义它。
第三,唯一性和匹配的需要。
一次响应可能包含多个 tool_calls,多轮循环、并行执行又会产生更多调用实例。id 必须在当前响应内唯一,才能让每个工具结果准确归属到对应的调用。由生成响应的一方统一分配,是保证唯一性和双方理解一致的常规做法。
id 的唯一性范围
需要知道的是,id 只保证在「同一次响应」内不重复:
- 模型一次返回多个调用时,它们的 id 一定不同;
- 但不同响应之间,协议并不承诺全局唯一。
实际实现通常用高熵随机值生成,碰撞概率低到可以忽略。所以真正需要保证的是:在同一个 messages 历史里能正确匹配,不要把它当成数据库主键那样的全局唯一标识。
这也解释了一个常见疑问:很久没对话,又调用同一个工具,模型会复用旧 id 吗?
不会。每次调用都是新生成的 id,历史里的旧 id 原样保留,两者互不影响,回填时用新 id 即可。
为什么不能改写 id
那么,可以把 id 改成一个自己更好认的值吗?
不行。原因不是模型记住了原来的 id——模型本身没有任何记忆,它只看到你这次发过去的 messages。
真正的原因是:你这次拼装的 messages 内部必须自洽。
每条 tool 消息的 tool_call_id,必须能在前面某条 assistant 消息的 tool_calls[].id 里找到对应。
如果把回填的 id 改掉:
{
"messages": [
{"role": "user", "content": "武汉天气怎么样?"},
{"role": "assistant", "content": null,
"tool_calls": [{"id": "call_aaa", "type": "function",
"function": {"name": "get_weather", "arguments": "{\\"city\\":\\"武汉\\"}"}}]},
{"role": "tool", "tool_call_id": "my_own_id", "content": "{\\"temp\\":24}"}
]
}
这份输入本身就断了:assistant 声明的是 call_aaa,tool 却说自己对应 my_own_id。
结果通常是:
- API 服务端校验失败,直接返回错误;
- 或者模型无法把结果关联到调用,推理出错。
整个过程不需要模型有任何记忆——问题完全出在这一次请求的数据内部。
所以最稳妥的做法就是:模型给什么 id,就原样保存、原样回填。
三种常见错误
① 漏填
{"role": "tool", "content": "{\\"temp\\":24}"}
② 写错
{"role": "tool", "tool_call_id": "call_abc", "content": "…"}
③ 多个调用全用同一个 id
{"role": "tool", "tool_call_id": "call_1", "content": "北京 24 度"},
{"role": "tool", "tool_call_id": "call_1", "content": "武汉 26 度"}
后果都一样:这次请求内部对不上,轻则重复调用工具,重则直接报错。
做法
把模型返回的 id 原样透传,不要自己生成、不要改写。
另外还有两点:
- 不要假设格式:OpenAI 常见 call_xxx,Claude 是 toolu_xxx,不同厂商并不相同;
- 不要依赖全局唯一:id 只在同一次响应内有唯一性保证,实际碰撞概率极低,但不要拿它当主键。
多个调用时,用一个 id → 结果 的映射逐条回填。
如果发现新返回的 id 和历史里已有的 id 冲突,最安全的做法是报错,而不是自行修复:
history_ids = {
tc["id"]
for m in messages
if m.get("role") == "assistant"
for tc in (m.get("tool_calls") or [])
}
for call in msg.tool_calls:
if call.id in history_ids:
raise RuntimeError(f"tool_call_id 与历史冲突:{call.id}")
4.2 参数幻觉
前文说过:Function Calling 保证了格式,但没有保证内容。
模型返回的参数,可能长这样:
{"city": "武汉", "unit": "c"} // unit 不在 schema 里
{"city": 123} // 类型错误
{"city": "武汉", "date": "今天"} // date 不在 schema 里
{} // 缺必填
更隐蔽的是语义错误:格式全对,但值是错的——城市名用了简称、日期时区错了、ID 是编造的、金额单位搞混。
做法:拿到参数后,先校验,再执行。
from jsonschema import validate
args = json.loads(call.function.arguments)
# 第一层:结构校验
validate(instance=args, schema=tool.schema)
# 第二层:业务校验(schema 查不出来的)
if args["city"] not in known_cities:
raise ValueError("未知城市")
# 通过校验后,才允许执行
execute(call.function.name, args)
尤其当工具涉及写操作(转账、删数据、发消息)时,除了校验,通常还需要权限控制和人工确认。模型输出的参数,永远只能当作"用户意图的转述",不能当作可信输入。
4.3 工具结果太大
想象一个 read_file 工具,模型读了一个 2MB 的日志文件,你把结果原封不动塞进 tool 消息。
后果很直接:
- 上下文瞬间被撑满,后续推理质量下降;
- token 成本飙升;
- 超出窗口时直接报错。
做法:在回填之前,先控制结果的大小。
def truncate(content: str, max_chars: int = 4000) –> str:
if len(content) <= max_chars:
return content
return content[:max_chars] + "\\n…[结果已截断]"
几种常用手段:
| 截断 | 日志、文件、长文本 |
| 分页 | 列表、搜索结果、数据库查询 |
| 只返回需要的字段 | 结构化数据 |
| 摘要 | 长文档,但会多一次模型调用 |
注意:截断后要明确告诉模型"结果不完整",否则它可能基于残缺信息给出错误结论。
4.4 并行工具调用
模型可能在一次返回里给出多个调用,比如同时查北京和武汉的天气:
"tool_calls": [
{"id": "call_1", "type": "function",
"function": {"name": "get_weather", "arguments": "{\\"city\\":\\"北京\\"}"}},
{"id": "call_2", "type": "function",
"function": {"name": "get_weather", "arguments": "{\\"city\\":\\"武汉\\"}"}}
]
错误做法:只处理第一个就继续请求。剩下的调用没有结果,下一轮对话会出错。
正确做法:全部执行、逐个回填。
这些调用之间通常没有依赖,可以并发执行来省时间:
import asyncio
async def execute_all(calls):
tasks = [
execute_async(call.function.name, json.loads(call.function.arguments))
for call in calls
]
return await asyncio.gather(*tasks)
results = await execute_all(msg.tool_calls)
for call, result in zip(msg.tool_calls, results):
messages.append({
"role": "tool",
"tool_call_id": call.id,
"content": result,
})
并发时要注意两点:
- 控制并发数:不要一次打出去几十个请求;
- 设置超时和失败处理:单个调用失败,不应该让整批结果都丢失。
4.5 四个坑的共同点
| tool_call_id 对不上 | 数据对不上 | 原样透传、一一映射 |
| 参数幻觉 | 数据不可信 | 结构校验 + 业务校验 |
| 结果太大 | 规模失控 | 截断、分页、摘要 |
| 并行调用 | 处理不完整 | 全部执行、并发控制 |
一句话总结:
模型负责"说",但说得对不对、全不全、大不大,应用都得兜住。
这也再次说明:Function Calling 只是能力,真正决定系统能不能用的,是应用侧那一整套 Tool Calling 流程。
5.一张表讲清区别
前面几节,我们拆开了 Function Calling、Tool Calling 和 Tool Loop。现在把三者放在一起,用一张表收口。
5.1 概念对比
| 本质 | 模型能力 | 应用范式 |
| 所在层级 | 模型侧 | 应用侧(包含模型) |
| 由谁提供 | 模型厂商 | 应用开发者 |
| 输入 | tools 定义 + messages | 工具 + 模型 + 执行环境 + 循环 |
| 产出 | 结构化调用请求(工具名 + 参数) | 最终回答 |
| 是否执行工具 | 否 | 是 |
| 是否包含循环 | 否 | 是 |
| 谁保证结果正确 | —(不负责) | 应用侧(校验、执行、回填) |
| 类比 | 只负责开单 | 负责履约 |
5.2 三者的关系
Tool Calling(完整范式)
├── 工具注册与描述
├── Function Calling
│ ├── 工具选择
│ └── 参数生成
├── 参数校验
├── 工具执行
├── 结果回填
└── Tool Loop(循环)
三条关系,可以分别用一句话记住:
- Tool Calling 使用 Function Calling:FC 只是模型侧的那一环,不是 TC 的全部;
- Tool Calling 包含 Tool Loop:循环是 TC 的运转机制;
- Tool Loop 不等于 Agent Loop:前者的出口是「能回答了」,后者是「事做完了」。
5.3 出问题时,该查哪一层
这张表比概念对比更有用。实际开发中,先定位问题属于哪一层,能少走很多弯路。
| 模型选错了工具 | 描述含糊 / 工具重名 / 工具太多 | 工具描述 + Function Calling |
| 参数格式不合法 | 模型输出问题 | Function Calling |
| 参数语义错误 | 模型幻觉 / 缺少业务校验 | Function Calling + 应用校验 |
| 工具执行失败 | 业务代码或外部 API 问题 | 应用侧(Tool Calling) |
| tool_call_id 对不上 | 回填逻辑错误 | 应用侧(Tool Calling) |
| 循环停不下来 | 终止条件或兜底缺失 | 应用侧(Tool Calling) |
| 上下文爆炸 | 工具结果太大 / 轮数过多 | 应用侧(Tool Calling) |
| 换模型后行为变化 | 协议字段差异 | 适配层(Tool Calling) |
规律很明显:
- 模型「想错」 → 先查工具描述和 Function Calling;
- 系统「做错」 → 查应用侧的校验、执行、回填和循环。
5.4 一句话记住
Function Calling 是模型「会调用」的能力,Tool Calling 是应用「能调用完」的系统。
6.小结
这篇博客想讲清的,其实就三句话:
合起来就是:
模型负责开单,应用负责履约。开单只是开始,履约才见真章。
最后回到上一篇:Tool Loop 能自动转很多轮,但它的出口是「我能回答了」,不是「事情做完了」。
能自动调用工具,不等于能自主完成任务。 Agent 的循环由目标驱动,直到完成判据满足才停止。