一、引言:同一个 Helm,为什么 Redis 比 MySQL 难?
上一篇我们用 Helm 把 MySQL 部署讲透了:StatefulSet + PVC + 主从复制。你可能会想"换个数据库照葫芦画瓢就行"——结论先给出来:不大行。Redis 的有状态语义和 MySQL 有本质差异,照搬会踩坑。
核心差异一句话:MySQL 是"磁盘为主、内存为缓存"的存储引擎,Redis 是"内存为主、磁盘为兜底"的缓存/存储一体机。这带来三个工程现实:
本文目标:用 Helm(bitnami/redis)把 Redis 三种拓扑逐一跑通,并把"内存型服务的持久化、故障转移、资源陷阱"讲透,让你真正理解有状态服务之间的差异化部署,而不是套模板。
二、原理解析
2.1 Redis 与 MySQL 的有状态差异对照表
维度
MySQL(上篇)
Redis(本篇)
数据主存
磁盘(InnoDB)
内存
持久化默认
始终落盘
默认不落盘(需开 appendonly)
删 Pod 后数据
在 PVC 里(除非 reclaimPolicy=Delete)
没了(除非开了持久化 + PVC)
连接模型
多线程、连接数受限
单线程命令执行、高并发靠多连接
拓扑
standalone / 主从异步
standalone / 主从+Sentinel / Cluster 分片
自动故障转移
❌(需 Orchestrator/Operator)
✅ Sentinel 原生支持
水平扩展
加只读副本
Cluster 分片(数据级)或加副本
资源瓶颈
CPU / IOPS / 连接数
内存(OOM 高发)
这张表是全文的"认知锚点"。后面所有实战决策,都是围绕"内存为主"和"拓扑选择"展开。
2.2 Helm 四件套(简版,详见上篇)
快速回顾,不展开:
- Chart:模板(bitnami/redis 就是官方维护的 Chart)
- Repository:Chart 仓库(helm repo add bitnami https://charts.bitnami.com/bitnami)
- Release:一次部署实例(helm install my-redis bitnami/redis)
- Values:本次部署的配置(-f values.yaml 或 –set)
⚠️ 版本铁律(与上篇一致):bitnami 的参数随版本重构,每次动手前先 helm show values bitnami/redis > redis-values.yaml 核对键名,不要用记忆里的旧键名。
2.3 Redis 三种拓扑的语义与选型
拓扑
架构参数
自动故障转移
数据分片
适用场景
standalone
architecture: standalone
❌
❌
开发/lab、纯缓存可丢数据
主从 + Sentinel
architecture: replication + sentinel.enabled: true
✅
❌
生产高可用、数据量单机可扛
Cluster
cluster.enabled: true
✅(主副本)
✅
数据量超单机内存、需横向分片
选型口诀:能丢数据用 standalone;要高可用且单机内存够用,上 Sentinel;单机内存扛不住,上 Cluster。
2.4 持久化与数据安全:Redis 最反直觉的坑
Redis 默认把数据放内存,不写磁盘。两个开关决定数据能否活过 Pod 重启: - appendonly: yes(AOF 持久化):每条写命令追加到 AOF 文件,重启重放 → 数据不丢(牺牲一点写性能)
- master.persistence.enabled: true:AOF 文件存进 PVC,Pod 重建后从 PVC 重放
两者必须同时开,否则: - 开了 appendonly 但没 PVC → Pod 重建后 AOF 丢了,数据仍蒸发
- 有 PVC 但没开 appendonly → 内存数据没落盘,重建后是空的
生产持久化最小正确组合
architecture: replication
master:
persistence:
enabled: true
size: 8Gi
storageClass: fast-ssd
configuration: |-
appendonly yes
appendfsync everysec
2.5 内存型服务的资源陷阱(OOM 比 MySQL 频繁)
Redis 单线程跑命令,瓶颈几乎永远是内存。两个认知必须建立:
master:
resources:
requests:
memory: 2Gi
cpu: 500m
limits:
memory: 2Gi # 上限,触达即 OOMKill
configuration: |-
maxmemory 1.7gb # 略小于 limit,预留 OS 开销
maxmemory-policy allkeys-lru # 触顶淘汰旧键,而非崩溃
三、实战演示
环境准备
1. 装 helm(如未装)
2. 加 bitnami 源并核对参数(版本铁律)
helm repo add bitnami https://charts.bitnami.com/bitnami
helm repo update
helm show values bitnami/redis > redis-values.yaml # 动手前必看键名
场景 1:最简 standalone 部署(开发/lab)
最简启动,数据在内存(删 Pod 即丢),仅适合缓存/测试
helm install my-redis bitnami/redis
–set architecture=standalone
–set auth.enabled=false
–set master.persistence.enabled=false
连接验证:
取 Pod 名并连进去
kubectl exec -it my-redis-master-0 – redis-cli ping
PONG
写读验证
kubectl exec -it my-redis-master-0 – redis-cli set foo bar
kubectl exec -it my-redis-master-0 – redis-cli get foo
“bar”
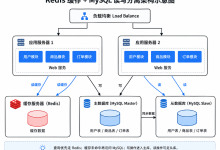
场景 2:主从 + Sentinel(生产高可用,自动故障转移)
redis-sentinel-values.yaml
architecture: replication # 主从复制
sentinel:
enabled: true # 开启哨兵,提供自动故障转移
auth:
enabled: true
password: “ChangeMe123!” # lab 用,生产改用 existingSecret
master:
persistence:
enabled: true
size: 8Gi
configuration: |-
appendonly yes
appendfsync everysec
maxmemory 3gb
maxmemory-policy allkeys-lru
resources:
requests: { memory: 4Gi, cpu: “1” }
limits: { memory: 4Gi, cpu: “1” }
replica:
replicaCount: 2 # 2 个只读副本
persistence:
enabled: true
size: 8Gi
helm install my-redis bitnami/redis -f redis-sentinel-values.yaml
验证主从 + 哨兵:
主节点写,副本读(副本只读)
kubectl exec -it my-redis-master-0 – redis-cli -a ChangeMe123! set k1 v1
kubectl exec -it my-redis-replica-0 – redis-cli -a ChangeMe123! get k1
“v1” ← 主从同步成功
删主 Pod,观察 Sentinel 自动提升某个副本为新主(几十秒内)
kubectl delete pod my-redis-master-0
kubectl get pods -w # 看到新 master-0 被重建,角色由 sentinel 重新指派
与 MySQL 的关键对照:MySQL replication 是异步复制、无自动故障转移(主挂了不会自动提副本,需 Orchestrator);而 Redis + Sentinel 原生支持自动故障转移——这正是"不同有状态服务部署差异"的典型体现。
场景 3:Cluster 模式(数据分片,超单机内存)
redis-cluster-values.yaml
cluster:
enabled: true # 开启 Cluster
nodes: 6 # 6 个节点(3 主 3 从,自动分配)
replicasPerMaster: 1 # 每主 1 副本
auth:
enabled: true
password: “ChangeMe123!”
persistence:
enabled: true
size: 8Gi
helm install my-redis-cluster bitnami/redis -f redis-cluster-values.yaml
验证分片与故障转移:
用 -c 走 cluster 模式连任意节点,cluster 会自动路由到正确槽位
kubectl exec -it my-redis-cluster-0 – redis-cli -c -a ChangeMe123! cluster info
cluster_state:ok、cluster_slots_assigned:16384
kubectl exec -it my-redis-cluster-0 – redis-cli -c -a ChangeMe123! set bigkey value
自动重定向到持有该槽的主节点
场景 4:生产级定制 Values(密码外置 + 安全上下文)
redis-prod-values.yaml
architecture: replication
sentinel:
enabled: true
auth:
enabled: true
existingSecret: redis-secret # 密码引用外部 Secret(呼应《配置管理》篇)
existingSecretPasswordKey: password
master:
persistence:
enabled: true
size: 8Gi
storageClass: fast-ssd
configuration: |-
appendonly yes
appendfsync everysec
maxmemory 3gb
maxmemory-policy allkeys-lru
containerSecurityContext: # 安全基线(呼应《Pod 安全》篇)
runAsNonRoot: true
readOnlyRootFilesystem: false # Redis 需写 AOF/working dir,不能只读根
resources:
requests: { memory: 4Gi, cpu: “1” }
limits: { memory: 4Gi, cpu: “1” }
metrics:
enabled: true # 暴露指标,喂给 Prometheus(呼应《可观测性》篇)
先建密码 Secret(按本系列《配置管理》篇的方式)
kubectl create secret generic redis-secret –from-literal=password=‘StrongPass!2026’
helm install my-redis bitnami/redis -f redis-prod-values.yaml
场景 5:升级与回滚
升级(如提 Redis 版本 / 改配置)
helm upgrade my-redis bitnami/redis -f redis-prod-values.yaml
查看历史
helm history my-redis
回滚到上一版(注意:回滚只回资源定义,PVC 数据不回滚,符合有状态预期)
helm rollback my-redis 1
持久化验证(呼应上篇 MySQL 同样的"灵魂测试"):
写数据 → 删主 Pod → 重建后读,证明数据活过重启
kubectl exec -it my-redis-master-0 – redis-cli -a ChangeMe123! set persist_test ok
kubectl delete pod my-redis-master-0
kubectl exec -it my-redis-master-0 – redis-cli -a ChangeMe123! get persist_test
“ok” ← 证明 appendonly + PVC 双开生效
四、排错实战
4.1 Helm 诊断四件套(与上篇同源)
helm ls # 看 release 状态
helm status my-redis # 看部署状态/notes
helm get values my-redis –all # 看合并后的最终 values
helm get manifest my-redis # 看渲染出的真实 YAML
helm history my-redis # 升级回滚历史
helm lint ./my-chart # 本地 Chart 语法检查
4.2 Redis 高频问题对照表
现象
根因
定位命令
修复
数据删 Pod 后丢失
没开 appendonly 或没挂 PVC
redis-cli config get appendonly、kubectl get pvc
双开持久化(见 2.4)
Pod 频繁 OOMKilled
limits.memory 太小或 maxmemory 触顶
kubectl describe pod 看 Last State: OOMKilled、redis-cli info memory
调大 limit + 设 maxmemory < limit + 配 maxmemory-policy
Sentinel 无法选主 / 集群脑裂
哨兵/集群 quorum 与网络分区、auth 不一致
redis-cli -p 26379 sentinel masters、kubectl logs
检查哨兵 auth 与主从一致、节点数满足 quorum
Cluster 槽未分配(MOVED/CLUSTERDOWN)
节点未全就绪 / 槽迁移中断
redis-cli cluster info 看 cluster_slots_assigned
等集群自愈或 redis-cli –cluster fix
连不上报 NOAUTH
客户端没带密码或密码错
redis-cli -a 重试
用 auth.existingSecret 统一密码源
主从不同步(replica 读不到主写)
主从 auth/网络不通、副本刚起
redis-cli info replication 看 master_link_status
检查主从 auth 一致、NetworkPolicy(呼应《NetworkPolicy》篇)放通 6379
PVC Pending
无默认 StorageClass / 资源不足
kubectl describe pvc、Events
指定 storageClass 或建默认 SC(呼应《存储》篇)
4.3 排错口诀
Redis 起不来?
├─ OOMKilled → 提 limits.memory,配 maxmemory < limit + maxmemory-policy
├─ 数据丢了 → appendonly + PVC 双开检查
├─ 主从/哨兵异常 → 看 info replication 的 master_link_status、sentinel 日志
├─ Cluster 异常 → cluster info 看 slots_assigned、redis-cli –cluster fix
└─ 连不上 → NOAUTH 查密码源、NetworkPolicy 查 6379 放通
五、总结
本篇把 Redis 这个"内存为主"的典型有状态服务讲透,并与上篇 MySQL 形成鲜明对照,让你理解有状态服务部署不是套模板、而是要吃透每个服务的差异化语义:
与系列其他篇的关联: