🔥 星光编译者 · 个人主页
📚 学习专栏: 《C/C++ 成长笔记》 · 《Linux 实践手册》 · 《数据结构与算法》
🌄 向云端飞扬,编译属于自己的代码星河。
☕ 写在开篇
你好,这里是 星光编译者。
这里记录我在 C/C++、Linux、数据结构与算法 学习中遇到的真实问题、亲手验证过的代码,以及那些容易被忽略的实现细节。
比起简单罗列结论,我更愿意从问题出发,把一个知识点的来由讲清楚,把“为什么会这样”和“应该怎样解决”说明白,让每一次踩坑都沉淀成可以复用的经验。
如果这篇记录能帮你少绕一点路,或让某个模糊的地方忽然变得清晰,那么这次分享便有了意义。愿我们在一次次阅读、编译与调试中稳步向前,慢慢搭起属于自己的技术世界。
🔥 本文定位:在 TCP Socket 可以收发数据之后,回答一个更关键的问题:收到的一串字节,怎样才能可靠地还原成一条条业务消息?
💡 学习目标:理解应用层协议与序列化的关系;区分 TCP 字节流和业务消息;设计长度前缀帧;实现能够处理半包、连续多帧与非法输入的解码器。
📌 实现范围:Linux、IPv4、阻塞 TCP、C++17。正文使用 length\\r\\nbody\\r\\n 帧格式;每条连接维护独立接收缓存,正文最大 64 KiB。JSON 与完整计算器放在下篇。
之前写回显服务时,我们可能会觉得网络通信很直接:客户端发送一句话,服务端收到后再把它发回来。但如果客户端连续发送两个计算请求,服务端的一次 recv 得到半条请求,或者同时得到两条请求,该怎么处理?
Socket 接口只把字节交给我们。把字节解释为业务消息,是应用程序必须完成的工作。这正是自定义协议要解决的问题。
文章目录
- 一、应用层协议究竟约定了什么
- 二、序列化为什么不能直接发送结构体
- 三、重新理解 send、recv 与全双工
- 四、TCP 为什么会出现半包与粘包
- 五、设计长度前缀帧
- 六、接收缓存的生命周期
- 七、完整的增量解码器
- 八、把拆包器接入阻塞收发
- 九、测试消息边界与异常输入
- 十、课堂代码中的实现细节
- 总结
一、应用层协议究竟约定了什么
1.1 从网络计算器开始
假设客户端想计算 7 + 3,服务端返回 10。如果我们只对服务端说“客户端会发一个字符串”,这个约定仍然不够明确。
请求里是否允许空格?负数怎么表示?只能做加法,还是支持减、乘、除、取模?运算失败时返回什么?一次请求在哪里结束?
这些问题不是网络设备替我们决定的,而是客户端与服务端共同遵守的规则。
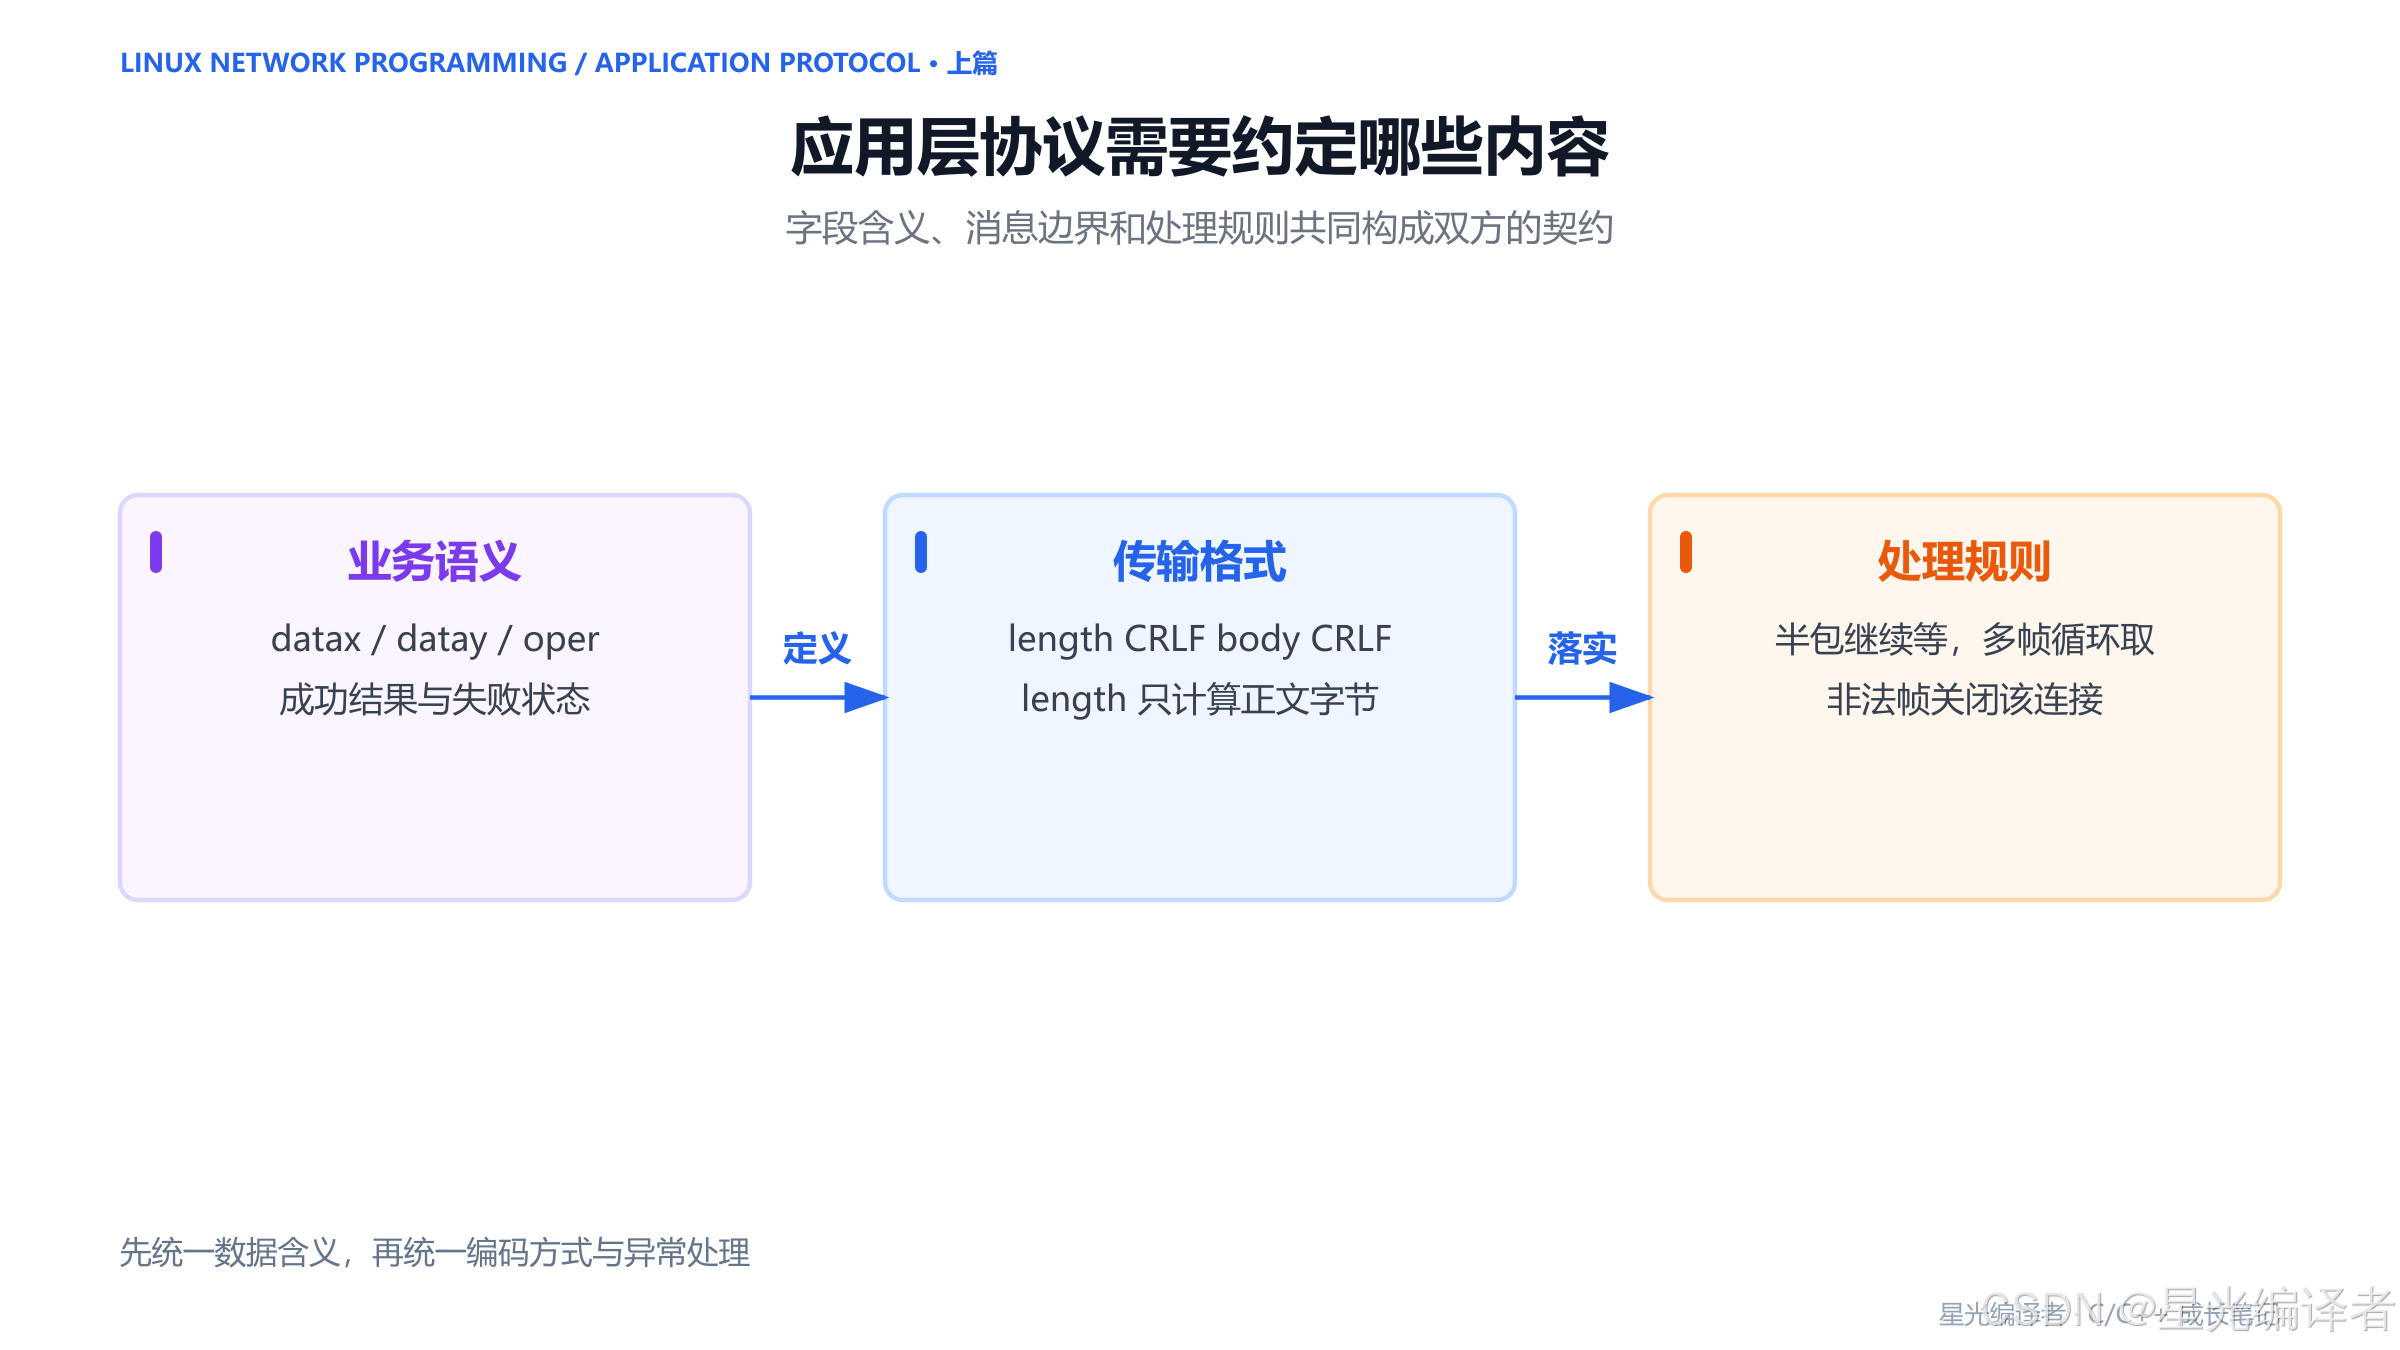
协议至少包含三类内容:
| 业务语义 | 两个操作数、运算符、结果、状态码 | 消息表达什么意思 |
| 编码格式 | 正文采用 JSON,外层采用长度前缀 | 消息怎样变成字节 |
| 处理规则 | 拒绝非法帧,校验字段,处理除零 | 消息怎样被接收和执行 |
“协议就是约定”容易记住,但真正落地时,必须把约定写到字段、格式、范围与行为上。只约定了字段名称,却没有约定字段类型,也会让双方在同一个消息上产生不同理解。
1.2 自定义不等于从零发明所有编码
自定义计算器协议,并不意味着必须亲手设计整数编码、字符串转义和对象格式。我们可以用 JSON 表达正文,同时自行约定字段名、允许值和外层帧格式。
这里同时存在两层约定:JSON 解决通用数据表达;计算器协议解决业务字段与通信行为。它们可以组合使用,没有“用了 JSON 就没有自定义协议”这样的限制。
1.3 为什么结果还要带状态码
7 – 7 的结果是零,7 / 0 却无法得到正常整数结果。如果服务器都只返回 0,客户端就分不清成功与失败。
因此响应需要至少两个字段:result 表达成功结果;code 表达执行状态。请求格式负责说明“想做什么”,响应格式负责说明“做成了没有,以及结果是什么”。
二、序列化为什么不能直接发送结构体
2.1 对象和线上字节是两种表示
程序内部可以使用这样的对象:
struct Request {
int datax;
int datay;
std::string oper;
};
它适合访问字段与执行业务。网络传输则需要一段具有明确长度的字节序列。把对象转换为可传输的字节表示,叫序列化;按同样规则把字节还原成对象,叫反序列化。
Request 对象
↓ Serialize
JSON 正文
↓ Encode
完整传输帧
接收方向按照相反顺序处理:先拆出完整正文,再解析正文中的字段。下篇会实现 JSON 部分,本篇先把完整正文可靠地取出来。
2.2 直接发送内存为什么不可靠
下面这段写法看上去省事:
send(fd, &request, sizeof(request), 0);
但接收端得到的是本进程对象的内存布局,不是双方共同定义的消息格式。
即使结构体只包含整数,也可能遇到整数宽度、字节序、对齐与填充差异。加入 std::string 后问题更明显:对象内部可能保存管理状态、容量以及与本进程地址空间有关的数据,发送这些内存并不等于发送字符串内容。
发送一个地址值也不会让另一台机器得到该地址指向的数据。双方必须约定“发送哪些值、以什么编码发送”,而不是假设自己的内存布局就是通用协议。
2.3 Socket 接口传输的是字节
PDF 为了方便入门,使用“按字符串方式收发”的说法。更准确地说,send、recv 接收的是缓冲区地址和字节数量,正文可以是文本,也可以是二进制数据。
std::string 在这里可以充当字节容器,但 C 字符串的结束规则不能直接套用到网络数据上。网络数据中可以出现 \\0,应当根据系统调用返回的实际长度处理。
三、重新理解 send、recv 与全双工
3.1 系统调用连接的是进程与本端内核
应用调用 send,把待发送的字节交给本端 Socket 的发送路径;调用 recv,从本端接收路径取出可读取的数据。数据何时真正传出、如何确认和重传,是 TCP 协议栈继续处理的工作。
send 成功不表示对端业务已经执行完,也不表示对端已经生成响应。要知道一次业务是否成功,仍需要接收并理解应用层响应。
3.2 为什么同一个连接 fd 可以读写
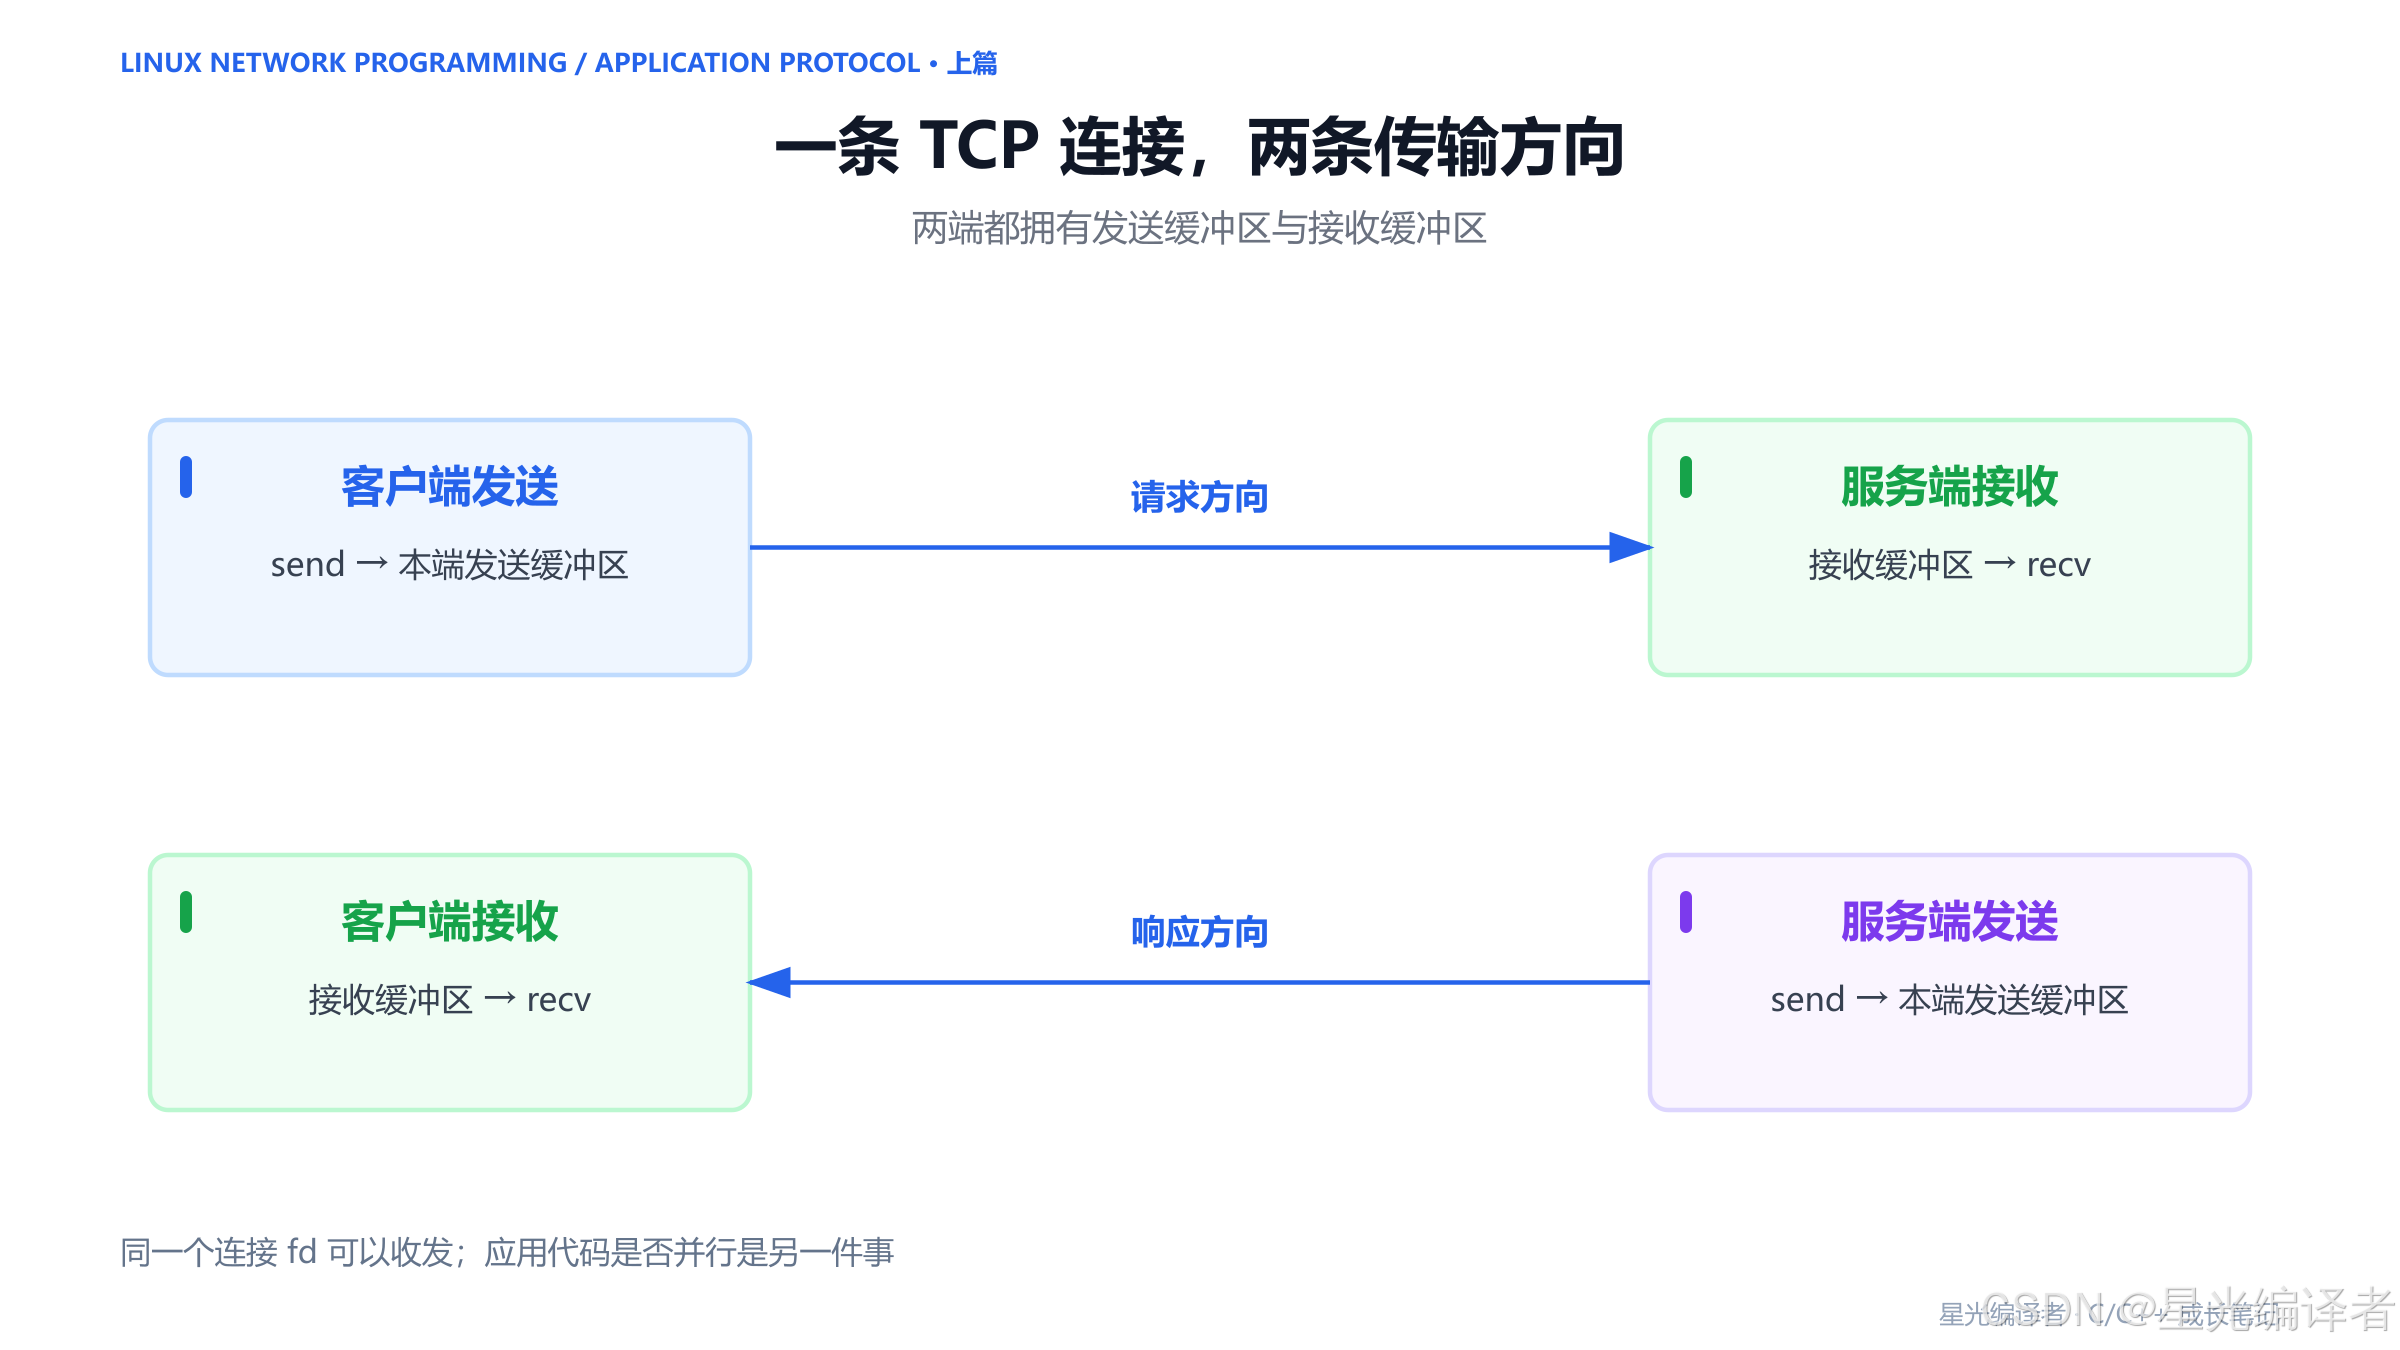
一条已建立的 TCP 连接支持两个方向的数据传输。客户端能发送请求,也能接收响应;服务端能接收请求,也能发送响应。
因此双方都通过自己的连接描述符收发。这里的“同一个 fd”是指一端内部使用同一个连接 fd,不是说客户端与服务端的描述符数值必须相同。
全双工描述的是连接具备双向传输能力。应用是否用两个线程同时收发,或者用一个线程按“发请求、等响应”的顺序执行,是应用设计问题。本系列计算器采用后一种模式,便于集中理解协议。
3.3 recv 的 size 是容量,不是请求长度
char chunk[4096];
ssize_t n = recv(fd, chunk, sizeof(chunk), 0);
4096 表示这次最多能写入多少字节,不代表内核必须凑齐 4096 字节才返回。普通接收调用通常会返回当前可用数据,数量最多达到请求上限。Linux recv 手册
| n > 0 | 本次拿到了 n 字节 | 按 n 追加到缓存 |
| n == 0 | 对端发送方向已经正常结束,且可读数据已取完 | 检查是否还有残帧,再结束读取 |
| n < 0 且 errno == EINTR | 系统调用被信号中断 | 重试 |
| 其他 n < 0 | 发生错误 | 结束当前连接处理 |
对于非阻塞 Socket,还需要处理 EAGAIN / EWOULDBLOCK。本文不把阻塞循环直接套到非阻塞程序里,后续 IO 模型章节再处理就绪事件与发送队列。
四、TCP 为什么会出现半包与粘包
4.1 TCP 保持字节顺序,不保留业务消息边界
客户端连续执行:
send(fd, "ABC", 3, 0);
send(fd, "DE", 2, 0);
假设这两次调用都成功发送了指定字节,接收端看到的流按顺序包含 ABCDE。但一次 recv 可能只返回 A,下一次返回 BCDE;也可能先返回 ABCD,再返回 E。
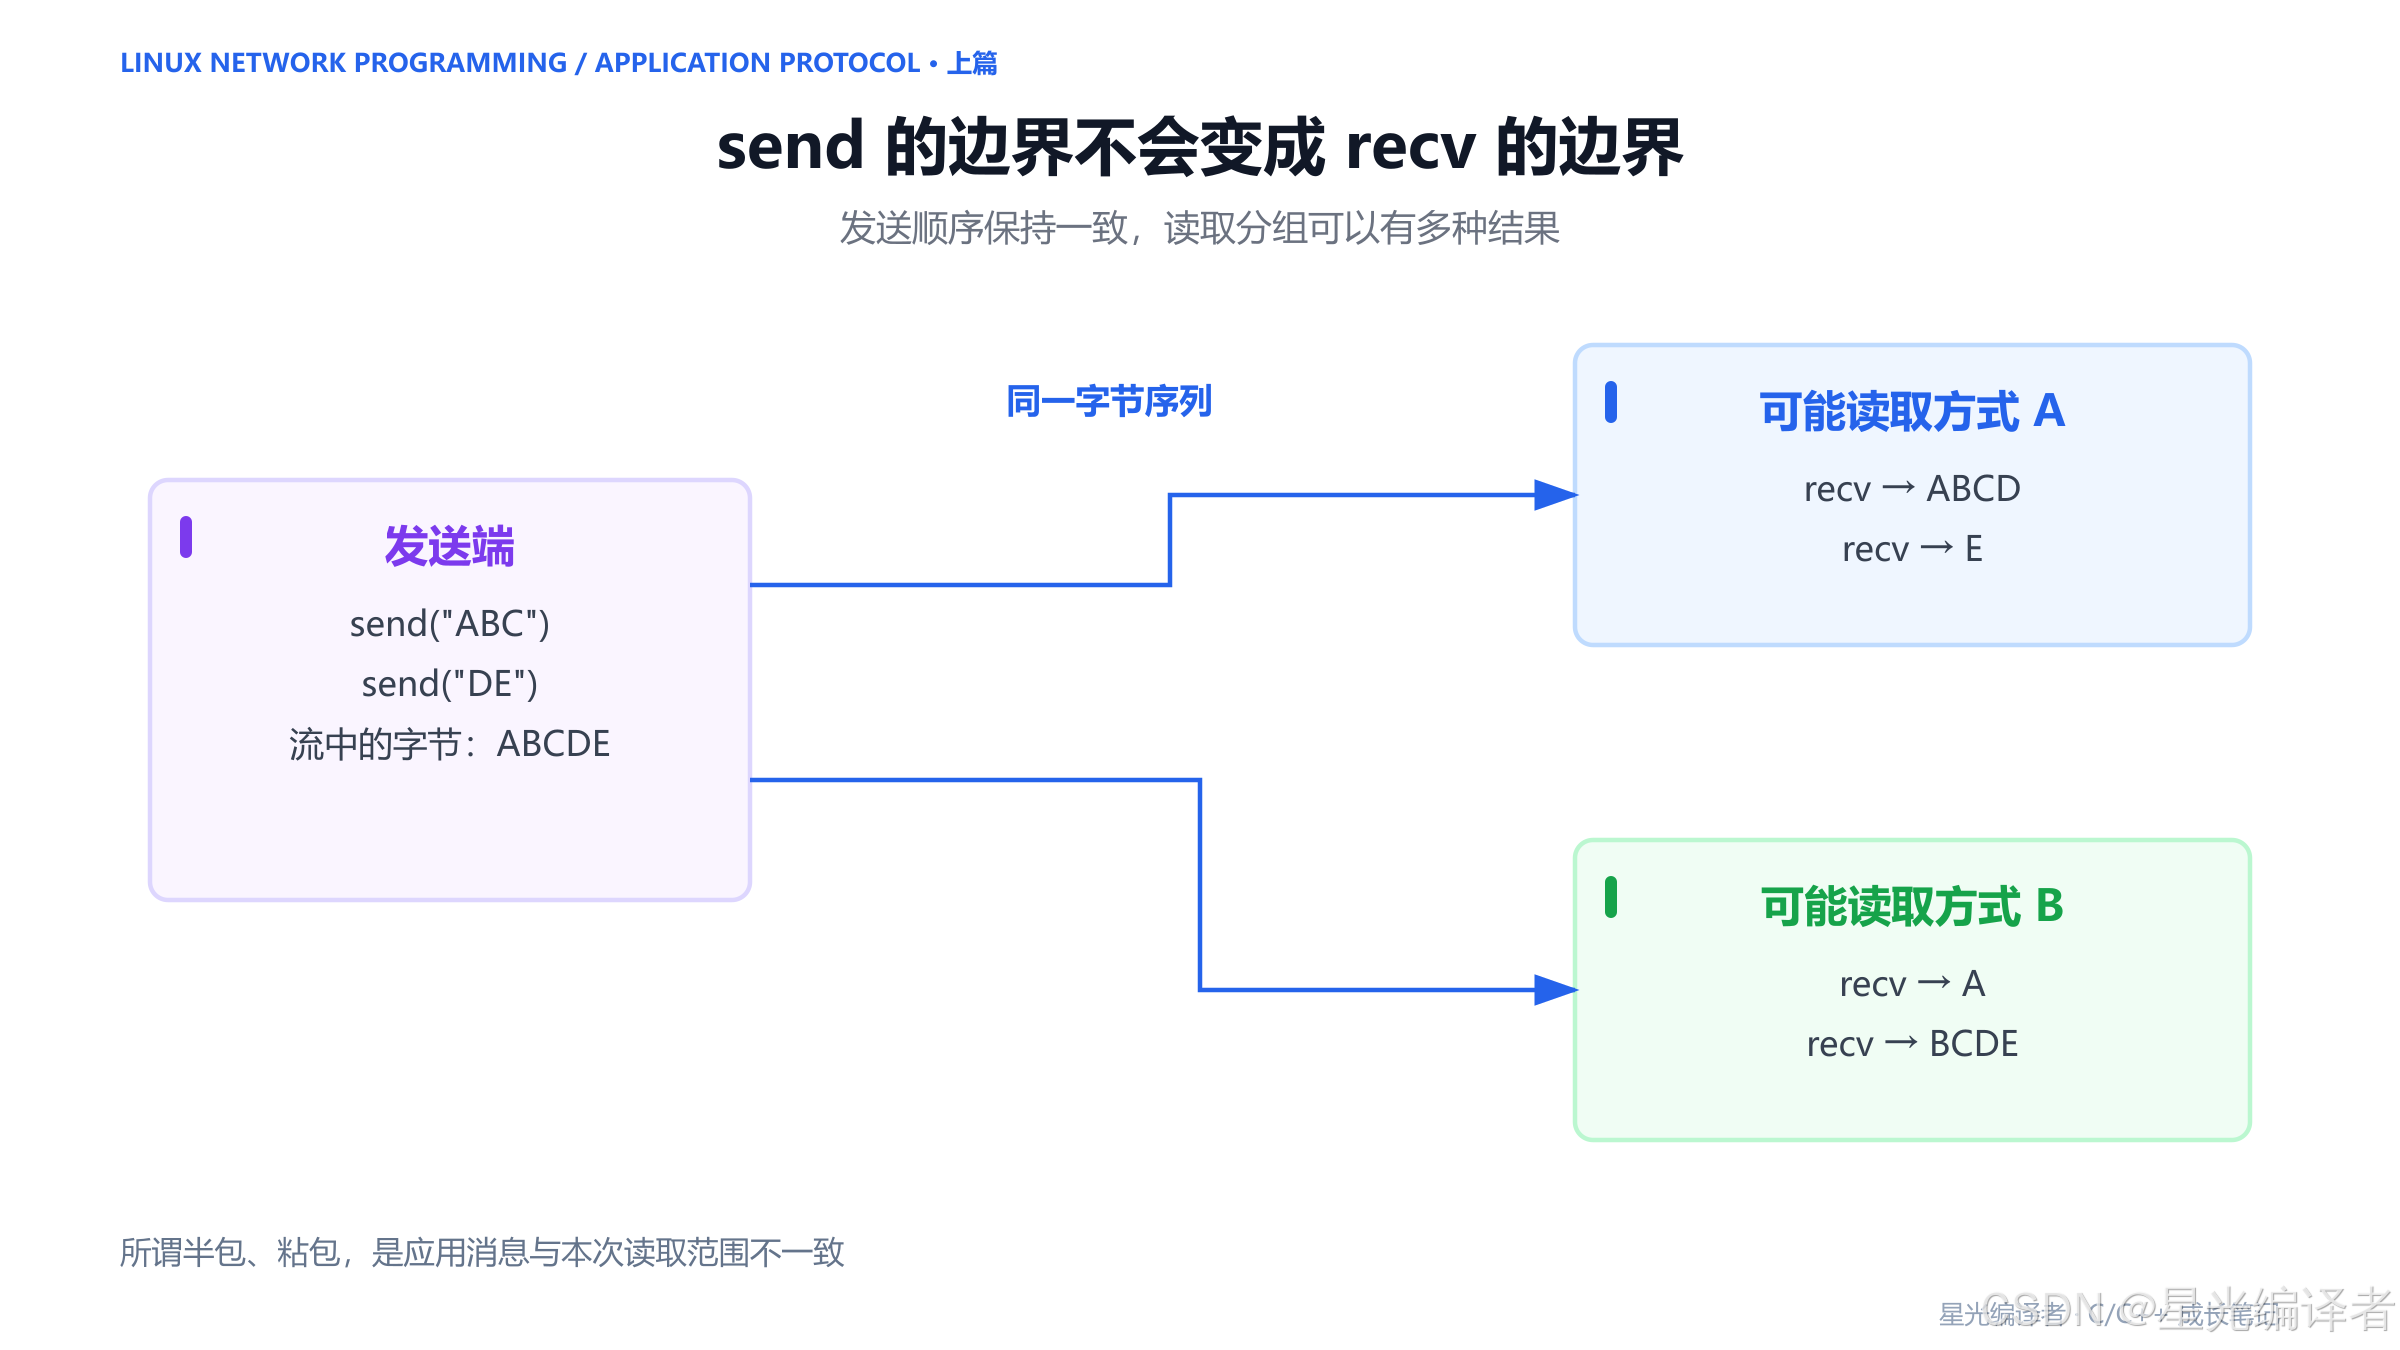
这些分组方式是可能出现的情况,用于说明接口契约,并不是预测某次运行必然怎样分包。接收缓冲区状态、读取时机与传输过程都会影响一次调用返回多少数据。
4.2 半包与粘包是应用层视角
一条业务消息只有一部分被本次读取取到,通常称为半包;多条业务消息的字节一起出现在一次读取结果中,通常称为粘包。
这里说的“包”是业务消息,不能把它与 IP 包、TCP 段混为一谈。应用的问题是如何确定消息边界,而不是修复 TCP 的顺序传输。
4.3 为什么加大数组或 sleep 无法解决
把读取数组从 1024 改成 65536,只是扩大一次读取的容量。即使数组足够大,这次也可能仅取到半条消息,也可能取到好几条消息。
发送后睡眠一会儿,也不能把时间间隔变成稳定的协议边界。只要“消息完整”没有用字节规则描述,接收端就无法仅凭读取时机可靠判断。
4.4 常见边界方案怎样选择
| 固定长度 | 每条消息固定 N 字节 | 固定记录、简单设备报文 | 变长正文可能浪费空间 |
| 分隔符 | 读到约定结束符 | 行文本协议 | 正文中出现分隔符时要转义或限制 |
| 长度前缀 | 头部声明正文长度 | 变长消息、二进制内容 | 严格校验长度与上限 |
| 连接结束 | EOF 表示正文结束 | 一条连接只传一份数据 | 难以在连接内连续传多条消息 |
本篇选择长度前缀,既能体现字符串处理,也能清楚展示增量拆包的基本思想。
五、设计长度前缀帧
5.1 本文统一的线上格式
<十进制正文字节数>\\r\\n<正文>\\r\\n
正文为 hello 时,完整帧为:
5\\r\\nhello\\r\\n
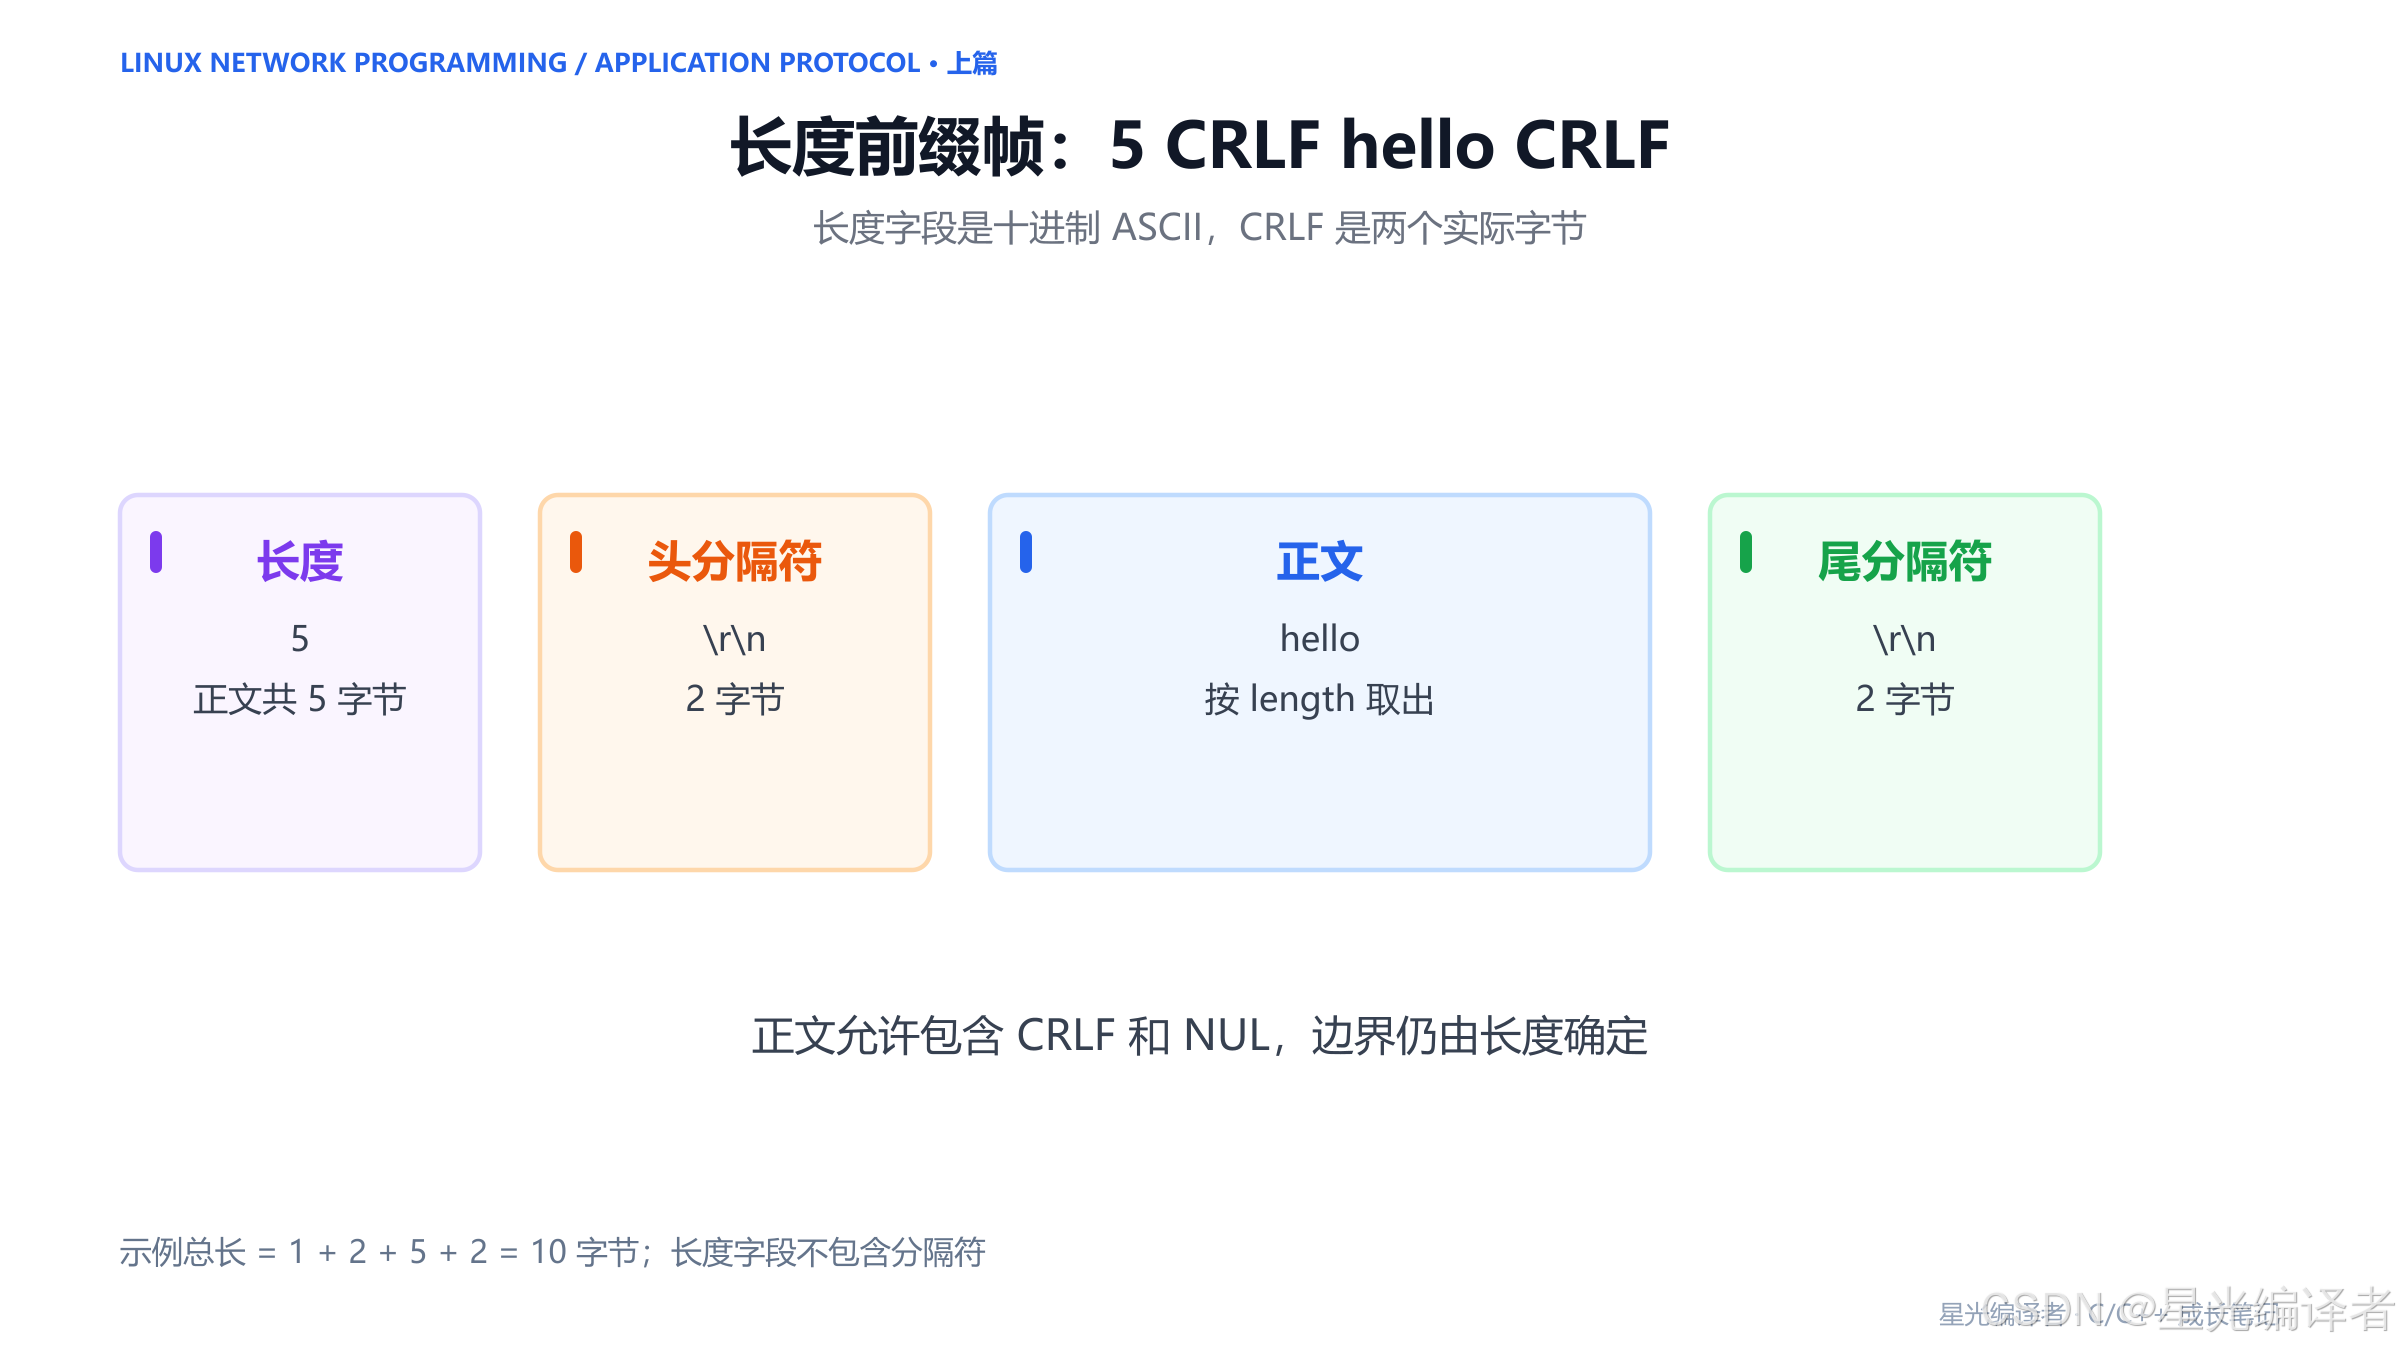
在上面的可视化表示中,\\r\\n 表示回车和换行两个实际字节,不是反斜杠、字母 r、反斜杠、字母 n 四个普通字符。
长度只计算正文。示例总长度为 1 + 2 + 5 + 2 = 10 字节,不能把帧总长度写进长度字段。
5.2 长度按字节算,不能按字符数算
std::string::size() 统计存储的字节数。正文采用 UTF-8 时,一个汉字通常占多个字节,字符个数与正文长度不是同一件事。
正确顺序是先得到最终要传输的正文,再对这个正文求 size(),最后封装帧。不要先估计字符数量,也不要在计算长度后继续修改正文。
5.3 正文中有 CRLF 怎么办
接收端只使用第一个头部分隔符定位长度字段。知道正文长度后,就按长度取正文,再在正文末尾检查尾部分隔符。
因此正文内部可以包含 CRLF,也可以包含 NUL。接收端不应该在正文里搜索“下一个 CRLF”来确定结束位置。
尾部 CRLF 是本文保留的帧格式约定,便于观察并检查格式。它不是 JSON 的必要部分;若选择只用“固定宽度长度头 + 正文”,同样能确定边界,但双方都需要遵守另一个完整约定。
5.4 长度字段也要有明确规则
本文规定:长度是十进制非负整数;只允许 ASCII 数字;零写作 0;其他长度不允许前导零;正文最大 65536 字节,长度字段最多 5 位。
于是 0\\r\\n\\r\\n 是外层合法的空正文帧;-1\\r\\n、01\\r\\n、x\\r\\n、65537\\r\\n 都是不合法帧。
外层允许空正文,不代表计算器业务允许空 JSON。把这两层判断分开,协议实现才不会互相混淆。
六、接收缓存的生命周期
6.1 缓存必须跨越多次 recv
pending.append(chunk, static_cast<std::size_t>(n));
pending 保存已经读到、但尚未消费的字节。每次 recv 得到的片段追加到它的尾部,然后尝试提取完整帧。
如果把 pending 放在每次循环内部重新创建,上一轮的半帧会丢失。如果使用 pending = chunk 覆盖,结果也一样。因此这个缓存必须属于当前连接,并且在该连接的多次读取之间保留。
6.2 一个完整帧之后还可能剩下一部分
假设两条消息分别是 ABC 与 DE:
3\\r\\nABC\\r\\n2\\r\\nDE\\r\\n
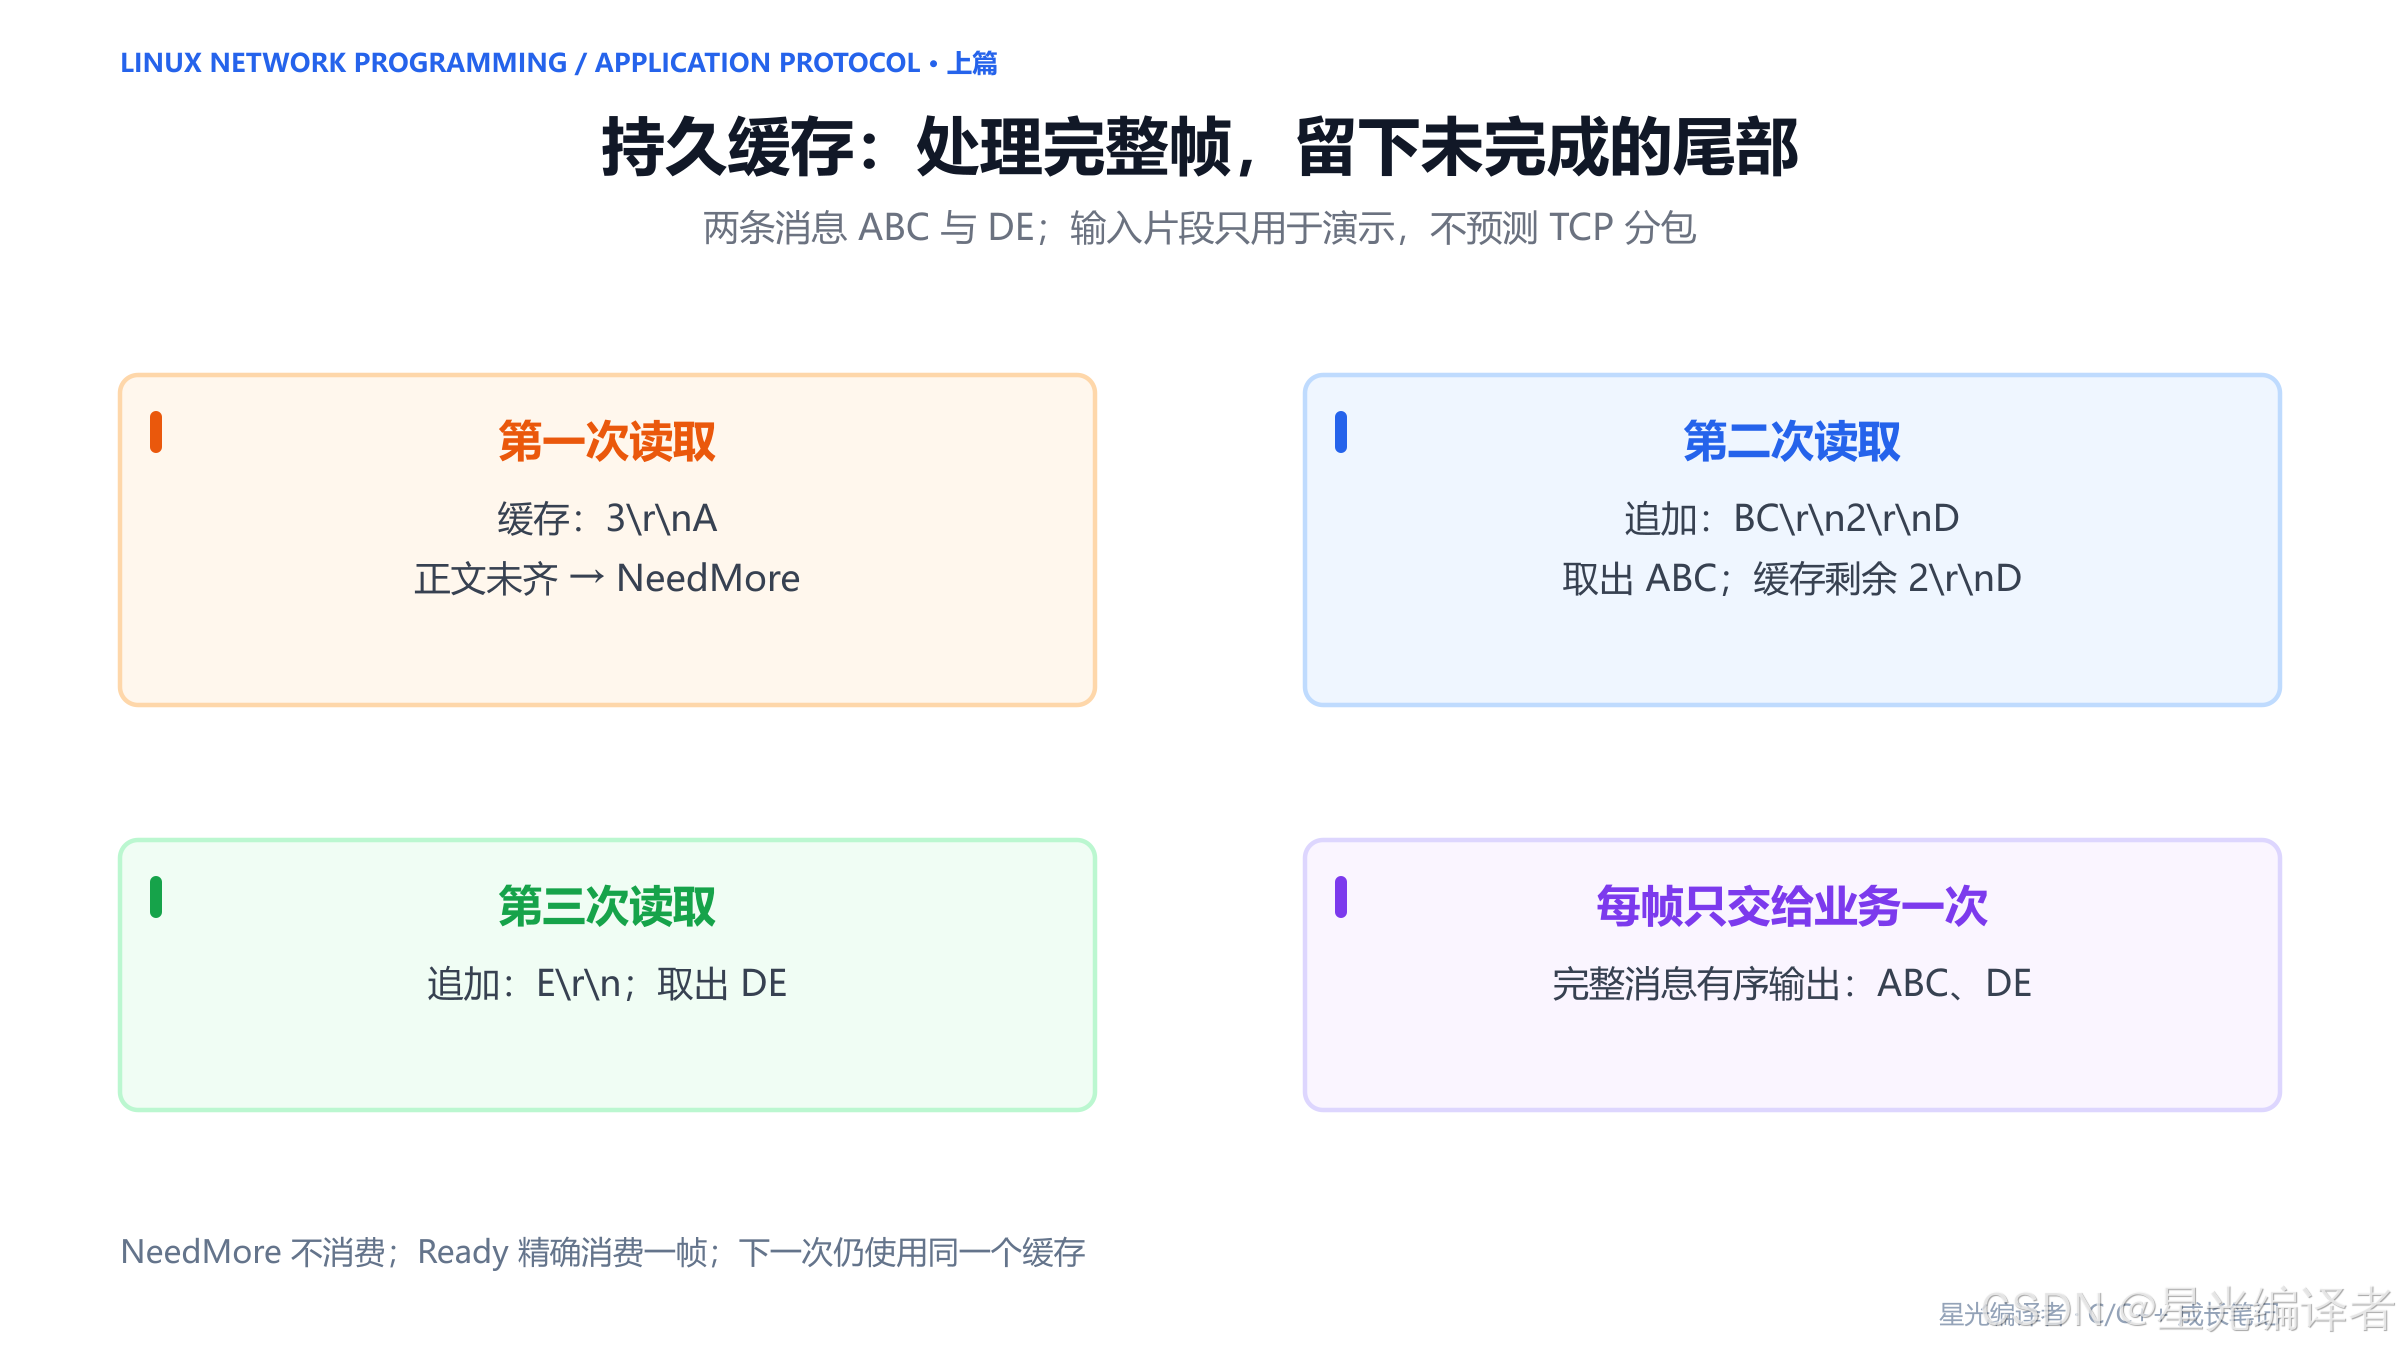
| 3\\r\\nA | 第一条未完成,等待 | 3\\r\\nA |
| BC\\r\\n2\\r\\nD | 输出 ABC;第二条未完成 | 2\\r\\nD |
| E\\r\\n | 输出 DE | 空 |
这里的片段是人为设计的测试输入。拆包器应当对任意分割位置都有效,不依赖真实 TCP 恰好按照表格分组。
6.3 为什么取完一帧后要继续尝试
缓存可能同时包含三条完整请求。如果只解码一次就再次调用阻塞 recv,剩余两条请求明明已经在用户态缓存里,程序却可能等着新数据。
正确顺序是先尽量消费已有缓存;只有缺少完整帧时才继续读取 Socket。这个顺序在后面的 FramedReader 中会直接体现。
七、完整的增量解码器
7.1 不完整与不合法不能共用一个结果
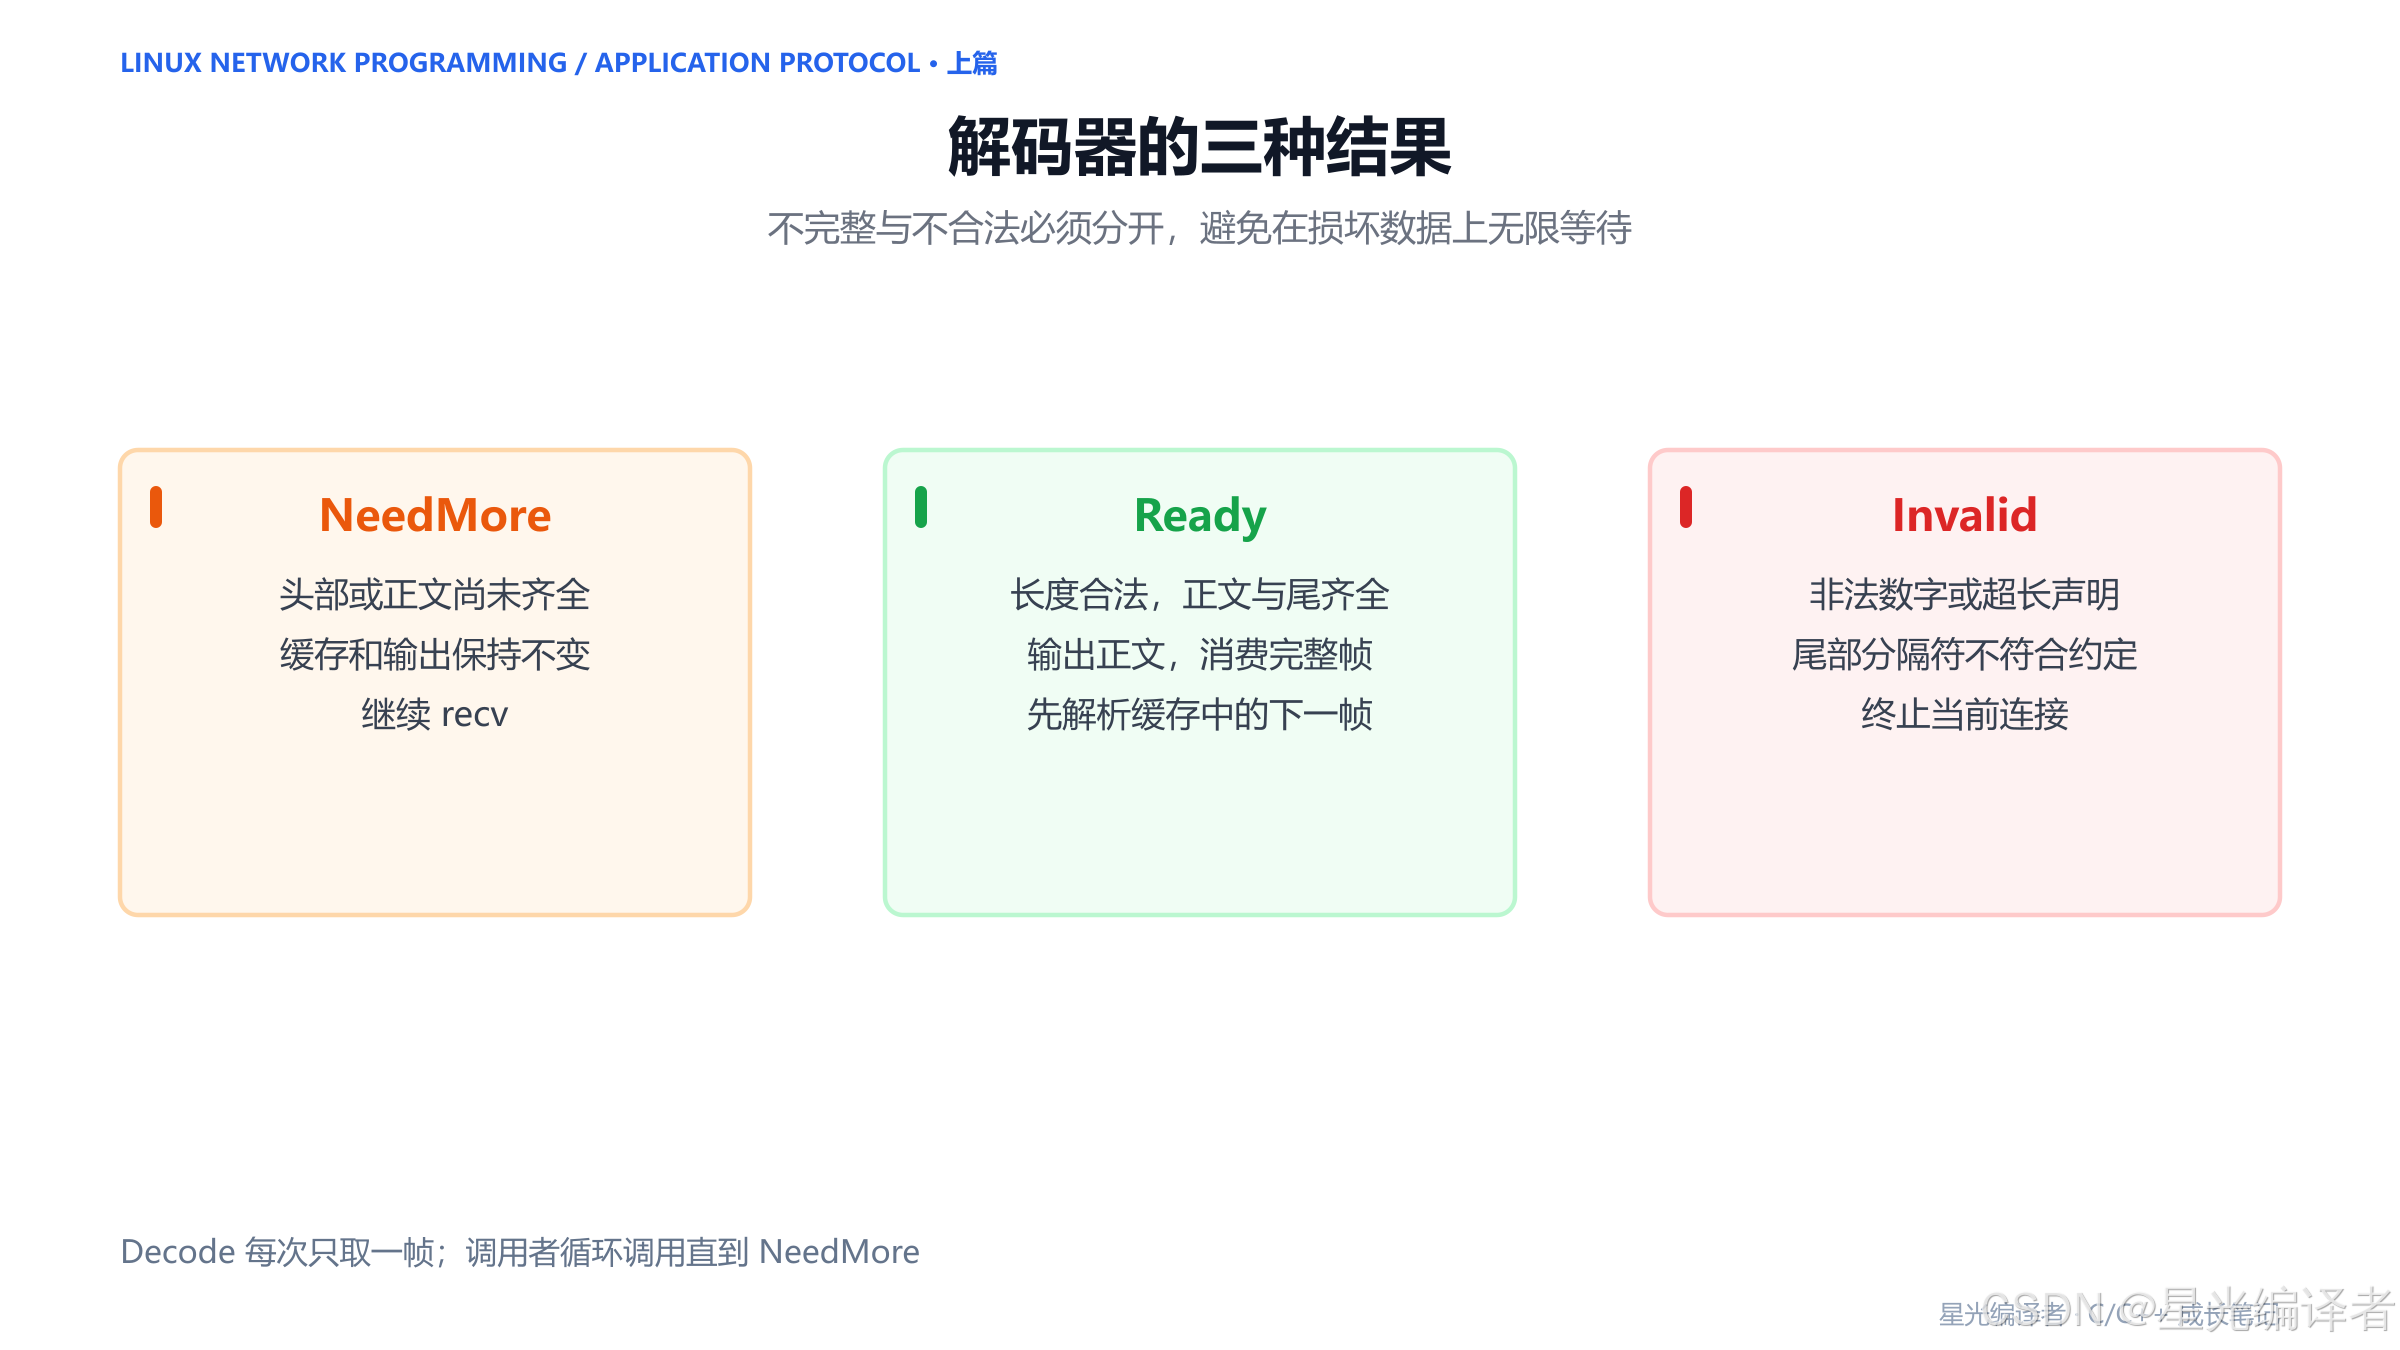
bool Decode(…) 很容易把“数据还没有收齐”和“数据已经损坏”都表达为 false。调用者不知道应该继续等待还是结束连接。
本文使用三种状态:
| NeedMore | 目前还不能形成完整合法帧 | 否 | 继续读取 |
| Ready | 已经取出一条完整帧 | 是,只消费这一帧 | 交给业务,继续拆包 |
| Invalid | 已经能确定违反帧约定 | 否 | 关闭当前连接 |
在 NeedMore 和 Invalid 时,输出正文也保持不变。这样调用者不会误把半条正文当成完整消息使用。
7.2 Frame.hpp 完整实现
下面的文件只依赖 C++17 标准库,可以单独编译测试,不需要 JsonCpp。
#pragma once
#include <cstddef>
#include <stdexcept>
#include <string>
#include <string_view>
namespace wire {
inline constexpr std::size_t MaxBody = 64 * 1024;
inline constexpr std::size_t MaxDigits = 5;
enum class State { NeedMore, Ready, Invalid };
inline std::string Encode(std::string_view body) {
if (body.size() > MaxBody) throw std::length_error("body too large");
std::string frame = std::to_string(body.size()) + "\\r\\n";
frame.append(body.data(), body.size());
frame += "\\r\\n";
return frame;
}
inline State Decode(std::string& buffer, std::string& body) {
const auto pos = buffer.find("\\r\\n");
if (pos == std::string::npos) {
// An unfinished header can contain digits and one final CR only.
std::size_t digits = buffer.size();
if (digits && buffer.back() == '\\r') —digits;
if (digits > MaxDigits) return State::Invalid;
for (std::size_t i = 0; i < digits; ++i)
if (buffer[i] < '0' || buffer[i] > '9') return State::Invalid;
if (!buffer.empty() && buffer[0] == '\\r') return State::Invalid;
if (digits > 1 && buffer[0] == '0') return State::Invalid;
return State::NeedMore;
}
if (pos == 0 || pos > MaxDigits) return State::Invalid;
if (pos > 1 && buffer[0] == '0') return State::Invalid;
std::size_t length = 0;
for (std::size_t i = 0; i < pos; ++i) {
const char c = buffer[i];
if (c < '0' || c > '9') return State::Invalid;
const auto digit = static_cast<std::size_t>(c – '0');
if (length > (MaxBody – digit) / 10) return State::Invalid;
length = length * 10 + digit;
}
const std::size_t body_begin = pos + 2;
const std::size_t total = body_begin + length + 2;
if (buffer.size() < total) return State::NeedMore;
if (buffer.compare(body_begin + length, 2, "\\r\\n") != 0)
return State::Invalid;
body.assign(buffer.data() + body_begin, length);
buffer.erase(0, total);
return State::Ready;
}
} // namespace wire
7.3 没收到完整头部时仍能发现非法输入
如果还找不到 CRLF,不代表缓存中的字节完全不用检查。例如 x 不可能成为合法十进制长度头;123456 已超过五位;单独一个开头的 CR 也不可能成为合法长度。
但合法头部有可能正好在 CR 与 LF 之间被切开。收到 3\\r 时,必须等待下一字节,而不是直接报错。因此代码允许未完成头部的末尾暂时出现一个 CR。
7.4 限制长度为什么放在累积过程里
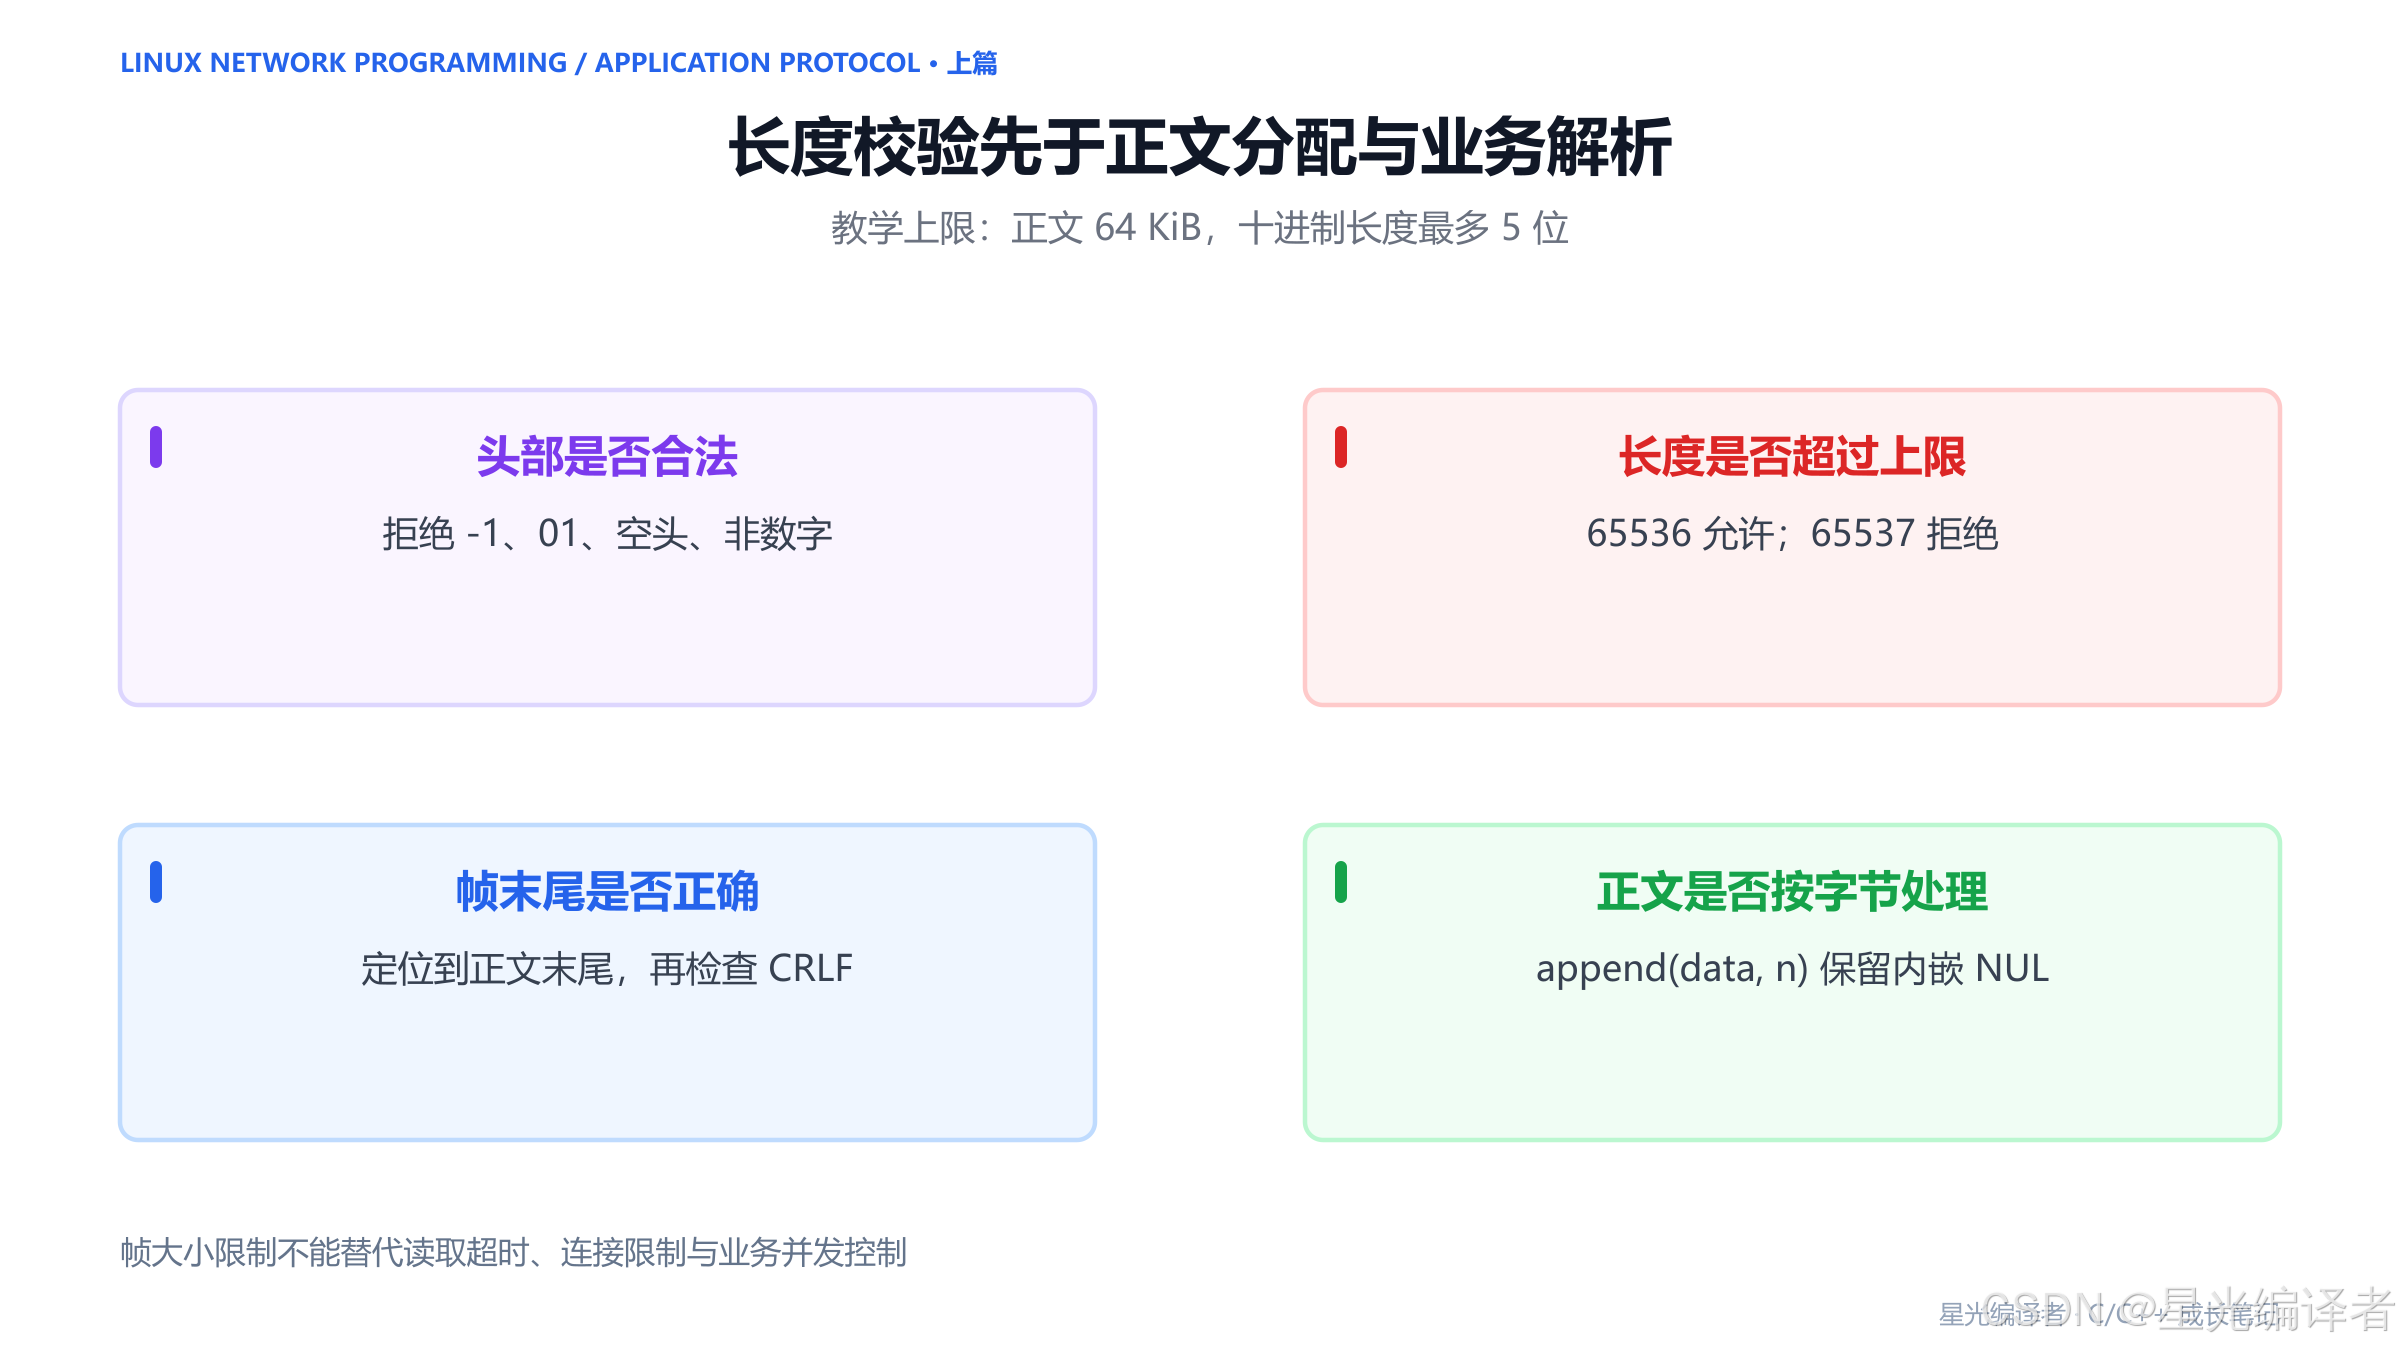
数字累积前使用:
if (length > (MaxBody – digit) / 10)
return State::Invalid;
它检查执行 length * 10 + digit 是否会超过正文上限。本协议只接受最多 65536 的长度,不必先把任意大整数解析出来再判断。
课堂中的 std::stoi 可以帮助理解流程,但外部输入可能导致异常,也可能包含只被部分转换的内容。逐位校验让我们同时控制合法字符、规范写法与上限。
7.5 为什么要检查尾部
缓存字节数足够,不代表帧就合法。如果正文声明长度为 1,输入却是 1\\r\\nx!!,不能把最后两个字节当成约定的 CRLF 然后无条件消费。
正文起点、正文长度和尾部位置应当先计算清楚,再检查指定位置的两个字节。非法帧不尝试扫描下一个 CRLF“重新同步”,因为正文也可能包含同样字节,无法安全判断真正边界。
7.6 erase 写法的适用范围
buffer.erase(0, total) 直观地移除已消费前缀,适合本篇的小消息教学实现。但字符串剩余内容可能需要移动,在高吞吐场景反复执行会增加开销。
可以改用读游标,累计消费位置,必要时集中整理缓存;也可以采用专门的缓冲区。先保证消息边界正确,再根据实际负载选择更合适的存储方式。
八、把拆包器接入阻塞收发
8.1 不要把二进制片段当作 C 字符串
PDF 的示例先给接收片段补 \\0,再执行 *buffer += inbuffer。对于不含内嵌 NUL 的文本,这能说明追加思想;对于通用字节正文,会在第一个 NUL 处提前结束。
本文使用 append(chunk, n)。它准确追加收到的 n 字节,不需要腾出一个字节保存字符串结束符。
8.2 部分发送也需要循环处理
接收端需要拼接,发送端也不能假设一次 send 一定接受全部待发送字节。SendAll 根据返回值推进偏移,继续发送余下内容。
Linux 中的 MSG_NOSIGNAL 可让本次发送在遇到已经关闭的对端时不产生 SIGPIPE,发送错误仍要根据返回值处理。Linux send 手册
8.3 SocketIO.hpp 完整实现
该文件同时提供描述符资源管理、完整发送与逐帧读取。
#pragma once
#include "Frame.hpp"
#include <cerrno>
#include <cstring>
#include <stdexcept>
#include <string>
#include <sys/socket.h>
#include <unistd.h>
class Fd {
int fd_;
public:
explicit Fd(int fd) : fd_(fd) {
if (fd < 0) throw std::runtime_error(std::strerror(errno));
}
~Fd() { if (fd_ >= 0) ::close(fd_); }
Fd(const Fd&) = delete;
Fd& operator=(const Fd&) = delete;
int get() const { return fd_; }
};
inline bool SendAll(int fd, const std::string& data) {
std::size_t sent = 0;
while (sent < data.size()) {
const ssize_t n = ::send(fd, data.data() + sent,
data.size() – sent, MSG_NOSIGNAL);
if (n > 0) sent += static_cast<std::size_t>(n);
else if (n < 0 && errno == EINTR) continue;
else return false;
}
return true;
}
// Blocking sockets only. Pending bytes belong to one connection.
class FramedReader {
std::string pending_;
public:
bool Read(int fd, std::string& body) {
for (;;) {
const auto state = wire::Decode(pending_, body);
if (state == wire::State::Ready) return true;
if (state == wire::State::Invalid)
throw std::runtime_error("invalid frame");
char chunk[4096];
const ssize_t n = ::recv(fd, chunk, sizeof(chunk), 0);
if (n > 0) pending_.append(chunk, static_cast<std::size_t>(n));
else if (n == 0) {
if (!pending_.empty()) throw std::runtime_error("truncated frame");
return false;
} else if (errno != EINTR) {
throw std::runtime_error(std::strerror(errno));
}
}
}
};
8.4 FramedReader 为什么先 Decode 再 recv
Read 的第一步总是尝试解码已有缓存。如果有完整帧,立即返回;如果帧不合法,立即报告错误;只有 NeedMore 才进入 recv。
调用者下一次执行 Read 时,仍使用同一个 FramedReader。这样上一轮多读出来的下一帧会保留在 pending_ 中,不会丢失,也不会被错误分配给另一条连接。
完整消息返回给调用者后,解码器暂时不关心正文是不是 JSON、有没有 datax 字段,更不负责做加法。这是下篇协议层与业务层的职责。
8.5 EOF 时为什么检查残帧
当 recv 返回 0,如果缓存为空,说明已经读取到当前方向的干净结束;如果缓存还包含未完成消息,说明对端在消息完整之前结束发送,这是一条截断帧。
因为 Read 在调用 recv 前已经尝试提取完整帧,缓存里的完整消息会先被交出去。EOF 检查处理的是最后剩余的未完成部分,不会故意丢弃已经收到的完整消息。
8.6 关闭描述符时为什么不盲目重试
Fd 的析构负责关闭持有的描述符,并禁止复制,避免两个对象同时把同一个 fd 当作自己拥有的资源。
本例在 Linux 中对 close 调用一次,不照搬 recv 的 EINTR 重试逻辑。描述符的释放语义与读写不同,盲目重试可能涉及已被其他操作复用的描述符。
如果后续希望把 Socket 所有权转交给工作线程,可以为包装类加入明确的移动构造与移动赋值。本篇不进行所有权转移,所以保留一个简单的不可复制包装即可。
九、测试消息边界与异常输入
9.1 测试的关键是改变分割位置
仅让客户端成功发送一次 hello,无法证明解码器处理了半包。边界测试应该人为构造完整帧,再把它在每一个可能的位置切成两段。
const std::string frame = wire::Encode("hello");
for (std::size_t cut = 0; cut < frame.size(); ++cut) {
std::string pending = frame.substr(0, cut);
std::string body;
assert(wire::Decode(pending, body) == wire::State::NeedMore);
pending += frame.substr(cut);
assert(wire::Decode(pending, body) == wire::State::Ready);
assert(body == "hello" && pending.empty());
}
这里没有把末尾位置包含进循环,因为 cut == frame.size() 时第一段本身已经是一条完整帧,应当返回 Ready。
9.2 本篇附带的测试覆盖哪些情况
| 两段切分 | 完整帧在每个位置分开 | 前半段等待,补齐后恢复正文 |
| 逐字节输入 | 每次仅追加一个字节 | 任意分片都能恢复 |
| 连续多帧 | 两条完整帧加下一帧残片 | 依次输出,保留尾部 |
| 二进制正文 | 正文含 NUL 和 CRLF | 内容按实际字节保留 |
| 非法头 | 负数、空头、前导零、非数字 | 返回 Invalid |
| 非法尾 | 指定尾部不是 CRLF | 返回 Invalid |
| 上限 | 空正文、65536 字节、超限声明 | 合法边界接受,超限拒绝 |
完整测试在 code/frame_test.cpp 中。它还包含下篇使用的计算边界检查,编译时不需要 JsonCpp。
g++ -std=c++17 -Wall -Wextra -Wpedantic -Werror \\
-fsanitize=address,undefined frame_test.cpp -o frame_test
./frame_test
实际验证环境为 WSL Ubuntu 24.04;该测试已经编译并运行通过。详细执行记录随文章放在 code/验证记录.md,测试结论仅覆盖记录中的项目,不把它等同于生产服务器验证。
十、课堂代码中的实现细节
10.1 可变长度数组不是标准 C++17
PDF 出现 char inbuffer[size]。当 size 是运行时参数时,这是某些编译器允许的扩展,不是标准 C++17 数组声明。
本文使用固定大小局部数组。若容量需要动态配置,可以使用 std::vector<char>,然后把 data() 与 size() 传给系统调用。
10.2 Socket 封装与模板方法
PDF 的 BuildListenSocketMethod 把创建、绑定、监听组织成固定流程,再由派生类实现具体步骤,可以用来理解模板方法的组织方式。
不过“使用了设计模式”不会自动解决 fd 所有权、重复关闭、错误传播和部分收发。博客代码使用小型资源包装与独立收发函数,把本章最关键的边界处理展示得更直接。
10.3 缓冲区上限还不是完整服务治理
本文先解码、缺数据再读取,并且每次最多追加 4096 字节。长度校验能让合法未完成帧保持在有限范围,也能较早拒绝超长或损坏头部。
但客户端仍然可以声明合法长度后迟迟不发完。阻塞服务会持续等待,所以真正面向多个客户端的程序还需要读取超时、并发模型与连接数量控制。长度限制解决的是一类内存和格式问题,不能替代其他运行机制。
10.4 序列化与拆包为什么要分开
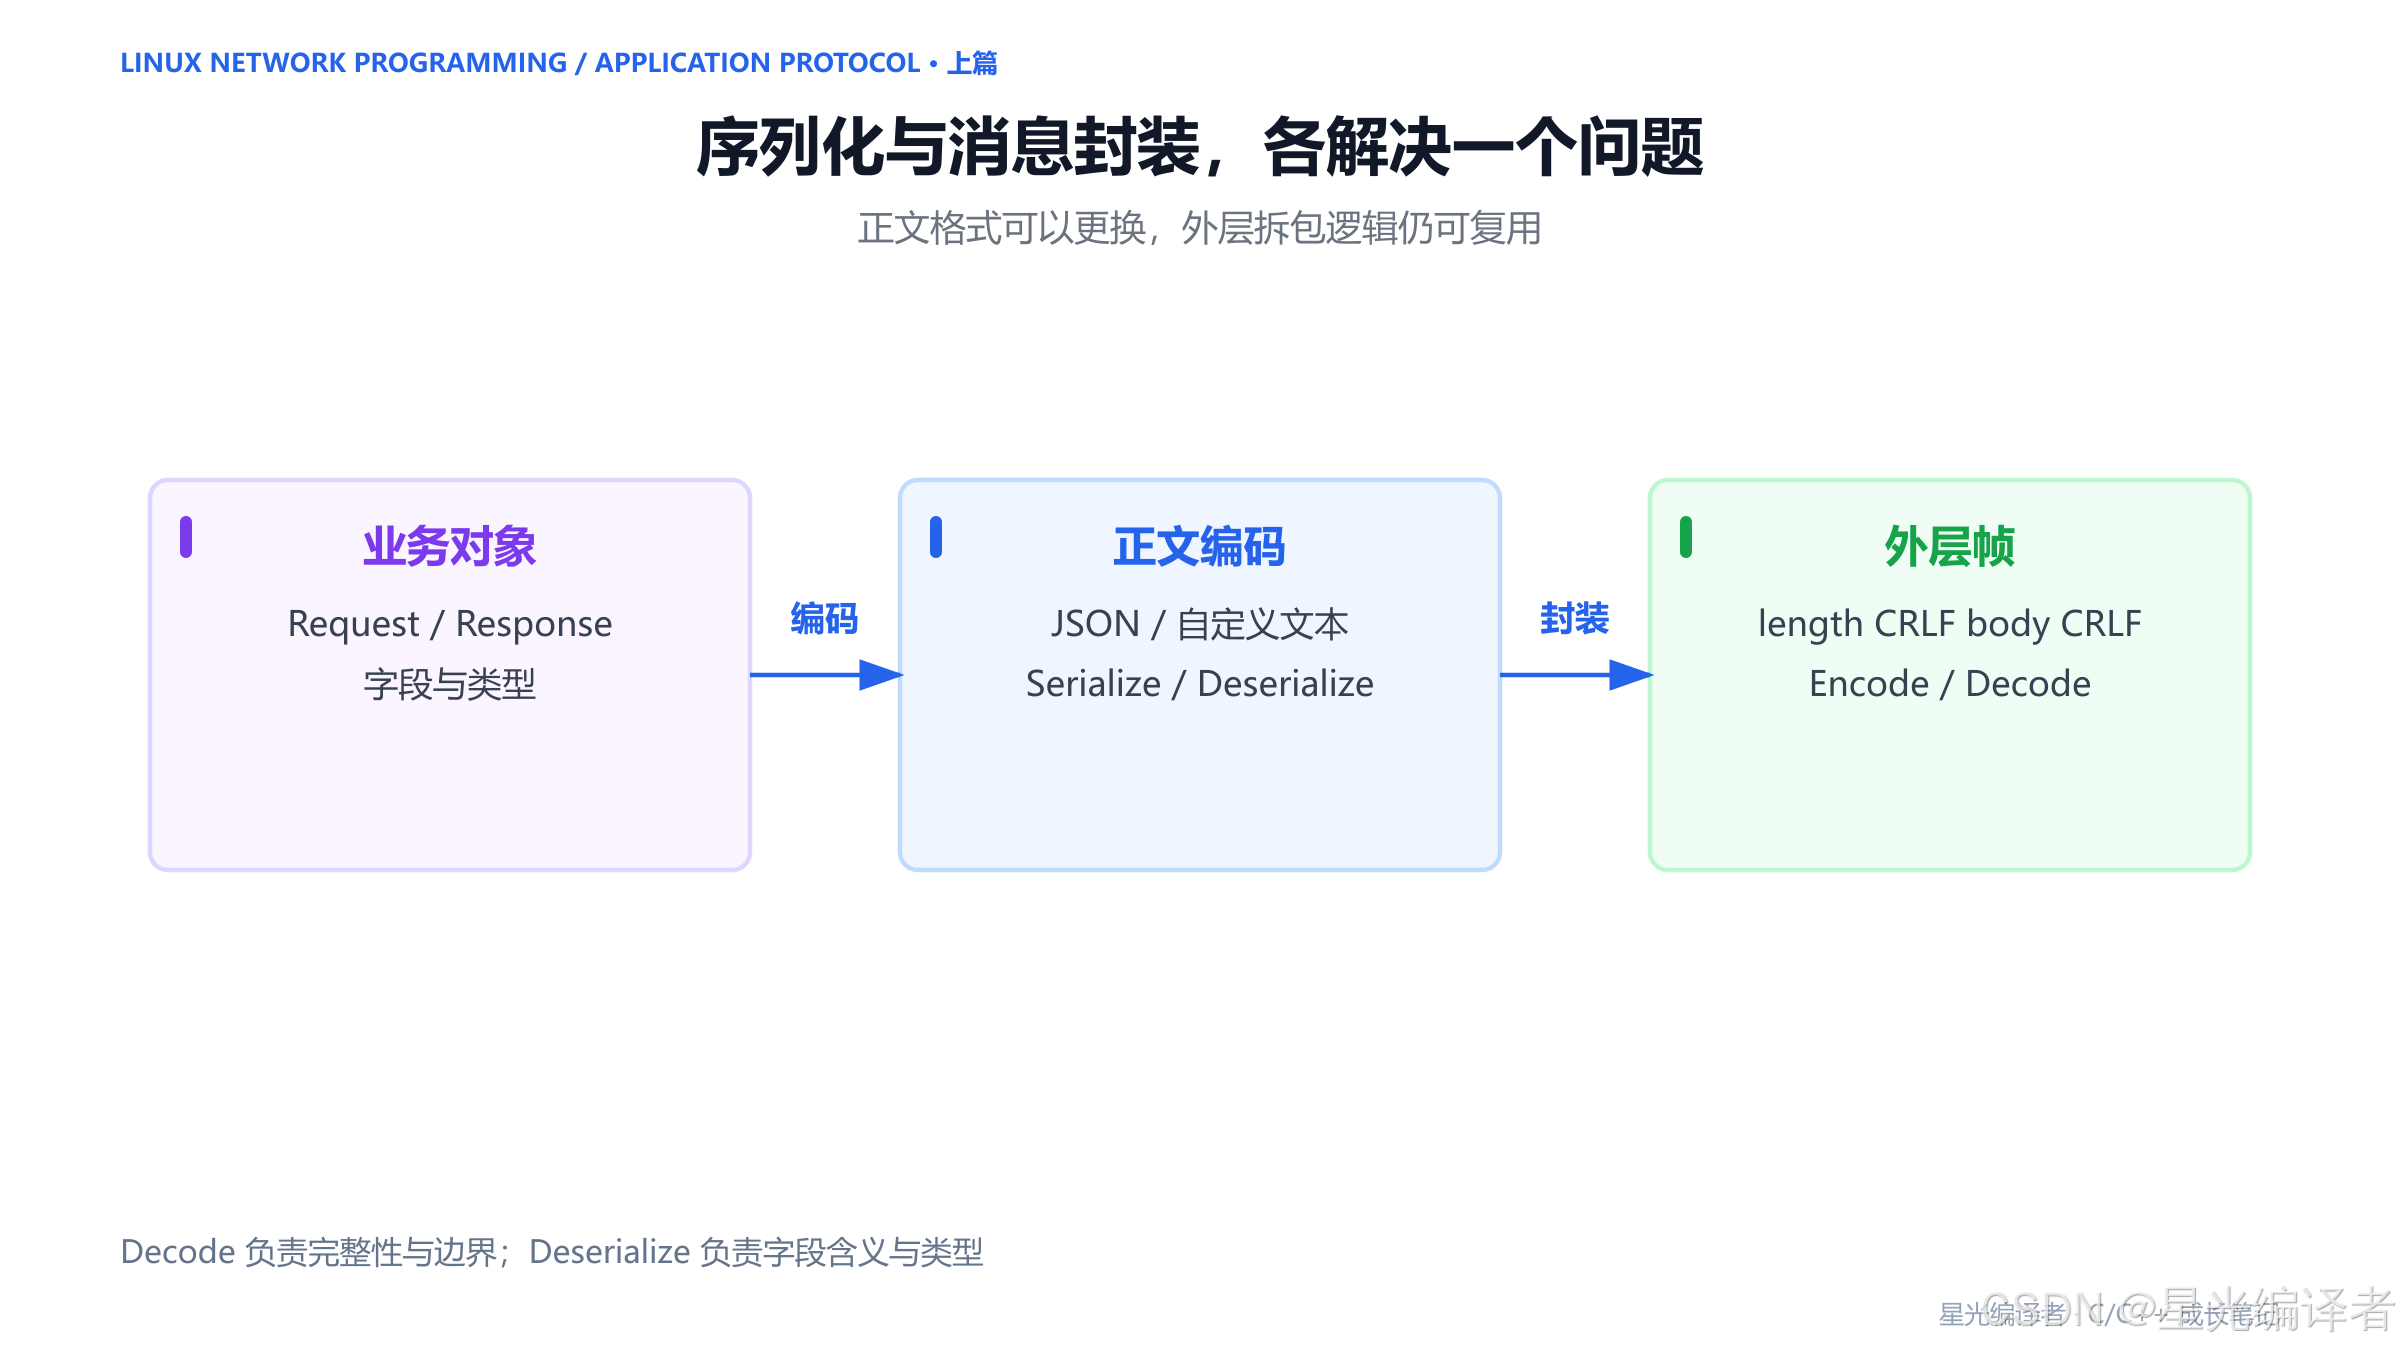
如果以后把正文从自定义文本改成 JSON,Frame.hpp 不必知道任何字段变化。如果计算器改成词典业务,长度帧同样可以继续使用。
相反,如果把消息长度、JSON 字段访问与加法全部写在一个 recv 分支中,一处修改就会同时影响三类逻辑。分层的价值在于让各自的约定清楚、让错误更容易定位。
总结
应用层协议把字节赋予业务意义。对 TCP 来说,接收程序还必须自行识别消息边界:系统调用返回的一段字节,未必就是一条完整请求。
本篇使用长度前缀帧,把问题拆成三步:按实际长度追加片段,增量判断完整性,取出一帧并保留余下字节。NeedMore / Ready / Invalid 分别告诉调用者继续等、处理消息或终止连接。
掌握这个处理顺序后,再接入 JSON 就比较自然了:先用 Decode 获得完整正文,再用 Deserialize 恢复字段,最后执行业务。
🌄 愿每一次阅读、编译与调试,都能让我们离清晰可靠的代码更近一步。如果这篇记录对你有帮助,欢迎点赞、收藏,也欢迎交流你的实现与问题。