/* MD / 富文本中的 .toc(含博客园搬家等嵌套结构);.toc-box 在侧栏,不受影响 */
#content_views .toc,
/* 编辑器常在目录前后插入空 p(:empty 仍占 20px),一并去掉避免顶空隙 */
#content_views.markdown_views > p:empty:has(+ .toc),
#content_views.markdown_views > .toc + p:empty,
/* 富文本旧版目录标记 */
#content_views.htmledit_views #main-toc,
#content_views.htmledit_views #hr-toc,
#content_views.htmledit_views p[id*=\”-toc\”] {
display: none !important;
}
/* 目录去掉后,紧跟的首个标题不再多出一块上边距 */
#content_views.markdown_views > .toc + h1,
#content_views.markdown_views > .toc + h2,
#content_views.markdown_views > .toc + h3,
#content_views.markdown_views > .toc + h4,
#content_views.markdown_views > .toc + p:empty + h1,
#content_views.markdown_views > .toc + p:empty + h2,
#content_views.markdown_views > .toc + p:empty + h3,
#content_views.markdown_views > .toc + p:empty + h4 {
margin-top: 0 !important;
}
Linux perf 硬件性能计数器实战:从 IPC 与 Cache Misses 看 CPU 停顿
在系统性能工程与高并发后端系统的底层优化中,许多工程师排查 CPU 瓶颈时,视野往往仅仅停留在操作系统汇报的宏观利用率上:
- 看到 top 或监控大盘显示某进程 CPU 利用率打满 100%,就下意识认为“CPU 正在全负荷全速运转计算指令”;
- 看到两个不同算法在循环次数上相近,就主观断定两者的执行效率没有本质差异。
然而,在现代超标量处理器(Superscalar Processor)的微架构底层,“CPU 利用率 100%”背后可能隐藏着巨大的“虚假繁荣”。
在物理芯片层面,现代 CPU 执行一条加法或位运算指令仅需 1 个时钟周期(约 0.3 纳秒)。但如果该指令所需的数据未能命中片上 L1/L2/L3 高速缓存,被迫穿透到慢速的 DDR4/DDR5 主内存去寻址,CPU 的流水线将被迫挂起停顿(Pipeline Stall)整整 200 到 300 个时钟周期(长达 60~100 纳秒的绝对真空期)!在这段漫长的等待中,计算单元完全处于空转饥饿状态,但操作系统内核依然将其计入“CPU 繁忙时间”。
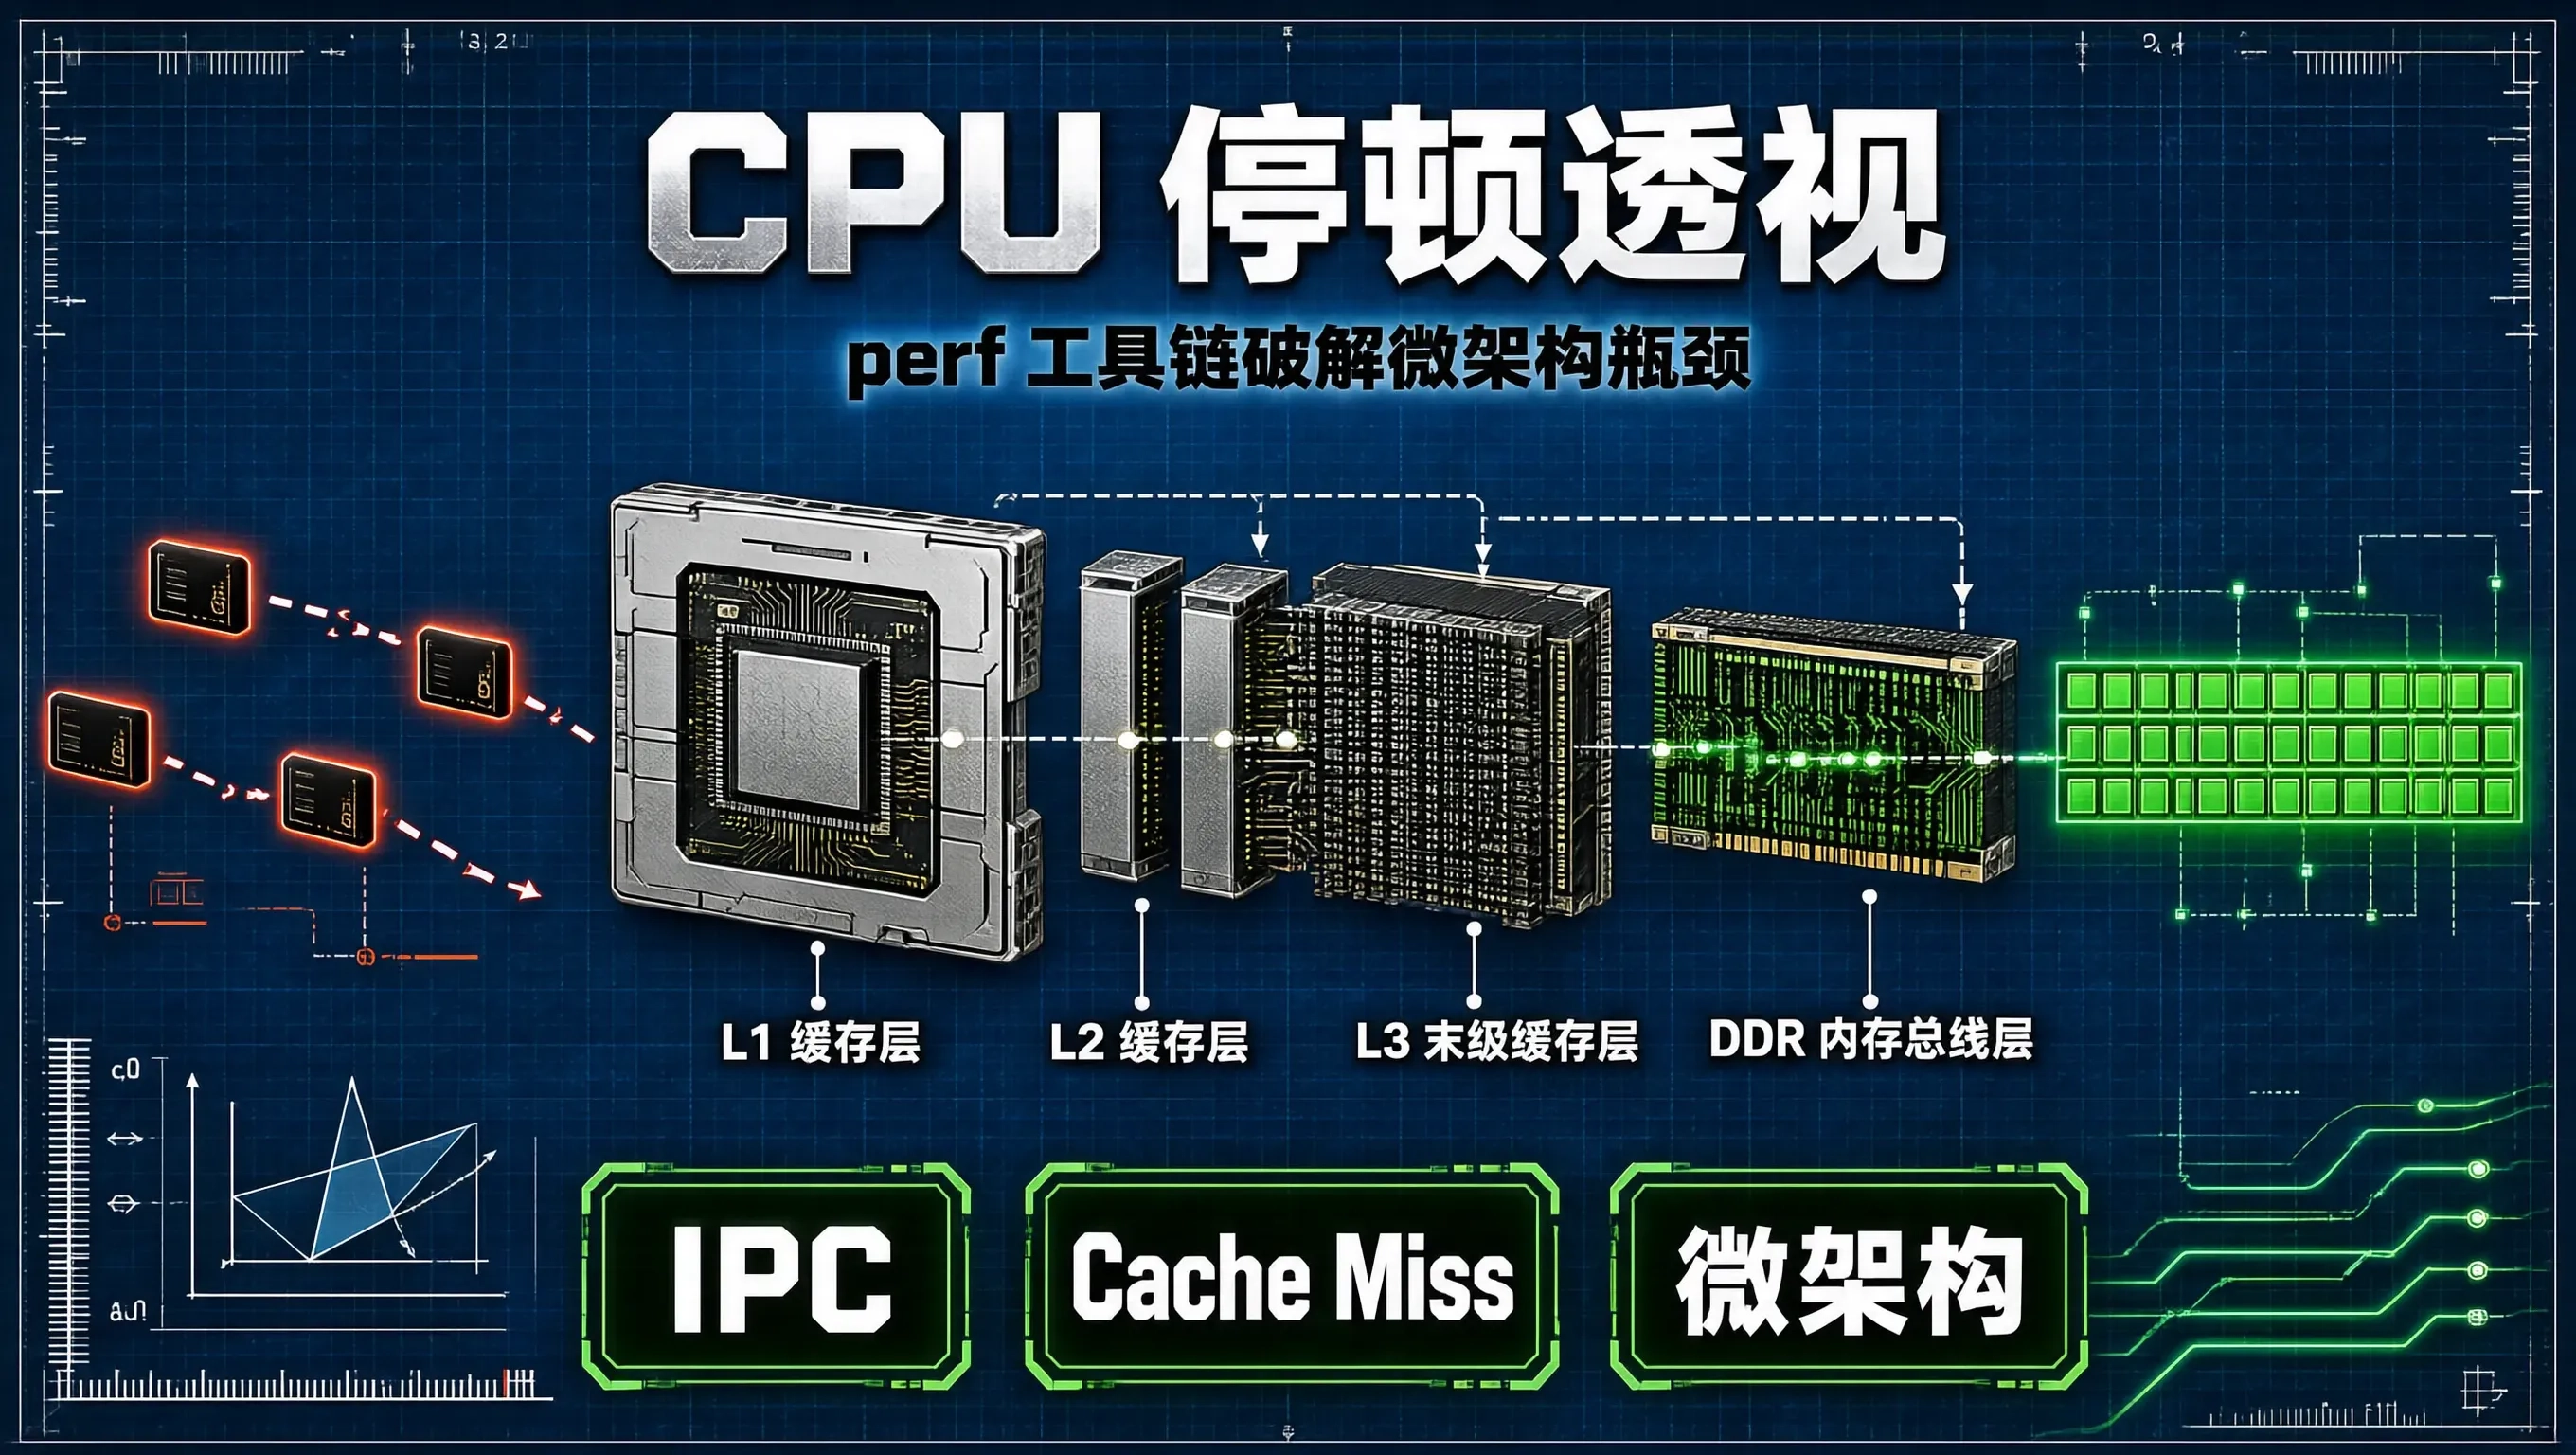
如何透视这些隐藏在操作系统监控之外的硬件停顿?如何利用 CPU 硬件性能监控单元(PMU, Performance Monitoring Unit)与 Linux perf 工具链,通过 IPC(Instructions Per Cycle) 与 Cache Misses 精准定位性能根因?深入微架构分析是高阶性能调优的必备技能。
CPU 微架构核心黄金度量:IPC 与 Top-Down 分析法
衡量 CPU 计算流水线真实健康度与执行效率的黄金标准是 IPC(Instructions Per Cycle,每时钟周期指令数):
$$\\text{IPC} = \\frac{\\text{Instructions Retired (已完成的指令总数)}}{\\text{CPU Cycles (消耗的时钟周期总数)}}$$
【IPC 效率健康度分级】
– IPC > 2.0 ~ 3.5 : 极度健康 (计算密集型, 数据全部命中 L1/L2 缓存, 流水线多发射全速推进!)
– IPC ≈ 1.0 : 中规中矩 (存在部分访存或分支预测损耗)
– IPC < 0.6 ~ 0.2 : 严重停顿 (内存受限型 Memory-Bound, 80% 的时钟周期在空转等待内存数据!)
根据 Intel 提出的 Top-Down 微架构分析方法论(TMAM),CPU 消耗的所有时钟周期严格划分为四大象限:
【CPU 时钟周期分类 (Top-Down TMAM)】
│
┌──────────────────────────┴──────────────────────────┐
▼ ▼
【Retiring (有效执行指令)】 【Stalls (硬件停顿流水线)】
– 真正转化为有效生产力的时钟周期 │
┌──────────────────────────────┴──────────────────────────────┐
▼ ▼
【Frontend Bound (前端受限)】 【Backend Bound (后端受限)】
– 指令译码、I-Cache Miss、分支预测失败 – 核心停顿 (Core Bound)
– 访存停顿 (Memory Bound: L1/L2/L3 Miss)
实战一:使用 perf stat 进行宏观硬件计数微架构体检
对线上正在承载高并发流量的核心业务进程(PID=8848)进行为期 10 秒的底层 PMU 硬件计数采样:
sudo perf stat -p 8848 -e \\
cycles,\\
instructions,\\
cache-references,\\
cache-misses,\\
L1-dcache-loads,\\
L1-dcache-load-misses,\\
LLC-loads,\\
LLC-load-misses,\\
branch-instructions,\\
branch-misses \\
— sleep 10
控制台输出的微架构体检报告:
Performance counter stats for process id '8848':
32,450,120,400 cycles # 3.245 GHz
11,357,542,140 instructions # 0.35 insn per cycle (IPC 严重过低!)
1,245,670,120 cache-references
452,180,900 cache-misses # 36.30% of all L1D misses (缓存失效极高!)
185,420,000 LLC-load-misses # 15.20 MB/s 主存颠簸
2,450,110,000 branch-instructions
28,120,000 branch-misses # 1.15% of all branches (分支预测良好)
10.002150320 seconds time elapsed
报告微架构诊断结论:
实战二:使用 perf record -e mem_load_retired 精准定位行级汇编代码
既然锁定了是 L3 Cache Miss 导致的内存停顿,如何在数万行代码中精准找出引发缓存缺失的罪魁祸首?
# 1. 采集针对末级缓存缺失 (LLC Miss) 的硬件中断与调用栈
sudo perf record -e mem_load_retired.l3_miss -p 8848 -g — sleep 10
# 2. 打开交互式性能剖析终端
sudo perf report
在 perf report 界面选中热点函数并按下 a 键(Annotate),展开源码与底层汇编映射:
Percent | Source Code / Disassembly
————————————————
| // 业务热路径: 遍历包含 50 万个节点的链表 (Pointer Chasing)
| while (curr != NULL) {
81.5% | MOV RAX, [RCX + 16] <– 硬件计数器标红:81.5% 的 L3 Miss 集中在此指令!
0.5% | ADD RDX, [RAX]
| curr = curr->next;
| }
真相瞬间大白:系统在热路径中遍历了一个由离散指针链接的链表。每个节点在物理内存中随机分布,破坏了空间局部性,导致 CPU 硬件流预取器(Stream Prefetcher)完全瘫痪,每一次指针解引用(MOV RAX, [RCX + 16])都触发一次向主存的漫长访存。
提升 IPC 与消灭 Cache Miss 的三大工业级优化
【优化前: 离散指针链表 (Pointer Chasing – 访存颠簸)】
[ Node A (地址 0x1000) ] ──> [ Node B (地址 0x9000) ] ──> [ Node C (地址 0x4000) ]
(微架构表现: 每次指针跳转引发一次 L3 Miss, CPU 停顿 250 周期, IPC = 0.35)
【优化后: 连续平坦紧凑数组 (Flat Array – 硬件预取)】
[ Slot 0 ][ Slot 1 ][ Slot 2 ][ Slot 3 ][ Slot 4 ][ Slot 5 ]…
(微架构表现: 硬件预取器自动加载后续 128 字节进 L1 缓存, 零停顿, IPC 飙升至 2.85!)
1. 面向数据设计(Data-Oriented Design, DOD)与连续平坦化
彻底废弃基于指针嵌套的树状或链表结构,改用基于内存连续切片(Slice / Vector)的平坦数组。连续内存让 CPU 硬件空间预取器能够在后台自动将后续数据块无缝拉入 L1 缓存。
2. AoS 到 SoA(Structure of Arrays)微架构变换
在执行批处理计算时,将包含多个非计算字段的结构体数组 []Struct{A, B, C, D} 转换为多个独立字段数组 Struct{ []A, []B }。确保每次载入 Cache Line 的 64 字节数据 100% 参与当前运算,彻底消灭内存带宽浪费。
3. 显式软件预取(Software Prefetching)
对于不可避免的稀疏索引访问,在当前循环中提前计算下一次迭代的内存地址,并发射硬件预取指令:
// C++ / C 显式预取下一跳内存至 L1 Cache
__builtin_prefetch((const void*)next_node_ptr, 0, 3);
微架构优化前后实测基准对账矩阵
在 64 核心 AMD EPYC 7763 服务器上,针对 50 万条金融订单撮合逻辑重构前后的硬件性能对账:
| 方案 1: 原始指针链表 (Pointer Chasing) | 48.5 ms | 0.35 (严重停顿) | 36.3% | 18.5% (主存颠簸) | 1.2 GB/s |
| 方案 2: 紧凑平坦数组 (Flat Array) | 9.2 ms | 1.85 (大幅提升) | 4.2% | 0.8% | 8.5 GB/s |
| 方案 3: SoA 内存布局 + 显式预取 | 5.8 ms (提速 8.3 倍!) | 2.88 (算力拉满) | 0.8% (极度干净) | < 0.05% (零穿透) | 18.2 GB/s (压满总线) |