📋 目录
- 💰 先看一组让人放松警惕的数字
- 🔍 第一层纠错:同一个模型有四套"官方价格",且互不相同
- 📊 第二层纠错:token 计费公式决定了"单价更低≠更便宜"
- 🎯 第三层:真正的成本是抽卡倍率,而它没有公开数字
- 🧩 三层成本叠在一起,实际该怎么算
- ⚖️ 一个必须说清的分歧:模型选择由重试率决定,不由单价决定
- 🎬 一个容易被忽略的成本项:角色一致性是靠资产库摊薄的
- 🏗️ 领码 SPARK 融合平台视角
- 📌 三条可以直接用的判断标准
- 💬 你做 AI 视频,真实的重试倍率是多少?
💰 先看一组让人放松警惕的数字
按 BytePlus ModelArk 官方公开的价目表,Seedance 2.5 的价格是这样的:
| 480p | $0.514 | $0.103 |
| 720p | $1.156 | $0.231 |
| 1080p | $2.843 | $0.569 |
30 秒 720p 片段,$6.93 左右。
看到这里,"AI 短剧成本已经很低了"这个判断就开始成立了。但这个判断只对了一半,而且是危险的那一半。
因为计费方式决定了一件事:上面这个数字算的是"一次成功生成",不是"一条能用的片段"。
而第二篇实测文章里那句"AI 视频最大的浪费就是’某一帧错了整段重做’",恰恰说明真实场景里,一次成功生成和一条能用的片段之间隔着一个不可忽略的倍率。
🔍 第一层纠错:同一个模型有四套"官方价格",且互不相同
这是本文第一个必须点破的问题。不同渠道报出的 Seedance 2.5 单价差异接近 5 倍:
| Convly(2026-09-23 更新) | 约 $0.097/秒(720p 年付高级套餐) | 消费者订阅折算 |
| BytePlus ModelArk 官方示例(2026-10-08 更新) | $0.103/秒(480p)、$0.231/秒(720p) | API 官方价目表 |
| Concat Pro 综合 | 480p 约 $0.10、720p 约 $0.23 | API 折算 |
| seedance2-5.video(独立网站) | 720p 约 $0.50~$1.10/秒 | 第三方转售,非字节官方 |
这四套数字都能找到出处,差异来自三个层面:
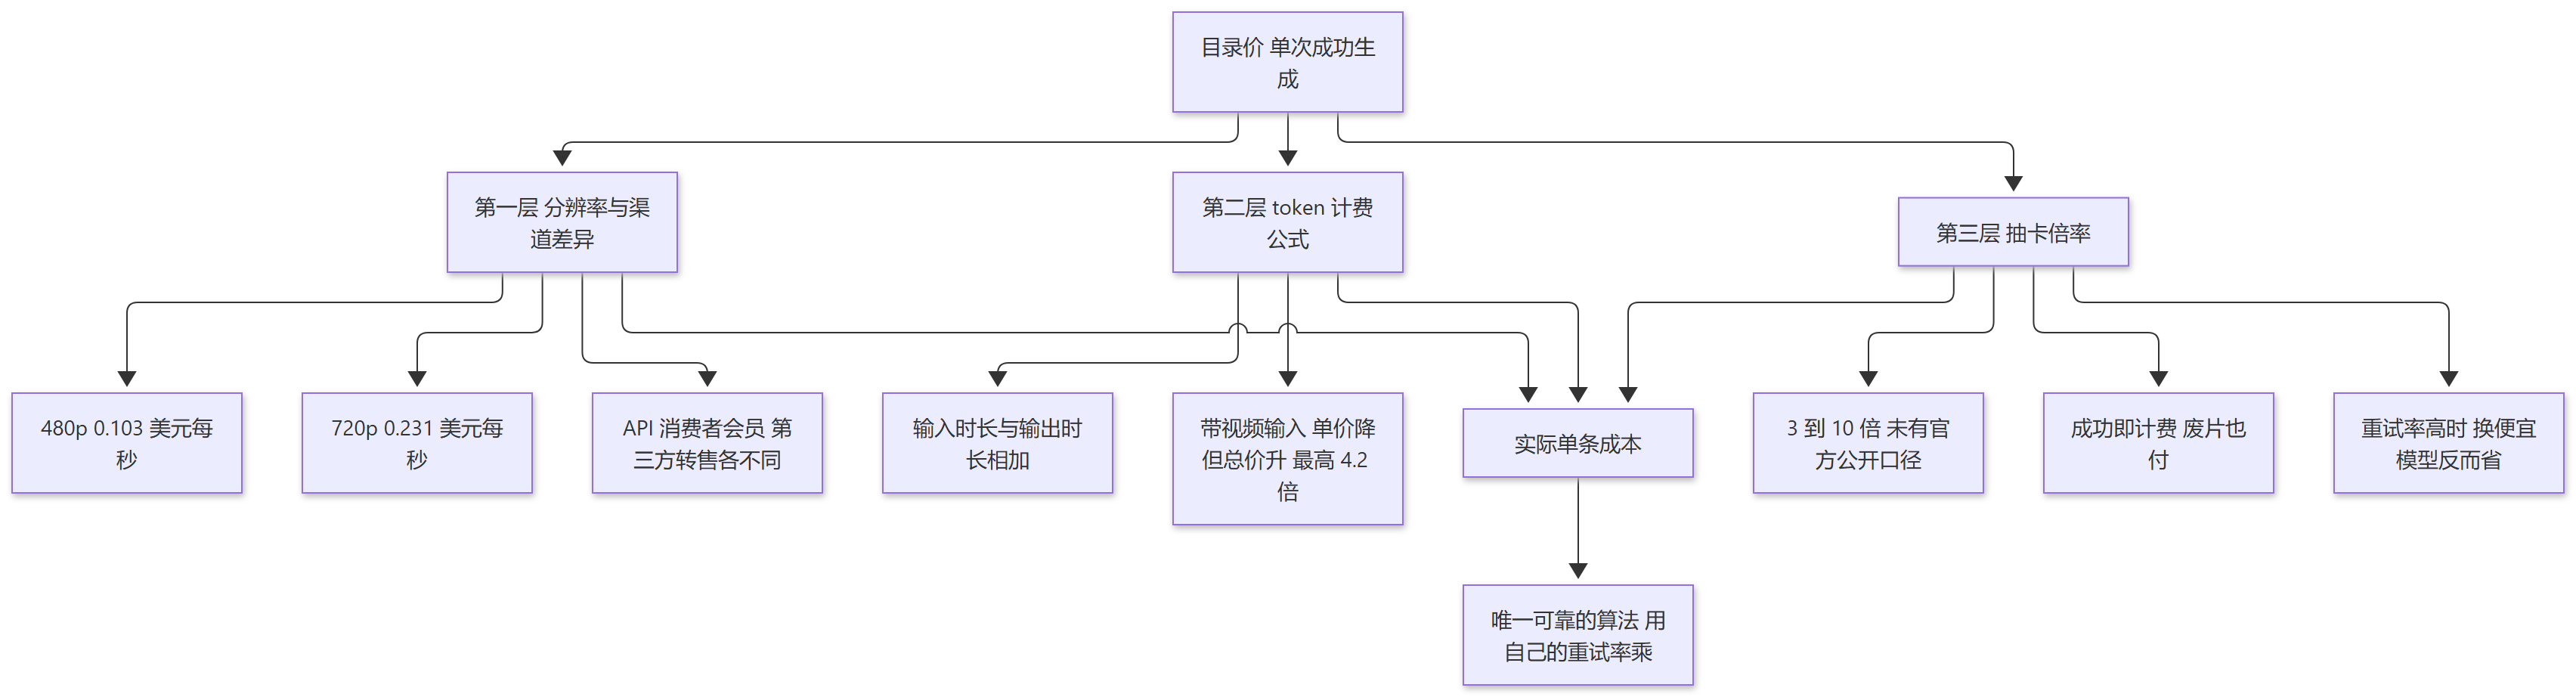
第一层:API 和消费者订阅不是同一个东西。 Convly 那个 $0.097/秒是 Dreamina(海外版即梦)年付高级套餐的折算单价;BytePlus 那个 $0.231/秒是 API 的token 计费结果。前者是你买会员按月摊出来的成本,后者是按次结算的目录价。 把两者放一起比大小,没有意义。
第二层:分辨率不同。 $0.103 是 480p,$0.231 是 720p,$0.569 是 1080p。这三个数不是"不同报价",是三个不同的产品档位。 很多流传的"Seedance 只要 0.1 美元一秒"拿的是 480p 价,而短剧实际交付通常要用 720p 甚至更高——差 2.2 倍。
第三层:有些价格是促销价,已经过期。 这是最容易踩的坑。TechPilot 的记录里写得很清楚:Dreamina 的 90% off 首月 Basic 促销跑的是 2026 年 9 月 23 日至 10 月 9 日,已结束;$1.50 的首月方案同样已结束。该站明确提醒:“不要用那个首月促销价做预算。”
还有一条:seedance2-5.video 那个站点自己声明"不是字节官方站点,与 ByteDance 无关联,价格是它自己的"。 它的 720p 报价 $0.50~$1.10/秒虽然是第三方里相对透明的,但引用时必须带上"非官方"这个标签。否则就是拿转售商的加价当官方定价。
📊 第二层纠错:token 计费公式决定了"单价更低≠更便宜"
这是本文最技术、也最有价值的一段。BytePlus 并不按条收费,而是估算 token 消耗:
预估 token 数 = (输入视频时长 + 输出视频时长) × 宽 × 高 × 帧率 ÷ 1024
预估价格 = token 单价 × token 数量
看懂这个公式,就看懂了 Seedance 2.5 定价里最反直觉的一件事:带视频输入的单价更低,但总价可能更贵。
| 720p,无视频输入 | $10.70 / 100 万 token | $1.156 |
| 720p,带视频输入 | $6.40 / 100 万 token | $1.24 ~ $4.84 |
单价从 10.70 降到 6.40,看起来降了 40%。但因为公式里"输入视频时长"和"输出视频时长"是相加的,一段 2~30 秒的参考片段本身就要计入 token 总量。
结果:720p 带视频输入的成本上限($4.84)比不带输入的示例($1.16)高出 4.2 倍。
这就是"单价更低不代表请求更便宜"的机制所在。对照另一条第三方数据:单引号费率低 40%,总成本最高能高出 320%。
这条对实操的指导意义非常直接:如果你的工作流里有参考视频,就不要用"单价"做预算,必须用完整请求算。 而Seedance 2.5 的多模态参考能力(最多 30 图/ 10 视频 / 10 音频)恰恰是这个工具的核心卖点——你越是用它的强项,越不能用它的单价来算账。
🎯 第三层:真正的成本是抽卡倍率,而它没有公开数字
到这一步都是可算的。但接下来这一层,是整个 AI 视频成本核算里最大的黑洞。
Convly 的定价页面写得很直接:
“A usable shot commonly takes three to ten attempts, so multiply by your real retry rate before budgeting.”
(一条能用的镜头通常需要三到十次尝试,所以在做预算前请乘以你自己的真实重试率。)
三到十次。这个倍率意味着什么:
| 30 秒 720p片段 | $6.93 | $20.79 | $69.30 |
| 5 秒 720p 片段 | $1.16 | $3.47 | $11.56 |
"AI 短剧一条 30 秒成本 7 美元"这个说法,真实的区间是 21 到 69 美元。 差了 10 倍。
而且这里有个容易被忽略的陷阱:BytePlus 只对成功生成的内容收费,被审核拦截或服务器报错的请求不收费。听起来很友好,但——
“A clip your reviewer rejects, however, is still a paid generation.”
(但你的审核人员否决的片段,只要生成成功,依然会被计费。)
生成成功的废片是照付的。 这意味着抽卡的成本不是"失败次数×单价",而是"成功次数×单价"——你抽了 10 次拿到的都是能生成但不能用的片段,10 次全部计费。
还有一个反直觉的推论:抽卡倍率高的团队,用便宜的模型反而更省。 Concat Pro 的建议里提到,短片高数量草稿场景下,Seedance 2.0 Mini(约 $0.03~$0.09/秒)往往仍是更实用的默认选择。如果你的重试率是 8 倍,换一个单价 1/3 的模型,总成本可能更低。 这跟"越贵越好"的直觉完全相反。
而 Flova 这类流程编排工具的核心卖点,正是"减少无效生成"。原文的说法是"不用赌运气式地反复抽卡"。它没有给出抽卡率下降了多少的数字——这个数字如果真的存在,应该被大范围引用,但我没查到可确认的官方口径。 本文不予引用。
🧩 三层成本叠在一起,实际该怎么算
把三层叠起来,一次真实的短剧成本核算长这样。
对应的成本核算表:
| 一 | 分辨率选择 480p/720p/1080p | 5.5 倍 | ✅ 官方价目表 |
| 一 | 促销价 vs 目录价 | 可达 90% | ⚠️ 促销已过期 |
| 二 | 是否带参考视频输入 | 最高 4.2 倍 | ✅ 官方公式 |
| 二 | 输入素材时长 | 线性增加 | ✅ 官方公式 |
| 三 | 抽卡倍率 3~10 倍 | 10 倍 | ❌ 无公开口径 |
| 三 | 废片是否计费 | 全额 | ✅ 明确计费 |
结论很清楚:目录价是唯一可查的部分,而它在真实成本里的占比可能不到 1/3。 因为抽卡倍率是最大的变量,也是唯一没有公开数字的变量。
⚖️ 一个必须说清的分歧:模型选择由重试率决定,不由单价决定
把上一节那个反直觉的推论展开。
Concat Pro 给了一个具体的对比逻辑:“The model that needs fewer retries is usually the cheaper one in practice.”(真正需要更少重试的模型,实际上通常更便宜。)
它同时列了横向对比:
| Wan 2.5 | $0.05 |
| Veo 3.1 | $0.05 |
| Sora 2 | $0.05 |
| Kling 2.5 Turbo Pro | $0.07 |
| Seedance 2.5 | $0.10 |
| Sora 2 Pro | $0.15 |
Seedance 2.5 处在中位。但它相对 Seedance 2.0 的溢价也很明确:
| 480p | $0.35 | $0.51 | +47% |
| 720p | $0.76 | $1.16 | +52% |
这个 50% 的溢价买到了什么? 三项能力:单次生成从 15 秒延到 30 秒、多模态参考上限从 9 提到 50、时间戳级编辑。
第三项是唯一直接对应成本的:时间戳级编辑意味着"改哪里算哪里",而不必整段重做。 如果这个能力真的能把重试率从 8 降到 3,那 50% 的溢价非常划算;如果你的项目本来就是一次过的短片,那这笔溢价就是纯支出。
所以判断标准不是"哪个模型强",而是"你的重试率是多少"。 这条判断在采购和工具选型里通用性很强。
🎬 一个容易被忽略的成本项:角色一致性是靠资产库摊薄的
前面三层都是显性成本,但短剧生产里还有一块成本经常被漏掉——角色一致性。
Seedance 2.5 支持最多 50 个多模态参考输入(30 图 / 10 视频 / 10 音频),这个能力在技术上确实能锁住形象。但用它锁形象的方式,是每次生成都把参考图重新喂一遍,也就是每次都重新付一次"输入侧"的 token 成本。
按公式算,输入侧时长相加进token 总数。参考素材越丰富,输入成本越高。这是一个和"减少抽卡"直接冲突的激励:你想让角色更一致,就得喂更多参考;参考喂得多,单次成本就上去。
Flova 这类工具的解法是"资产库"——角色的形象、师父的设定、场景卡、风格参考,都作为独立的元素卡片存在画布里。做完这条片子后,这些确认过的角色和场景存进资产库。下一集直接带进新项目,Agent 基于已有设定继续工作。
原文的说法是:
“不用从头解释’画师长什么样’‘浮世绘要什么色调’。”(腾讯新闻原文)
但这里有个必须追问的问题:资产复用到底省的是 token,还是省的人工?
从机制上看,两种情况都可能:
- 如果资产库只是"预置好参考图",每次生成还是要把图喂进去,那token 成本一分没省,省的是"写提示词描述角色"的人工。
- 如果资产库改变了调用方式(比如固定引用而非每次输入),那才可能省 token。
官方材料没有说明这一点,我也没查到可确认的口径。 本文不推测。但这条不确定性本身很重要——它决定了你把资产库当成"省钱工具"还是"省事工具",两者的期望值完全不同。
可以确定的是另一个:资产库对一致性的价值是可验证的。一篇实测提到短剧最翻车的现场是"上一集是短发的男主,下一集变成卷发了",解法是多模态参考锁形象加 Skill 锁风格,两层锁叠加才能压住。
这里也解释了为什么"生成前一帧对了,后面还是会错":一致性不是一次调用的事,是跨集、跨项目的持续约束。而持续约束需要存下来,不能靠每次重新描述。
🏗️ 领码 SPARK 融合平台视角
这期谈的成本核算,落到企业数据场景里有一个完全同构的问题:AI 生成类工具的成本,从来不在"单价表"上,而在"返工率"上。
iPaaS 接数据 —— 把成本因子接进来,而不是把单价接进来。
现在大多数成本核算的做法是:记下每次调用的单价,算总量。这是把成本当成一个标量在记,而它实际上是一个由多个可观测因子共同决定的函数。
接进平台的数据应该是:单次调用价格、输入规模、输出规模、重试次数、成功率、人工介入次数。有了这五项,才能算出真实的单位交付成本。 只有单价没有重试率,等于用"目录价"给自己做预算。
治理中心前置 —— 生成前声明约束,而不是事后返工。
Seedance 2.5 的多模态参考能力越强,token 成本越高——这跟"局部编辑能省额度"是同一枚硬币的两面。能力越强,约束不写清楚的后果越贵。
放到企业数据治理上完全同理:一个字段的口径不在入库前声明,就要靠人工在事后核对;一次核对成本可能不高,但如果这条数据每天被读一万次,返工成本就被放大了万倍。 前置声明的成本和事后返工的成本,差的不是倍数,是数量级。
全域守卫划权限 —— 让重试率可归因。
这一条是本文最想强调的。重试率是所有 AI 工具成本里最关键的指标,但它在大多数团队里是一个不可归因的数字。 你知道这个月失败了 300 次,但不知道这 300 次分散在哪些人、哪些业务场景、哪类数据。
全域守卫在这里的价值是:当失败可以追溯到具体的人、具体的输入、具体的规则,就能定位到"到底是模型不行、prompt 写得不对,还是数据本身有歧义"。 这三者的解法完全不同——第一种换模型,第二种改 prompt,第三种改数据规范。不归因的成本核算,只会得到"上个季度超预算了"这个没有行动价值的结论。
与 Dify 分工 —— 平台管成本事实,AI 管生成。
平台负责把"真实单位交付成本"算准并且可追溯,AI 负责生成。分工线在这里特别重要:因为真实成本里那一大块(重试、返工、人工介入)恰恰是最需要记账的部分,而它恰好是最不适合交给模型去"感觉"的部分。
要克制的是:平台能让成本可算、可归因、可对比,但"抽卡倍率多少算合理"这个基准线,仍需业务专家定。 同一类素材在创意场景抽 3 次是正常,在金融合规场景抽 3 次就可能说明上游数据有问题。平台给不了这个阈值,它只能保证不同场景的成本被分别记清楚。
📌 三条可以直接用的判断标准
| 1 | 用重试率选模型,不用单价选 | 记录自己项目连续 20 次生成的实际重试倍率 | 单价低 40% 但重试高 3 倍,总成本会更高 |
| 2 | 带参考素材时禁止用单价预算 | 用 token 公式算完整请求 | 输入时长与输出时长相加,总价最高可达单价暗示的 4.2 倍 |
| 3 | 促销价一律不进预算 | 只用当前结账页价格 | Dreamina 90% off 首月促销已于 10-09 结束 |
补一条容易被当成理所当然的:"抽卡率降了 40%"这类效率数字,必须先问它是按 token 算还是按金额算。 按 token 算的 40%,在分辨率从 480p 提到 720p 之后可能变成负收益。任何百分比效率提升,都要问它的分母是什么。
第 3 条看起来是废话,但我见过太多预算表里还留着"首月 1.5 美元/90% off"的过期价。这类数字一旦进了预算表,就会一路活到下次复盘。
💬 你做 AI 视频,真实的重试倍率是多少?
我很好奇这个数字。因为所有定价页面都只给单次成本,没有一家敢公布"平均重试次数"——而这恰恰是决定账单的变量。
如果你做过 AI 短剧或 AI 视频量产,说说你的实际重试倍率:是一个镜头抽两次就能用,还是要抽五次以上?以及有没有出现过"全部生成成功但全部不可用"的情况(那种成本最离谱,因为全部计费)?
另外,如果你发现某个工具宣传"效率提升 XX%",记得追问一句:这个 XX 是按目录价算的,还是按实际交付成本算的? 这两者的差距,通常就是宣传材料里不会提的那部分。
本文基于 BytePlus ModelArk 官方公开价目表(2026-10-08 更新)、Dreamina 订阅方案、第三方转售平台报价,以及 Flova 官方发布内容与多方实测报道整理。价格为实时变动项,引用时须带时点;文中"抽卡倍率 3~10 倍"为第三方平台经验值,非字节官方口径。