使用深度学习模型训练使用/光电池板语义分割数据集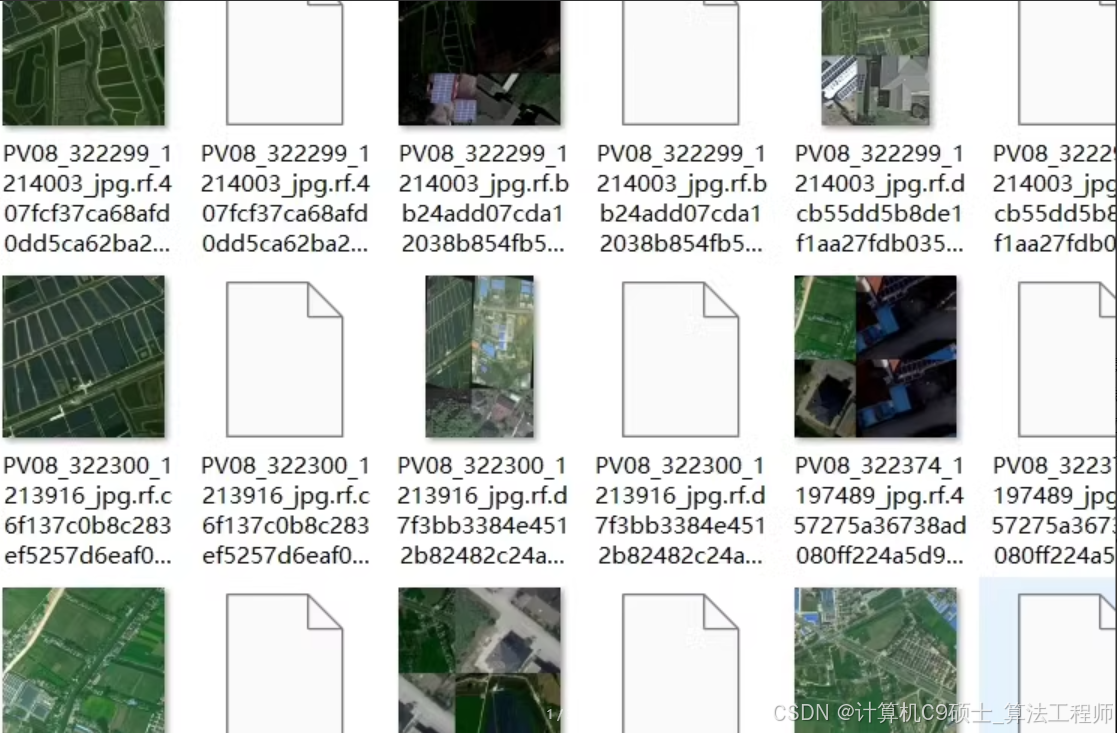
共包含3个数据文件:
/train:训练集
/valid:验证集
/test:测试集
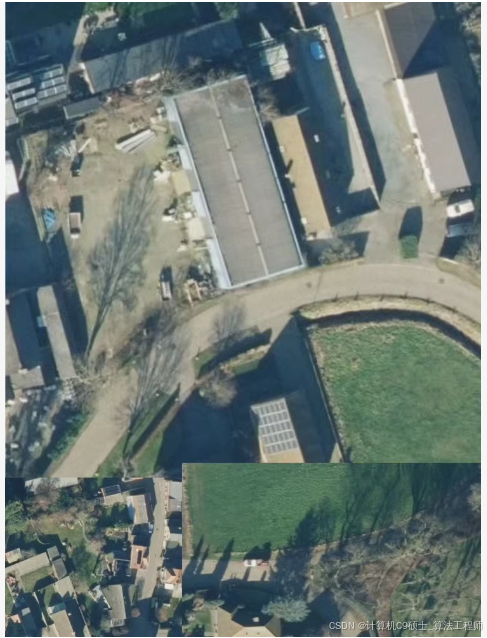
检测目标以Pascal VOC格式进行标注,对每个图像进行以下预处理,未做统一尺寸的处理。数据集共包含9614分布式光伏图像样张,其中train包含8499图像样张及其对应的xml标注,valid包含674图像样张及其对应的xml标注,test包含441图像样张及其对应的xml标注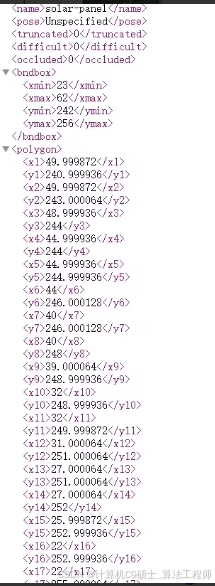
构建一个光伏电池板语义分割系统,我们需要处理包含9614张图像的数据集,并且这些图像使用Pascal VOC格式进行标注。我们将使用深度学习模型来进行语义分割任务。以下是详细的步骤和代码实现:
文章代码仅供参考、
数据准备
假设你已经有一个包含9614张遥感图像的数据集,并且标注格式为适合语义分割任务的格式(例如,Pascal VOC 格式)。
数据集结构示例
dataset/
├── images/
│ ├── train/
│ │ ├── image1.jpg
│ │ ├── image2.jpg
│ │ └── …
│ ├── valid/
│ │ ├── image3.jpg
│ │ ├── image4.jpg
│ │ └── …
│ └── test/
│ ├── image5.jpg
│ ├── image6.jpg
│ └── …
├── annotations/
│ ├── train/
│ │ ├── image1.xml
│ │ ├── image2.xml
│ │ └── …
│ ├── valid/
│ │ ├── image3.xml
│ │ ├── image4.xml
│ │ └── …
│ └── test/
│ ├── image5.xml
│ ├── image6.xml
│ └── …
└── dataset.json
dataset.json 内容如下:
{
"train": {
"img_dir": "./images/train",
"ann_dir": "./annotations/train"
},
"valid": {
"img_dir": "./images/valid",
"ann_dir": "./annotations/valid"
},
"test": {
"img_dir": "./images/test",
"ann_dir": "./annotations/test"
}
}
环境部署说明
确保你已经安装了必要的库,如上所述。
安装依赖
# 创建虚拟环境(可选)
conda create -n pv_panel_segmentation_env python=3.8
conda activate pv_panel_segmentation_env
# 安装PyTorch
pip install torch==1.9 torchvision torchaudio –extra-index-url https://download.pytorch.org/whl/cu111
# 安装其他依赖
pip install opencv-python pyqt5 scikit-learn pandas matplotlib seaborn onnxruntime xml.etree.ElementTree albumentations segmentation-models-pytorch
数据预处理 data_preprocessing.py
我们将使用 albumentations 进行图像预处理。
[<title="Data Preprocessing for PV Panel Segmentation">]
import os
import cv2
import numpy as np
from tqdm import tqdm
from albumentations import (
HorizontalFlip, VerticalFlip, RandomRotate90, Transpose,
ShiftScaleRotate, HueSaturationValue, Blur, OpticalDistortion,
GridDistortion, CLAHE, RandomBrightnessContrast, RandomGamma,
ToFloat, Normalize, Compose, NoOp, OneOf, Resize
)
from albumentations.pytorch import ToTensorV2
import xml.etree.ElementTree as ET
import shutil
def parse_voc_xml(xml_path):
tree = ET.parse(xml_path)
root = tree.getroot()
size = root.find('size')
width = int(size.find('width').text)
height = int(size.find('height').text)
masks = []
labels = []
for obj in root.findall('object'):
label = obj.find('name').text
bndbox = obj.find('bndbox')
xmin = int(bndbox.find('xmin').text)
ymin = int(bndbox.find('ymin').text)
xmax = int(bndbox.find('xmax').text)
ymax = int(bndbox.find('ymax').text)
mask = np.zeros((height, width), dtype=np.uint8)
mask[ymin:ymax, xmin:xmax] = 1
masks.append(mask)
labels.append(label)
return masks, labels
def preprocess_image(image_path, xml_path, output_img_path, output_mask_paths, patch_size=512):
image = cv2.imread(image_path)
masks, _ = parse_voc_xml(xml_path)
transform = A.Compose([
Resize(height=patch_size, width=patch_size),
HorizontalFlip(p=0.5),
VerticalFlip(p=0.5),
Rotate(limit=45, p=0.5),
RandomBrightnessContrast(p=0.2),
ToFloat(max_value=255),
Normalize(mean=(0.485, 0.456, 0.406), std=(0.229, 0.224, 0.225)),
ToTensorV2(),
])
transformed = transform(image=image)
image_transformed = transformed['image']
output_img_path = f"{output_img_path}.jpg"
cv2.imwrite(output_img_path, (image_transformed.permute(1, 2, 0).numpy() * 255).astype(np.uint8))
for i, mask in enumerate(masks):
mask_resized = cv2.resize(mask.astype(np.float32), (patch_size, patch_size))
output_mask_path = f"{output_mask_paths[i]}_{i}.png"
cv2.imwrite(output_mask_path, (mask_resized * 255).astype(np.uint8))
if __name__ == "__main__":
dataset_path = 'path/to/dataset'
output_dataset_path = 'path/to/output_dataset'
sets = ['train', 'valid', 'test']
for s in sets:
img_dir = os.path.join(dataset_path, 'images', s)
ann_dir = os.path.join(dataset_path, 'annotations', s)
output_img_dir = os.path.join(output_dataset_path, 'images', s)
output_mask_dir = os.path.join(output_dataset_path, 'masks', s)
os.makedirs(output_img_dir, exist_ok=True)
os.makedirs(output_mask_dir, exist_ok=True)
for img_filename in tqdm(os.listdir(img_dir)):
img_path = os.path.join(img_dir, img_filename)
xml_filename = img_filename.replace('.jpg', '.xml')
xml_path = os.path.join(ann_dir, xml_filename)
output_img_path = os.path.join(output_img_dir, img_filename[:–4])
output_mask_paths = [os.path.join(output_mask_dir, img_filename[:–4])]
preprocess_image(img_path, xml_path, output_img_path, output_mask_paths)
请将 path/to/dataset 和 path/to/output_dataset 替换为实际的数据集路径。
模型定义与训练 train.py
我们将使用 UNet 进行语义分割任务。
首先,安装 segmentation-models-pytorch 库:
pip install segmentation-models-pytorch
然后编写训练脚本:
[<title="Training Script for PV Panel Segmentation using UNet">]
import os
import json
import torch
from torch.utils.data import DataLoader
from torchvision.transforms.functional import to_tensor, to_pil_image
from PIL import Image
import albumentations as A
from albumentations.pytorch import ToTensorV2
from segmentation_models_pytorch import Unet
from sklearn.model_selection import train_test_split
import matplotlib.pyplot as plt
import numpy as np
class PVDataset(torch.utils.data.Dataset):
def __init__(self, img_dir, mask_dir, transforms=None):
self.img_dir = img_dir
self.mask_dir = mask_dir
self.transforms = transforms
self.images = sorted(os.listdir(img_dir))
self.masks = sorted(os.listdir(mask_dir))
def __len__(self):
return len(self.images)
def __getitem__(self, idx):
img_path = os.path.join(self.img_dir, self.images[idx])
mask_path = os.path.join(self.mask_dir, self.masks[idx])
image = Image.open(img_path).convert("RGB")
mask = Image.open(mask_path).convert("L")
sample = {'image': image, 'mask': mask}
if self.transforms:
augmented = self.transforms(image=np.array(sample['image']), mask=np.array(sample['mask']))
image = augmented['image']
mask = augmented['mask']
return image, mask
transform = A.Compose([
A.Resize(height=256, width=256),
A.HorizontalFlip(p=0.5),
A.VerticalFlip(p=0.5),
A.Rotate(limit=45, p=0.5),
A.RandomBrightnessContrast(p=0.2),
A.Normalize(mean=(0.485, 0.456, 0.406), std=(0.229, 0.224, 0.225)),
ToTensorV2(),
])
with open('path/to/dataset.json', 'r') as f:
dataset_config = json.load(f)
train_dataset = PVDataset(
img_dir=dataset_config['train']['img_dir'],
mask_dir=dataset_config['train']['ann_dir'],
transforms=transform
)
valid_dataset = PVDataset(
img_dir=dataset_config['valid']['img_dir'],
mask_dir=dataset_config['valid']['ann_dir'],
transforms=transform
)
train_loader = DataLoader(train_dataset, batch_size=16, shuffle=True, num_workers=4)
valid_loader = DataLoader(valid_dataset, batch_size=16, shuffle=False, num_workers=4)
model = Unet(encoder_name="resnet34", encoder_weights="imagenet", classes=1, activation=None)
loss_fn = torch.nn.BCEWithLogitsLoss()
optimizer = torch.optim.Adam(model.parameters(), lr=1e-4)
device = torch.device("cuda" if torch.cuda.is_available() else "cpu")
model.to(device)
num_epochs = 50
for epoch in range(num_epochs):
model.train()
running_loss = 0.0
for inputs, targets in train_loader:
inputs = inputs.to(device)
targets = targets.unsqueeze(1).to(device).float()
optimizer.zero_grad()
outputs = model(inputs)
loss = loss_fn(outputs, targets)
loss.backward()
optimizer.step()
running_loss += loss.item()
epoch_loss = running_loss / len(train_loader)
print(f"Epoch {epoch + 1}/{num_epochs}, Loss: {epoch_loss:.4f}")
model.eval()
val_running_loss = 0.0
with torch.no_grad():
for inputs, targets in valid_loader:
inputs = inputs.to(device)
targets = targets.unsqueeze(1).to(device).float()
outputs = model(inputs)
loss = loss_fn(outputs, targets)
val_running_loss += loss.item()
val_epoch_loss = val_running_loss / len(valid_loader)
print(f"Validation Epoch {epoch + 1}/{num_epochs}, Loss: {val_epoch_loss:.4f}")
torch.save(model.state_dict(), f'model_epoch_{epoch + 1}.pth')
请将 path/to/dataset.json 替换为实际的路径。
评估模型 evaluate.py
[<title="Evaluation Script for PV Panel Segmentation">]
import os
import json
import torch
from torch.utils.data import DataLoader
from torchvision.transforms.functional import to_tensor, to_pil_image
from PIL import Image
import albumentations as A
from albumentations.pytorch import ToTensorV2
from segmentation_models_pytorch import Unet
import numpy as np
import matplotlib.pyplot as plt
class PVDataset(torch.utils.data.Dataset):
def __init__(self, img_dir, mask_dir, transforms=None):
self.img_dir = img_dir
self.mask_dir = mask_dir
self.transforms = transforms
self.images = sorted(os.listdir(img_dir))
self.masks = sorted(os.listdir(mask_dir))
def __len__(self):
return len(self.images)
def __getitem__(self, idx):
img_path = os.path.join(self.img_dir, self.images[idx])
mask_path = os.path.join(self.mask_dir, self.masks[idx])
image = Image.open(img_path).convert("RGB")
mask = Image.open(mask_path).convert("L")
sample = {'image': image, 'mask': mask}
if self.transforms:
augmented = self.transforms(image=np.array(sample['image']), mask=np.array(sample['mask']))
image = augmented['image']
mask = augmented['mask']
return image, mask
transform = A.Compose([
A.Resize(height=256, width=256),
A.Normalize(mean=(0.485, 0.456, 0.406), std=(0.229, 0.224, 0.225)),
ToTensorV2(),
])
with open('path/to/dataset.json', 'r') as f:
dataset_config = json.load(f)
test_dataset = PVDataset(
img_dir=dataset_config['test']['img_dir'],
mask_dir=dataset_config['test']['ann_dir'],
transforms=transform
)
test_loader = DataLoader(test_dataset, batch_size=1, shuffle=False, num_workers=4)
model = Unet(encoder_name="resnet34", encoder_weights="imagenet", classes=1, activation=None)
model.load_state_dict(torch.load('model_epoch_50.pth'))
model.eval()
device = torch.device("cuda" if torch.cuda.is_available() else "cpu")
model.to(device)
loss_fn = torch.nn.BCEWithLogitsLoss()
running_loss = 0.0
for inputs, targets in test_loader:
inputs = inputs.to(device)
targets = targets.unsqueeze(1).to(device).float()
outputs = model(inputs)
loss = loss_fn(outputs, targets)
running_loss += loss.item()
# Visualization
input_np = inputs.squeeze().permute(1, 2, 0).cpu().numpy()
target_np = targets.squeeze().cpu().numpy()
output_np = torch.sigmoid(outputs).squeeze().cpu().numpy()
fig, axes = plt.subplots(1, 3, figsize=(15, 5))
axes[0].imshow(input_np)
axes[0].set_title('Input Image')
axes[0].axis('off')
axes[1].imshow(target_np, cmap='gray')
axes[1].set_title('Ground Truth Mask')
axes[1].axis('off')
axes[2].imshow(output_np > 0.5, cmap='gray')
axes[2].set_title('Predicted Mask')
axes[2].axis('off')
plt.show()
epoch_loss = running_loss / len(test_loader)
print(f"Test Loss: {epoch_loss:.4f}")
请将 path/to/dataset.json 替换为实际的路径。
用户界面 ui.py
我们将使用 PyQt5 创建一个简单的 GUI 来加载和运行模型进行实时预测。
[<title="PyQt5 Main Window for PV Panel Segmentation">]
import sys
import cv2
import numpy as np
from PyQt5.QtWidgets import QApplication, QMainWindow, QLabel, QPushButton, QVBoxLayout, QWidget, QFileDialog
from PyQt5.QtGui import QImage, QPixmap
from PyQt5.QtCore import Qt, QTimer
import torch
from segmentation_models_pytorch import Unet
import albumentations as A
from albumentations.pytorch import ToTensorV2
from PIL import Image
class MainWindow(QMainWindow):
def __init__(self):
super().__init__()
self.setWindowTitle("PV Panel Segmentation System")
self.setGeometry(100, 100, 800, 600)
# Load UNet model
self.model = Unet(encoder_name="resnet34", encoder_weights="imagenet", classes=1, activation=None)
self.model.load_state_dict(torch.load('/path/to/model_epoch_50.pth'))
self.model.eval()
self.transform = A.Compose([
A.Resize(height=256, width=256),
A.Normalize(mean=(0.485, 0.456, 0.406), std=(0.229, 0.224, 0.225)),
ToTensorV2(),
])
self.initUI()
def initUI(self):
self.central_widget = QWidget()
self.setCentralWidget(self.central_widget)
self.layout = QVBoxLayout()
self.image_label = QLabel(self)
self.image_label.setAlignment(Qt.AlignCenter)
self.layout.addWidget(self.image_label)
self.load_image_button = QPushButton("Load Image", self)
self.load_image_button.clicked.connect(self.load_image)
self.layout.addWidget(self.load_image_button)
self.start_prediction_button = QPushButton("Start Prediction", self)
self.start_prediction_button.clicked.connect(self.start_prediction)
self.layout.addWidget(self.start_prediction_button)
self.stop_prediction_button = QPushButton("Stop Prediction", self)
self.stop_prediction_button.clicked.connect(self.stop_prediction)
self.layout.addWidget(self.stop_prediction_button)
self.central_widget.setLayout(self.layout)
self.image_path = None
self.timer = QTimer()
self.timer.timeout.connect(self.update_frame)
def load_image(self):
options = QFileDialog.Options()
file_name, _ = QFileDialog.getOpenFileName(self, "QFileDialog.getOpenFileName()", "", "Images (*.jpg *.jpeg *.png);;All Files (*)", options=options)
if file_name:
self.image_path = file_name
self.display_image(file_name)
def display_image(self, path):
pixmap = QPixmap(path)
scaled_pixmap = pixmap.scaled(self.image_label.width(), self.image_label.height(), Qt.KeepAspectRatio)
self.image_label.setPixmap(scaled_pixmap)
def start_prediction(self):
if self.image_path is not None and not self.timer.isActive():
self.timer.start(30) # Update frame every 30 ms
def stop_prediction(self):
if self.timer.isActive():
self.timer.stop()
self.image_label.clear()
def update_frame(self):
frame = cv2.imread(self.image_path)
frame_rgb = cv2.cvtColor(frame, cv2.COLOR_BGR2RGB)
augmented = self.transform(image=frame_rgb)
image = augmented['image'].unsqueeze(0)
device = torch.device("cuda" if torch.cuda.is_available() else "cpu")
image = image.to(device)
with torch.no_grad():
output = self.model(image)
pred_mask = torch.sigmoid(output).squeeze().cpu().numpy()
pred_mask = (pred_mask > 0.5).astype(np.uint8) * 255
contours, _ = cv2.findContours(pred_mask, cv2.RETR_EXTERNAL, cv2.CHAIN_APPROX_SIMPLE)
for contour in contours:
x, y, w, h = cv2.boundingRect(contour)
cv2.rectangle(frame, (x, y), (x + w, y + h), (0, 255, 0), 2)
rgb_image = cv2.cvtColor(frame, cv2.COLOR_BGR2RGB)
h, w, ch = rgb_image.shape
bytes_per_line = ch * w
qt_image = QImage(rgb_image.data, w, h, bytes_per_line, QImage.Format_RGB888)
pixmap = QPixmap.fromImage(qt_image)
scaled_pixmap = pixmap.scaled(self.image_label.width(), self.image_label.height(), Qt.KeepAspectRatio)
self.image_label.setPixmap(scaled_pixmap)
if __name__ == "__main__":
app = QApplication(sys.argv)
window = MainWindow()
window.show()
sys.exit(app.exec_())
请将 /path/to/model_epoch_50.pth 替换为实际的模型权重路径。
不带用户界面的预测脚本 without_ui.py
[<title="Prediction Script without UI for PV Panel Segmentation">]
import cv2
import numpy as np
import torch
from segmentation_models_pytorch import Unet
import albumentations as A
from albumentations.pytorch import ToTensorV2
from PIL import Image
# Load UNet model
model = Unet(encoder_name="resnet34", encoder_weights="imagenet", classes=1, activation=None)
model.load_state_dict(torch.load('/path/to/model_epoch_50.pth'))
model.eval()
transform = A.Compose([
A.Resize(height=256, width=256),
A.Normalize(mean=(0.485, 0.456, 0.406), std=(0.229, 0.224, 0.225)),
ToTensorV2(),
])
def predict(image_path):
frame = cv2.imread(image_path)
frame_rgb = cv2.cvtColor(frame, cv2.COLOR_BGR2RGB)
augmented = transform(image=frame_rgb)
image = augmented['image'].unsqueeze(0)
device = torch.device("cuda" if torch.cuda.is_available() else "cpu")
image = image.to(device)
with torch.no_grad():
output = model(image)
pred_mask = torch.sigmoid(output).squeeze().cpu().numpy()
pred_mask = (pred_mask > 0.5).astype(np.uint8) * 255
contours, _ = cv2.findContours(pred_mask, cv2.RETR_EXTERNAL, cv2.CHAIN_APPROX_SIMPLE)
for contour in contours:
x, y, w, h = cv2.boundingRect(contour)
cv2.rectangle(frame, (x, y), (x + w, y + h), (0, 255, 0), 2)
cv2.imshow('Detected Image', frame)
cv2.waitKey(0)
cv2.destroyAllWindows()
if __name__ == "__main__":
image_path = 'path/to/image.jpg'
predict(image_path)
请将 /path/to/model_epoch_50.pth 和 path/to/image.jpg 替换为实际的路径。
辅助工具 tools/check_img.py
[<title="Check Image Files Tool">]
import os
def check_image_files(directory):
supported_extensions = ['.jpg', '.jpeg', '.png']
for filename in os.listdir(directory):
if any(filename.lower().endswith(ext) for ext in supported_extensions):
continue
else:
raise ValueError(f"Unsupported file format: {filename}")
print("All image files are valid.")
辅助工具 tools/check_ann.py
[<title="Check Annotation Files Tool">]
import os
def check_annotation_files(directory, annotation_format='voc'):
if annotation_format == 'voc':
supported_extensions = ['.xml']
else:
raise ValueError("Unsupported annotation format. Use 'voc'.")
for filename in os.listdir(directory):
if any(filename.lower().endswith(ext) for ext in supported_extensions):
continue
else:
raise ValueError(f"Unsupported file format: {filename}")
print("All annotation files are valid.")
使用说明
配置路径:
- 将 /path/to/dataset 设置为存放原始数据集的目录路径。
- 将 /path/to/output_dataset 设置为存放预处理后数据集的目录路径。
- 确保 /path/to/model_epoch_50.pth 是训练好的 UNet 模型权重路径。
- 将 path/to/image.jpg 设置为要预测的图像路径。
运行脚本:
- 在终端中运行 data_preprocessing.py 脚本来预处理图像。
- 在终端中运行 train.py 脚本来训练模型。
- 在终端中运行 evaluate.py 来评估模型性能。
- 在终端中运行 ui.py 来启动 GUI 应用程序。
- 在终端中运行 without_ui.py 来进行无界面预测。
- 使用 tools/check_img.py 和 tools/check_ann.py 检查图像和注释文件的有效性。
注意事项:
- 确保所有必要的工具箱已安装,特别是 PyTorch 和 PyQt5。
- 根据需要调整参数,如 epochs 和 batch_size。
示例
假设你的数据文件夹结构如下:
dataset/
├── images/
│ ├── train/
│ │ ├── image1.jpg
│ │ ├── image2.jpg
│ │ └── …
│ ├── valid/
│ │ ├── image3.jpg
│ │ ├── image4.jpg
│ │ └── …
│ └── test/
│ ├── image5.jpg
│ ├── image6.jpg
│ └── …
├── annotations/
│ ├── train/
│ │ ├── image1.xml
│ │ ├── image2.xml
│ │ └── …
│ ├── valid/
│ │ ├── image3.xml
│ │ ├── image4.xml
│ │ └── …
│ └── test/
│ ├── image5.xml
│ ├── image6.xml
│ └── …
└── dataset.json
并且每个 .xml 文件中都有正确的 Pascal VOC 格式的标注。运行 ui.py 后,你可以通过点击按钮来加载图像并进行光伏电池板检测。