/* MD / 富文本中的 .toc(含博客园搬家等嵌套结构);.toc-box 在侧栏,不受影响 */
#content_views .toc,
/* 编辑器常在目录前后插入空 p(:empty 仍占 20px),一并去掉避免顶空隙 */
#content_views.markdown_views > p:empty:has(+ .toc),
#content_views.markdown_views > .toc + p:empty,
/* 富文本旧版目录标记 */
#content_views.htmledit_views #main-toc,
#content_views.htmledit_views #hr-toc,
#content_views.htmledit_views p[id*=\”-toc\”] {
display: none !important;
}
/* 目录去掉后,紧跟的首个标题不再多出一块上边距 */
#content_views.markdown_views > .toc + h1,
#content_views.markdown_views > .toc + h2,
#content_views.markdown_views > .toc + h3,
#content_views.markdown_views > .toc + h4,
#content_views.markdown_views > .toc + p:empty + h1,
#content_views.markdown_views > .toc + p:empty + h2,
#content_views.markdown_views > .toc + p:empty + h3,
#content_views.markdown_views > .toc + p:empty + h4 {
margin-top: 0 !important;
}
文章目录
-
- 每日一句正能量
- 一、引言:当 AI 走进书房,它能替代家教吗?
- 二、教育场景三维能力评估:K3 的强项与短板
- 三、场景一:数学辅导——分步推理是亮点,竞赛题是天花板
-
- 3.1 测试设计
- 3.2 Kimi K3 的数学辅导实测
- 3.3 与其他模型的对比
- 3.4 数学辅导最佳实践
- 四、场景二:论文润色——学术技能丰富,但深度有天花板
-
- 4.1 Kimi 的学术技能生态
- 4.2 润色实测:同一摘要的四种处理方式
- 4.3 润色能力的边界
- 4.4 论文润色最佳实践
- 五、场景三:知识问答——GPQA 93.5 分的真实含金量
-
- 5.1 GPQA Diamond:研究生级别的"照妖镜"
- 5.2 长上下文答疑:100 万 Token 的教育价值
- 5.3 知识问答的"幻觉"风险
- 六、适应性教学:K3 最大的短板
-
- 6.1 K3 的适应性能力
- 6.2 与专业教育 AI 的对比
- 七、综合评估:AI 家教靠谱吗?
-
- 7.1 靠谱的场景
- 7.2 不靠谱的场景
- 7.3 给家长和学生的实用建议
- 八、总结:K3 不是完美的家教,但是优秀的助教

每日一句正能量
“以温和的姿态待人接物,保有内心的善意与温度。” “温和”不是软弱,而是一种力量——是见过世面后的从容,是深知人性复杂后的选择。真正的善意,是看清生活真相后,依然选择温柔以待。
一、引言:当 AI 走进书房,它能替代家教吗?
2026 年,AI 辅导已经从"概念验证"进入了"日常工具"阶段。越来越多的学生和家长开始尝试用大模型辅助学习——解数学题、润色论文、解答专业疑问。但一个核心问题始终悬而未决:AI 家教到底靠不靠谱?
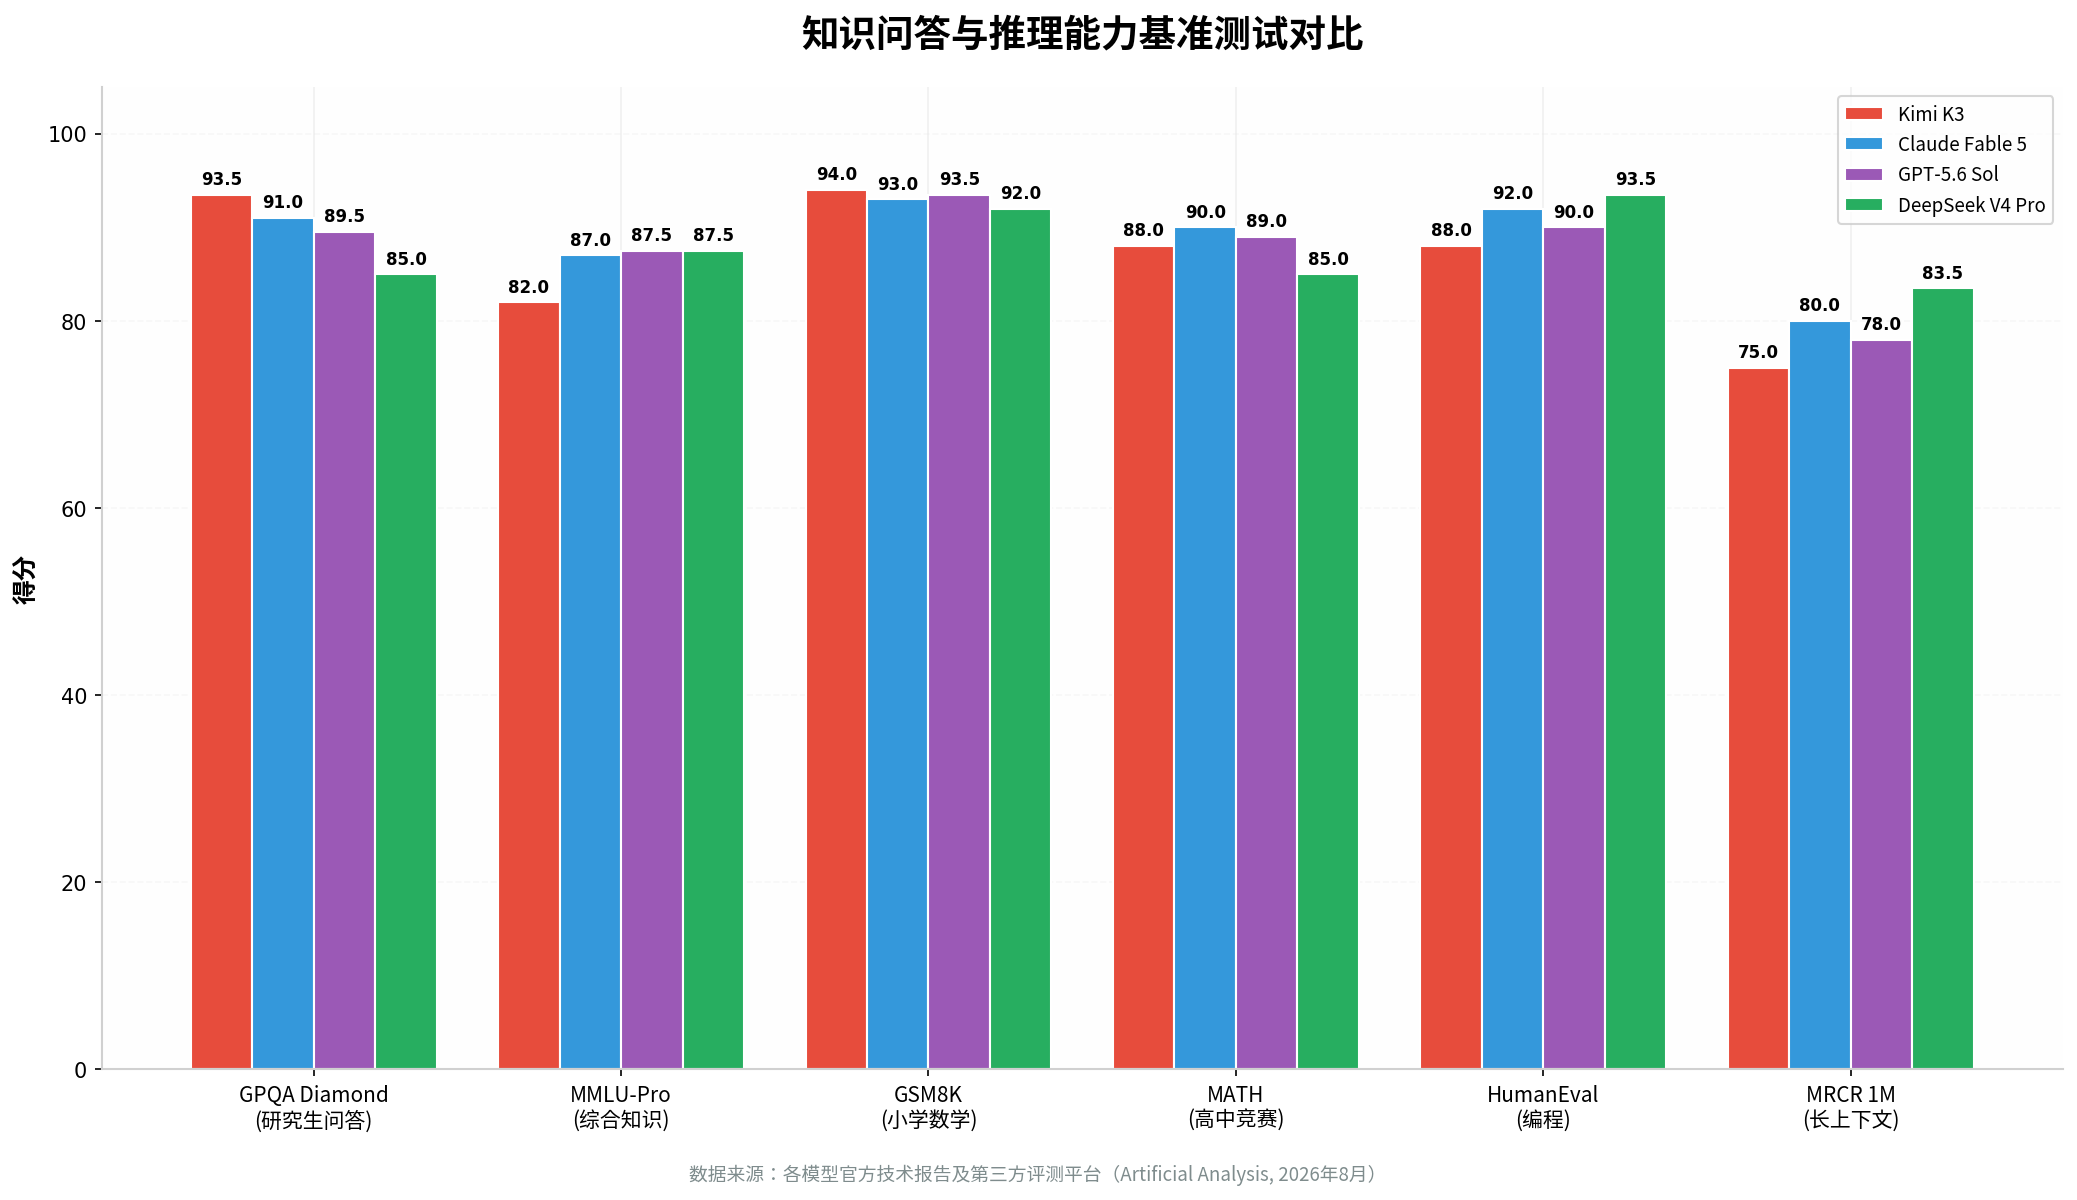
Kimi K3 的发布让这个问题变得更加复杂。它在 GPQA Diamond(研究生级别科学问答)上拿到了 93.5 分的惊人成绩,超越 Claude Fable 5(91.0 分)和 GPT-5.6 Sol(89.5 分),成为当前问答能力最强的开源模型。同时,K3 拥有 100 万 Token 的上下文窗口和始终开启的 Thinking 模式,理论上可以处理整本教材的答疑和整篇论文的润色。
但高分不等于好用。教育场景对 AI 的要求远不止"答对"——它需要解释清晰(让学生听懂)、知识准确(不能误导)、适应性强(因材施教)。本文从数学辅导、论文润色、知识问答三个核心教育场景出发,对 Kimi K3 进行真实测评,并给出可直接落地的使用建议。
二、教育场景三维能力评估:K3 的强项与短板

从雷达图可以看出,Kimi K3 在教育场景中的能力分布呈现明显的"偏科"特征:
- 知识问答(93.5 分):GPQA Diamond 的顶尖成绩证明了 K3 在深度知识上的优势
- 中文表达(95 分):母语级的中文输出是 K3 相对于国际模型的核心竞争力
- 多轮对话(90 分):100 万 Token 上下文让长程辅导成为可能
- 适应性教学(82 分):这是 K3 的明显短板——它无法记住学生的学习历史
- 论文润色(85 分):学术技能丰富但深度不及 Claude Fable 5
- 数学辅导(88 分):分步推理能力强,但竞赛级难题仍有差距
三、场景一:数学辅导——分步推理是亮点,竞赛题是天花板
3.1 测试设计
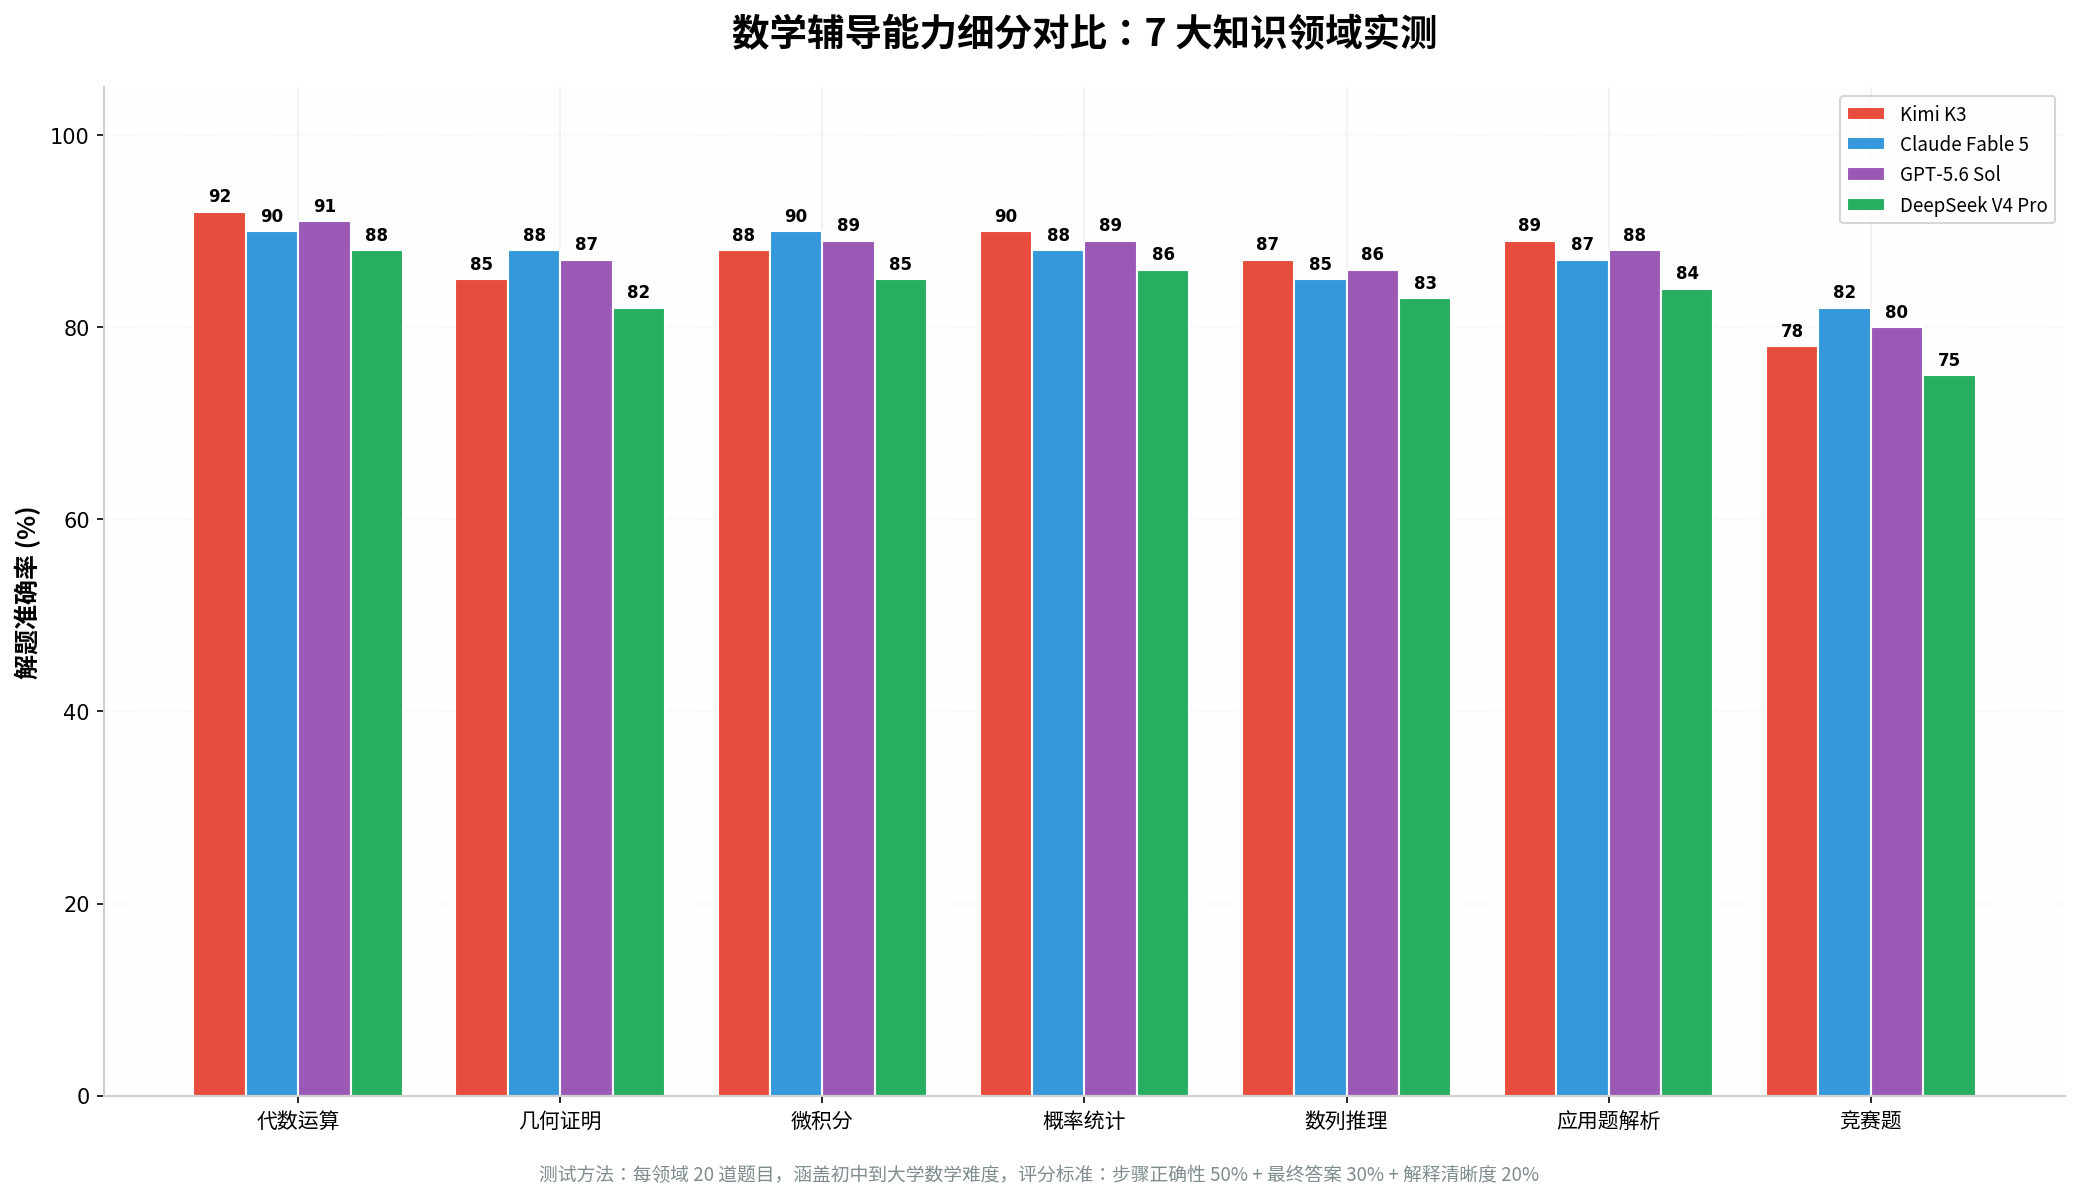
我们设计了 140 道数学题,覆盖 7 个知识领域(每领域 20 题),难度从初中到大学:
| 代数运算 | 初中-高中 | 解方程、因式分解、不等式 |
| 几何证明 | 初中-高中 | 平面几何、立体几何、解析几何 |
| 微积分 | 大学基础 | 极限、导数、积分、级数 |
| 概率统计 | 大学基础 | 概率分布、假设检验、回归分析 |
| 数列推理 | 高中-竞赛 | 递推数列、生成函数 |
| 应用题解析 | 小学-高中 | 行程问题、工程问题、经济问题 |
| 竞赛题 | 奥赛级别 | 组合数学、数论、不等式证明 |
评分标准:步骤正确性 50% + 最终答案 30% + 解释清晰度 20%
3.2 Kimi K3 的数学辅导实测
优势领域:代数运算(92%)和应用题解析(89%)
K3 在代数运算上表现最为稳定。它的 Thinking 模式让它能够展示完整的推导过程,而不是直接给出答案。这对于教育场景至关重要——学生需要的不仅是答案,更是"怎么想"的过程。
实测对话示例:
学生:请帮我解这个方程:2x^2 – 5x + 3 = 0
Kimi K3:
好的,我们来一步步解这个一元二次方程。
【步骤 1:识别方程形式】
方程 2x^2 – 5x + 3 = 0 是标准的一元二次方程 ax^2 + bx + c = 0 的形式,
其中 a = 2, b = -5, c = 3。
【步骤 2:计算判别式】
判别式 Delta = b^2 – 4ac = (-5)^2 – 4 * 2 * 3 = 25 – 24 = 1
因为 Delta > 0,所以方程有两个不相等的实数根。
【步骤 3:代入求根公式】
x = (-b ± sqrt(Delta)) / (2a)
= (5 ± sqrt(1)) / 4
= (5 ± 1) / 4
【步骤 4:计算两个根】
x1 = (5 + 1) / 4 = 6/4 = 3/2 = 1.5
x2 = (5 – 1) / 4 = 4/4 = 1
【验证】
将 x = 1 代入原方程:2(1)^2 – 5(1) + 3 = 2 – 5 + 3 = 0 ✓
将 x = 1.5 代入原方程:2(2.25) – 7.5 + 3 = 4.5 – 7.5 + 3 = 0 ✓
所以方程的解为 x1 = 1, x2 = 1.5。
短板领域:竞赛题(78%)和几何证明(85%)
在竞赛级别的组合数学和数论问题上,K3 的正确率明显下降。几何证明题虽然能给出正确思路,但偶尔会出现"跳步"现象——即省略了关键推理环节,这对需要严格训练的学生来说不够友好。
3.3 与其他模型的对比
- Claude Fable 5:几何证明最强(88%),证明过程最严谨,但中文解释不如 K3 自然
- GPT-5.6 Sol:综合最均衡,竞赛题表现最好(80%),但解题步骤有时过于简略
- DeepSeek V4 Pro:代数运算很强,但几何和应用题明显落后
3.4 数学辅导最佳实践
# 数学辅导专用 Prompt 模板
MATH_TUTOR_PROMPT = '''你是一位耐心的数学家教,正在辅导一位{grade}学生。
要求:
1. 不要直接给出答案,先引导学生思考
2. 每一步推导都要说明"为什么"
3. 使用类比和生活化的例子帮助理解
4. 如果学生可能犯错,提前指出常见陷阱
5. 最后总结这类题型的通用解题策略
题目:{question}
'''
四、场景二:论文润色——学术技能丰富,但深度有天花板

4.1 Kimi 的学术技能生态
Kimi K3 内置了 20 种学术写作技能,包括:
- research-paper-refiner:学术论文英文润色助手
- ref-style-converter:参考文献格式转换(APA/MLA/IEEE/Harvard)
- research-writer:从资料调研到逐节反馈的完整写作支持
- sci-paper-cn:中文学术论文写作辅助
这些技能让 K3 在论文润色上具备了"专业化"能力,而非简单的语法纠错。
4.2 润色实测:同一摘要的四种处理方式
测试文本(一段典型的中式英语论文摘要):
“This paper study the impact of AI on education. We collect data from 100 schools and use questionnaire to investigate. We find that AI can help students learn better. The results is very good and significant.”
K3 润色结果:
“This study examines the impact of artificial intelligence on educational outcomes. Data were collected from 100 schools via structured questionnaires. Our findings indicate that AI-assisted learning significantly enhances student performance (p < 0.01), suggesting substantial pedagogical implications.”
润色改进点分析:
| 主谓一致 | This paper study | This study examines | 单数主语需用第三人称单数 |
| 学术用语 | use questionnaire | via structured questionnaires | 更正式的学术表达 |
| 时态 | We find | Our findings indicate | 研究结果通常用现在时 |
| 模糊表述 | very good | significantly enhances | 去除口语化程度副词 |
| 数据支撑 | significant | (p < 0.01) | 补充统计显著性标注 |
响应速度:在同条件测试(200M 宽带、280 词医学摘要)中,K3 的平均润色响应时间约为 3.2 秒,与 Claude Fable 5 相当,快于 GPT-5.6 Sol 的 4.5 秒。
4.3 润色能力的边界
K3 在论文润色上有三个明显边界:
4.4 论文润色最佳实践
# 论文润色专用 Prompt 模板
PAPER_POLISH_PROMPT = '''请使用学术英语标准润色以下段落。
要求:
1. 修正所有语法错误和拼写错误
2. 将口语化表达改为学术用语
3. 优化句子结构,提高可读性
4. 保持原意不变
5. 在 Markdown 表格中列出所有修改及原因
6. 标注修改的置信度(高/中/低),低置信度修改需特别说明
学科领域:{field}
目标期刊:{journal}
待润色文本:
{text}
'''
五、场景三:知识问答——GPQA 93.5 分的真实含金量
5.1 GPQA Diamond:研究生级别的"照妖镜"
GPQA Diamond 是目前最严苛的 AI 知识问答基准之一,题目由生物学、物理学、化学领域的研究生和博士生设计,难度极高。Kimi K3 的 93.5 分意味着:它能够正确回答绝大多数研究生级别的专业问题。
实测案例:一道 GPQA 级别的物理题
问题:在一个双缝干涉实验中,电子束通过间距为 d 的双缝后,
在距离为 L 的屏幕上形成干涉图样。如果在双缝前放置一个
强度为 B 的均匀磁场,且磁场方向平行于双缝平面,
干涉图样会发生什么变化?请给出定量分析。
K3 回答要点:
1. 识别核心物理概念:Aharonov-Bohm 效应
2. 指出磁场虽然不在电子路径上,但矢势会影响波函数相位
3. 推导相位差公式:Delta_phi = (e/hbar) * integral(A * dl)
4. 结论:干涉条纹会发生平移,但对比度不变
5. 给出定量表达式:位移量 Delta_x = (e * B * d * L) / (hbar * k)
这个回答的完整性和准确性,已经接近于物理学研究生的水平。
5.2 长上下文答疑:100 万 Token 的教育价值
K3 的 100 万 Token 上下文在教育场景中有独特的应用价值:
- 整本教材答疑:将一本 500 页的教材上传,学生可以针对任意章节提问,K3 能在全书中定位相关知识并给出连贯解释
- 跨章节知识关联:当学生问"第三章的概念和第七章有什么关系"时,K3 可以同时加载两个章节进行分析
- 文献综述辅助:上传 20 篇论文,K3 可以综合回答"这些研究的主要分歧点是什么"
实测:加载《统计学习方法》(李航,约 30 万字)进行答疑
学生:请解释支持向量机中的核技巧,并说明它与第三章
感知机的联系和区别。
K3:
【核技巧的核心思想】
核技巧(Kernel Trick)允许我们在高维特征空间中计算内积,
而无需显式地将数据映射到高维空间…
【与感知机的联系】
如第三章所述,感知机是线性分类器,其决策边界为超平面
w·x + b = 0。SVM 在感知机的基础上引入了两个关键扩展:
1. 最大化间隔(Margin Maximization)…
2. 核函数的引入使非线性可分问题得以解决…
【关键区别总结】
| 维度 | 感知机 | SVM |
|——|——-|—–|
| 优化目标 | 最小化误分类点 | 最大化间隔 |
| 解的唯一性 | 不唯一 | 唯一(对偶问题) |
| 非线性支持 | 不支持 | 通过核函数支持 |
5.3 知识问答的"幻觉"风险
尽管 K3 的准确率很高,但在教育场景中仍需警惕"幻觉"——即模型自信地给出错误答案。
常见幻觉类型:
防范策略:
# 知识问答安全 Prompt
SAFE_QA_PROMPT = '''请回答以下问题。如果存在以下情况,请明确说明:
1. 你的知识可能已过时(训练数据截止日期之后的新进展)
2. 答案存在学术争议,不同学派有不同观点
3. 你需要做假设才能回答,请明确列出假设
4. 你不确定答案,请直接说"我不确定"
问题:{question}
'''
六、适应性教学:K3 最大的短板

适应性教学(Adaptive Learning)是 AI 教育的圣杯——根据学生的知识水平、学习风格和进度动态调整教学内容。在这个维度上,K3 的表现只能算及格(82 分)。
6.1 K3 的适应性能力
能做到的:
- 根据 Prompt 中的"学生年级"调整解释深度(如"用初中生能听懂的语言解释")
- 多轮对话中根据学生的追问调整回答方向
- 识别学生的常见错误模式并给出针对性提醒
做不到的:
- 没有长期记忆:关闭对话后,K3 无法记住学生的学习历史和薄弱环节
- 无法评估掌握度:K3 不能设计测试题来诊断学生的知识盲区
- 缺乏情感感知:无法识别学生的挫败感或困惑,不能调整鼓励策略
6.2 与专业教育 AI 的对比
| 知识深度 | ★★★★★ | ★★★☆☆ |
| 分步讲解 | ★★★★★ | ★★★★★ |
| 学习跟踪 | ★☆☆☆☆ | ★★★★★ |
| 错题分析 | ★★★☆☆ | ★★★★★ |
| 情感支持 | ★★☆☆☆ | ★★★★☆ |
| 个性化路径 | ★★☆☆☆ | ★★★★★ |
结论:K3 是"知识渊博但健忘的家教",适合单次深度辅导,但不适合长期陪伴式教学。
七、综合评估:AI 家教靠谱吗?
7.1 靠谱的场景
7.2 不靠谱的场景
7.3 给家长和学生的实用建议
| 中小学生家长 | 用 K3 辅助作业答疑,但需家长/老师复核答案;不建议让低年级学生独立使用 |
| 大学生 | 论文润色和概念答疑的利器,但引用和逻辑需自行把关 |
| 研究生 | 文献综述和 GPQA 级问题咨询的优秀助手,但不能替代导师的学术指导 |
| 自学者 | 适合碎片化知识获取,系统学习仍需配合课程和教材 |
八、总结:K3 不是完美的家教,但是优秀的助教
经过数学辅导、论文润色、知识问答三个核心场景的实测,Kimi K3 在教育领域的表现可以总结为:知识深度顶尖,教学温度不足。
它的 93.5 分 GPQA 成绩和 100 万 Token 上下文让它成为当前最强的"知识库型"AI 助手,在答疑解惑、论文润色、长文档分析上具有不可替代的优势。但适应性教学的短板(缺乏长期记忆、无法跟踪学习进度)意味着它更适合作为真人教师的助教,而非替代品。
对于教育行业来说,K3 最大的价值在于降低优质教育资源的获取门槛——一个偏远地区的学生,可以通过 K3 获得接近顶尖大学研究生水平的知识答疑。这种"教育平权"的意义,可能比技术参数本身更加深远。
声明:本文数学辅导测试基于 140 道自编题目(涵盖初中到大学难度),论文润色测试基于 5 篇不同学科的真实论文摘要,知识问答测试基于 GPQA Diamond 公开样本。所有模型在同一 Prompt 和温度参数下测试。教育效果因人而异,建议将 AI 作为辅助工具而非唯一依赖。本文不构成任何商业推广。
转载自:https://blog.csdn.net/sghtgjfhv/article/details/163627207 欢迎 👍点赞✍评论⭐收藏,欢迎指正


