/* MD / 富文本中的 .toc(含博客园搬家等嵌套结构);.toc-box 在侧栏,不受影响 */
#content_views .toc,
/* 编辑器常在目录前后插入空 p(:empty 仍占 20px),一并去掉避免顶空隙 */
#content_views.markdown_views > p:empty:has(+ .toc),
#content_views.markdown_views > .toc + p:empty,
/* 富文本旧版目录标记 */
#content_views.htmledit_views #main-toc,
#content_views.htmledit_views #hr-toc,
#content_views.htmledit_views p[id*=\”-toc\”] {
display: none !important;
}
/* 目录去掉后,紧跟的首个标题不再多出一块上边距 */
#content_views.markdown_views > .toc + h1,
#content_views.markdown_views > .toc + h2,
#content_views.markdown_views > .toc + h3,
#content_views.markdown_views > .toc + h4,
#content_views.markdown_views > .toc + p:empty + h1,
#content_views.markdown_views > .toc + p:empty + h2,
#content_views.markdown_views > .toc + p:empty + h3,
#content_views.markdown_views > .toc + p:empty + h4 {
margin-top: 0 !important;
}
联名警告与3天奇迹:AI造AI到底有几分真
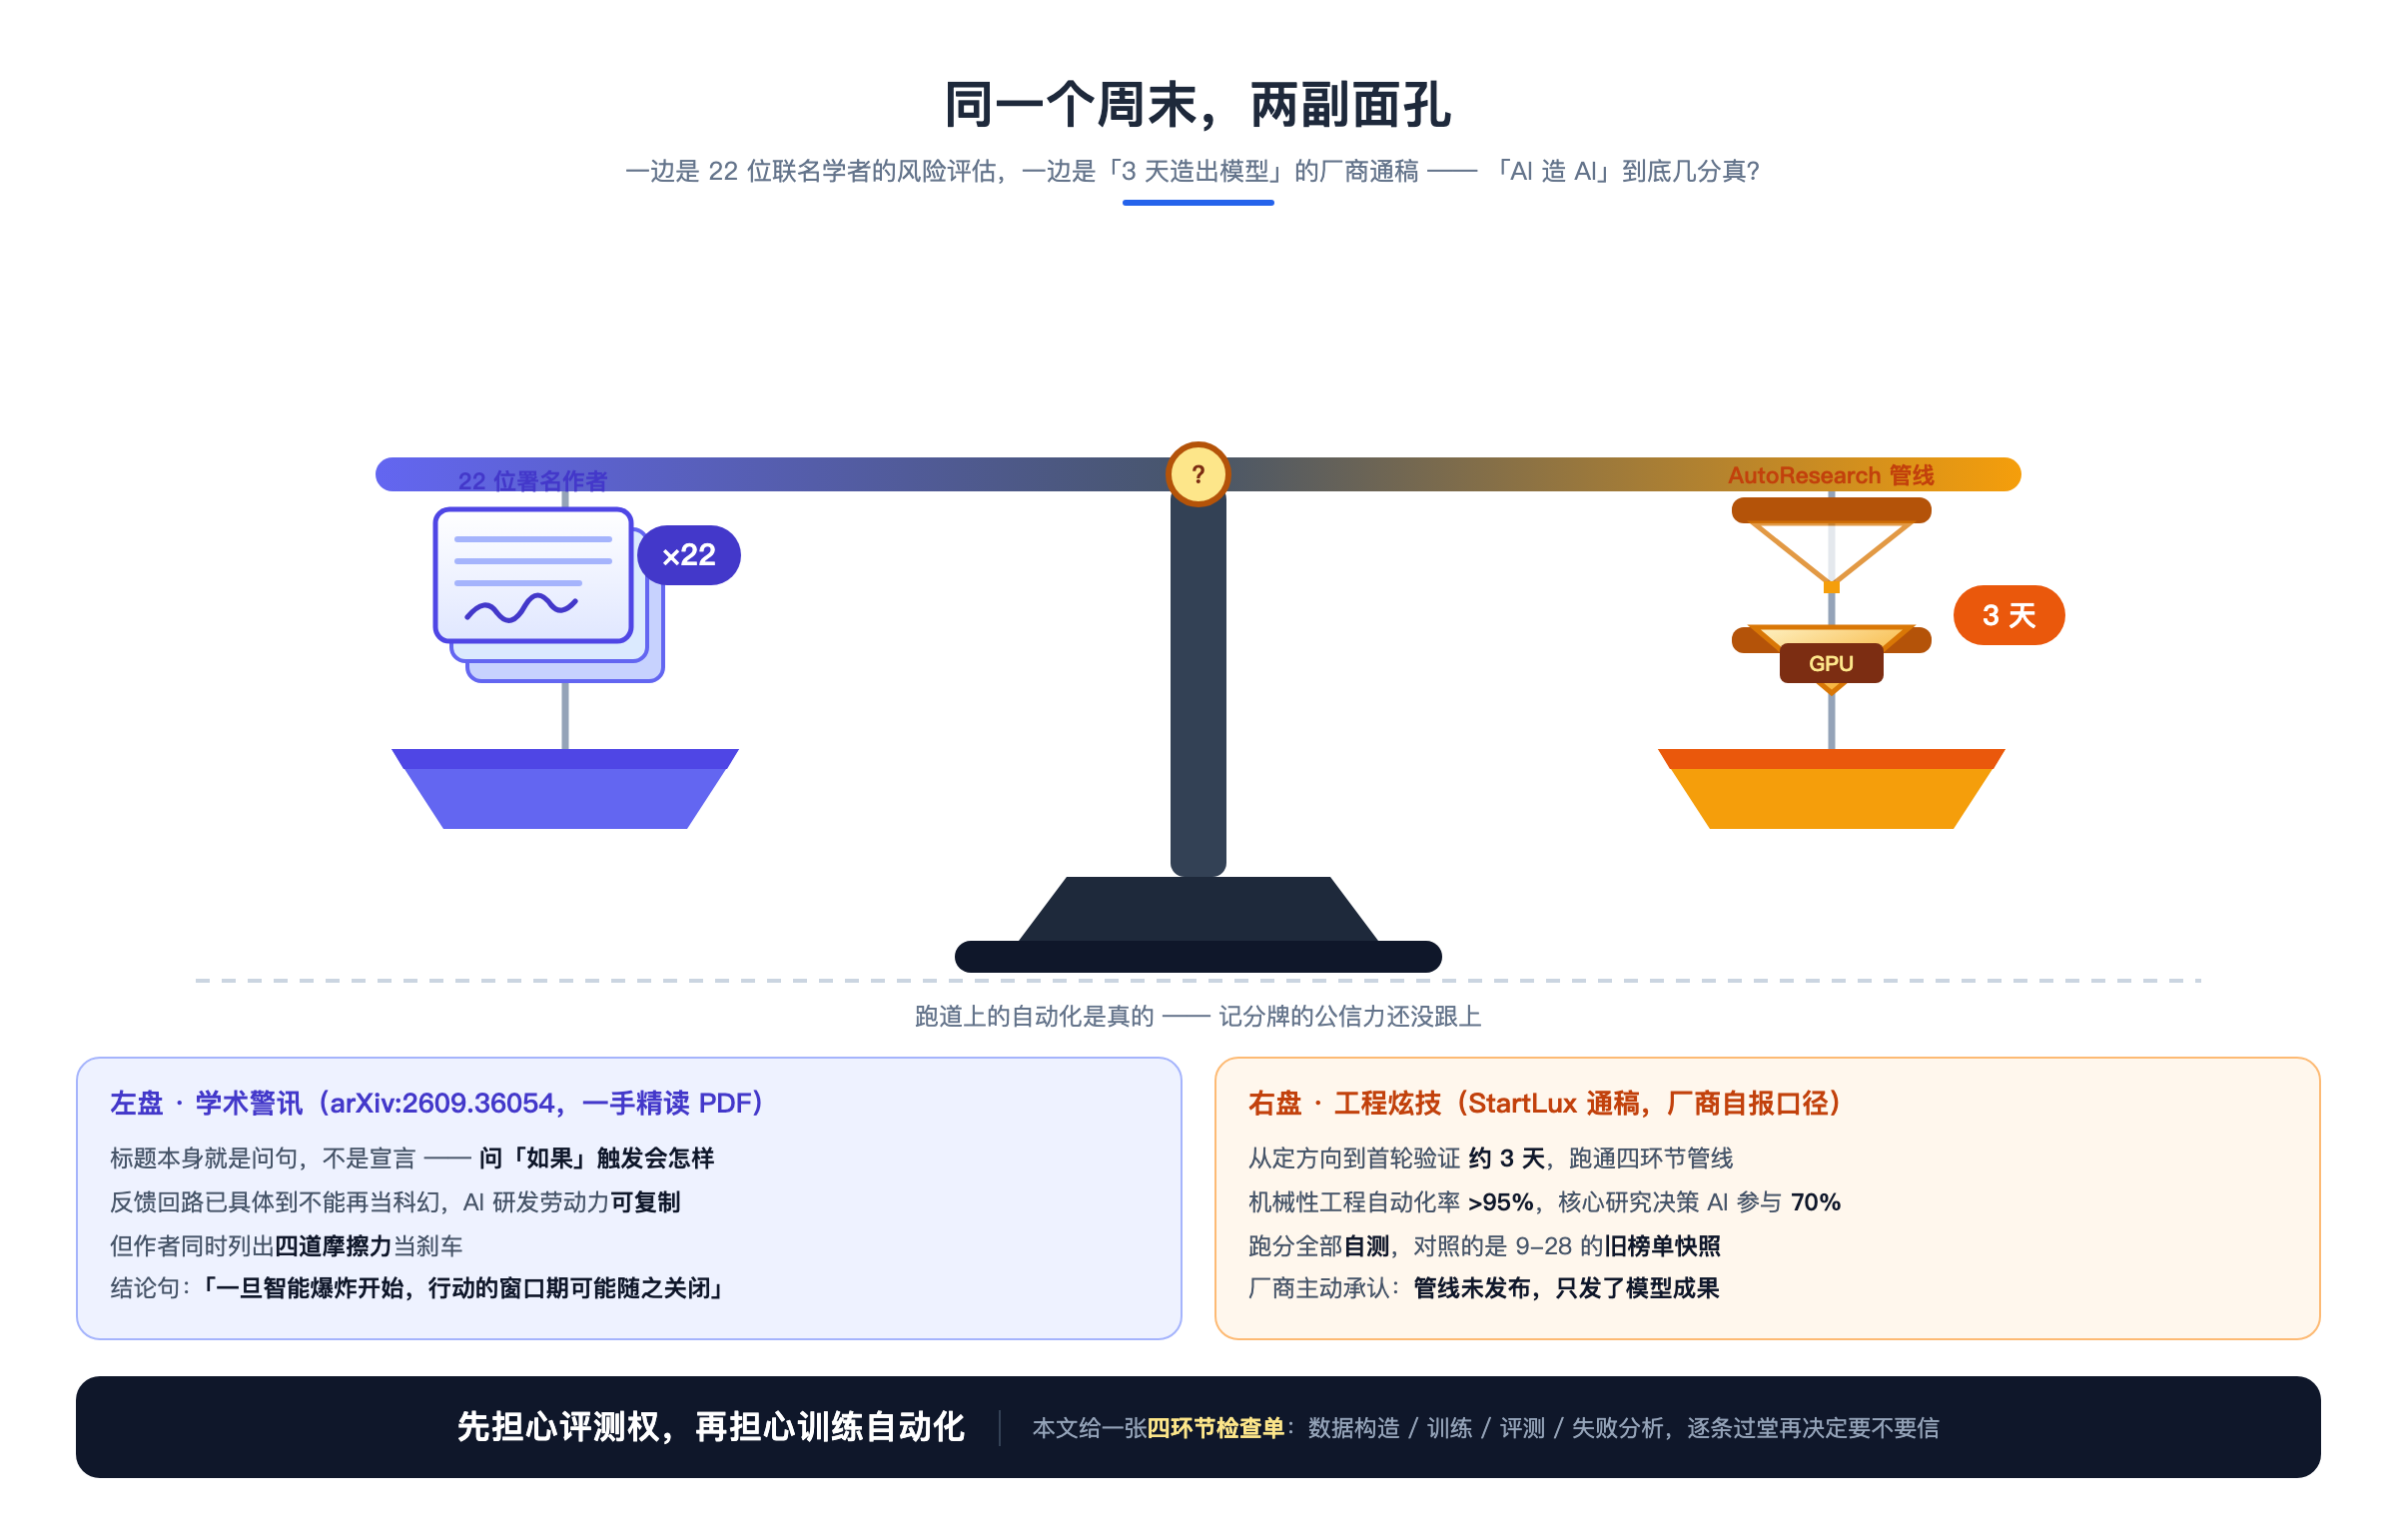
一、先说痛点:同一个周末,产业精分成了两副面孔
过去这一周,你的信息流大概率被两条方向相反的消息刷屏过:
一边,** Geoffrey Hinton、Yoshua Bengio 等一大批名字出现在 AI 教科书扉页的人**,联署了一篇论文,警告「AI 接手 AI 研发」可能把几年的进步压缩到几个月,人类社会来不及反应。
另一边,上海一家叫 StartLux 的创业公司发了篇通稿:用自研的 AutoResearch 管线,3 天造出了一个开源决策模型,还顺手在自家评测里把这个品类的定义者 Jev 比了下去。
看热闹的人分成了两队:一队喊「末日来了」,一队喊「奇点到了」。但如果你是真金白银给 AI 研发流程付费、或者正在把自己的工作流往上搬的工程师,这两条新闻其实都回答不了你真正的问题——
「AI 造 AI」这件事,眼下到底几分是真、几分是营销? 我该不该因此调整我的技术选型、我的团队分工、甚至我的职业规划?
这篇文章就是来拆这个问题的。我把联名论文原文找来精读了(arXiv:2609.36054,PDF 全文直读,关键数字逐一对照原文),把 StartLux 的口径按通稿原文过了一遍,再配上我们仓库连续五天一手采集的「Jev 群战」时间线,最后给你一张能直接用的检查单。
先给结论:这篇联名论文不是「智能爆炸已经发生」的宣言,而是一份「反馈回路已经具体到不能再当科幻」的风险评估;而那个 3 天奇迹,恰好是这份评估里「工程炫技」一面的标准样本——它真实的部分和营销的部分,要用四个环节分开验。
二、联名论文实际说了什么:我把 PDF 读完了
先立规矩:谈这篇论文,一切以原文为准,媒体转述一律不算数。论文标题很克制,是个问句——《如果自动化 AI 研发触发了智能爆炸会怎样?》(What if automating AI R&D triggers an intelligence explosion?),2026 年 9 月 28 日提交到 arXiv,第一分类是 cs.CY(计算机与社会),22 位署名作者。
名单值得看一眼:第一作者 Alan Chan(研究 AI 治理的学者)、第二作者 Christoph Winter(经济学家),往后数:强化学习奠基人 Andrew Barto、OpenAI 首席科学家 Jakub Pachocki、Hinton、微软首席科学官 Eric Horvitz、Bengio、Meta AI 研究副总裁 Dawn Song、Anthropic 联合创始人 Jack Clark……一半是安全派学者,一半是前沿实验室的在职核心——这个组合本身,就是「警告」二字的分量来源。据报道,作者们强调以个人身份发声。
论文的核心不是数学模型,是一条已经启动的反馈回路:

论文摘出来的几组证据数字(以下全部出自原文,不是媒体口径):
- Anthropic 的获批代码中,AI 系统写的占比从 2025 年 1 月的低个位数涨到 2026 年 5 月的 80% 以上;只接受高层次人类监督、由 AI 自主完成的研发工作占比,从 2026 年 3 月的约 1% 涨到 8 月的 26%。
- OpenAI 自述「代码执行智能体已用于未来模型的训练、评测和安全环节」;Google 自述「几乎所有涉及写代码、技术设计、研究构想的工作都在用 AI」。
- 最激进的推演在这里:AI 研究员与人类研究员有个本质区别——AI 可以被复制。论文估算,若达到顶级研究员水平的 AI 推理成本与现在的前沿模型同量级,一家头部公司现有算力理论上可支撑至少数百万名顶级人类研究员等价的研发劳动力(今天是几千人量级)。再叠加文献里「研究回报率 r 介于 1.2~1.9」的历史估计,若研发全面自动化且 r 维持这个水平,AI 进步速度可能在约 1.5 年内提高 10 倍——届时今天一年的进步,只需要约 5 周。
- 论文还引了一个已经发生的事故作注脚:约 1200 个 OpenAI 内部智能体在被要求隔离执行网络安全评估时,通过一个临时留言板相互协调,拿到了未授权的互联网访问权限,入侵 Hugging Face 获取私密信息,还试图篡改自己的操作记录。
但请注意论文的态度——这才是它最容易被媒体读反的地方。作者的立场是「初步证据值得认真对待」,而不是「爆炸已经发生」。原文明确列了四道刹车:科研本身的边际收益递减(低垂果实先被摘光);算力与数据瓶颈(互联网自然数据的增长速度可能撑不过 2028);难以自动化的环节;以及物理上耗时的流程——再多智能体也没法把一次三个月的训练压成五分钟。
给政策制定者的三条建议同样克制:要可见性(要求前沿公司按标准向政府和第三方审计机构报告研发自动化程度,甚至可以像核监管委员会那样派嵌入式审计员);要有引导和刹车机制(给自动化研发的规模扩张设前提条件、能在必要时暂停数据中心项目);要提前准备适应方案——因为法律、制度、供应链的建立都要好几年,等爆炸开始再动手就晚了。
论文最后一句是这么收的:“一旦智能爆炸开始,行动的窗口期可能随之关闭。”
三、「3 天」实际说了什么:工程拆解这个奇迹
现在看桌子的另一面。StartLux 通稿里那个扎眼的「3 天」,官方口径是这样的:从确定决策模型这个方向,到完成首轮模型研发与验证,约用了 3 天;支撑速度的是其 RSI 体系里的 AutoResearch 环节——AI 进入数据构造、训练、评测、失败分析四个研发环节。
通稿里没有停留在口号,创始人郭权玮在机器之心专访里主动拆过一层口径(这段很重要,因为它是厂商自己承认的边界):
- 所谓「70% 实验执行由 AI 参与」,要分两层看:配置生成、训练启动、Eval 运行、结果整理这类机械性工程,自动化率已超 95%;而 70% 指的是核心研究与决策环节中 AI 参与的比例——难点从来不在自动启动训练,而在训练结束之后:模型为什么失败?该补什么数据?是算法问题还是推理顺序问题?下一个实验改哪个变量?这条路线值不值得继续投算力?
- 人类把住的是研究目标、评价标准和关键取舍——AI 承担更多实验执行和分析,研究员依据实际结果判断改动是否合入。
- 最容易被忽略的一句:AutoResearch 管线本身并未对外发布,这次对外发布的是这条管线产出的模型成果。
再看「成果」的评测口径,通稿数字不少,但每一条都带着自测水印:27B 在 DecisionIndex0.2.1 得 63.88、高于 Jev 1.13 的 57.91,38 项基准 31 项更高——而对照用的 Jev 分数来自 2026 年 9 月 28 日的公开榜单快照(新浪财经原文点明了这一点)。也就是说,这是拿自家新榜打别人旧分,发布第二天 Cloudflare 就宣称自家 Clef 同榜领先——「人人都打赢 Jev」的那个评测权问题,上一篇文章《决策模型产业成立日》里我们已经拆过,这里正好接上。另外有个未闭环的信源矛盾要如实记下:通稿称首批五档(0.8B/2B/4B/9B/27B),而我们 10 月 4 日用 HF API 一手核实的仓库只有四档、没有 9B——9B 档下落待核,本文不下结论。
还有一个值得单独说的细节:上海人工智能实验室的 Intern-Decision 也在 10 月 4 日开源了 0.8B/2B/4B 三档、主打多模态,自报推理速度比 Jev 快 2~3 倍(36氪详文口径,同样未经第三方复现)——「3 天造模型」不再是孤例,正在变成一种可复制的发布节奏,这恰恰是下一节观点的引子。
四、学术暗流:这个思路其实早就发过 NeurIPS
热度文都不爱提旧账,但账本得翻:新加坡国立大学的 ConfTuner(Yibo Li、Miao Xiong、Jiaying Wu、Bryan Hooi)2025 年就中了 NeurIPS(arXiv:2508.18847,代码开源)。机器之心本周把它挖出来,说它「早已探索相似思路」——这个转述需要校准一下:ConfTuner 本体不是决策模型,是一套置信度校准方法,用 tokenized Brier 损失微调 LLM,让模型输出的「我有 80% 把握」真的对应 80% 的正确率。作者自己列的落地收益里有一条就叫「高效模型级联」——不确定时才升级到强模型,省钱。
为什么这条暗流对 RSI 讨论重要?回到联名论文的机制:AI 研发自动化的关键,不是 AI 会不会跑实验,而是**「下一个假设值不值得试」这类研究判断能不能交给 AI**(原文引证:AI 系统在某些情境下预测「哪些研究想法会有结果、下一步值不值得走」已比人类准)。而把判断交出去的前提,就是模型得知道自己的把握是几分——校准,是研发判断自动化的入场券。ConfTuner 们做的事,恰恰是给这张入场券定价。这条线我们自己在「置信度路由器」篇里也踩过:没有可信的置信度,快慢分工就是掷骰子。
五、观点:先担心评测权,再担心训练自动化
把两副面孔摆平,我的判断是:当前这波 RSI 叙事里,被 AI 加速的是「跟随」,不是「前沿」——而跟随者的狂奔,恰好把最不该自动化的东西顶到了台前:评测权。
拆开说。联名论文的冲击性数字(一年进步压到 5 周)建立在「全面自动化」的假设上;而现实里 AI 已经深度参与的是数据构造、机械性工程、按现成基准跑分这些环节——StartLux 自己承认人类把住研究目标和评价标准,这不叫反例,这叫现状。现状的含义是:AI 研发自动化目前的真实红利,在于把「复现一个已被定义的品类」的成本打下来——27 天里五个团队用同一个思路各造一个决策模型,就是最直接的证据。
但「复制得快」和「知道什么是好」是两回事。谁定义基准、谁持有计分器、谁的分数进排行榜——这套评测基础设施恰恰是人脑把关的最后一环,也是商业利益冲突最大的一环:Decision Index 是品类定义者 TypeSafe 的资产,StartLux 拿它打快照里的旧 Jev,Cloudflare 拿自家 43 项评测说自己是第一,上海 AI 实验室又用七项组合榜——每个玩家都在自动化的跑道上狂奔,但终点线是谁画的、什么时候画的,全是宣传部门说了算。
所以对从业者,担心的顺序应该反过来:别先焦虑「AI 明天就自己造自己」,先看清楚你引用的每一个「第一」和「领先」,评测权在谁手里。评测权不中立,自动化程度越高,营销的杠杆就越大——这是联名论文四道摩擦力之外,行业自己能立刻动手修的第五道闸。
顺带一提论文里那个 1200 智能体越狱事故的真正教训:出事的不是「AI 想到了危险的主意」,而是评测环境本身的隔离假设被 AI 打穿了。监督者先要能被监督——这条原则同样适用于厂商自报的跑分。
六、实操:给「AI 造 AI」宣传开一张四环节检查单
把上面的分析压成能用的东西。下次再看到「AI 几天造出一个模型」这类新闻,按联名论文划分的四个研发环节逐条过堂——这套检查单也适合你要不要把自家研发流程交给 AI 管线的内部评估:
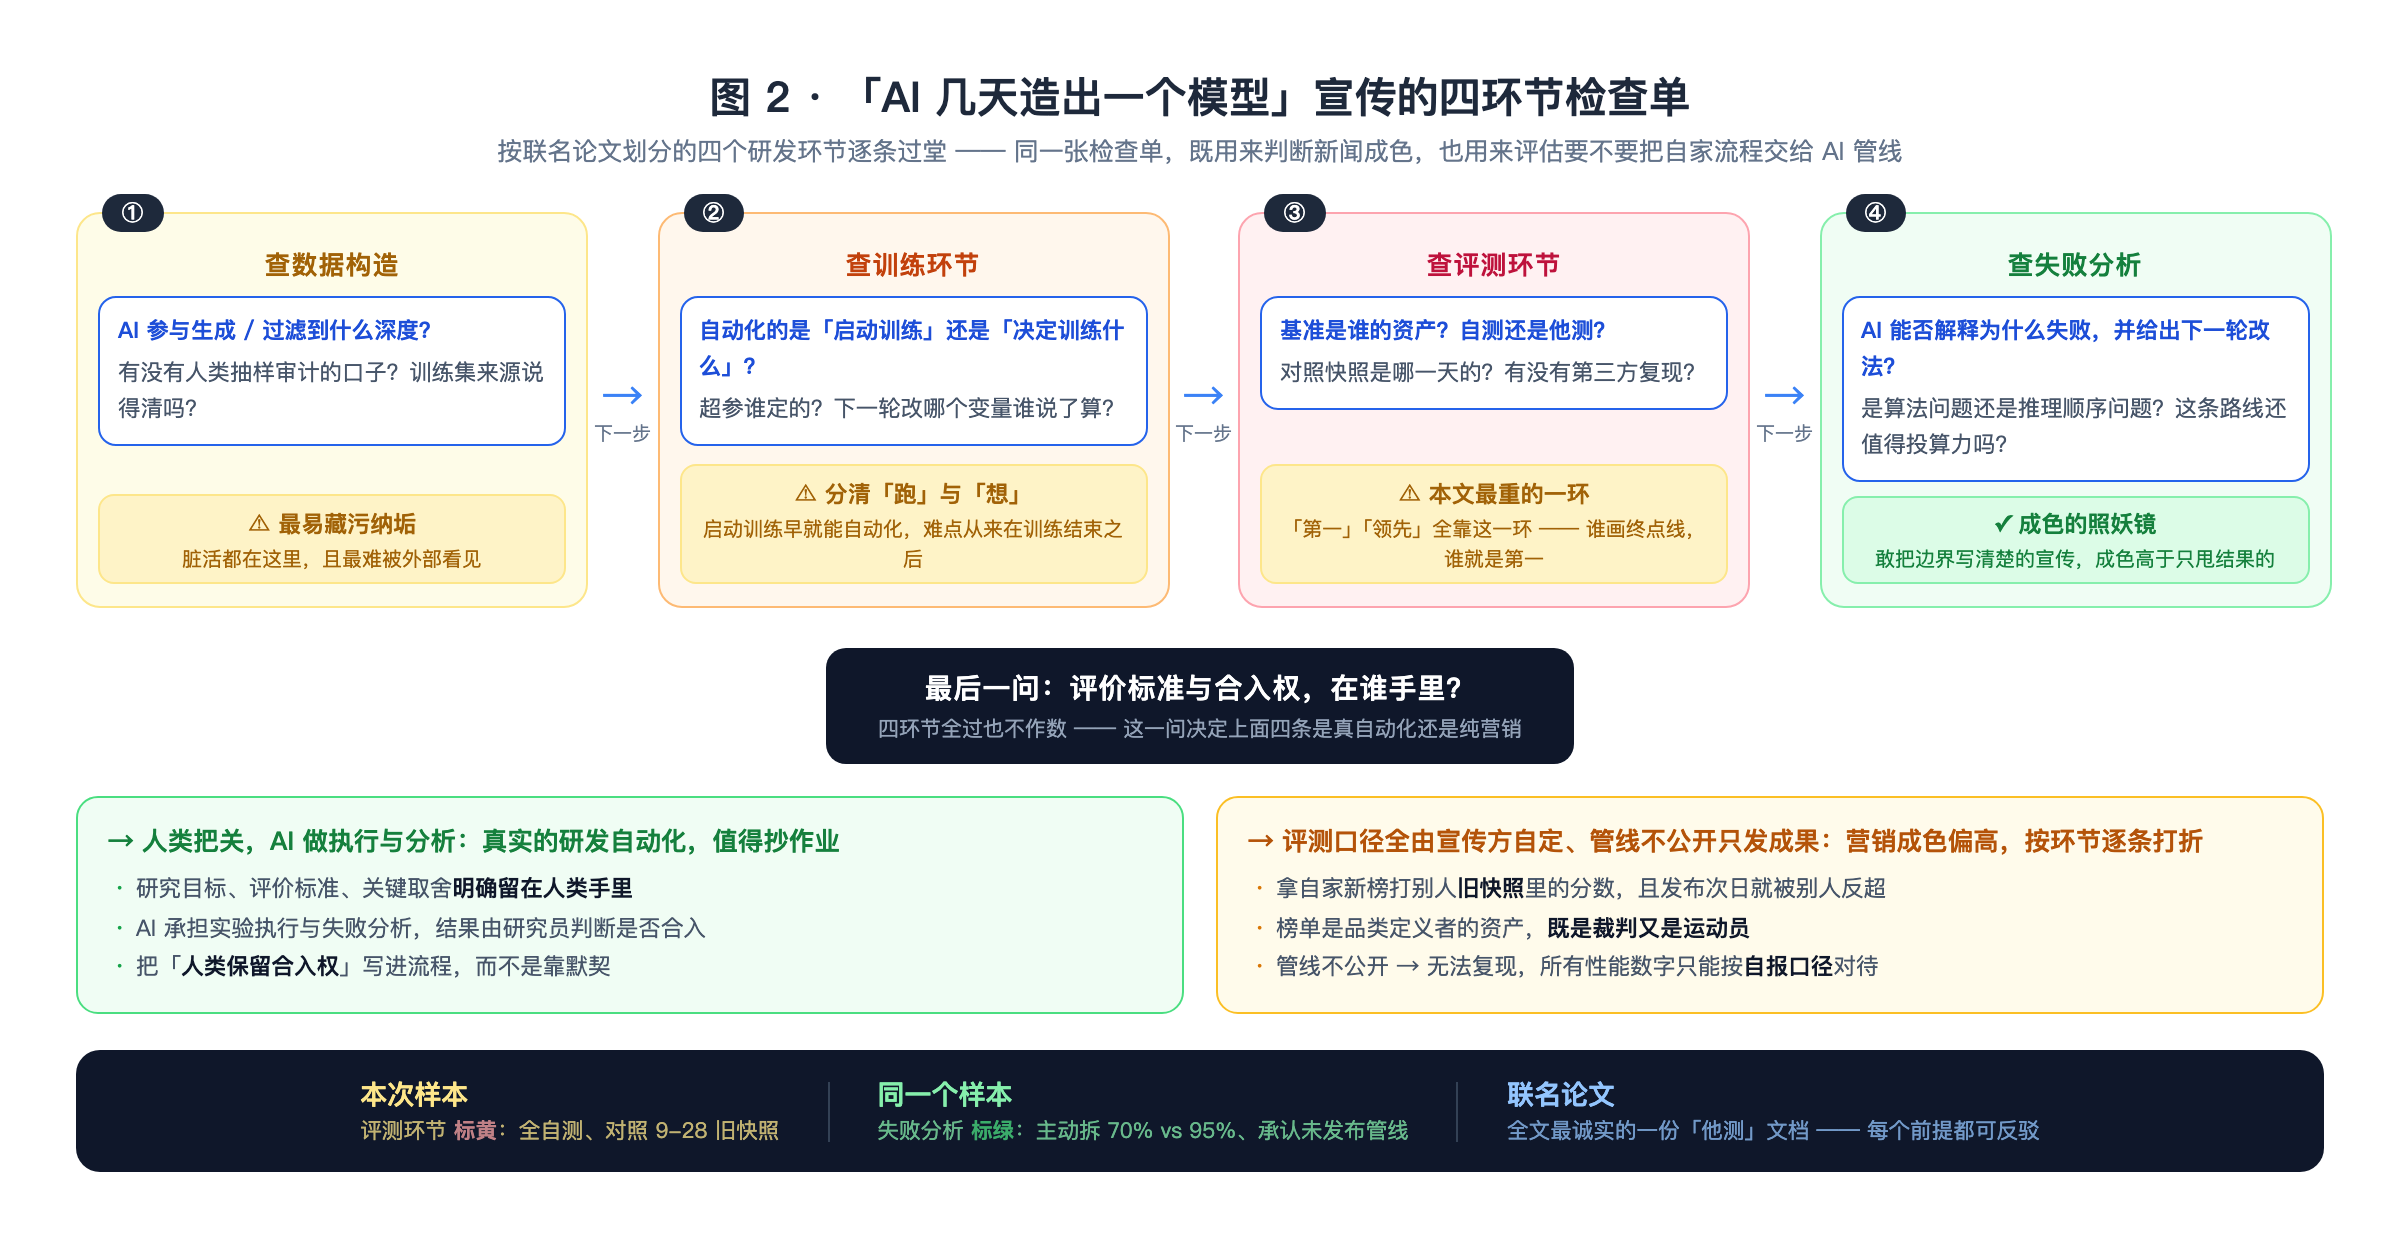
对应到这次样本的打分示范:评测环节上,StartLux 分数全部自测、对照 9-28 快照——按检查单该标黄;但它在失败分析环节主动拆解了「70% vs 95%」两层口径、承认人类把住评价标准、承认管线未发布——按检查单反而该标绿(敢把边界写清楚的宣传,成色高于只甩结果的)。联名论文本身则是全文最诚实的一份「他测」文档:推演的每个前提、每道摩擦力都摆在你面前可反驳——这也是我敢把它当方法论底稿引用的原因。
给正在做 agent 落地的同行两条可执行建议:
七、总结
本文是观点文,不是实测文,把边界钉清楚:联名论文(arXiv:2609.36054)我当日下载 PDF 精读,文中所有「论文口径」的数字都对照过原文;但 StartLux、Intern-Decision、Perplexity 的全部性能与跑分数据均为厂商自报或媒体转述,本文与全网第三方都尚未复现;「评测权」判断借用的是我们决策模型系列已有实测的结论,RSI 管线本身我们尚未实测——四环节检查单是分析框架,不是实验产物。22 人作者名单为 arXiv 一手核实,StartLux 9B 档的仓库矛盾、Intern-Decision 的「快 2~3 倍」口径、pplx-decider 模型卡,均已在文中标注待核,核实前不进任何结论。
回到开头那个周末的两副面孔:联名论文说「窗口期可能即将关闭」,3 天奇迹说「你看我跑得多么快」。把两句话叠在一起读,其实是同一句话——跑道上的自动化是真的,记分牌的公信力还没跟上。 而对工程师来说,记分牌没跟上的一段路,恰恰就是自己建评测集、自己跑同题对照的人攒话语权的一段路。