自律是普通人最大的武器
| 🐧 Linux | 进入专栏 → |
| 🔤 C语言 | 进入专栏 → |
| 🔧 C++ | 进入专栏 → |
| 🐬 MySQL | 进入专栏 → |
| 🧩 算法刷题 | 进入专栏 → |
🏠 博客主页:虚无的纽扣 📦 作者仓库:github | gitee
目录
- 引言
- 1、什么是线程
- 2、Linux 是怎么“造”出线程的
- 3、为什么要这样设计
- 4、理解资源划分:从页表说起
-
- 页框与 struct page
- 页目录与页表
- MMU 与缺页中断
- 资源划分的本质
- 5、线程的优缺点与私有数据
-
- 优点
- 缺点
- 线程异常与私有数据
- 结语
引言
进程系列写到今天,从进程概念、进程地址空间、进程控制,到进程间通信和信号,我们把“进程与进程之间”的事情基本聊完了。这篇换个方向,往进程内部看一眼:一个进程里面,还能不能再“分”出多条执行流?这就是线程。 线程的内容我们分两篇:上篇讲概念——线程是什么、Linux 是怎么把它造出来的、它凭什么比进程轻;下篇讲控制——怎么创建、等待、终止和分离一个线程,以及 pthread 库的内部到底长什么样。
1、什么是线程
先从教材定义来看。进程 = 内核数据结构 + 自己的代码和数据(执行流);线程,则是进程内部的一个执行分支(执行流)。再换个角度:从内核和资源的角度看,进程是承担分配系统资源的基本实体——不管是内核数据结构还是代码和数据,都要占据内存资源、CPU 资源,所以进程一定要消耗系统的资源;而线程,是 CPU 调度的基本单位。 这两个定义放在一起就很有意思了:资源分配的时候,我们以进程为单位来分;真正上 CPU 跑的时候,调度的是线程。也就是说,一个进程内部是允许多条执行流存在的,它们共同瓜分这个进程拿到的资源。 还有一句话要记住:进程强调独占,部分共享(比如通信的时候);线程强调共享,部分独占。这句话是理解线程所有行为的基础,后面讲优缺点、讲线程库的时候,都会回到它。
2、Linux 是怎么“造”出线程的
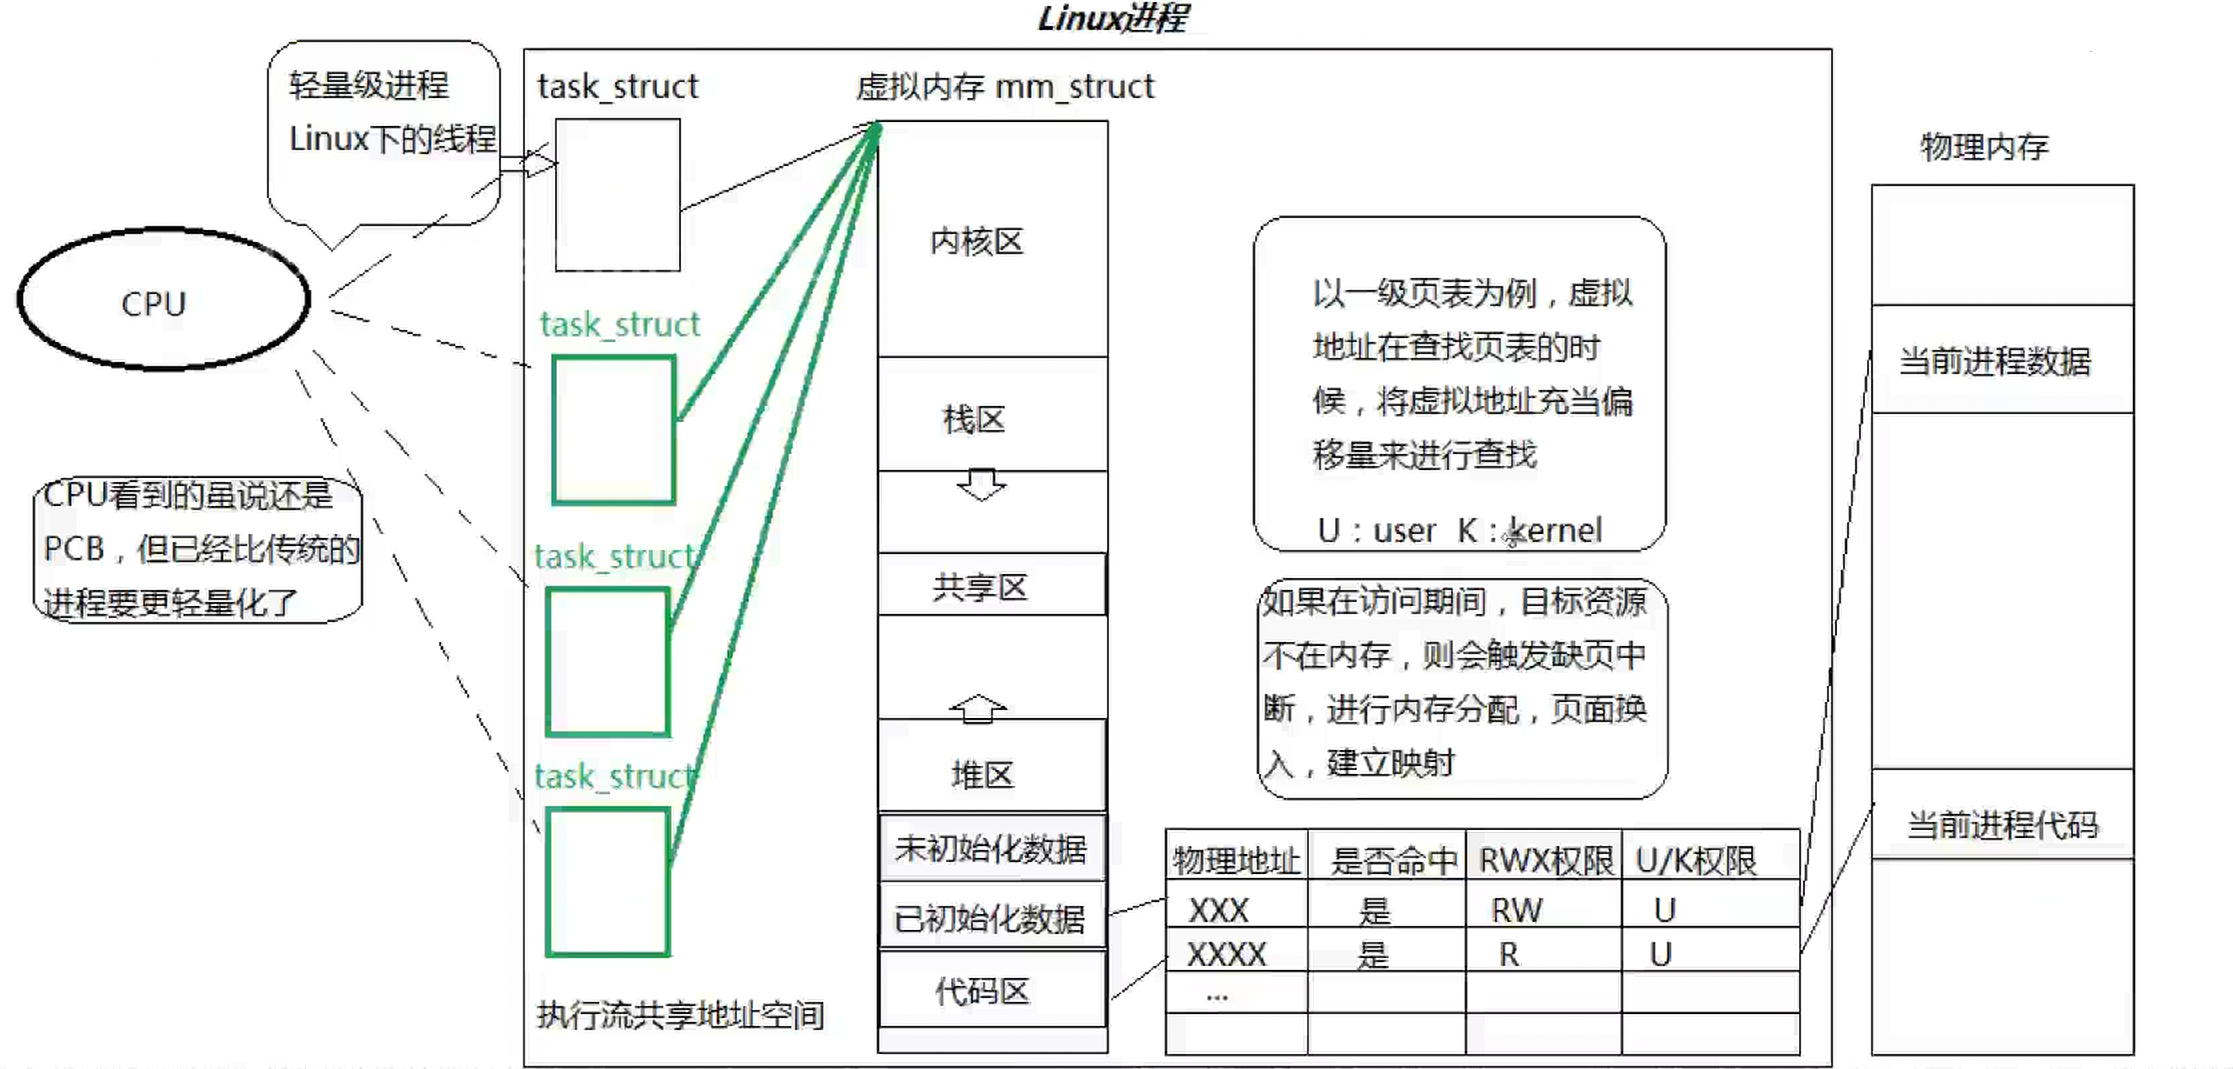
进程访问的大部分资源,都是通过地址空间访问的——地址空间就是进程访问资源的“窗口”,每一个进程的“窗口”都是独立的,都指向自己的资源。那如果创建一个“进程”,让它与其他“进程”共享“窗口”呢?这样就不需要创建独立的地址空间和页表,只需要让所有新创建的“进程”指向同一个地址空间,那么所有的“进程”就可以看到同一份资源,再将资源分配给不同的“进程”,我们就用进程模拟出来线程了! 而资源分配,本质就是划分地址空间,就是划分虚拟地址:只要将代码区划分成不同的小块,再分配给不同的“进程”,再将页表也划分成对应的小块,每一个“进程”就可以拿着这一块代码并行运行了。代码段如此,其他部分同样可以如此——将整个进程的资源划分成不同的子区域,分配给每一个对应的、比较细的执行流,这就是 Linux 设计的线程。 先给四条结论:1、Linux 的“线程”可以采用进程来模拟;2、对资源的划分,本质是对地址空间、虚拟地址范围的划分,虚拟地址就是资源的代表;3、代码区怎么划分?函数就是虚拟地址空间的集合,本质就是让线程未来执行 ELF 程序中不同的函数即可;4、那怎么面对之前讲的进程呢?其实并不冲突——之前讲的进程,都是在内部只有一个线程的前提下的。第 4 条尤其重要,它意味着我们学过的进程知识到线程这里几乎全部适用,只是视角变了。
3、为什么要这样设计
那为什么要这样设计?其他平台也是这样吗?比如 Windows,就是另一种方案。Windows 的程序员在设计线程时,专门设计了一个数据结构来描述线程。但线程的数量会比进程数量多很多,这就会导致整个系统的复杂性变得更高,效率就会变低,健壮性也会不高。 而 Linux 的程序员认为,线程的功能与进程的功能相似性足够高,没有必要专门设计一个数据结构来描述线程——只需要复用 task_struct,用进程来模拟线程,这样进程的内核代码就可以全部复用,不需要再设计一套属于线程的代码,成本会更低,效率也会更高。 所以,构成整个大进程的这一个个小“进程”(task_struct),在 Linux 系统中就叫做轻量级进程。Linux 的线程就是轻量级进程,或者说是用轻量级进程模拟实现的,并没有真正意义上的线程。而线程,就在进程地址空间内运行。
4、理解资源划分:从页表说起
页框与 struct page
既然线程的资源划分本质是划分地址空间,那我们就得把地址空间背后的机制看清楚,从物理内存说起。这一节要讲明白的其实就一件事:分资源,说到底是分虚拟地址范围、分页表条目。物理内存被操作系统划分为一个个 4KB 大小的数据块,可执行程序在磁盘上存储的时候,也是以 4KB 为单位存储的,所以物理内存在与磁盘进行数据交换的时候,是以 4KB 为单位进行 I/O 交换的,这个 4KB 大小的存储空间叫做页框或者页帧。 一般物理内存都是 4GB,划分为 4KB 大小的页框,就会有 1048576 个单位。这些页框的作用多种多样:有被用来存放进程数据的,有充当共享内存的,还有作为管道文件的。所以操作系统需不需要对它们进行管理?肯定要。因此必须有一个描述这 4KB 内存所对应的结构体,这个结构体叫做 struct page。 将所有 page 放进一个数组里,操作页框就转换为对数组的操作了。每一个 page 都有下标,只要知道了 page 的下标,就知道了页框的起始物理地址——具体物理地址 = 起始物理地址 + 页内偏移地址。所以申请物理内存,本质就是在查数组、改 page、建立内核数据结构的对应关系。 此外,我们之前讲进程的时候曾经说过,一个 task_struct 可以同时属于多种数据结构,既链入二叉树又链入链表;page 也是如此,如果我们将 page 链入哈希表、链入二叉树,这个 page 就被称为各种各样的缓存。
页目录与页表
物理内存这边有了 page 数组作索引,虚拟这边靠的就是页表。页表并不是单张的,因为存储空间不够。怎么理解“单张”?单张就是指用一个超级大的连续数组来覆盖全部虚拟页,不管用不用都全部分配——哪怕一个地址数据占 4 字节,把虚拟地址的全部地址都存进去的话,内存会远远大于 4GB,相当于把整个物理内存都占满了,所以不能是单张页表。 虚拟地址是用 32 位的数字来表示的,操作系统在查页表的时候,不会拿着虚拟地址整体去查。在 32 位下,系统在设计的时候,把前十个比特位当成一个整体,把中间十个比特位当成一个整体,把后 12 位当成一个整体。创建页表的时候,我们首先为当前进程构建一个只有 1024 个表项的表,用虚拟地址的前十位来索引它,这个表叫做页目录;页目录里的每一个表项保存的是下一级页表的地址。第二张页表的结构与页目录类似,这才是真正的页表,用虚拟地址的中间十位来索引,里面存的是页的地址,也就是物理地址,指向每一个页框的起始地址。 我们之前算过页框有多少个?1048576 个,就是 2^10 × 2^10 个;而页目录的表项数加上页表的表项数,也刚好是 2^10 × 2^10 个,就和页框一一对应了。这样我们就会有一个页目录,最多 1024 个页表。将一个地址看作 4 字节,将所有页表写满也才 4MB,比单张页表要少得多。 这么设计的核心目的是什么?虽然看上去,如果将所有的页表用一张大表统一实现,也可以做到上面的功能,但如果只开一张表,就必须在创建表的时候将 1048576 个单位一个不差地创建出来;问题是一个进程往往用不到这么多内存空间,往往只会用其中的一小部分,这样实现就会导致中间有很大一部分区域是空白的,白白浪费了内存。而像这样多级创建的话,就只需要创建我们需要部分的页表,其他部分的页表不需要创建,节省了很多空间。 经过查找页表,我们有了要访问地址的起始页框地址,这时候再拿着虚拟地址的低 12 位作为页内偏移,就可以精确找到我们要访问的那一个字节——低 12 位刚好表示 4096 个单位,而一个页框 4KB 也刚好是 4096 个字节,就可以实现任意一个字节的精确查找。为什么是低 12 位?因为地址在设计的时候是由低到高排序的,当两个数据属于同一个 4KB 的时候,它的前 20 位一定是一样的,后 12 位不一样,所以选择低 12 位来作为页内偏移。
MMU 与缺页中断
把查页表的过程串一下:1、先查找到虚拟地址对应的页框;2、再用低 12 位进行页内偏移,定位到要访问的那一个字节。那虚拟地址是由谁提供的?虚拟地址空间提供,既可以给用户,也可以给内核;只要找到页目录的起始地址,就可以找到整个页表的起始地址——怎么找到当前页表的起始地址?CPU 的 CR3 寄存器,指向的就是当前进程的页目录。 那 CPU 怎么访问具体的地址?CPU 还集成了一个组件 MMU,叫做内存管理单元,负责将虚拟地址转换为物理地址:CPU 将虚拟地址交给 MMU,MMU 用页表和虚拟地址进行查页表的工作,这个工作由 MMU 硬件转化来完成。 申请内存的全过程,其实就是这几步连起来:先去查找页框数组,从中挑出一个没有被使用的 page,拿到它的页框地址,再在内存里构建页表,最后把页框地址写进页表。写时拷贝、缺页中断、内存申请等等,背后都可能要重新建立新的页表和建立映射关系的操作!所以进程是由一张页目录 + n 张页表构建的映射体系:虚拟地址是索引,物理页框是目标,虚拟地址(低 12 位)+ 页框地址 = 物理地址。
资源划分的本质
绕了一圈,回到线程。执行流看到的资源,本质是:在合法情况下,你拥有多少虚拟地址——虚拟地址是资源的代表。虚拟地址空间(mm_struct 与 vm_area_struct)本质是进行资源的统计数据和整体数据,而页表,就是一张虚拟到物理的地图。 所以资源划分本质就是地址空间划分,资源共享本质就是虚拟地址的共享。线程进行资源划分:本质是划分地址空间,获得一定范围的合法虚拟地址,再本质一点,就是在划分页表;线程进行资源共享:本质是对地址空间的共享,再本质一点,就是对页表条目的共享。
5、线程的优缺点与私有数据
优点
先说优点。1、创建一个新线程的代价要比创建一个新进程小得多;2、线程占用的资源比进程少;3、能充分利用多处理器的可并行数量:计算密集型应用,为了能在多处理器系统上运行,可以将计算分解到多个线程中实现;I/O 密集型应用,为了提高性能,可以将 I/O 操作重叠,线程可以同时等待不同的 I/O 操作。 4、与进程之间的切换相比,线程切换只要求操作系统做更少的事。最主要的区别是:线程切换后虚拟内存空间依然是相同的,页表也是相同的,而进程切换则两者都不同。 这里还有两个隐藏的损耗,进程切换有、线程切换没有。一个是处理器缓存:上下文切换会扰乱处理器的缓存机制——一旦切换上下文,处理器中所有已经缓存的内存地址一瞬间都作废了。另一个是页表缓冲 TLB(快表):当你改变虚拟内存空间的时候,TLB 会被全部刷新,这将导致内存的访问在一段时间内相当低效,而线程切换不会出现这个问题。另外 CPU 里还有一个硬件 cache:当 CPU 需要读取数据时,它不仅仅是只读取那一个数据,而是根据 CPU 的缓存策略,将该数据周边的一部分数据都提前载入到 cache 中,这样下次再访问附近的数据时,CPU 就不用再去内存中读取,而是直接在 cache 里找,节省了很多时间;如果进行进程切换,cache 也会被全部刷新,下次运行就需要重新缓存,线程同样不会出现这样的问题。所以线程切换的成本低。
缺点
再说缺点。1、性能损失:一个很少被外部事件阻塞的计算密集型线程,往往无法与其他线程共享同一个处理器;如果计算密集型线程的数量比可用的处理器多,就可能有较大的性能损失——这里的性能损失指的是增加了额外的同步和调度开销,而可用的资源不变。2、健壮性降低:编写多线程需要更全面更深入的考虑,在一个多线程程序里,因时间分配上的细微偏差或者因共享了不该共享的变量而造成不良影响的可能性是很大的,换句话说,线程之间是缺乏保护的。 3、缺乏访问控制:进程是访问控制的基本粒度,在一个线程中调用某些 OS 函数,会对整个进程造成影响。4、编程难度提高:编写与调试一个多线程程序,比单线程程序困难得多。
线程异常与私有数据
再看线程异常。单个线程如果出现除零、野指针这类错误,CPU 会触发异常,内核再向进程投递信号,信号的默认动作是把整个进程终止——进程一终止,该进程内的所有线程也就随即退出。也就是说,一个线程出错,整个进程都会跟着受影响,这正是信号那两篇里"CPU 运行出错触发中断、操作系统发信号"那条线在这里的接续。 线程自己私有的数据有这些:线程 ID、一组寄存器、线程的上下文数据、栈、errno、信号屏蔽字、调度优先级。私有之外的部分就是共享的:整个地址空间——代码区、全局数据区、堆区,还有文件描述符表(也就是打开的文件),都是进程内所有线程一起看的。
结语
这节课我们把线程的概念立起来了:Linux 没有为线程单独设计数据结构,而是复用 task_struct,用轻量级进程模拟线程;线程的资源划分,本质是对地址空间、对页表的划分——虚拟地址就是资源的代表;它比进程轻的地方,也正好来自这份“共享”。有了概念打底,下一篇我们就动手:pthread 库从哪来、线程怎么创建、等待、终止与分离,以及库内部的管理块和线程 ID 到底是什么。 如果有哪里讲得不清楚,也欢迎各位大佬在评论区指正,我们一起把这些底层的东西啃透。以后我也会继续创作 Linux 方向的博客,如果觉得有帮助的话,希望各位大佬能三联关注支持一下,看到后我会进行回关和回访。