前言
现在很多 AI 爬虫都在强调“一句话生成”,但生成代码和生成可用数据并不是一回事。
真正决定爬虫能否投入使用的,是它能不能处理脏数据:中文与外文片名混在一起,导演和主演挤在同一行,年份、国家和类型用斜杠分隔,评价人数后面还跟着中文单位。
豆瓣电影 Top 250 正好提供了一个适合检验这些能力的真实场景。
因此,这次我不打算再写一篇常规的“豆瓣爬虫教程”,而是用 Bright Data Scraper Studio完成一次实际采集测试:
不手写选择器,只描述结果要求,看看 AI Agent 能否完成分页、中文字段拆分、数字转换和异常值处理。
最终目标不是“页面能打开”,而是输出一份可以直接进入 Excel、数据库或分析脚本的数据。
一、我给这次测试定了四条及格线
测试入口是豆瓣电影 Top 250:
地址:https://movie.douban.com/top250
我选择 Discovery 类型,只采集榜单页,不进入电影详情页。原因很简单:这次测试的是列表发现、分页和字段清洗,不是详情页采集。
在开始之前,我先设定了四条及格线。
1、能完整翻页
爬虫不能只抓第一页。它需要识别“后页”,持续访问后续分页,并在没有下一页时停止。
2、能拆开混排字段
榜单中的电影信息不是一列一个字段。导演和主演可能位于同一段文字中,年份、国家和类型也可能使用 / 分隔。
我希望最终得到独立的 directors、actors、year、regions 和 genres,而不是一段未经处理的原始文本。
3、能输出正确的数据类型
排名和评价人数应该是整数,评分应该是数字,导演、演员、国家和类型应该是数组。
如果所有内容都输出为字符串,虽然看起来“抓到了”,但后续排序、筛选和统计仍需要重新清洗。
4、遇到缺失值时不能串字段
不是每部电影都有一句话推荐或其他片名。某个字段缺失时,正确结果应该是 null 或空数组,而不是把相邻字段错误地填进来。
这四条标准比“成功输出 250 条记录”更重要。因为数量正确,并不代表数据正确。
二、第一轮,我故意只给 AI 一个简单要求
我先在 Bright Data Scraper Studio 中创建了一个 Discovery 爬虫,但没有一开始就写很长的规则。
第一轮 Prompt 只有这些内容:
请采集豆瓣电影 Top 250。 从 https://movie.douban.com/top250 开始, 自动访问后续分页,并提取每部电影的排名、片名、导演、主演、 年份、国家或地区、类型、评分、评价人数、一句话推荐和详情页链接。 输出结构化 JSON,共采集 250 条电影记录。
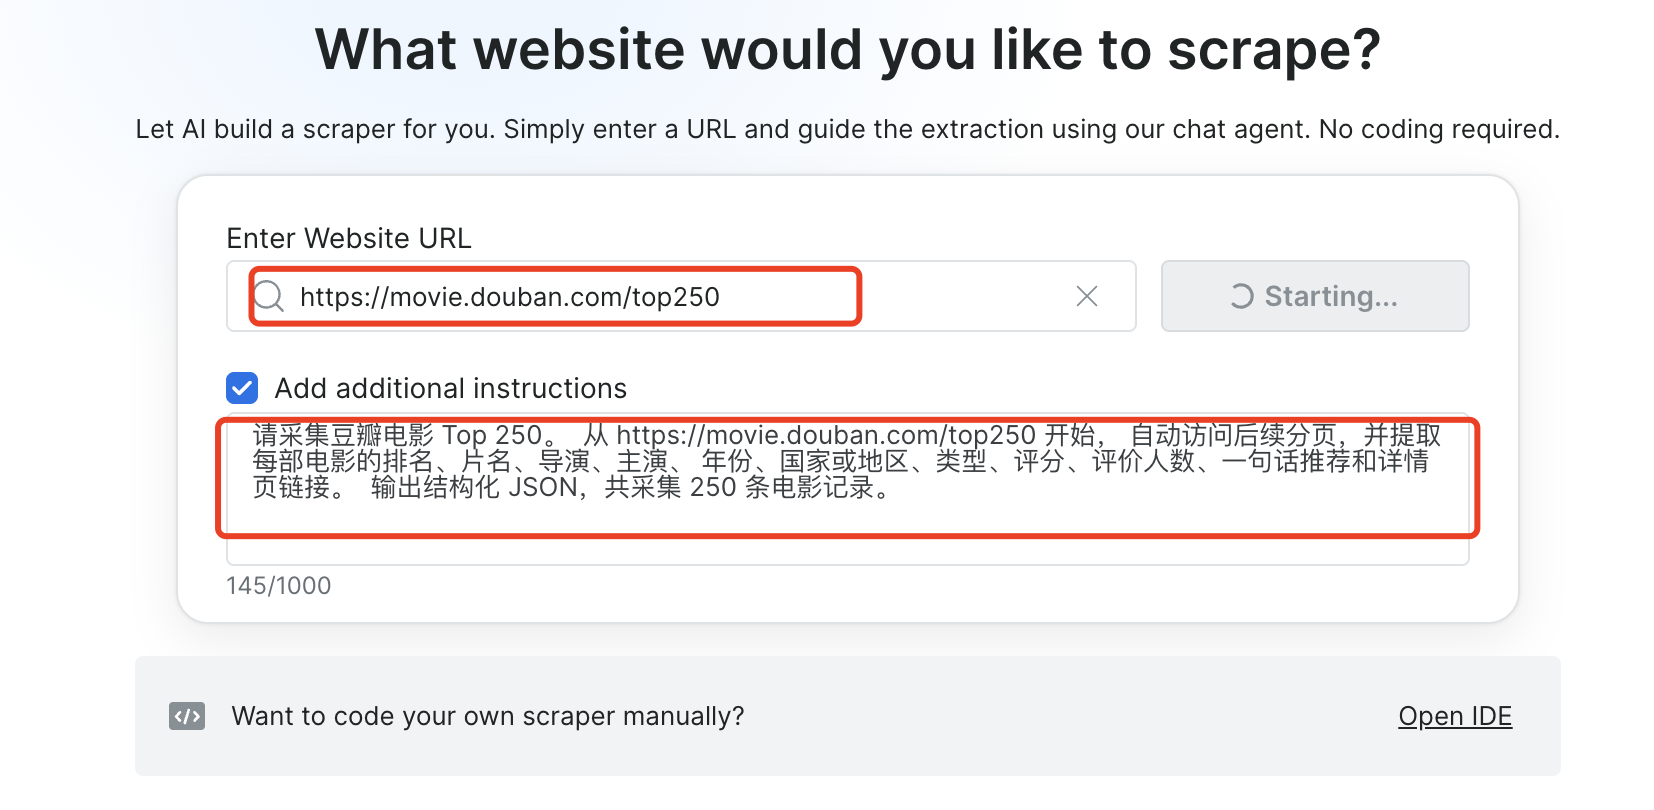
这样做是为了观察 AI Agent 在没有详细提示的情况下,会如何理解页面结构,而不是提前把所有答案都告诉它。
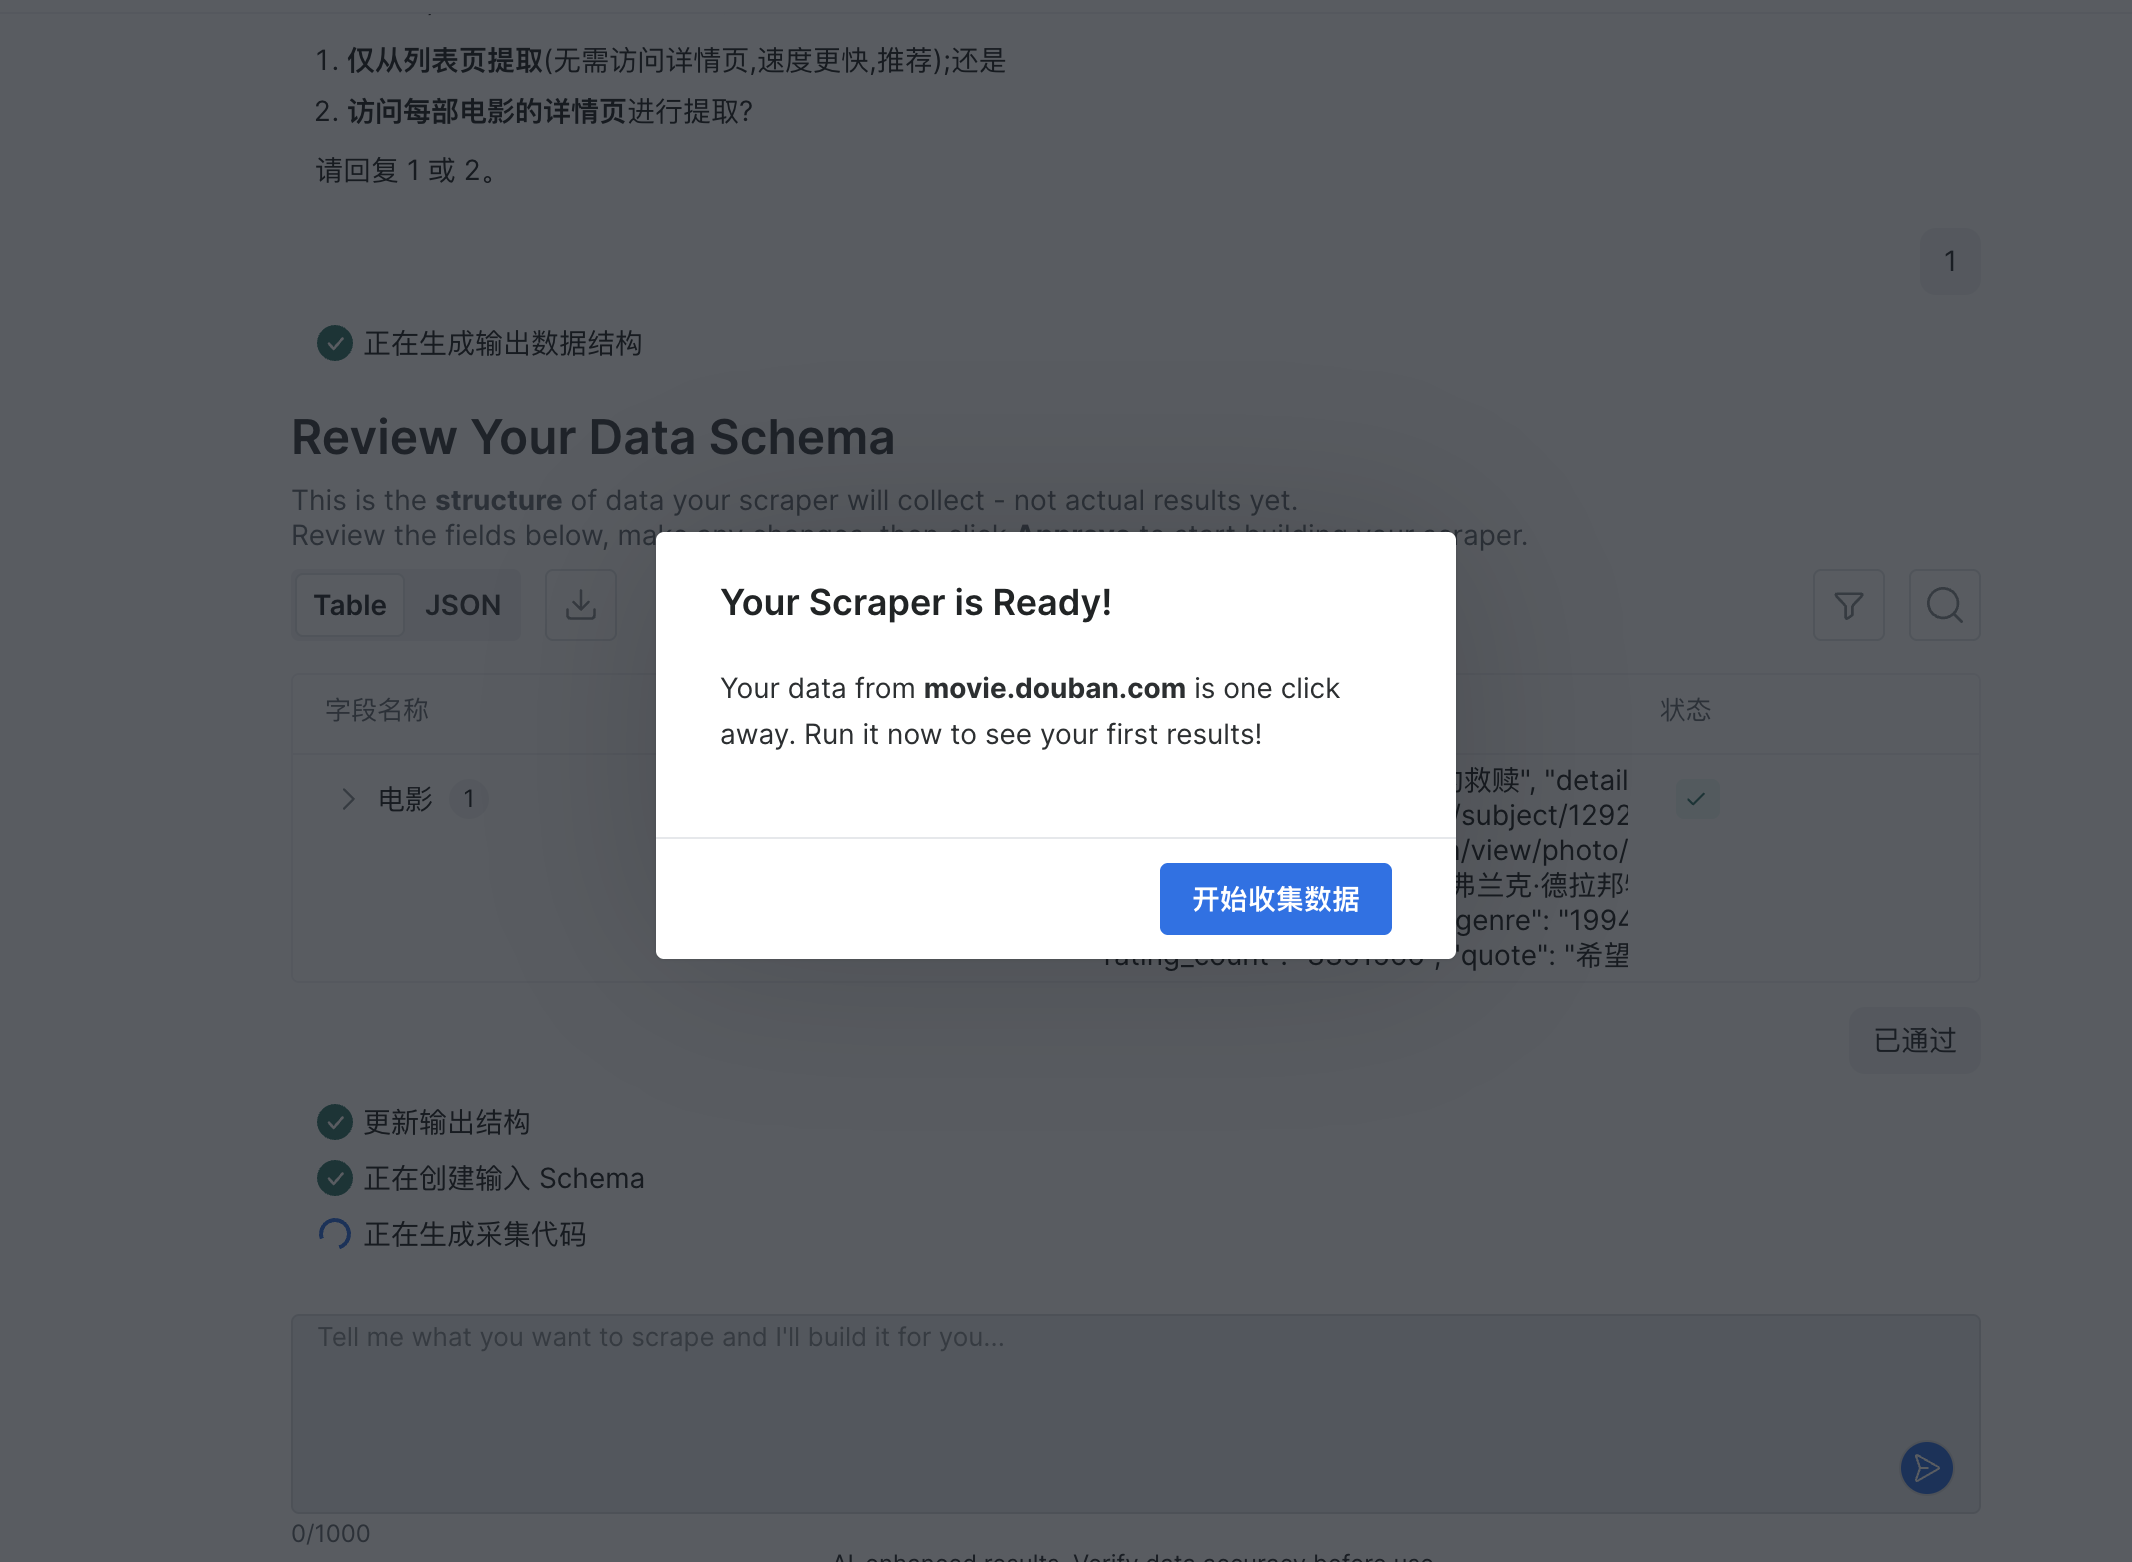
随后回答一下AI提问的问题,比如:确认数据的来源以及数据字段。当出现下面的弹框的时候,就说明程序已经准备妥当了,然后点击“开始收集数据”
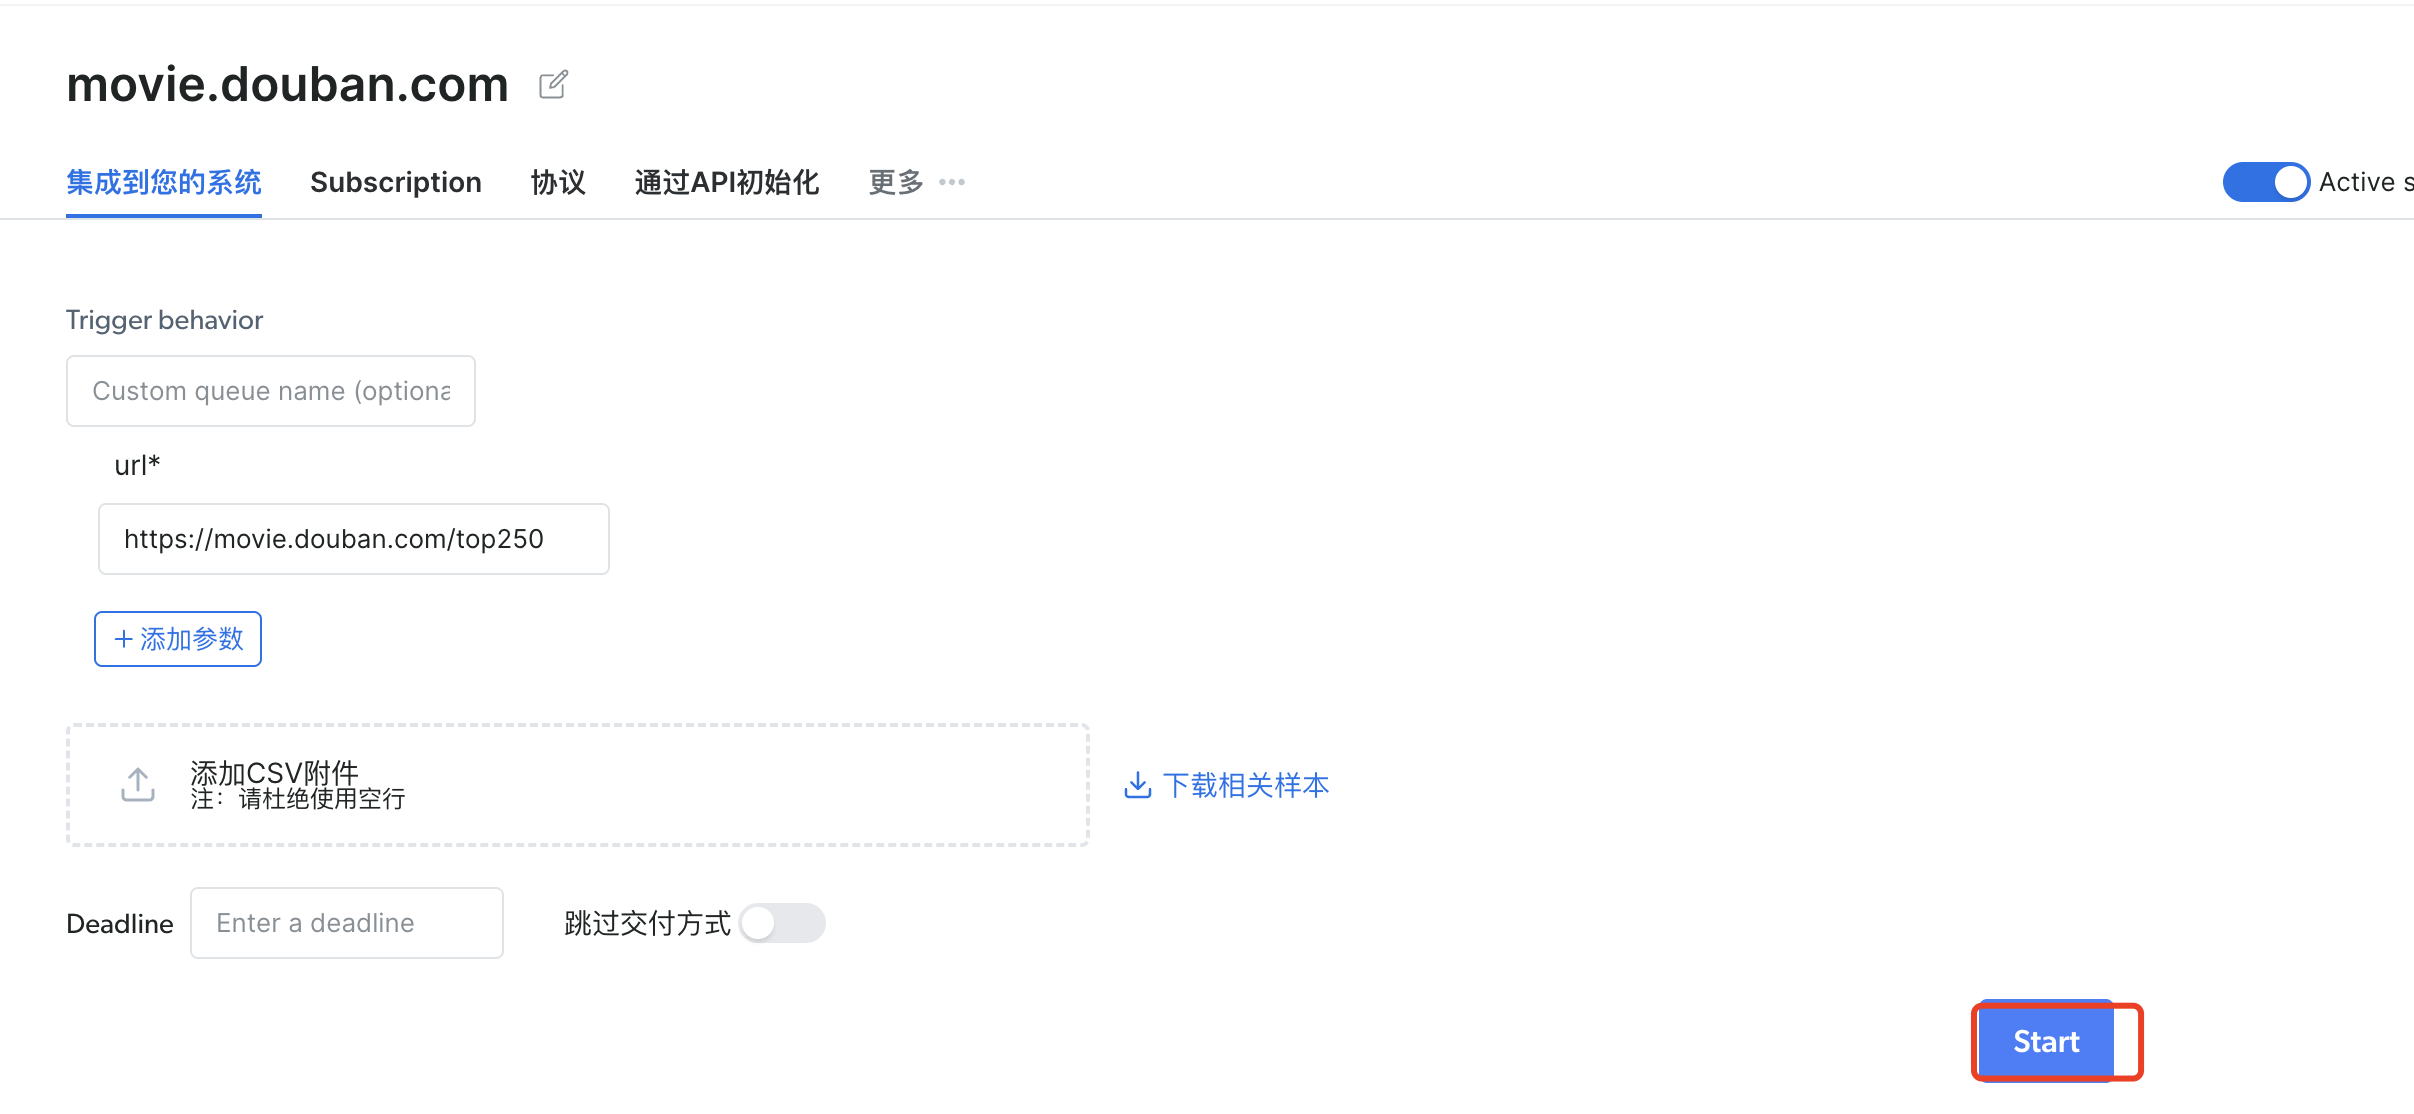
点击“Start”就可以正常工作了。
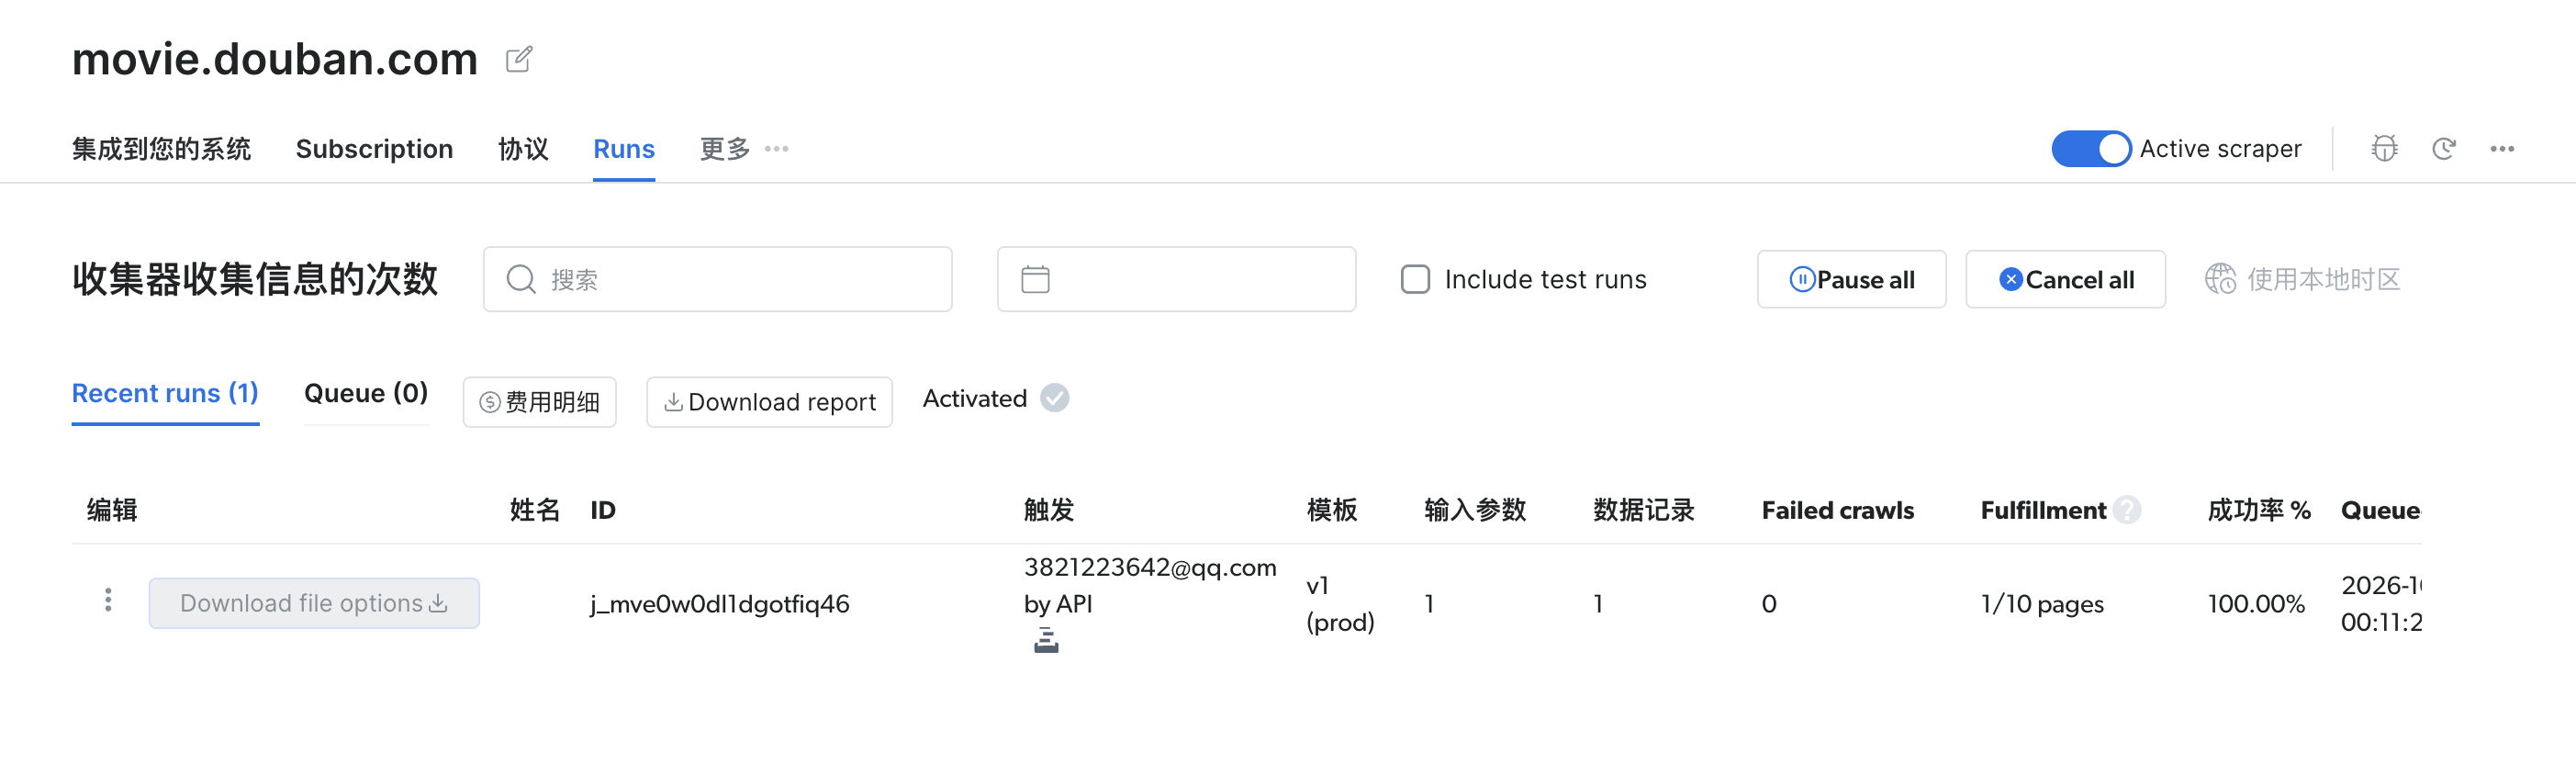
我们可以看到生成一条抓取记录,抓取结束可以点击下载获取结果
其中部分结果如下所示:
{
"rank": 1,
"title": "肖申克的救赎",
"detail_url": "https://movie.douban.com/subject/1292052/",
"poster_url": "https://img3.doubanio.com/view/photo/s_ratio_poster/public/p2934829882.webp",
"director_and_cast": "导演: 弗兰克·德拉邦特 Frank Darabont 主演: 蒂姆·罗宾斯 Tim Robbins /…",
"year_country_genre": "1994 / 美国 / 犯罪 剧情",
"rating": 9.7,
"quote": "希望让人自由。"
},
{
"rank": 2,
"title": "霸王别姬",
"detail_url": "https://movie.douban.com/subject/1291546/",
"poster_url": "https://img3.doubanio.com/view/photo/s_ratio_poster/public/p2911205318.webp",
"director_and_cast": "导演: 陈凯歌 Kaige Chen 主演: 张国荣 Leslie Cheung / 张丰毅 Fengyi Zha…",
"year_country_genre": "1993 / 中国大陆 中国香港 / 剧情 爱情 同性",
"rating": 9.6,
"quote": "风华绝代。"
},
第一轮结果中,AI 正确完成了,但也暴露了问题,比如:
- 导演和主演仍混在 director_and_cast 字符串中,部分内容还被省略号截断
- 年份、国家和类型仍合并在 year_country_genre 中,没有拆成独立字段
- 评价人数 rating_count 完全缺失
- 其他片名 other_title 完全缺失
- 250 条记录中只有 135 条包含 quote;推荐语缺失时,该字段会被直接省略,而不是返回 null
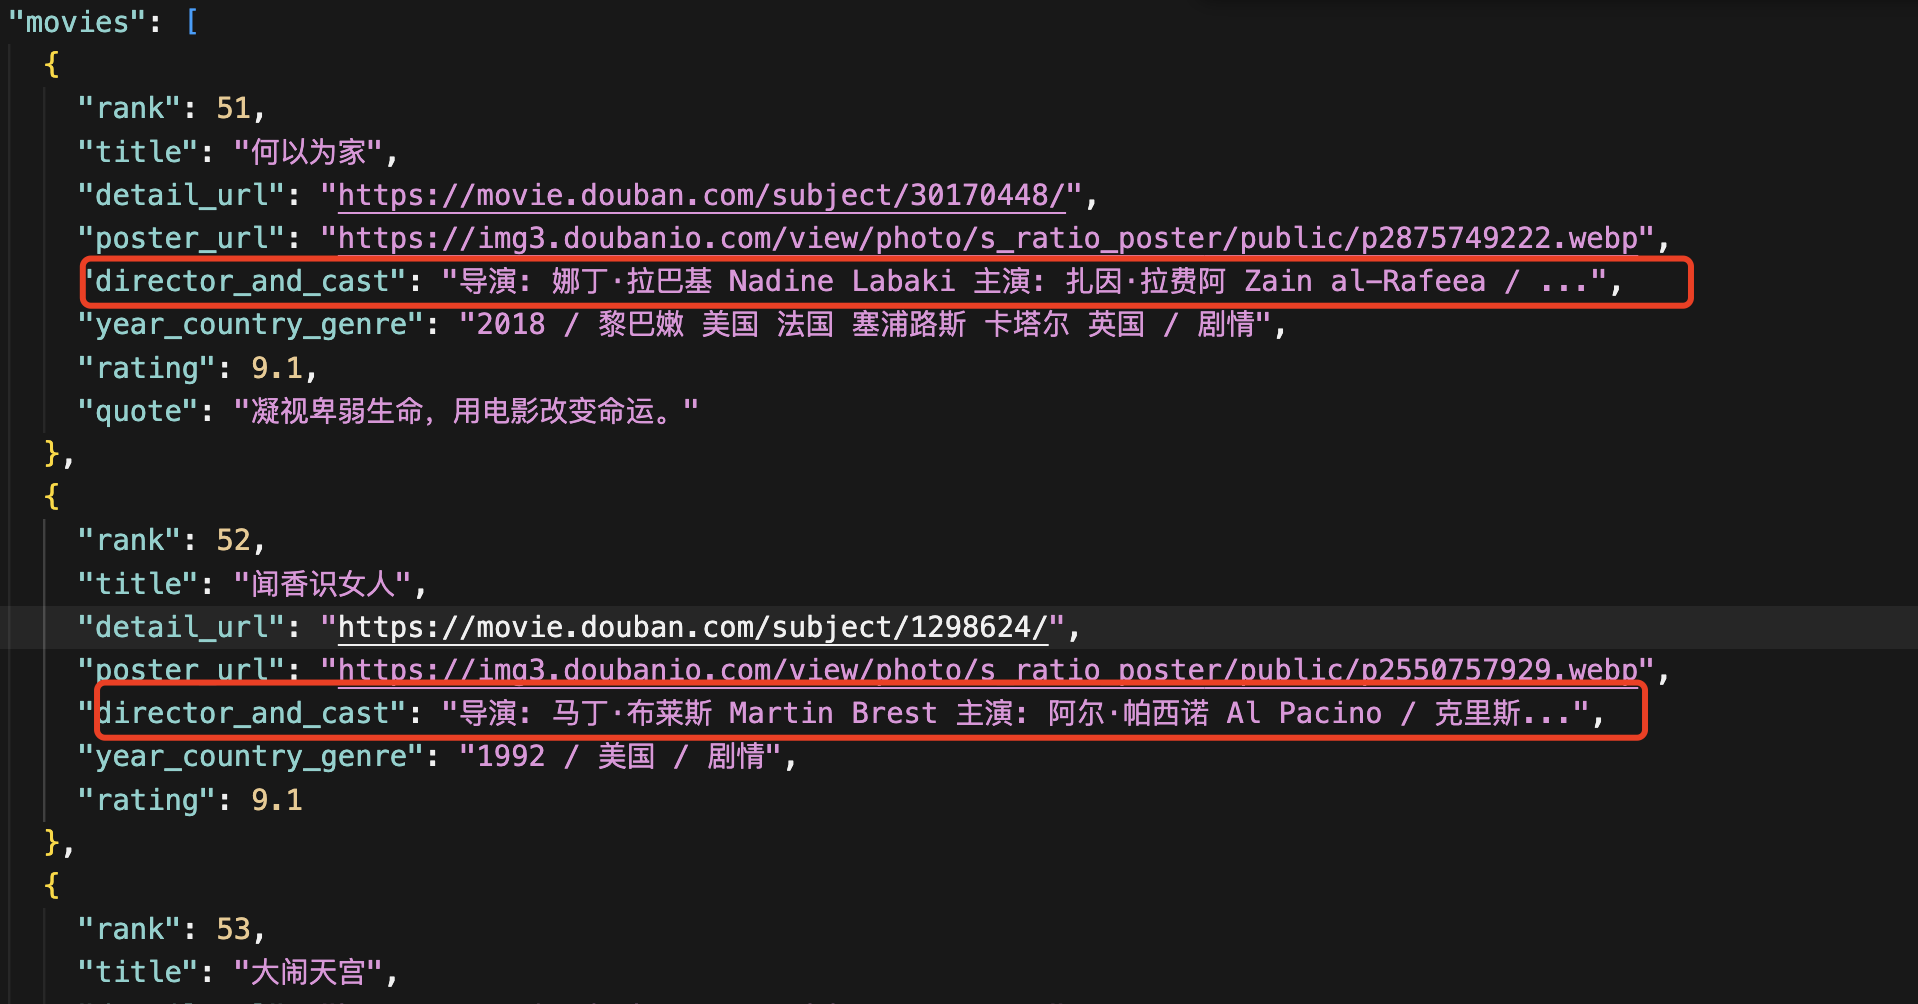
接下来我将着重优化一下上面的问题。
三、第二轮不是重写代码,而是补充数据规则
发现问题后,我没有进入 IDE 手动改选择器,而是继续用自然语言补充要求,
修正当前豆瓣 Top 250 爬虫的数据结构:
1.rank、year 和 rating_count 输出为整数,rating 输出为数字;
2. directors、actors、regions 和 genres 输出为字符串数组;
3. 将“1234567人评价”转换为 1234567;
4. title 只保留中文主标题,其他片名写入 other_title;
5. 去掉 other_title 开头和结尾多余的斜杠与空格;
6. quote 不存在时返回 null,不要读取下一行内容;
7. detail_url 输出完整 URL,只保留 movie.douban.com/subject/ 链接;
8. 按 detail_url 去重;
9. 继续翻页,直到没有下一页或获得 250 条有效记录;
10. 不访问详情页、评论页、用户主页或登录后页面。
选择自愈功能,输入上面的内容
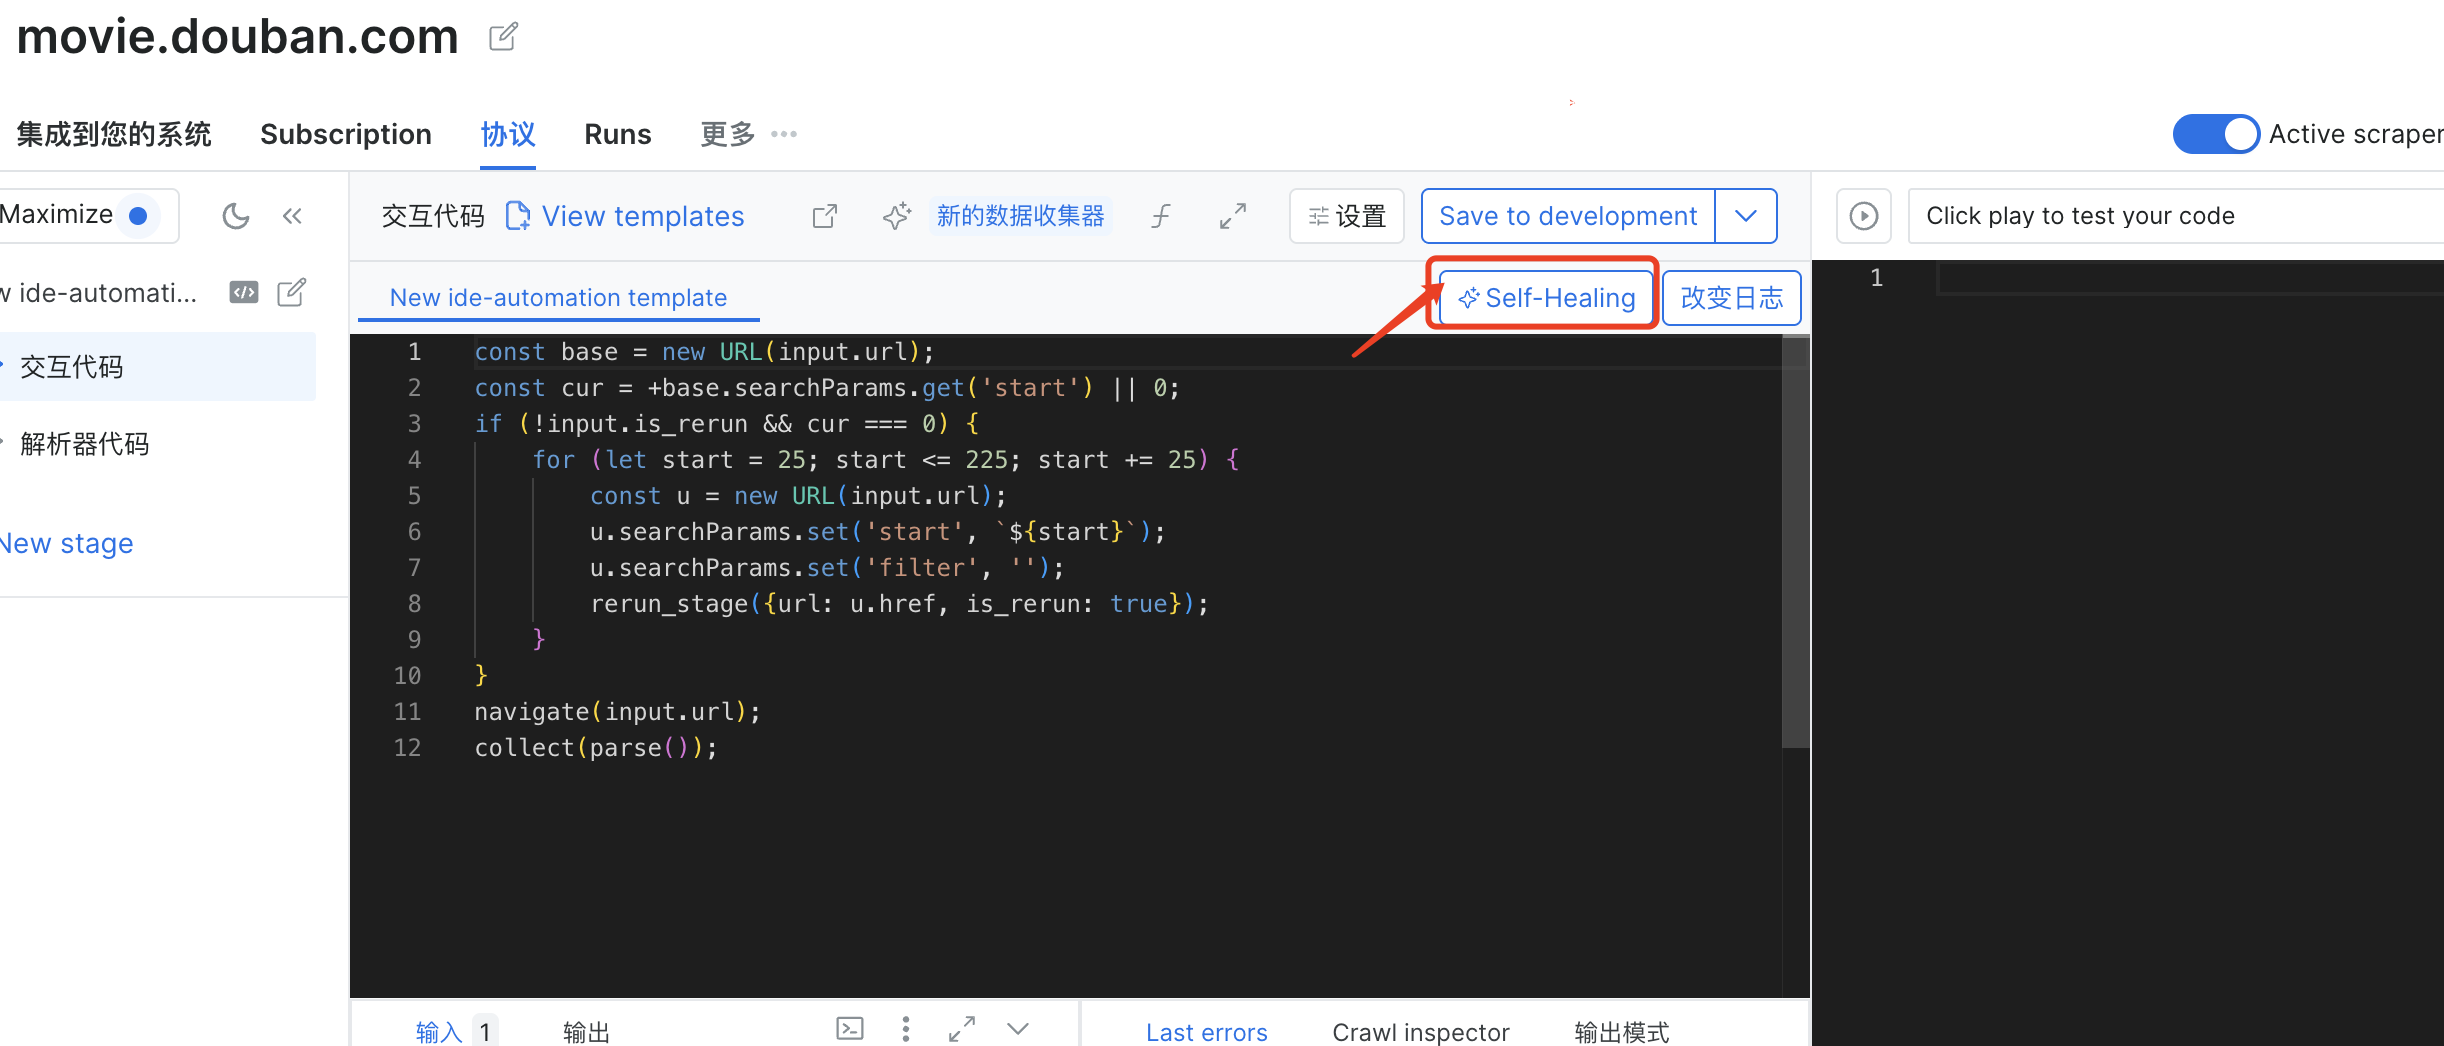

第二轮的重点不再是“抓哪些字段”,而是规定这些字段应该长什么样。
AI Agent 随后更新了 Schema 和爬虫逻辑。发布前应使用控制台实际生成的 Schema 替换下面的目标结构:
{
"rank": 52,
"title": "闻香识女人",
"other_title": "Scent of a Woman / 女人香 / 女人的芳香",
"directors": ["马丁·布莱斯 Martin Brest"],
"actors": ["阿尔·帕西诺 Al Pacino"],
"year": 1992,
"regions": ["美国"],
"genres": ["剧情"],
"rating": 9.1,
"rating_count": 1021467,
"quote": null,
"detail_url": "https://movie.douban.com/subject/1298624/"
}
从这一步开始,Bright Data Scraper Studio 更像一个与我共同调试数据规则的 Coding Agent,而不只是一个自动生成代码的表单。
四、这次测试真正省掉了什么?
如果自己用 Python 或 Playwright 完成这项任务,我需要处理的不只是解析逻辑,还包括代理、浏览器运行、访问失败、重试、部署和定时任务。
Bright Data Scraper Studio 把这些部分放在同一个托管环境中:
- AI Agent 根据自然语言生成 Schema 和爬虫代码;
- IDE 允许开发者查看并修改 JavaScript;
- Bright Data 负责代理、浏览器渲染、解锁和重试;
- 任务可以手动运行、通过 API 触发或定时执行;
- 输出支持 JSON、NDJSON、CSV、XLSX 和 Parquet;
- 数据可以发送到 Webhook、S3、GCS、Azure Blob、Snowflake 或 SFTP。
对这次测试而言,最有价值的不是省下几十行代码,而是第二轮发现数据问题后,我可以继续描述预期结果,不必立即回到选择器和部署环境中排查。
五、如果下个月页面改版怎么办?
榜单页一旦调整结构,最先出现的通常不是整个任务报错,而是部分字段悄悄变成 null,或者导演、主演和年份发生错位。
这类问题比直接失败更危险,因为错误数据可能继续流入分析系统。
Bright Data Scraper Studio 的 Self-Healing 可以根据自然语言生成代码修复。它不会未经确认直接覆盖生产版本,而是先提供修改差异,用户预览通过后再保存。
例如,可以输入:
最近一次运行中,rating_count 大量返回 null, directors 和 actors 也出现字段错位。 请根据当前豆瓣 Top 250 页面结构修复解析逻辑, 保持现有 Schema 和字段名不变。 先用第一页预览,并重点检查缺失 quote 的电影。
如果没有真实执行 Self-Healing,发布时应将本节保留为功能说明,不能写成已经完成的实测。
六、这类榜单爬虫需要多少成本?
根据 Bright Data 当前公开页面,新账户每月提供 5,000 个共享免费信用点,无需信用卡。在 Bright Data Scraper Studio 中,一次页面加载消耗一个信用点;免费额度用完后,公开的按量价格为每 1,000 次成功页面加载 1.50 美元,最新价格以官方为准。
这次只使用 Discovery 遍历榜单分页,不访问 250 个电影详情页。豆瓣 Top 250 通常包含约 10 个分页,因此一次完整运行所需的页面加载量相对有限,真实消耗以控制台统计为准。
如果还需要简介、片长、语言和完整上映日期,可以升级为 Discovery + PDP:先从榜单发现详情链接,再访问每部电影的详情页。字段会更丰富,但页面加载量也会显著增加。
与手写爬虫相比,Bright Data Scraper Studio 的差异主要在托管基础设施和维护流程;与依赖社区 Actor 的平台相比,它强调用户掌控自己的爬虫工作流,以及可检查、可回滚的 Self-Healing。
最终成本仍应根据相同页面量、相同字段和相同成功标准进行实测,而不是只比较宣传价格。
另外可以使用折扣码:TKMAO 可以享有各种代理60%off,其它API产品35%off 为期3个月
结论
这次测试让我更明确了一件事:AI 爬虫的价值,不在于它能否生成第一版代码,而在于它能否根据数据问题继续迭代。
豆瓣 Top 250 的难点不是页面数量,而是中文混排字段的拆分和清洗。第一轮 Prompt 用来验证 AI 对页面的基本理解,第二轮 Prompt 则把错误转化为明确的数据规则。这样的过程比直接展示一段“Prompt”更接近真实项目。
对于需要快速验证中文网站公开数据,又不想自行维护代理、浏览器和部署环境的开发者或数据团队,Bright Data Scraper Studio 提供了一条值得测试的路径。它不能替代数据质量检查,也不能替代合规判断,但可以减少从发现问题到修改爬虫之间的工程成本。目前每月提供 5,000 个共享免费信用点,最新价格以官方为准,可以先用第一页验证字段规则,再运行完整榜单。
常见问题
Bright Data Scraper Studio 如何处理中文混排数据?
Bright Data Scraper Studio 通过 AI Agent 生成字段提取和清洗逻辑,并使用 Schema 约束字段名称与数据类型。对于导演和主演混排、年份与类型共用分隔符等情况,用户可以通过后续 Prompt 明确拆分规则,再通过预览验证输出。
如何处理爬虫输出中的脏数据?
处理爬虫脏数据需要先定义字段类型、缺失值、去重和拆分规则,再对不同分页及异常记录进行抽样验证。Scraper Studio 可以根据自然语言规则更新解析逻辑,但字段准确性仍需要通过真实样本检查。
Discovery 爬虫适合什么场景?
Discovery 适合从列表页、分类页或榜单页发现多条记录,并继续翻页采集的场景。豆瓣 Top 250 的字段主要位于榜单页,因此使用 Discovery 比逐一访问详情页更节省页面加载量。
什么是 Scraper Studio 的 Self-Healing?
Self-Healing 是根据自然语言描述生成爬虫代码修复方案的功能。修复内容先以代码差异和草稿形式供用户审核,预览通过并确认保存后才会更新生产版本。
什么时候需要使用 Discovery + PDP?
当列表页只能提供摘要,而完整字段位于详情页时,应考虑使用 Discovery + PDP。对于豆瓣电影,如果还需要简介、片长、语言和完整上映日期,可以先发现电影链接,再进入每个详情页采集。
Scraper Studio 是否能完全自动保证数据质量?
Scraper Studio 不能完全自动保证数据质量。AI Agent 和 Self-Healing 可以生成与修复解析逻辑,但分页完整性、字段类型、缺失值和重复记录仍需要由使用者验证。
相关资料:
- Scraper Studio 产品页
- Self-Healing 文档
合规提醒:“本测试仅用于公开数据采集的工程技术验证,请在遵守目标网站服务条款及相关法律法规的前提下合理使用。”