温馨提示: 本人主页置顶文章(点我)开头有 CSDN 平台官方提供的学长联系方式的名片! 温馨提示: 本人主页置顶文章(点我)开头有 CSDN平台官方提供的学长联系方式的名片! 温馨提示: 本人主页置顶文章(点我)开头有 CSDN 平台官方提供的学长联系方式的名片!
前言
🌞博主介绍:✌CSDN特邀作者、全栈领域优质创作者、10年IT从业经验、码云/掘金/知乎/B站/华为云/阿里云等平台优质作者、专注于Java、小程序/APP、python、大数据等技术领域和毕业项目实战,以及程序定制化开发、文档编写、答疑辅导等。✌🌞
👇🏻 精彩专栏 推荐订阅👇🏻 2026-2027年最值得选的微信小程序毕业设计选题大全:200个热门选题推荐✅
2026-2027年最值得选的计算机毕业设计选题大全:500个热门选题推荐✅
Java精品项目实战案例《500套》
Java项目实战案例《500套》
微信小程序项目精品案例《500套》 🌞文末获取源码+数据库+文档🌞 感兴趣的可以先收藏起来,还有大家在毕设选题,项目以及论文编写等相关问题都可以给我留言咨询,希望帮助更多的人
项目概述
随着现代社会生活节奏加快,学业压力、工作竞争、人际关系等多重因素导致人们情绪波动频繁,焦虑、抑郁、愤怒等负面情绪长期积压易引发心理健康问题。传统情绪管理依赖个人自省与人工咨询,存在记录不及时、反馈滞后、缺乏量化数据支撑等局限。本项目基于SpringBoot与AI大模型设计并实现了一个情绪追踪与可视化反馈系统,系统采用前后端分离架构,面向普通用户提供情绪记录打卡、情绪追踪、情绪类型识别、情绪解压音乐推荐、个性化建议、异常上报、干预调节、公告资讯等服务;面向管理员提供用户管理、情绪类型管理、情绪解压音乐管理、情绪记录管理、个性化建议管理、异常上报处理、干预调节、情绪追踪数据管理、数据可视化分析、公告资讯、弹窗提醒、轮播图管理等功能。系统融合AI大模型情感分析能力,基于用户记录的事件名称、情绪类型、情绪强度、生理反应、应对行为、记录地点等特征自动生成情绪分析与个性化干预建议,并通过音乐、建议、干预等多维度反馈机制帮助用户疏解情绪、改善心理健康。
技术环境
本系统采用主流成熟的开发技术栈,以Java为核心开发语言,结合AI大模型、后端、前端、数据库、可视化等技术搭建完整项目体系,具体技术环境配置如下:
- 开发语言:Java,语法简洁、生态丰富,适配后端服务搭建与业务逻辑处理工作
- AI大模型算法:接入大语言模型(LLM)能力,基于用户记录的事件、情绪类型、情绪强度、生理反应、应对行为、记录地点等多维度特征进行AI情感分析与情绪识别,自动生成个性化情绪分析报告与干预调节建议,支持自然语言理解与智能对话反馈
- 开发IDE工具:Idea、VS Code,分别用于后端业务开发、前后端代码编写与调试
- 数据库:MySQL5.7 / MySQL8.0,关系型数据库,稳定性强、读写速度快,用于持久化存储用户数据、情绪类型数据、情绪解压音乐数据、情绪记录数据、情绪追踪数据、个性化建议、异常上报、干预调节、公告资讯、弹窗提醒、轮播图等全部业务数据
- 后端核心框架:SpringBoot,轻量化Web框架,快速搭建后端RESTful接口、处理核心业务逻辑、实现权限管控与AI分析任务调度
- 项目包管理工具:Maven,统一管理项目依赖库、后端组件,保障项目环境一致性
- 前端技术栈:HTML+CSS+JavaScript+Vue3,采用组件化开发模式,搭建响应式前端页面,实现用户交互、情绪记录打卡、情绪追踪、音乐解压、建议查看、异常上报、后台管理等功能
- 可视化技术:ECharts,专业数据可视化图表库,实现情绪类型分布、情绪强度统计、情绪趋势变化、情绪记录统计分析等多维度数据图表展示
- 数据库管理工具:Navicat,可视化数据库管理工具,用于数据表创建、数据查看、数据备份与运维管理
- 整体技术架构:SpringBoot + Vue3 + MySQL + ECharts + AI大模型,标准前后端分离架构,业务解耦度高、扩展性强、便于后期功能迭代与系统维护
系统功能模块设计
一、普通用户角色
二、管理员角色
系统部分效果展示
系统前台实现效果
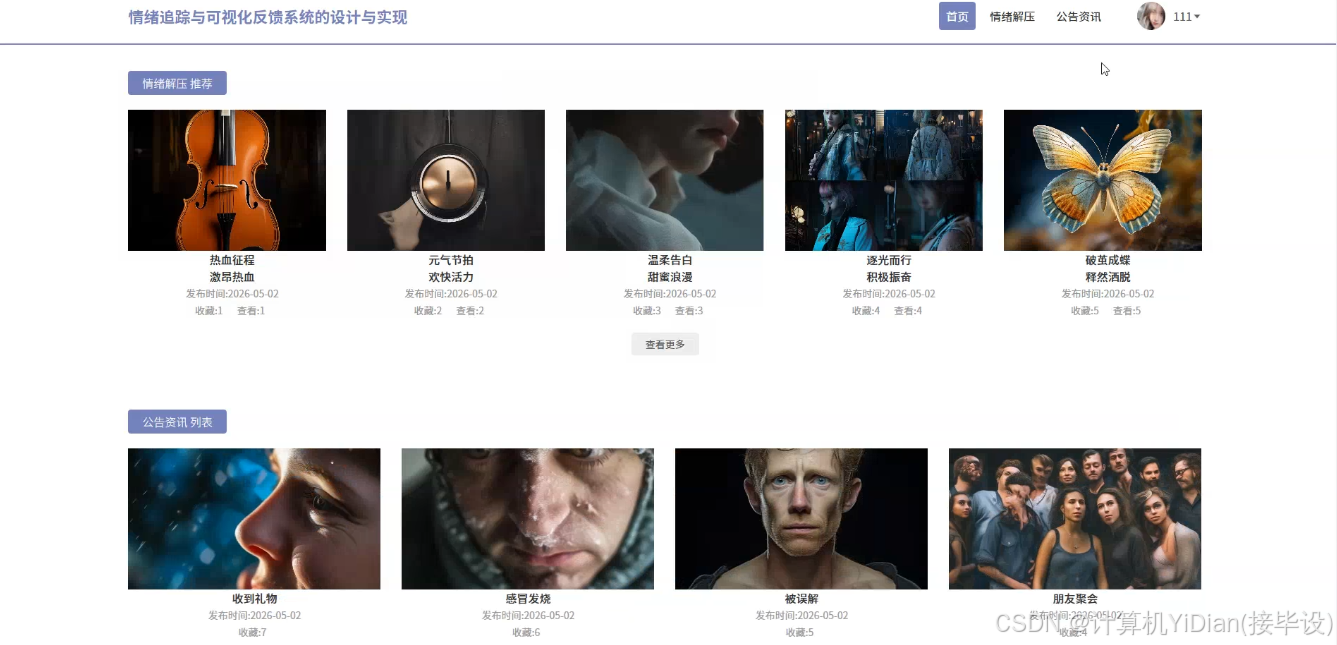
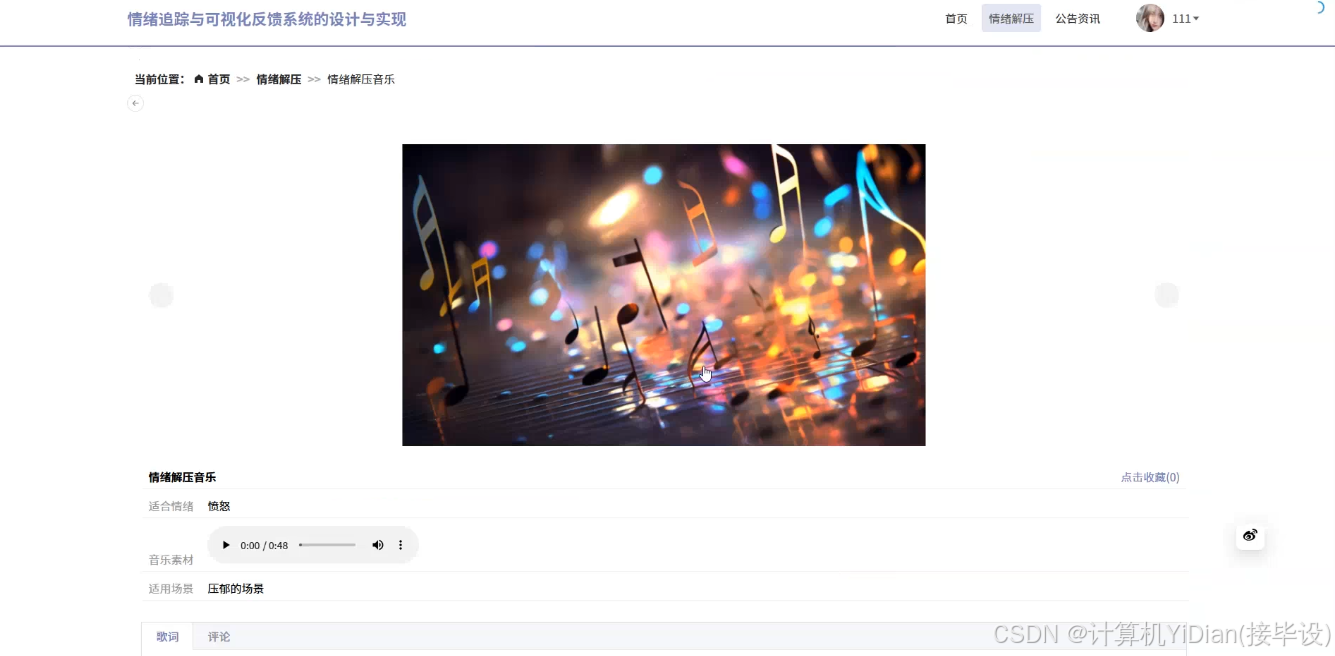
系统后台管理实现效果
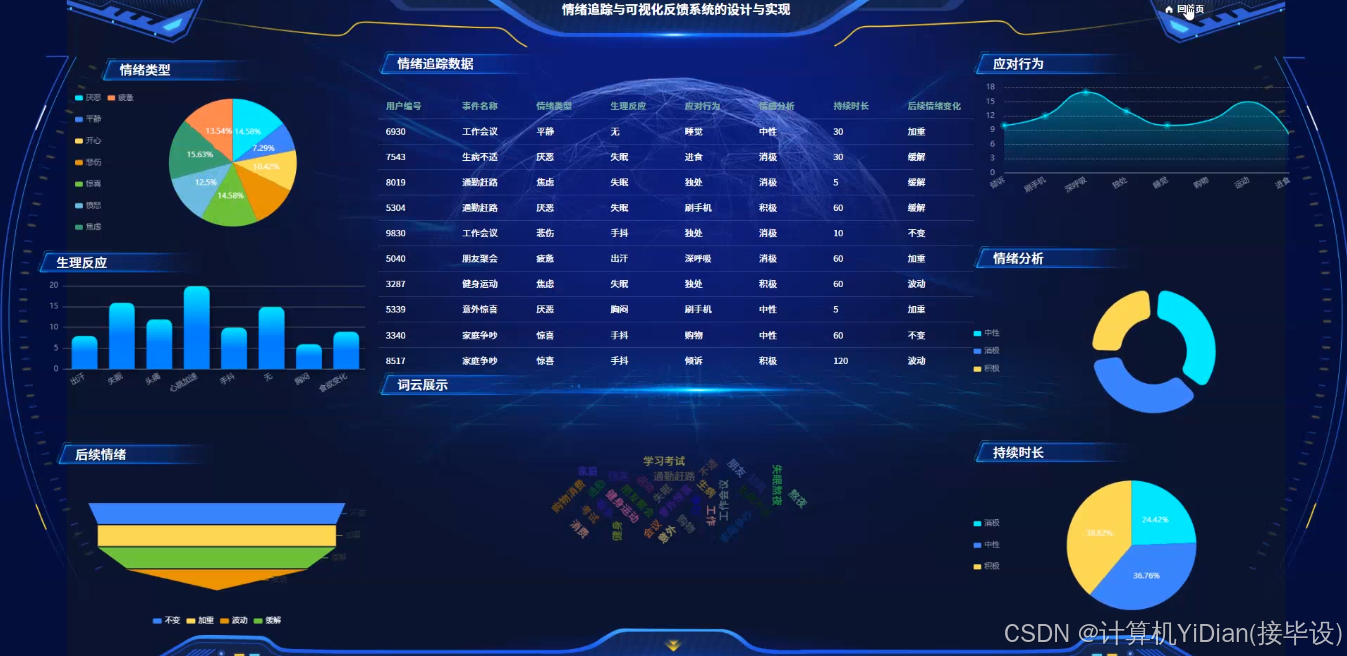
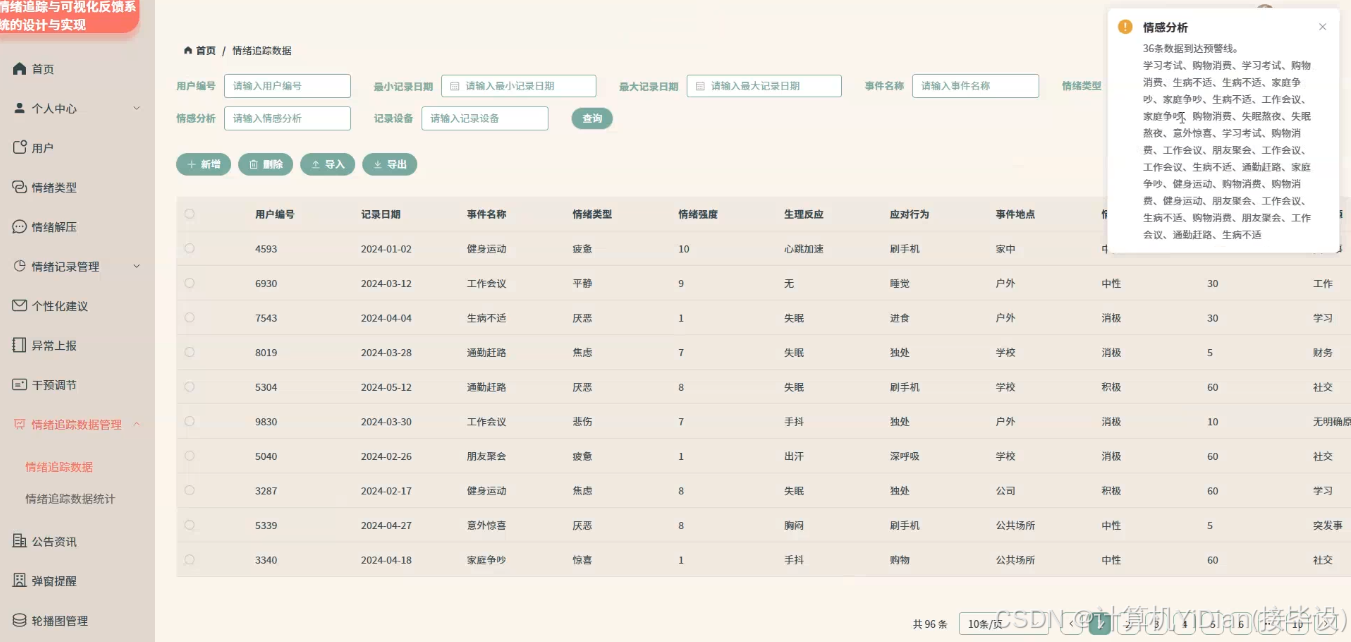
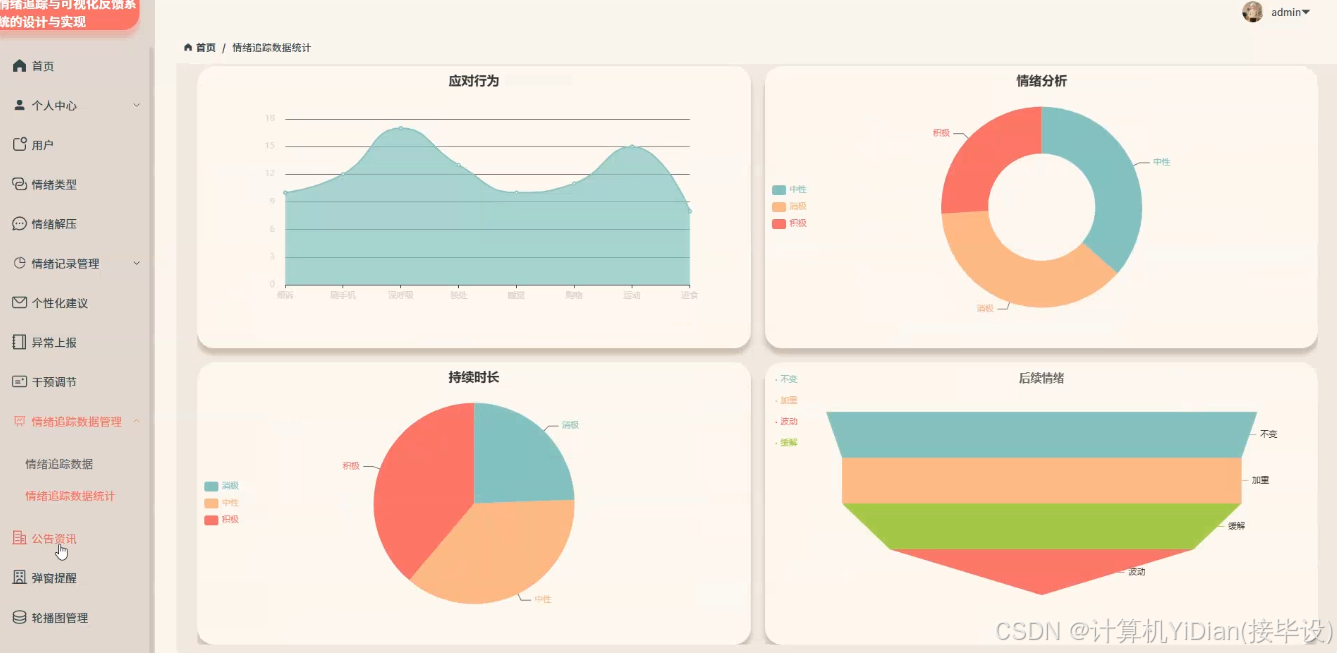
详细视频演示
❤文末卡片,联系我获取更详细的演示视频
系统架构设计
本系统采用经典前后端分离架构,整体分为三层:
- 表现层(前端):基于Vue3框架分别构建普通用户前台页面与管理员后台页面,用户端提供情绪记录打卡、情绪追踪、解压音乐聆听、个性化建议查看、异常上报、公告浏览等轻量化交互界面,管理端提供情绪数据管理、情绪追踪数据统计、干预调节管理等专业操作界面,通过ECharts实现情绪类型分布、情绪强度统计、情绪趋势等多维度图表渲染
- 业务逻辑层(后端):基于SpringBoot框架搭建RESTful API接口,处理用户认证、情绪记录管理、情绪追踪、解压音乐管理、AI情感分析调用、个性化建议生成、异常上报处理、干预调节、公告管理、弹窗提醒等核心业务逻辑,实现多角色权限控制与数据校验
- 数据层:基于MySQL数据库持久化存储用户信息、情绪类型、解压音乐、情绪记录、情绪追踪数据、个性化建议、异常上报、干预调节、公告资讯等业务数据,AI大模型基于用户情绪特征数据自动生成情感分析与个性化干预建议
系统特色与创新说明
推荐其他项目
基于SpringBoot+Vue的体育社区系统设计与实现 基于SpringBoot+Vue+AI的智能口腔医疗管理平台设计与实现 基于AI大模型+SpringBoot+Vue的社区医院慢性病智能化管理系统的设计与实现 基于微信小程序的景点攻略交流平台设计与实现 基于大数据+爬虫的影视评论采集可视化分析系统的设计与实现 基于微信小程序的中华诗词交流平台设计与实现 基于SpringBoot+Vue农作物病虫害防治系统设计与实现 基于SpringBoot+Vue的校园安全信息上传与应急响应系统的设计与实现 基于SpringBoot+Vue+AI大模型+推荐算法的高校毕业生实习管理系统设计与实现 基于SpringBoot+Vue的校园旧物捐赠平台设计与实现
为什么选择我们
海量实战案例
所有实战项目源码均为博主收集和开发,亲测可用,质量保障,大家可以放心使用,当然也可根据需求定制开发。 
自己的公众号(一点毕设)
代码参考
import scrapy
import pymysql
import pymssql
from ..items import xiangmuItem
import time
import re
import random
import platform
import json
import os
from urllib.parse import urlparse
import requests
import emoji
class xiangmuSpider(scrapy.Spider):
name = 'xiangmuSpider'
spiderUrl = 'https://url网址'
start_urls = spiderUrl.split(";")
protocol = ''
hostname = ''
def __init__(self, *args, **kwargs):
super().__init__(*args, **kwargs)
# 列表解析
def parse(self, response):
_url = urlparse(self.spiderUrl)
self.protocol = _url.scheme
self.hostname = _url.netloc
plat = platform.system().lower()
if plat == 'windows_bak':
pass
elif plat == 'linux' or plat == 'windows':
connect = self.db_connect()
cursor = connect.cursor()
if self.table_exists(cursor, 'xiangmu') == 1:
cursor.close()
connect.close()
self.temp_data()
return
list = response.css('ul.subject-list li.subject-item')
for item in list:
fields = xiangmuItem()
fields["laiyuan"] = self.remove_html(item.css('div.pic a.nbg::attr(href)').extract_first())
if fields["laiyuan"].startswith('//'):
fields["laiyuan"] = self.protocol + ':' + fields["laiyuan"]
elif fields["laiyuan"].startswith('/'):
fields["laiyuan"] = self.protocol + '://' + self.hostname + fields["laiyuan"]
fields["fengmian"] = self.remove_html(item.css('div.pic a.nbg img::attr(src)').extract_first())
fields["xiaoshuoming"] = self.remove_html(item.css('div.info h2 a::attr(title)').extract_first())
detailUrlRule = item.css('div.pic a.nbg::attr(href)').extract_first()
if self.protocol in detailUrlRule:
pass
elif detailUrlRule.startswith('//'):
detailUrlRule = self.protocol + ':' + detailUrlRule
else:
detailUrlRule = self.protocol + '://' + self.hostname + detailUrlRule
fields["laiyuan"] = detailUrlRule
yield scrapy.Request(url=detailUrlRule, meta={'fields': fields}, callback=self.detail_parse)
# 详情解析
def detail_parse(self, response):
fields = response.meta['fields']
try:
if '(.*?)' in '''div#info span a::text''':
fields["zuozhe"] = re.findall(r'''div#info span a::text''', response.text, re.S)[0].strip()
else:
if 'zuozhe' != 'xiangqing' and 'zuozhe' != 'detail' and 'zuozhe' != 'pinglun' and 'zuozhe' != 'zuofa':
fields["zuozhe"] = self.remove_html(response.css('''div#info span a::text''').extract_first())
else:
fields["zuozhe"] = emoji.demojize(response.css('''div#info span a::text''').extract_first())
except:
pass
# 去除多余html标签
def remove_html(self, html):
if html == None:
return ''
pattern = re.compile(r'<[^>]+>', re.S)
return pattern.sub('', html).strip()
# 数据库连接
def db_connect(self):
type = self.settings.get('TYPE', 'mysql')
host = self.settings.get('HOST', 'localhost')
port = int(self.settings.get('PORT', 3306))
user = self.settings.get('USER', 'root')
password = self.settings.get('PASSWORD', '123456')
try:
database = self.databaseName
except:
database = self.settings.get('DATABASE', '')
if type == 'mysql':
connect = pymysql.connect(host=host, port=port, db=database, user=user, passwd=password, charset='utf8')
else:
connect = pymssql.connect(host=host, user=user, password=password, database=database)
return connect
# 断表是否存在
def table_exists(self, cursor, table_name):
cursor.execute("show tables;")
tables = [cursor.fetchall()]
table_list = re.findall('(\\'.*?\\')',str(tables))
table_list = [re.sub("'",'',each) for each in table_list]
if table_name in table_list:
return 1
else:
return 0
源码获取
🍅由于篇幅限制,获取完整文章或源码、代做项目的,本人主页置顶文章(点我)开头有 CSDN 平台官方提供的学长联系方式的名片。🍅 点赞、收藏、关注,不迷路