删掉几个头就算找到电路吗:消融基线与补偿——16 条 GPT-2 样本的末位干预
- 系列:从最小复现到可检验的科研问题
- 日期:2026-10-19
- 读者:研究生、科研新人和工程型研究者
- 范围:真实 GPT-2 small、16 条受控合成开发样本、三个候选头,仅干预句末位置。
摘要
前一篇发现,换一种姓名破坏方式,激活替换的头排名会变化。但“把干净激活放回去能恢复行为”,不等于“把这些头拿掉就能解释行为”。恢复与消融的起点不同,替换值也不同。本文固定候选组件,实际运行三种基线、七个组件子集,共 336 次消融。主要结果是:两个头的联合损失小于单独损失之和;第三个头的条件效应会随基线改变符号。我们得到的是一个可复查的干预现象,没有得到完整电路,也没有证明模型启用了备用机制。
复现价值:先问“拿掉”究竟指什么
间接宾语识别,即 IOI,要求补全类似“Christopher 和 Michael 到商店,Christopher 把戒指给了……”的句子,目标是 Michael。模型已经能做对,研究问题才转向内部计算。这里的“头”指多头注意力中的一个子模块;“电路”还需要说明组件如何连接、怎样传递与任务有关的信息。
**论文报告:**Wang 等人的 IOI 研究使用干预分析,并提出忠实性、完整性和最小性等检验标准;论文还报告了常规组件被消融后,其他组件承担名字搬运功能的现象。这是进一步检查补偿的动机,不能直接移植为本实验结论。原论文
**本次实际验证:**沿用上篇的模型、模板和 16 条开发材料,根据已经公开的局部破坏排名,冻结前三个候选头:A 为 L8H10,B 为 L8H6,C 为 L9H9。层与头均从零编号。本篇内部对照只改变替换基线和被替换的组件集合;相较上篇批量三十二的扫描,此次统一改为批量一并重算基线,避免把批量数值差混入效应。排名和消融使用同一批开发材料,因此这是探索性跟进,不是独立确认。
核心思想:零、均值和重采样回答不同问题
零消融把选定激活变成零,容易执行,却同时改变均值、尺度和内容。均值消融使用参考分布的平均激活,保留某些共同成分。重采样消融则使用一个参考样本的真实激活,保留该样本内部的结构,但结果可能依赖抽到谁。三者都需要明确参考对象,不能把“真实激活”当成“无偏替代”的保证。
本实验把每个模板里的三个姓名位置改成三个不同名字,枚举 Michael、Christopher、Jessica 的六种排列,形成每模板六条、总计十二条 ABC 参考句。这里 ABC 表示三个不同姓名槽位,与候选头 A、B、C 的记号无关。参考句没有重复主语身份,不赋予唯一正确间接宾语标签。按模板取均值,或者按预先保存的种子 103 映射取一个供体;同一目标的所有头与子集共用该供体。
原论文也讨论了使用 ABC 参考分布及模板分组的理由;本次只枚举极小参考库,不声称复现其完整采样与电路提取过程。参考均值可能不是任何自然输入的实际状态,单次供体分配也不能代表重采样的总体平均。论文中的消融定义
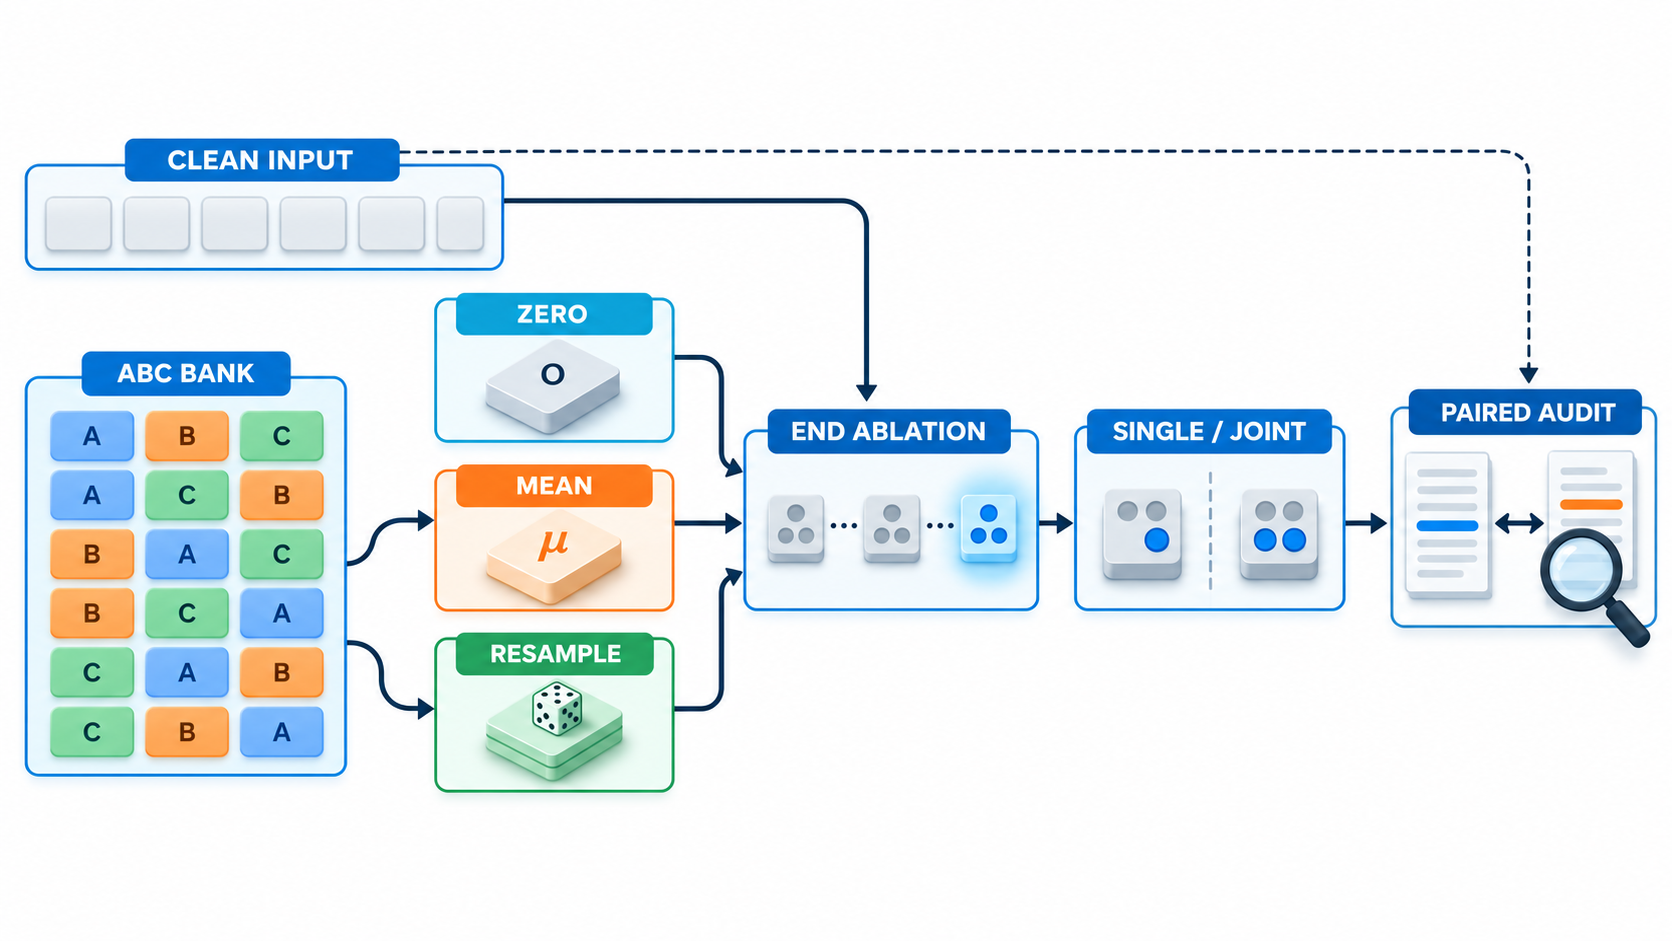
图中三条替换支路是并列条件,虚线把原始模型输出送入配对审计;图形只说明协议,不承载实验测量。单独与联合消融均只作用在末位,其他位置和未选组件继续计算。
公式与模块:把组件效应写成可复算的量
采用原始正确名字与干扰名字的 logit 差:
D
(
x
)
=
ℓ
I
O
(
x
)
−
ℓ
S
(
x
)
,
Δ
K
(
b
)
(
x
)
=
D
(
x
)
−
D
K
(
b
)
(
x
)
.
D(x)=\\ell_{IO}(x)-\\ell_S(x),\\qquad \\Delta_K^{(b)}(x)=D(x)-D_K^{(b)}(x).
D(x)=ℓIO(x)−ℓS(x),ΔK(b)(x)=D(x)−DK(b)(x).
x
x
x 是干净提示词,
ℓ
\\ell
ℓ 是输出层未经 softmax 的分数,
I
O
IO
IO 和
S
S
S 分别为正确名字与主语名字。
K
K
K 是被消融的头集合,
b
b
b 是替换基线;
D
K
(
b
)
D_K^{(b)}
DK(b) 是干预后的分差。
Δ
\\Delta
Δ 为正表示该干预使表现下降,为负表示改善。它不是正确率,也不是组件拥有的固定“贡献份额”。
两个头的非加性量定义为:
I
A
B
(
b
)
=
Δ
A
B
(
b
)
−
Δ
A
(
b
)
−
Δ
B
(
b
)
.
I_{AB}^{(b)}=\\Delta_{AB}^{(b)}-\\Delta_A^{(b)}-\\Delta_B^{(b)}.
IAB(b)=ΔAB(b)−ΔA(b)−ΔB(b).
同一样本、同一基线下,若该值为零,两次独立损失可相加;负值说明联合损失小于相加预测。先逐行计算,再对固定十六行取均值。另看在 AB 已消融后移除 C 的边际影响,即
Δ
A
B
C
(
b
)
−
Δ
A
B
(
b
)
\\Delta_{ABC}^{(b)}-\\Delta_{AB}^{(b)}
ΔABC(b)−ΔAB(b)。这个量与单独消融 C 的效应可以不同。
实现缓存注意力输出投影前的
z
z
z,张量视图为
[
1
,
T
,
12
,
64
]
[1,T,12,64]
[1,T,12,64]:批量为一,
T
T
T 为十五或十九个输入 token,十二个头各有六十四维。我们只替换末位的选中切片,输出投影、残差路径和后续网络仍正常运行。因此这不是删除整个头的权重,更不是在所有位置关闭它。
官方代码阅读路线
先看固定版本 GPT2Attention:找到注意力加权值合并到隐藏维、进入 c_proj 的位置,确认切片对应哪个头。再看 GPT2LMHeadModel 的最终输出层,确认比较的是同一位置和同一答案 token。最后读 IOI 仓库的 get_circuit_replacement_hook 与 do_circuit_extraction,检查位置替换、参考数据和分组均值的接口。官方 GPT-2 源码、IOI 消融实现
本地实现使用官方 Transformers 前向过程,自写钩子完成教学实验,没有运行 EasyTransformer 或 TransformerLens,也没有进行权重转换。源码地图逐项标注原样复用的自写模块、改写部分与独立算术实现。四份官方文件已重新下载核验,其中模型实现与安装版本字节一致。
最小实验与评测协议
实验冻结了 GPT-2 模型与分词器 revision 607a30d783dfa663caf39e06633721c8d4cfcd7e,使用 PyTorch 2.6.0、Transformers 4.49.0、CPU 单精度、四线程、批量一。材料由两模板、两种姓名顺序、两个相互重叠的姓名对及两个角色方向构成。只有三个不同名字,不能把十六行当作独立自然样本。留出名字和模板未推理,未训练、生成或截断。
七个子集为三个单头、三个双头和三个头联合。主要对照提前写为零值与参考均值下的 AB 损失及非加性;重采样和其余组合完整报告,不在看过结果后挑选“最有解释力”的设置。配置、源码、数据、资源及协议哈希在试跑前冻结,输出缓存不复用。
单样本试跑含二十一个干预及完整参考库,耗时 13.31 秒,预计全量约 21.24 秒,低于三百秒预算。正式运行实际墙钟 11.99 秒、进程峰值内存约 1.47 GB;试跑包含冷启动成本,两者不构成速度比较。各阶段状态、逐行分数、供体向量和退出码均保留。
本次实际结果:不能把非加性翻译成补偿
干净模型平均分差为 4.295。下表中的数字都是平均分差损失,越大表示干预破坏越强;最后两行则是配对对比量。
| 单独 A 的损失 | 1.218 | 1.256 | 1.195 |
| 单独 B 的损失 | 1.416 | 1.513 | 1.519 |
| 单独 C 的损失 | 0.320 | 0.702 | 0.667 |
| 联合 AB 的损失 | 2.340 | 2.493 | 2.453 |
| 联合 ABC 的损失 | 2.281 | 2.537 | 2.477 |
| AB 非加性 | −0.294 | −0.276 | −0.262 |
| AB 后继续消融 C | −0.060 | 0.044 | 0.025 |
三种基线的十六行 AB 非加性均为负。若简单相加单头损失,会高估联合干预的平均损失。更值得追踪的是 C:单独消融明显有害,但在 AB 已消融后,边际损失接近零,且零消融下平均略有改善。均值基线下 AB 后分差仍为正的有十四行,而全词表首选正确仅十二行;只比较两个名字,会漏掉其他词超过正确答案的情况。
**作者推断:**这些现象足以反驳“组件有不随背景变化的贡献值”这一简单解释,却不能辨认补偿路径。尤其这里没有出现“移除 AB 后 C 更不可或缺”的证据。残差重计算、层归一化、非线性与分数饱和都可能产生非加性;证明备用机制,需要额外定位与路径干预,而不是给交互项起一个生物学名字。
失败排查与证据边界
先排除实现错误。干净激活替回自身、空集合干预的全词表误差均为零;完整官方输出与末位读出的最大误差约为 0.000191。另写一种独立实现,在输出投影后加入替换产生的线性差量,与投影前覆盖相比最大误差约为 0.000061,低于预设阈值。所有模式的三头联合均执行该对照,避免多个钩子互相覆盖。
再排除算术错误。独立标准库脚本从原始候选分数复算全部条件、均值、正确数、交互量及参考向量统计,并通过七项故意损坏测试。这是自动复算,不是人工标注。补充独立程序用另一种投影后干预和完整官方前向,重放十六条基线及全部三百三十六个条件,全词表首选一致;候选分数最大差约 0.000153,双精度概率核对最大差约 0.000043,不声称所有数值逐位相同。
还要区分必要性和充分性。某次消融让分数下降,只说明该干预条件下这些激活与行为有关;不能说明只有这些组件参与,也不能说明保留这些组件就能重建行为。本文没有关闭剩余网络,没有检查组件之间的边,因此不能从三个候选头画出一个完整因果图。完整记录保留了未在表中展示的两个双头组合,读者可以核对结论是否只依赖某个特选子集。
最后检查替换尺度。C 的干净向量平均范数约 9.376,零替换为零,参考均值约 4.438。三种干预幅度不同,不能把它们当成等强度扰动;范数差也不能证明某状态在分布之外。真正的边界是:参考库很小、只有一次供体分配、开发选择和分析共用数据。旧临时环境缺失依赖及网络恢复过程已记录,没有把环境修复当作科学结果。
从现象到可检验的研究问题
下一步应固定这三个头和替换规则,在留出的名字、模板上比较行为与条件效应;若只有名字变换后失效,先检查参考库是否编码了姓名身份,若仅换模板失效,检查末位上下文及参考分组。两种解释要求不同对照,不能失败后重新挑头,再把新组合包装成原假设通过。
另一个区分性实验是固定干预集合,改变参考库规模并重复供体种子:若符号稳定而大小波动,主要问题可能是估计精度;若符号系统改变,则“组件重要性”的定义本身依赖参考分布。这里提出的是待验证假设,本次没有运行这些新增设置,也不预先承诺迁移成功。
源码与复现入口
本篇已公开的固定版本:完整源码目录、README 与运行说明、SOURCE_MAP 与上游映射。四十四个分发文件已匿名下载,与本地源码和归档逐文件哈希一致;公开副本通过独立审计与真实模型试跑。
安装 README 中的锁定依赖后,最小入口为:
python run.py –cache ./cache –out smoke-new –smoke
python audit.py smoke-new
第一条命令校验或下载固定资源,运行一条真实目标及十二条参考句,生成逐条件记录、参考激活、汇总、环境与阶段状态;第二条执行独立复算。正式范围为十六条目标、三百三十六次干预及全部实现对照。归档包含所有自写模块和必要证据,模型权重由固定链接获取。不要将最小试跑输出与正式全量结果混报。
总结
消融是一个带有参考值、作用位置和指标选择的实验。此次可核查的进展,是把联合效应的非加性和条件依赖写进了完整记录;仍缺少的是补偿路径及留出迁移证据。只有把这两者分开,定位结果才有机会发展成可以被检验的机制解释。
参考资料
检索与访问日期:2026-10-19。以上结果来自本次日志,以下一手资料提供概念、模型和实现依据。