NEURIPS 2026
关系融合
RCS-Fusion:由像素监督转为关系监督
图像融合并没有一个固定的答案,但是它已经被长期地用作源图像像素和梯度的“替代真值”。本文提出的不是同一个问题,而是在于要求融合图像的同时不能忽略红外和可见光的信息,或者是在于限制融合图像时不能丢弃红外和可见光的信息,或者是限制融合图像时不能忽略红外和可见光的信息。
00 论文核心信息
论文标题:Beyond Spatial-Domain Supervision: A Relation Constrained Space for Multi-Modal Image Fusion
** 论文作者:** Zeyu Wang、Mingyu Ge、Haiyu Song*、Haoran Duan*
作者单位:大连民族大学计算机科学与工程学院;清华大学自动化系。
论文链接:
https://arxiv.org/abs/2609.38968
代码链接:
https://github.com/GMY628/RCS-Fusion
一句话概括:把“同时逼近两幅源图像”的监督,改成“满足共享、互补、冲突协调关系”的监督。
PART 01
为何融合会受到监督而被“带偏”呢?
除了网络之外,在学习的目标上也存在问题
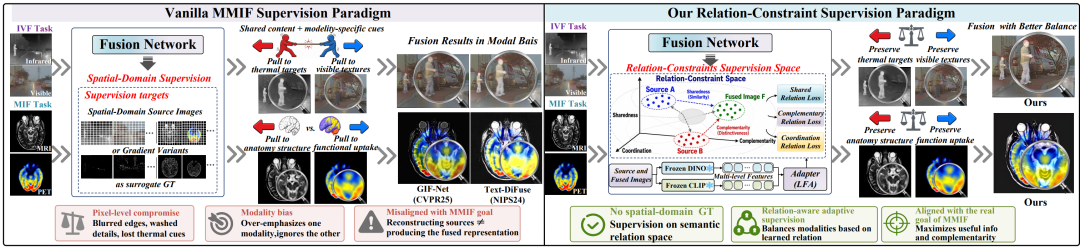
红外图像突出的是热目标,而可见光图像则比较擅长于结构和纹理的描绘。两者都是真实的观察结果,但是都不是融合结果的唯一正确标签。直接使融合图像同时接近两个源图像,在目标差异很大的情况下就很容易出现像素折中、边缘模糊或者模态偏移等问题。
作者把融合的目标概括为三个方面:第一,把两种模态一起支持的一种结构;第二,保留只在某一种模态中出现的有用的细节;第三,在出现信息冲突的情况下,不要输出过于偏好的一方。注意:并不是说像素监督一无是处,而是把它限定在了训练预热阶段,之后由关系监督来接手。
1.1 传统的损失函数为什么会产生拉扯效应?
传统的融合网络一般都会用到强度保持、梯度保持等等目标。例如红外热像图中热亮点和可见光图像中纹理边界的同一位置会给出不同的梯度方向;把两个源图像都看作是需要精确复原的真值的话,那么这两个源图像之间的差异就会以“互相拉扯”的方式进入到优化当中去。
传统的强度和梯度损失,在本方法里只起预热的作用
RCS-Fusion 之间的不同并不是换了一个新的加权系数,而是在于改变评判融合结果好坏的标准:源图像提供信息,关系空间提供最后的监督要求。从重建目标到关系约束的转变,是本文研究动机中最重要的一点。
PART 02
使用DINO和CLIP来建立监督空间
并不是要让大模型直接生成融合图像
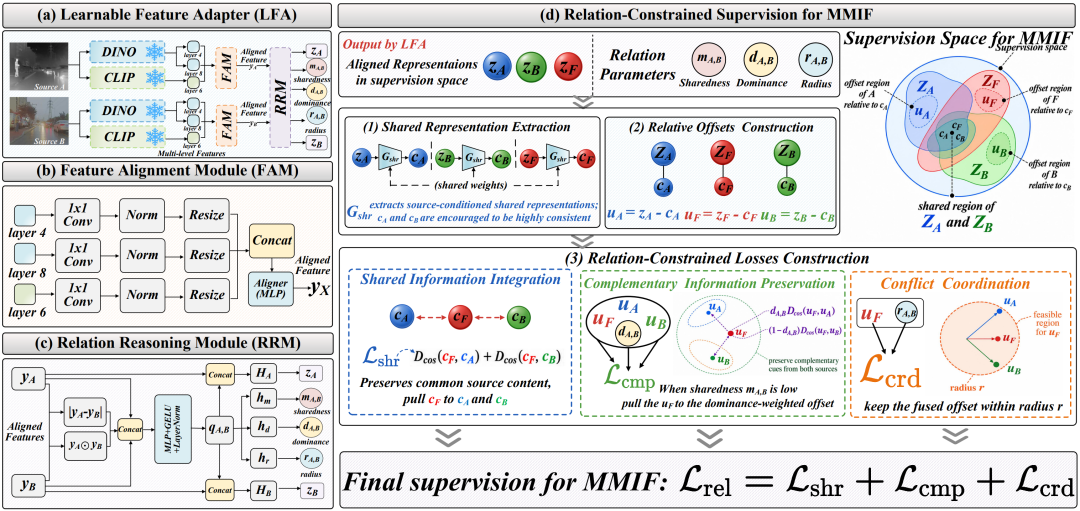
论文使用了被冻结的DINO和CLIP来作为特征信息提供者。DINO第4、8层以及CLIP第6层的特征,先经过Feature Alignment Module(FAM),再经过1×1卷积、归一化、尺寸对齐、MLP映射到统一token空间;然后由RelationReasoningModule(简称RRM)联合推理出两张源图之间的共享部分、非共享信息偏爱以及协调半径。
LFA(Learnable Feature Adapter)就是其中的核心:预训练模型只提供了结构和语义特征,真正起“怎样监督融合”作用的是可学习适配器。它产生一对条件表征zA、zB,以及三个关系参数m、d、r。
02.1 LFA 为什么能够理解跨模态的关系呢?
对于A、B两个源图像,FAM首先让DINO和CLIP在不同层次上的特征投影到同一个token网格中;RRM 再拼接对齐后特征、绝对差和逐元素乘积。绝对差表示模态分歧的程度,逐元素乘积表示局部相似性,这两个量可以给关系推断提供直接线索。
关系编码器
可以学习的关系参数有三个
其中m表示共享性,取值越小,则非共享的信息就越需要重点处理;d 表示非共享成分更倾向于 A 还是 B;r 为允许偏差协调半径。d 不是简单的红外/可见光固定混合权重,而是在于输入图像对的变化关系估计。
02.2 优化的方向是由三者的关系损失来决定的
首先提取出共享成分和相对残差
① 共享信息集成
② 互补的信息仍然有效
③ 冲突协调
总的说来就是关系监督损失
共同的信息被Lshr对齐;非共享的信息由 Lcmp 根据 m、d 自适应地保留下来;Lcrd 是“超过半径才惩罚”的hinge约束。特别重要的就是这三者并不是简单的三次重建,而是在同一个空间中先识别出各种各样的关系,然后再用这些关系来定义出各种各样的损失。
PART 03
三个损失对应三个融合的目标
共享、互补、协调
首先利用共享编码器从源表征中提取出共同的部分,然后把剩下的非共享的信息表示成残差。共享损失要求融合的结果接近共同结构;互补损失根据预测的共享程度以及来源权重来保留残差信息;只有当融合残差大于自适应半径的时候才会对损失进行协调。相比于单纯的将两张源图像相加或者逐像素逼近来更符合作者所定义的融合任务。
Sharedness·共享性
共同的信息应该是稳定的:融合表征的共享部分靠近两种模态各自提取的共享表示,并不是强制复制任何一个源图像。
Complementarity·互补性
非共享的信息并不是噪音:热目标和细节纹理要被保留;对于冲突非常敏感的特性,就用协调半径来控制它的偏移量。
3.1 没有融合GT,适配器怎么学?
监督空间如果自己就不稳定,那么再怎么精心设计出来的损失函数也有可能把融合模型带向错误的方向。作者使用了“真实的配对中两模态之间的相关性大于随机错配”的自监督假设来训练LFA;并且使融合图像和它对应的源图像对之间关系分数大于与错配来源的关系分数。
源图像对排序损失
源-融合图像排序损失
适配器学习目标
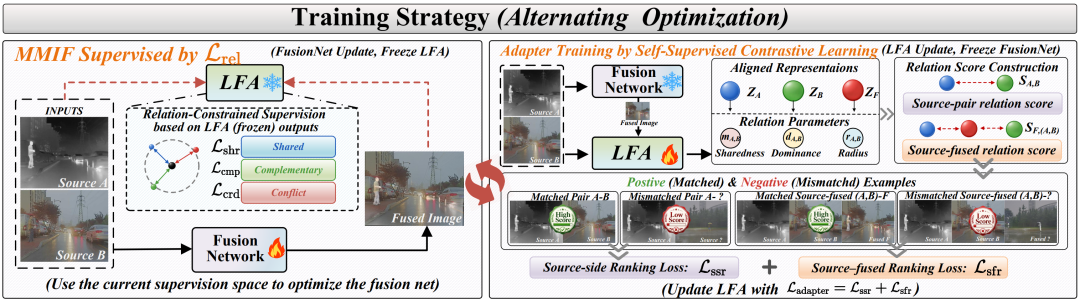
首先使LFA学会评价关系,然后依次更新监督空间和融合网络。
训练分为三个阶段:首先使用传统的损失函数来预热融合网络20个epoch;接着做 50 个 epoch 的适配器预训练;最后进行交替优化 5 轮,在每一轮中首先冻结融合网络、训练 LFA 30 个 epoch,然后冻结 LFA、训练融合网络 20 个 epoch。进入交替阶段之后,融合网络只用关系监督损失,并不加之前的空间域损失。
本文和直接用CLIP、DINO做感知损失的区别在于:监督空间不是一次训练就永久固定的,而是会随着当前融合结果的变化而不断更新。原文把这叫做面向适配器和融合网络的双方向优化。
4 实验:除了提升传统的融合度之外
作者对红外-可见光融合(IVF)、医学图像融合(MIF)这两项任务进行了验证,并且分别适应了CNN、Mamba、Transformer三种骨干网络。训练集包含MSRS(IVF)、Harvard医学院医学影像数据等;测试涵盖了RoadScene、M3FD、MSRS和CT-MRI、MRI-PET、MRI-SPECT等。
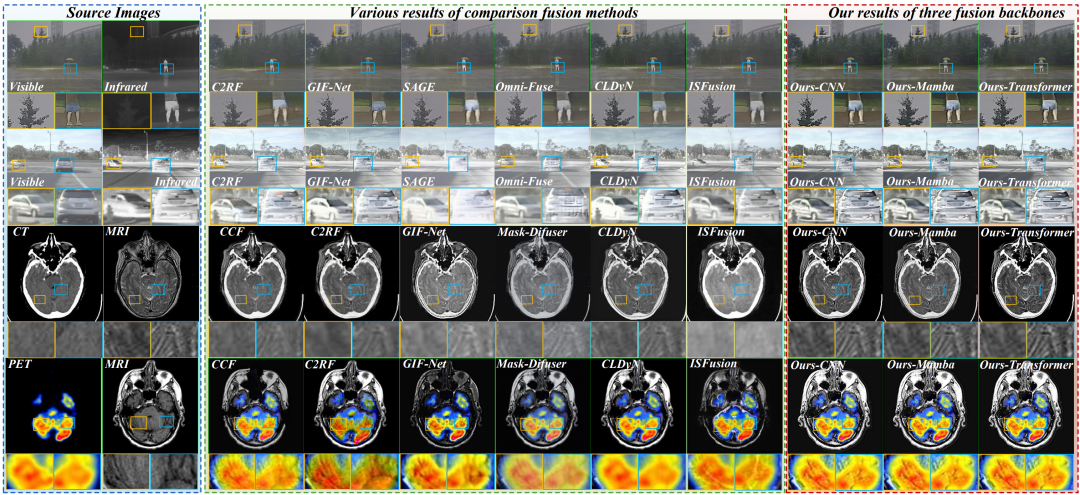
Fig. 4 Infrared target, visible light texture, medical structure and function information visualization comparison.
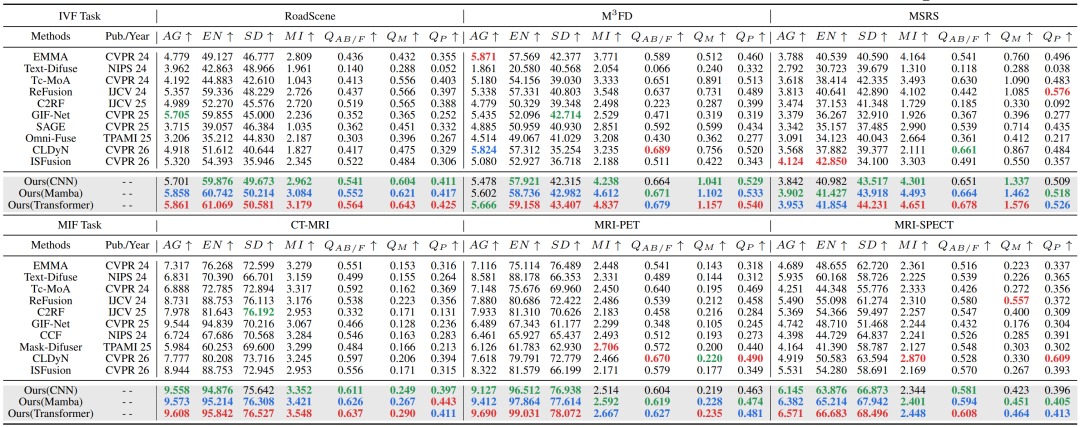
Table 1 三个骨干在六个小组融合的数据上全部指标的比较。
以 RoadScene 为例,Transformer 版本的 AG/EN/QAB/F 分别为 5.861 / 61.069 / 0.564;CLDyN分别为4.918/51.612/0.417。在MRI-PET的任务里,使用了Transformer版本的AG=9.690、EN=99.031。但是不同的方法在一些细分指标上排名不一样,本文也不能简单的说成是“所有的指标都排名第一”。
4.1 将模态冲突进行量化,并不是只展示更加清楚的地图
论文在M3FD高分歧区定义了三个分析指标:冲突比例CR、冲突强度CS和更新不平衡程度UI。对于局部图像块,在保留红外和保留可见的情况下分别计算出融合结果下降的方向,并且用余弦相似度来判断两种更新方式之间是否存在互相抵消的关系。该部分的分析只用来做实验评价,并不会参与到模型训练当中去。
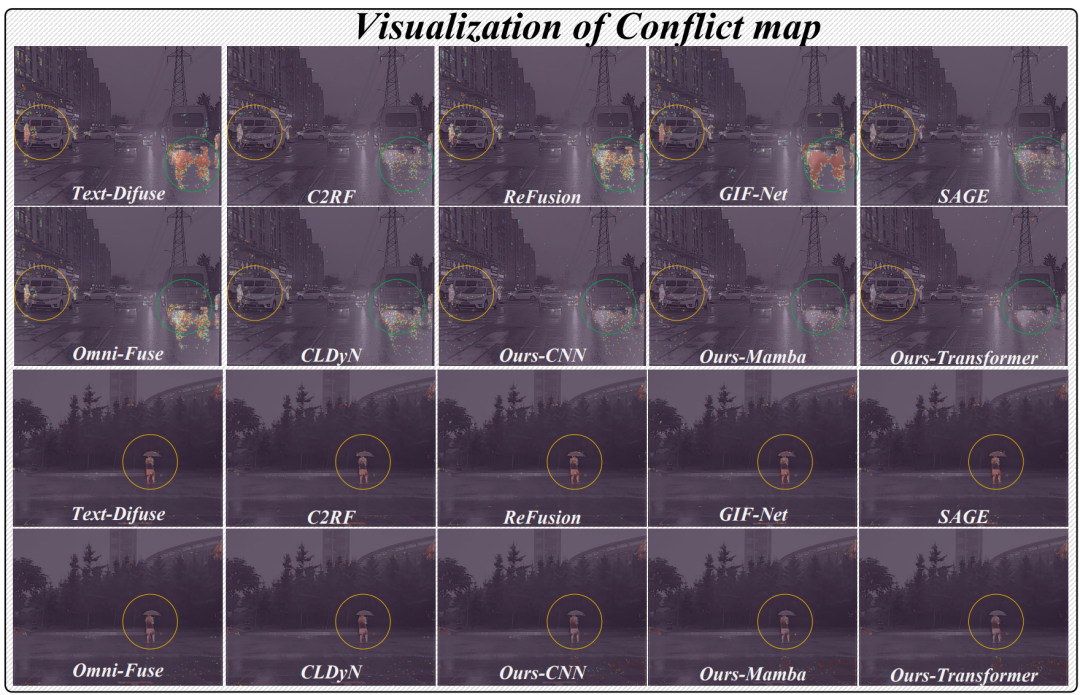
Fig. 5|源保持更新冲突的可视化,红色越明显表示冲突越大。
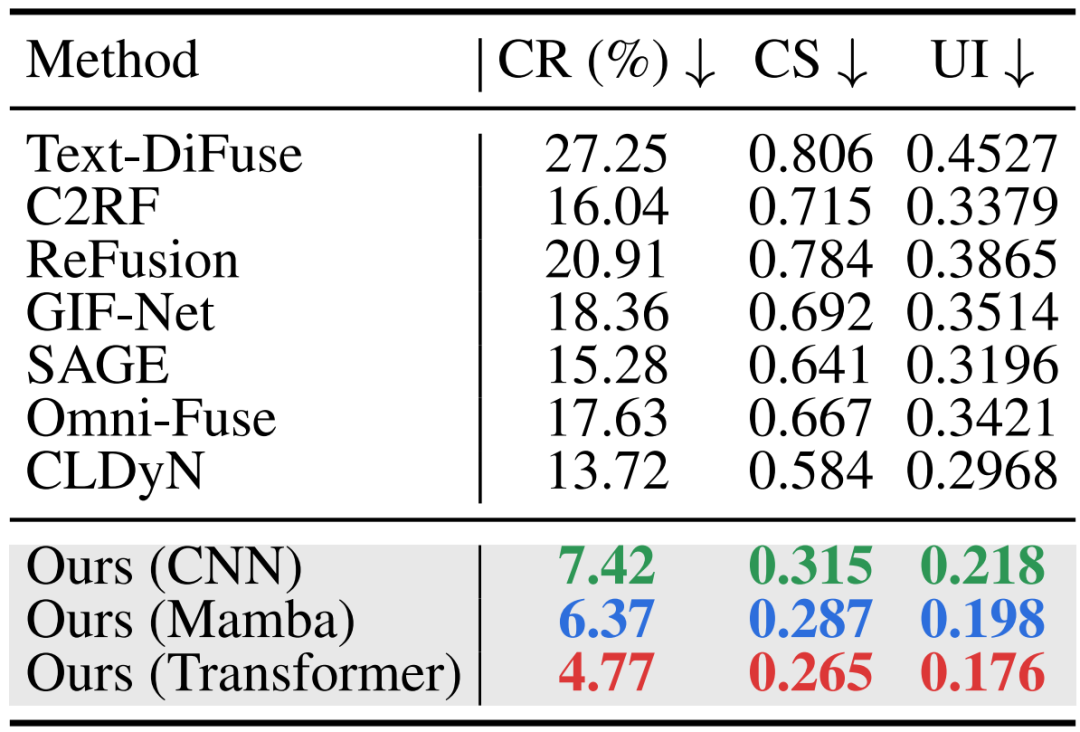
Table 2|M3FD 高分歧区域的 CR、CS 以及 UI 指标。
Table 2 中 CLDyN 的 CR 为 13.72%,本文使用的是 Transformer 版本,其 CR 为 4.77%;相应的CS从0.584降到0.265,UI从0.2968降到0.176。它们一起支持着“减少冲突并且没有靠单边压制来达到低冲突”的实验解释。
4.2 消融:并不是只有DINO/CLIP的大模型特征
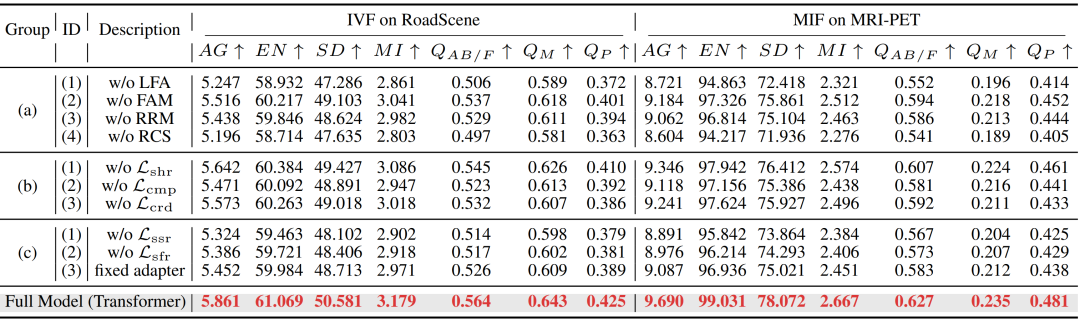
Table 3|去除了LFA、FAM、RRM这三项关系损失以及排序训练所造成的退化。
消融结果显示:移除LFA或者整个RCS系统,性能会大幅度降低;去掉共享、互补、协调损失,以及源端/源—融合端排序损失之后也出现了退化。附录中还对固定的参数、固定的适配器以及联合同时优化进行比较,完整的方案更加稳定。
4.3 下游任务:融合图是否真的起到了作用,即融合图是否真的帮助到了感知?
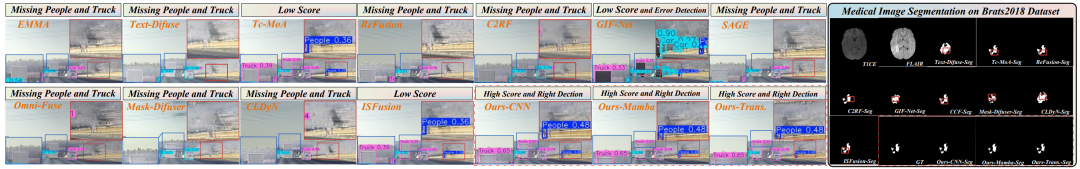
Fig. 6|M3FD 目标检测、BraTS2018 脑肿瘤分割可视化。
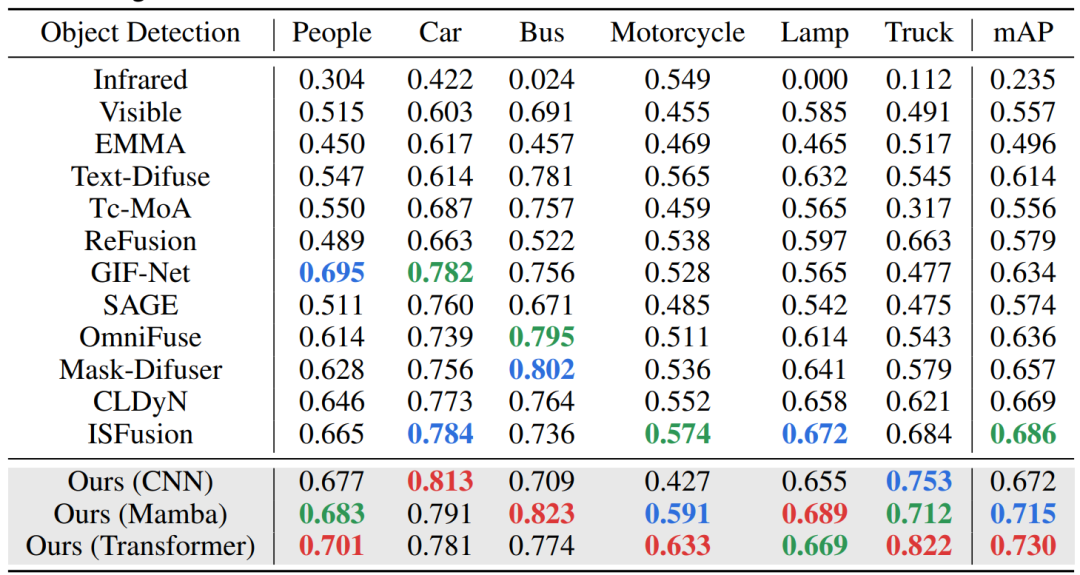
Table 4 不进行微调的情况下,各个融合方法所对应的的目标检测mAP。
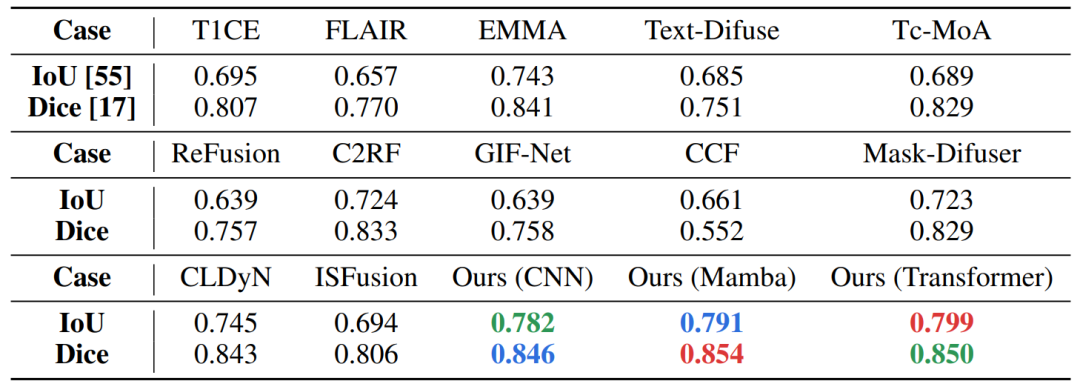
Table 5:医学分割的IoU和Dice。
使用相同的预训练YOLOv12检测器,在没有微调的情况下,本文Transformer版本在M3FD上得到的mAP为0.730。表中ISFusion为0.686;在医学分割中使用Transformer版本的IoU是0.799,而Mamba版本的Dice系数为0.854。上述结果来自于论文中的表格,并不是在另外一种设置下单独复现出来的。
4.4 一些额外的亮点是:可以为已经存在的融合网络更换“监督规则”
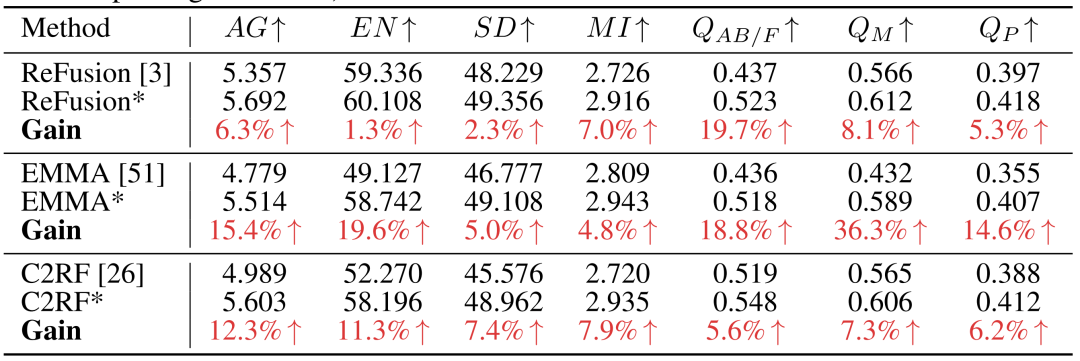
Table 6:ReFusion、EMMA、C2RF 替换原来的监督之后得到的提高。
附录Table 6 保持原来的模型结构以及训练参数设置,只是把关系监督的方式换掉。在RoadScene上,ReFusion、EMMA和C2RF这七个报告指标都得到了提升。该组数据表明论文的价值并不只限于它自带的CNN/Mamba/Transformer骨干,监督范式本身也具有一定的可迁移性。
5 讨论:本文究竟带来了哪些改变?
亮点一:把“学什么像素”的问题变成“学什么关系”的问题。作者把多模态融合的三个主要目标显式地转化为监督空间约束,在这个层面上的创新往往要比继续堆积特征交互模块更有价值去研究。
亮点二:预训练特征不能直接被融合。DINO/CLIP 信息源被冻结了,LFA 和共享编码器把来自不同来源的信息进行整理,并形成可以指导融合的关系,而不应该把预训练模型简单地当作万能判别器。
亮点三:增加了有关“冲突的变化情况”方面的证据。CR、CS、UI 把不同的模态造成的影响拉扯得具体一些,并且结合下游感知的结果来实现“融合更均衡”的目标,不仅仅停留在主观的图像观感上。
如果你在研究红外-可见光融合的话,这篇论文最有价值的思想就是:融合并不一定缺少更强大的骨干,也有可能缺少一个真正符合融合目的的监督信号。
往期推荐