🏆 本文收录于 《滚雪球学 Spring Boot 3.x》 专栏,专注 Spring Boot 3.x 系统学习与实战进阶,内容持续更新中。
本专栏致力于打造高质量、体系化的 Spring Boot 3.x 学习路线,从零基础入门到进阶实战,帮助你快速掌握核心知识与企业级开发经验。 📌 想快速定位学习内容,可查看:【Spring Boot 3 教程导航帖】
🎉 当前专栏限时优惠中:一次订阅,终身阅读,后续更新章节全部免费解锁 👉 立即订阅 👈️ 🎁 想系统打通 Spring Boot 各主流版本?还可以查看: 👉 《Spring Boot 2.x 实战》 👉 《Spring Boot 3.x 实战》 👉 《Spring Boot 4.x 实战》
🚀 推荐合集:《Spring Boot 全栈实战合集》,一站式覆盖 Spring Boot 2.x、3.x、4.x 核心特性、项目实战与架构进阶内容。
演示环境说明:
- 开发工具:IDEA 2021.3
- JDK版本: JDK 17(推荐使用 JDK 17 或更高版本,因为 Spring Boot 3.x 系列要求 Java 17,Spring Boot 3.5.4 基于 Spring Framework 6.x 和 Jakarta EE 9,它们都要求至少 JDK 17。)
- Spring Boot版本:3.5.4(于25年7月24日发布)
- Maven版本:3.8.2 (或更高)
- Gradle:(如果使用 Gradle 构建工具的话):推荐使用 Gradle 7.5 或更高版本,确保与 JDK 17 兼容。
- 操作系统:Windows 11
全文目录:
- 1. 为什么这个主题值得放进 Spring Boot 3 专栏
- 2. Spring Boot 3.x 学习这类问题时要先建立什么技术基线
-
- 2.1 Spring Boot 3.x 的技术前提
- 2.2 本文的知识目标
- 2.3 文章中的工程约定
- 3. Kafka Producer 发送链路全景:从业务代码到 Broker 落盘
-
- 3.1 从业务调用角度看发送链路
- 3.2 绘图看整体链路
- 3.3 几个关键内部类必须先认识
-
- (1)KafkaProducer
- (2)RecordAccumulator
- (3)Sender
- (4)TransactionManager
- (5)ProducerStateManager(Broker 端)
- 4. 为什么会出现重复消息、乱序、半成功、跨主题不一致
-
- 4.1 最典型的重复场景
- 4.2 乱序从哪里来
- 4.3 跨多个 Topic/Partition 的“半成功”
- 4.4 为什么业务层去重不等于 Kafka 幂等
- 5. 幂等生产者:解决了什么问题,没有解决什么问题
-
- 5.1 什么叫幂等生产者
- 5.2 幂等生产者主要依赖哪些条件
-
- (1)为什么必须 `acks=all`
- (2)为什么必须 `retries>0`
- (3)为什么 `max.in.flight` 不能太大
- 5.3 幂等生产者的核心机制:PID + Sequence
- 5.4 幂等生产者没有解决什么问题
-
- (1)没有解决跨多个 Topic/Partition 的原子提交
- (2)没有解决跨 Producer Session 的完整语义
- (3)没有解决业务层主动重复发送
- (4)没有解决消费端看到未完成事务的问题
- 6. 事务生产者:在幂等之上又补了哪些能力
-
- 6.1 事务生产者的本质
- 6.2 为什么事务一定建立在幂等之上
- 6.3 事务生产者相比幂等多了什么
-
- (1)事务身份:`transactional.id`
- (2)事务状态机
- (3)事务协调器与事务日志
- (4)消费者可见性控制
- 6.4 事务生产者能解决哪些场景
- 7. 源码级对比:幂等生产者与事务生产者到底差在哪
-
- 7.1 两者共用的底座:KafkaProducer 还是同一个入口
- 7.2 源码视角下的共同点
- 7.3 第一层区别:是否显式开启事务 API
- 7.4 第二层区别:状态机复杂度不同
- 7.5 第三层区别:事务生产者需要 `transactional.id`
- 7.6 第四层区别:是否要向事务中注册分区
- 7.7 第五层区别:是否要生成事务完成标记
- 7.8 第六层区别:消费端协作要求不同
- 7.9 用表格总结源码级差异
- 7.10 从 Spring Boot 3.x 角度再翻译一次
- 8. Spring Boot 3.x 下的工程化接入思路
-
- 8.1 为什么不建议把所有 Producer 都做成事务型
- 8.2 本文案例的项目结构
- 8.3 Maven 依赖
-
- 代码解析
- 8.4 基础配置文件
-
- 配置解析
- 9. 可运行案例一:幂等生产者实战
-
- 9.1 主题配置
-
- 代码解析
- 9.2 定义订单事件 DTO
-
- 代码解析
- 9.3 幂等 Producer 配置
-
- 代码解析
- 9.4 幂等发送服务
-
- 代码解析
- 9.5 控制器:触发幂等发送
-
- 代码解析
- 9.6 幂等案例小结
- 10. 可运行案例二:事务生产者实战
-
- 10.1 定义事务相关 DTO
- 10.2 事务 Producer 配置
-
- 代码解析
-
- (1)事务 ProducerFactory 和幂等 ProducerFactory 是两套
- (2)`setTransactionIdPrefix()` 是 Spring 风格的重要桥接点
- (3)为什么要有 `KafkaTransactionManager`
- 10.3 事务发送服务
-
- 代码解析
- 10.4 从源码角度理解 `executeInTransaction`
- 10.5 为什么事务型模板不建议在事务外随便发
- 10.6 用 Mermaid 看事务型发送路径
- 11. 可运行案例三:数据库与 Kafka 发送协同的设计思路
-
- 11.1 先说结论:Kafka 事务 ≠ 数据库 + Kafka 的全局 XA
- 11.2 为什么业务上还会把它们一起使用
- 11.3 本文给出的教学方案:本地事务 + Kafka 发送协同
-
- 实体类
- Repository
- 协同服务
- 代码解析
- 11.4 为什么很多公司最终会落到 Outbox Pattern
- 12. 消费端如何配合事务生产者实现端到端语义
-
- 12.1 为什么消费者要关心事务
- 12.2 `read_committed` 的意义
- 12.3 简单消费者示例
-
- 代码解析
- 13. 深入源码思维:为什么说事务生产者比幂等生产者“重得多”
-
- 13.1 幂等的核心复杂度在哪里
- 13.2 事务的核心复杂度在哪里
- 13.3 为什么事务异常常常比幂等异常更难处理
- 14. 高频误区与线上避坑
-
- 14.1 误区一:开启幂等就等于彻底没有重复消息
- 14.2 误区二:事务生产者就是“更强的幂等”
- 14.3 误区三:事务型 KafkaTemplate 可以当普通模板随便用
- 14.4 误区四:Kafka 事务能直接解决数据库与消息的一切一致性问题
- 14.5 误区五:消费者不配 `read_committed` 也没关系
- 14.6 误区六:所有业务都应该上事务 Producer
- 15. 一图总结:幂等与事务的关系
- 16. 面试题与答题模板
-
- 16.1 面试题:Kafka 幂等生产者和事务生产者有什么区别?
-
- 参考回答
- 16.2 面试题:为什么事务一定需要 `transactional.id`?
-
- 参考回答
- 16.3 面试题:幂等能保证 exactly-once 吗?
-
- 参考回答
- 17. 全文总结
-
- 17.1 从概念上总结
- 17.2 从源码思路上总结
- 17.3 从 Spring Boot 3.x 工程实践上总结
- 17.4 给零基础读者的学习建议
- 课后思考题
- 小结
- 🧧 学习福利 · 限时开放 🧧
- 🫵 Who am I?
1. 为什么这个主题值得放进 Spring Boot 3 专栏
很多同学第一次接触 Kafka 时,会把注意力放在三个表面问题上:
- 生产者怎么发消息;
- 消费者怎么收消息;
- Spring Boot 怎么配 application.yml。
但真正到了线上,决定系统稳定性的往往不是“能不能发”,而是:
- 失败重试时会不会出现重复消息;
- 多条消息要么一起成功,要么一起失败时怎么办;
- 跨多个 Topic 的写入是否原子;
- 业务服务重启、Broker 故障、网络抖动后语义是否还能成立;
- Spring Boot 中的 KafkaTemplate、ProducerFactory、事务管理器到底把底层封装成了什么样子。
而“Kafka 幂等生产者”与“Kafka 事务生产者”正好就是这几个问题的核心答案。
对初学者来说,这两个概念最容易被混淆:
- 幂等生产者:很多人以为“开启幂等 = 完整 exactly-once”。
- 事务生产者:很多人又以为“事务生产者 = 幂等生产者多了一个 commit()”。
实际上,这两者虽然相关,但保证边界完全不同。
如果你只是记住:
- enable.idempotence=true 可以去重;
- transactional.id 可以事务;
那么你在面试和项目里都还停留在“会背配置”的阶段。
真正的进阶点是:
所以,这篇文章会有意采用“从浅入深”的写法:先把概念说清,再进入源码级差异,最后落到 Spring Boot 3.x 工程实践。
2. Spring Boot 3.x 学习这类问题时要先建立什么技术基线
在进入 Kafka 细节之前,我们要先明确本文的技术上下文。
2.1 Spring Boot 3.x 的技术前提
Spring Boot 3.x 相比 2.x,有几个你必须知道的基础变化:
对于本文主题来说,最重要的一点是:
在 Spring Boot 3.x 中,你学习 Kafka 事务,不应该只盯着原生 KafkaProducer API;你还要理解 Spring 的 ProducerFactory、KafkaTemplate、KafkaTransactionManager 是如何把底层事务能力桥接到业务代码的。
2.2 本文的知识目标
读完本文,你至少应该能回答以下问题:
- 为什么 Kafka 生产者在重试时可能产生重复消息?
- 幂等生产者如何借助 PID、sequence number、broker 端状态记录 去重?
- 事务生产者为什么要有 transactional.id?它和幂等的关系是什么?
- 为什么“幂等”主要解决单分区、单会话下的重复写入问题,而事务可以把多个分区/多个 Topic 的写入变成一个原子单元?
- Spring Boot 3.x 下如何分别配置幂等生产者和事务生产者?
- KafkaTemplate 在事务模式下为什么会要求在事务上下文中使用?
- 消费端如果不配 read_committed,事务生产者的价值为什么会打折?
2.3 文章中的工程约定
为了让案例更贴近真实项目,本文统一采用如下约定:
- Java 17
- Spring Boot 3.3.x 风格项目
- spring-kafka 3.x 体系
- 消息体使用 JSON
- 案例领域采用“订单创建 / 审计日志 / 库存预占”这样的电商语义
这套约定既适合入门,也方便你以后迁移到真实业务。
3. Kafka Producer 发送链路全景:从业务代码到 Broker 落盘
在对比幂等生产者与事务生产者之前,先要弄明白:普通 Producer 到底是怎么把一条消息发出去的。
如果这个链路不清楚,你后面看到 PID、Sequence、TxnCoordinator、事务状态机时会觉得像“凭空多出来的一层魔法”。
3.1 从业务调用角度看发送链路
在 Spring Boot 3.x 项目里,我们最常见的发送代码通常长这样:
kafkaTemplate.send("order-events", orderNo, event);
表面上就一行,但底下至少经过了以下环节:
这条链路中,幂等机制与事务机制都不是“额外插一个 if 判断”那么简单,而是嵌入到了生产者状态管理、批次管理、请求协议和 Broker 状态校验里面。
3.2 绘图看整体链路
示意图绘制如下,仅供参考:
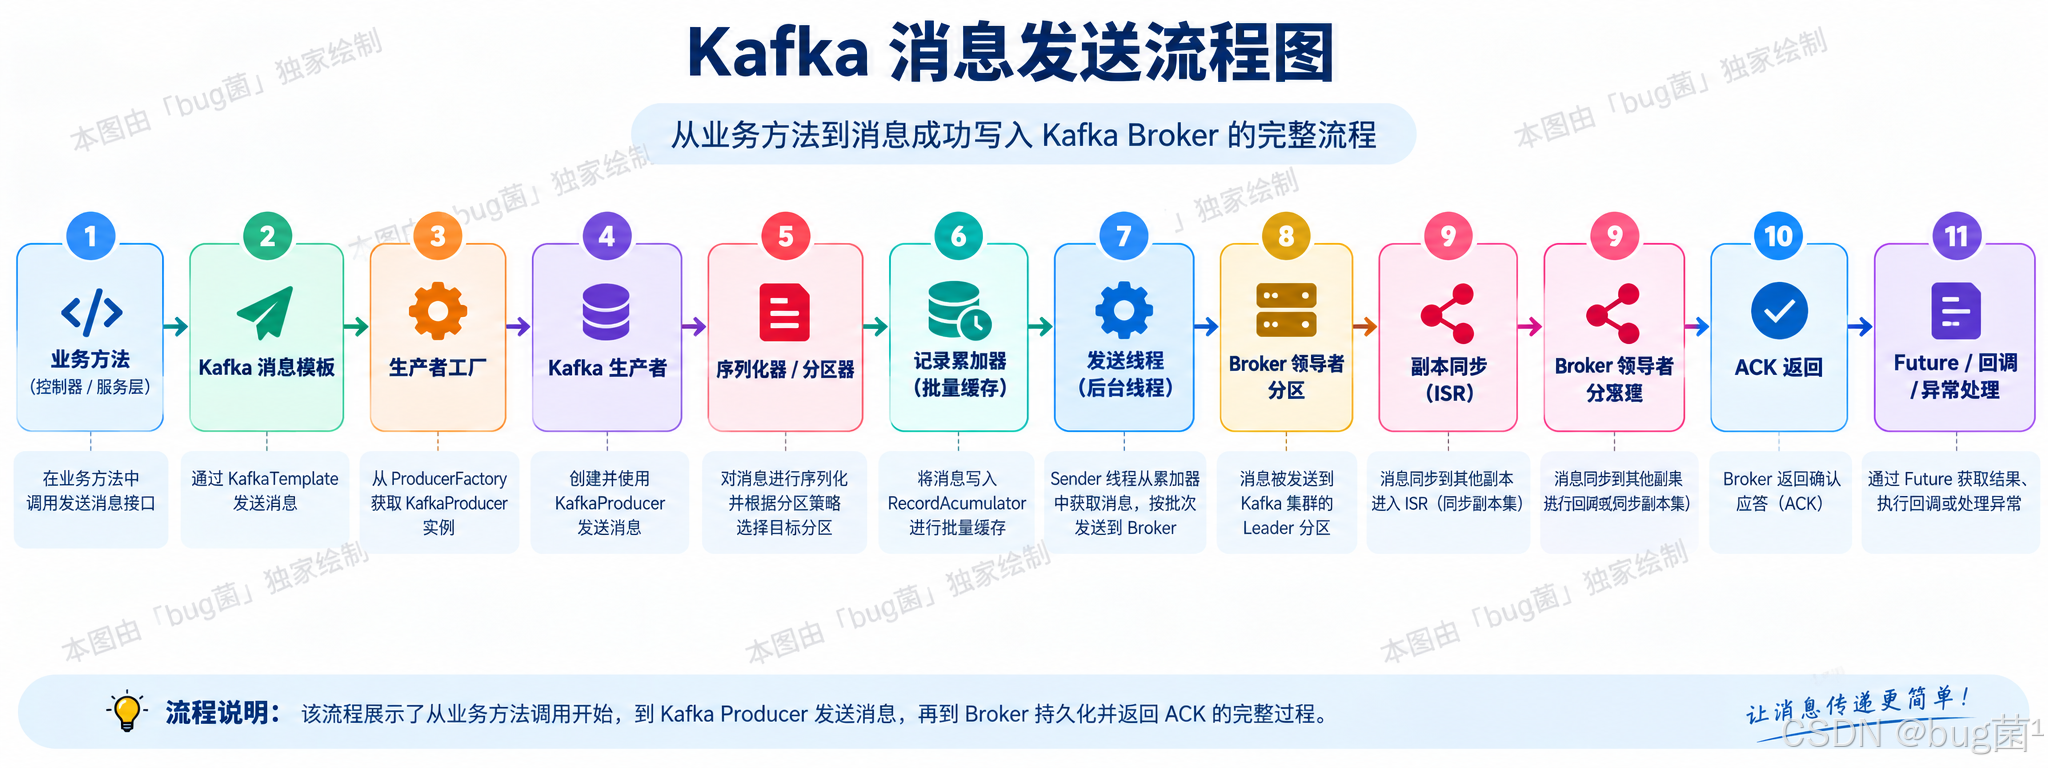
这个图先记住,后面我们会在这个图上不断“加层”:
- 幂等生产者会在 KafkaProducer → Broker 这条链路上增加 Producer 身份与序列校验;
- 事务生产者会再增加 事务状态机、分区注册、提交/回滚标记、消费者可见性控制。
3.3 几个关键内部类必须先认识
后面分析源码时,你会频繁见到下面这些类名:
(1)KafkaProducer
客户端入口。发送、flush、事务 API 都在这里暴露。无论是普通发送、幂等发送还是事务发送,最外层都是这个类。
(2)RecordAccumulator
消息并不是一条一条立刻发出去,而是先按分区聚合成批次。这个累加器决定了 Producer 的吞吐与批量发送行为。
(3)Sender
真正负责网络 I/O 的后台线程。业务线程把消息塞进缓存,真正的发送工作主要由它完成。
(4)TransactionManager
名字虽然叫“TransactionManager”,但它在 Kafka Producer 里并不只服务于显式事务。它本质上承担了Producer 侧身份、序列、事务状态等管理工作。后面你会看到,幂等和事务在这里就开始分层了。
(5)ProducerStateManager(Broker 端)
这是 Broker 端的重要状态组件。它维护某个分区中 Producer 的写入元数据,比如最后的 sequence、epoch、offset 等。幂等之所以能成立,不是客户端自己说“我去重了”就行,而是 Broker 端也必须记状态并做校验。
把这五个角色建立起来,你再看源码差异会清晰很多。
4. 为什么会出现重复消息、乱序、半成功、跨主题不一致
很多人学 Kafka 时会先背“消息中间件默认至少一次”,但并没有把这个结论拆开理解。
实际上,重复消息的产生并不神秘,它来自于两个非常朴素的事实:
问题就在于:客户端并不总能准确知道上一条请求到底是“没成功”,还是“成功了但 ACK 丢了”。
4.1 最典型的重复场景
举个最经典的例子。
对于 Broker 来说,如果没有额外机制,它根本不知道第二次是不是“第一次的重试”,还是“业务真的要再发一条同样内容的消息”。于是重复消息就出现了。
4.2 乱序从哪里来
另一个经常被忽略的问题是乱序。
比如同一分区内有两个批次:
- 批次 A 先发;
- 批次 B 后发;
- A 因网络问题失败,B 却先成功;
- A 重试成功。
那么最终 Broker 看到的顺序就可能是 B 在前,A 在后。这时不仅重复有风险,顺序也会被打乱。
4.3 跨多个 Topic/Partition 的“半成功”
普通 Producer 还有一个非常现实的问题:
假设你的业务逻辑是:
- 发一条订单主消息到 order-events;
- 再发一条审计消息到 audit-events;
- 再发一条库存预占消息到 stock-events。
如果前两条成功,第三条失败,那么系统就会进入一种尴尬状态:
- 主流程看起来订单已经创建;
- 审计日志也记下来了;
- 但库存预占没通知出去。
这时候就不是“重复”问题,而是“跨多条消息、多个主题的原子一致性”问题。幂等生产者解决不了这个问题,事务生产者才是为这个场景设计的。
4.4 为什么业务层去重不等于 Kafka 幂等
有些同学会说:“那我自己给消息加一个全局唯一 ID,不就能消费端去重了吗?”
这种做法当然有价值,但它和 Kafka 幂等不是一个层次:
- 业务去重,是你在业务语义层补偿;
- Kafka 幂等,是客户端和 Broker 在消息写入协议层做去重。
两者不是互斥关系,而是上下两层:
- 协议层尽量不产生重复;
- 业务层仍然要对关键操作保持幂等意识。
这也是为什么成熟系统不会只迷信某一个开关,而是把“消息协议语义 + 业务语义”同时设计好。
5. 幂等生产者:解决了什么问题,没有解决什么问题
现在我们正式进入幂等生产者。
5.1 什么叫幂等生产者
Kafka 幂等生产者的目标非常明确:
当同一个 Producer 因重试导致同一条记录被重复发送时,Broker 能够识别出“这其实是同一条逻辑消息的重发”,从而避免把它写成多份重复数据。
注意这里有几个关键词:
- 同一个 Producer;
- 重试导致的重复发送;
- Broker 能识别重发。
也就是说,幂等生产者并不是“把所有重复消息都消灭”,它的能力边界是有前提的。
5.2 幂等生产者主要依赖哪些条件
要让幂等真正成立,Kafka 对 Producer 配置有明确要求:
- enable.idempotence=true
- acks=all
- retries>0
- max.in.flight.requests.per.connection<=5
很多初学者把这几项当成死记硬背,其实它们背后都有原因:
(1)为什么必须 acks=all
因为幂等不是只追求“没重复”,还要尽量避免在主从切换下造成语义不一致。acks=all 表示 Leader 要等 ISR 副本都确认后再返回,语义最强。
(2)为什么必须 retries>0
如果你根本不重试,那幂等去重机制就失去主要价值了。幂等本来就是为“可安全重试”服务的。
(3)为什么 max.in.flight 不能太大
因为 Broker 侧只会为每个 Producer 保留有限数量的批次序列窗口。如果同时挂起太多未确认请求,会让顺序控制和重复检测变复杂,甚至破坏保证。
5.3 幂等生产者的核心机制:PID + Sequence
幂等并不是靠“消息体内容相同就判重”,那样太不可靠。Kafka 的设计更底层,它依赖的是:
- Producer ID(PID):给生产者分配一个身份;
- Sequence Number:针对分区写入递增序号;
- Broker 端状态记录:Broker 记住这个 Producer 在这个分区最后成功写到了哪个序号。
于是一个简化后的思路就是:
Producer 拿到 PID;
Producer 向某个分区发批次时附带 sequence;
Broker 收到后检查:
- 如果 sequence 正好是期望值,说明是正常新写入;
- 如果 sequence 比期望值小,说明可能是重复重试;
- 如果 sequence 不连续,说明可能出现乱序或状态异常。
这就是幂等能成立的根本原因:不是客户端单边承诺,而是客户端携带状态,Broker 严格校验状态。
5.4 幂等生产者没有解决什么问题
这是最关键的一段。
幂等生产者主要没有解决下面几类问题:
(1)没有解决跨多个 Topic/Partition 的原子提交
你连续发三条消息,其中前两条成功,第三条失败。幂等不会帮你把前两条自动回滚。
(2)没有解决跨 Producer Session 的完整语义
如果 Producer 重启了,新的进程虽然可以重新建立状态,但“上一轮会话中的业务重复提交”并不是幂等机制天然全兜底的。
(3)没有解决业务层主动重复发送
如果你的应用代码自己调用了两次 send(),即便消息内容一模一样,Kafka 也不会把它们简单当成“重复重试”处理,因为从协议角度看,它们就是两次独立发送。
(4)没有解决消费端看到未完成事务的问题
这听起来像事务才有的问题,没错——因为幂等根本不控制“多条消息作为一个事务单元的可见性”。
所以一句话概括:
幂等生产者解决的是“单 Producer 在可重试发送时的重复写入问题”,而不是“分布式事务的一致性问题”。
6. 事务生产者:在幂等之上又补了哪些能力
理解了幂等之后,再看事务就容易了。
6.1 事务生产者的本质
事务生产者本质上是在幂等基础上进一步增强,使得 Producer 可以把:
- 多条消息;
- 多个分区;
- 多个 Topic;
- 甚至消费位点提交(offset commit)
组成一个原子事务单元。
也就是说,事务生产者不是简单地“去重更强一点”,而是让 Kafka 具备了:
- 要么全部成功可见;
- 要么全部失败不可见;
这样的提交语义。
6.2 为什么事务一定建立在幂等之上
因为事务的前提就是:
- 事务内的每次发送不能因为重试而产生副作用;
- 同一个事务过程中的批次、分区、状态变更必须可识别;
- Producer 重启后还要能进行事务恢复和旧实例隔离。
所以 Kafka 的设计是:
一旦你配置了 transactional.id,幂等会被自动启用。
这不是“框架善意附赠”,而是协议层设计要求。
6.3 事务生产者相比幂等多了什么
至少多了四层能力:
(1)事务身份:transactional.id
幂等只需要把“当前 Producer 会话”识别出来;
事务则需要一个更稳定的逻辑身份,让 Producer 在重启后还能恢复事务语义,并且对旧实例进行 fencing(围栏隔离)。这就是 transactional.id 的意义。
(2)事务状态机
事务不是发完就结束,它至少有:
- 初始化事务;
- 开启事务;
- 向事务中加入分区;
- 发送消息;
- 提交事务;
- 回滚事务。
这意味着客户端要维护一个严格状态机,Broker 也要配合事务协调。
(3)事务协调器与事务日志
事务不是 Producer 自己说了算。Producer 要和事务协调器交互,Broker 集群要记录事务状态。这也是为什么事务比单纯幂等更重。
(4)消费者可见性控制
事务提交之前,消息并不是对所有消费者都等价可见。只有消费者使用 read_committed,才能真正实现“只读已提交事务消息”的效果。
6.4 事务生产者能解决哪些场景
典型适用场景有:
- 一个订单操作要向多个 Topic 同时发通知;
- 一边消费消息,一边处理业务,再把结果写回 Kafka,并希望 offset 提交与结果发送保持原子性;
- 流处理场景中需要更强的一致性语义。
但也要注意:
Kafka 事务不是万金油,它并不等于跨数据库、缓存、RPC、消息系统的全局 XA。
这点在 Spring Boot 项目里尤其要讲清楚,否则很容易把 Kafka 事务误用成“万能分布式事务”。
7. 源码级对比:幂等生产者与事务生产者到底差在哪
这一节是全文核心。我们不满足于停留在“配置不同”,而是要看源码层面的能力差异。
7.1 两者共用的底座:KafkaProducer 还是同一个入口
不管你是普通 Producer、幂等 Producer 还是事务 Producer,最外层都是 KafkaProducer。
这说明一个重要事实:
Kafka 没有为事务单独造一个完全不同的 Producer 类,而是在同一个 Producer 主体里,通过配置、状态管理和协议行为,让不同模式呈现出不同语义。
也就是说,幂等与事务不是“两个平行产品”,而是同一套 Producer 体系下的不同工作模式。
7.2 源码视角下的共同点
两者的共同点包括:
这也是为什么很多人第一次读源码时会疑惑:
“为什么幂等和事务都和 TransactionManager 有关系?”
答案是:因为 Kafka 这里的 TransactionManager 并不只是“提交/回滚事务管理器”那么狭义,它承担的是更广义的 Producer 状态协调。
7.3 第一层区别:是否显式开启事务 API
幂等生产者对业务代码来说几乎是“无感”的。你还是像普通 Producer 一样调用:
producer.send(record);
你通常不会额外写:
- initTransactions()
- beginTransaction()
- commitTransaction()
- abortTransaction()
但事务生产者不同,它在原生 API 层明确引入了一整套事务方法。
也就是说,幂等主要是发送协议增强,事务则是明确暴露给业务使用的事务编排模型。
7.4 第二层区别:状态机复杂度不同
幂等生产者虽然也有 Producer 身份和 sequence 管理,但业务线程并不需要显式控制“事务开始 / 提交 / 回滚”的状态。
事务生产者则必须维护更复杂的状态机。你从源码类 TransactionManager 就能看出来,它要处理的状态切换远比幂等模式复杂得多:
- 是否已经初始化事务;
- 当前是否在事务中;
- 是否正在提交事务;
- 是否正在回滚事务;
- 是否已经进入不可恢复错误状态;
- 是否要把某个分区加入当前事务;
- 是否要把消费位点也纳入事务。
换句话说:
幂等关注的是“单次发送重试的正确性”,事务关注的是“一个事务生命周期内所有动作的正确性”。
7.5 第三层区别:事务生产者需要 transactional.id
幂等可以只在当前 Producer 会话内工作,而事务需要一个更稳定的逻辑身份。
这个身份就是 transactional.id。
它的意义至少有三个:
所以你可以把它理解成:
- 幂等:更像“当前会话的安全重试”;
- 事务:更像“带身份恢复能力的安全事务写入”。
7.6 第四层区别:是否要向事务中注册分区
事务生产者在发送过程中,会把涉及到的分区逐步加入事务上下文。
这一步很重要,因为事务提交时,Broker 必须知道:
- 这个事务涉及哪些分区;
- 这些分区上的数据应该被一起标记为已提交,还是一起标记为已回滚。
幂等生产者不需要做这种“事务参与分区收集”,因为它不维护跨分区原子单元。
7.7 第五层区别:是否要生成事务完成标记
事务提交或回滚后,Kafka 不只是“客户端本地认为结束了”,它还会在日志层面留下事务完成标记。
这样消费者在 read_committed 模式下才能区分:
- 哪些记录属于已提交事务,可读;
- 哪些记录属于已回滚事务,不可读。
幂等生产者没有这套事务完成标记机制,因为它没有事务边界。
7.8 第六层区别:消费端协作要求不同
幂等生产者大多只影响生产端去重行为,对消费端配置没有那么强的耦合要求。
事务生产者则不同——如果你的消费者仍然用 read_uncommitted,那么未提交或已回滚事务中的记录可能仍然以某种形式被看到,事务语义就不完整了。
这说明:
幂等更像 Producer 单边增强;事务则是 Producer、Broker、Consumer 三方协作协议。
7.9 用表格总结源码级差异
| 目标 | 防止重试造成重复写入 | 保证多条消息/多分区/多 Topic 原子提交 |
| 入口类 | KafkaProducer | KafkaProducer |
| 是否自动启用幂等 | 是自身能力 | 是,且事务会隐式开启幂等 |
| 是否要求 transactional.id | 否 | 是 |
| 是否需要显式事务 API | 否 | 是:initTransactions/begin/commit/abort |
| 状态管理复杂度 | 中等 | 高 |
| 是否注册事务参与分区 | 否 | 是 |
| 是否有提交/回滚标记 | 否 | 是 |
| 消费端是否强依赖 read_committed | 不强依赖 | 强依赖 |
| 典型问题边界 | 单 Producer 重试去重 | 原子写入与端到端事务语义 |
7.10 从 Spring Boot 3.x 角度再翻译一次
在 Spring Boot 3.x 项目里,上述差异会表现为:
- 幂等生产者:你主要在 ProducerFactory 或属性中增强底层发送语义,业务代码调用方式几乎不变;
- 事务生产者:你除了配置 ProducerFactory 外,还会引入 KafkaTransactionManager、事务型 KafkaTemplate、executeInTransaction() 或 @Transactional 等 Spring 事务接入方式。
所以从工程体验来说:
幂等更像“升级发送器”;事务更像“建立一套新的发送编排模型”。
8. Spring Boot 3.x 下的工程化接入思路
这一节正式进入代码实践前的设计。
8.1 为什么不建议把所有 Producer 都做成事务型
很多初学者知道事务更强,就会想:
“那我直接所有 Producer 都上事务,不就最稳了吗?”
现实里一般不这么做,原因有三:
所以比较合理的工程设计是:
- 普通业务通知:优先考虑幂等生产者;
- 跨多个 Topic 的原子事件发布:使用事务生产者;
- 涉及数据库与消息协同:根据一致性要求选择“事务同步 + 补偿 / Outbox / Kafka 事务”等不同方案。
8.2 本文案例的项目结构
下面我们准备一套结构清晰的 Spring Boot 3.x 示例工程:
src/main/java/com/example/kafkademo
├── KafkaProducerDemoApplication.java
├── config
│ ├── KafkaTopicsConfig.java
│ ├── IdempotentProducerConfig.java
│ ├── TransactionalProducerConfig.java
│ └── ConsumerConfig.java
├── controller
│ └── OrderEventController.java
├── dto
│ ├── AuditEvent.java
│ ├── OrderCreatedEvent.java
│ └── StockReservedEvent.java
├── entity
│ └── OrderLog.java
├── repository
│ └── OrderLogRepository.java
├── service
│ ├── IdempotentOrderProducerService.java
│ ├── TransactionalOrderProducerService.java
│ ├── OrderLocalTransactionService.java
│ └── OrderEventConsumer.java
└── util
└── JsonUtil.java
这个工程的好处是:
- 幂等案例和事务案例分开;
- 代码之间可以共用 DTO;
- 后面做数据库协同示例时也方便扩展;
- 符合真实项目“配置层、服务层、控制层”分层习惯。
8.3 Maven 依赖
下面是一份适合本文案例的 pom.xml。它不是极简依赖,而是有意保留了 Web、Kafka、JPA、H2、测试等模块,便于你后续继续扩展。
<project xmlns="http://maven.apache.org/POM/4.0.0"
xmlns:xsi="http://www.w3.org/2001/XMLSchema-instance"
xsi:schemaLocation="http://maven.apache.org/POM/4.0.0 https://maven.apache.org/xsd/maven-4.0.0.xsd">
<modelVersion>4.0.0</modelVersion>
<parent>
<groupId>org.springframework.boot</groupId>
<artifactId>spring-boot-starter-parent</artifactId>
<version>3.3.0</version>
<relativePath/>
</parent>
<groupId>com.example</groupId>
<artifactId>kafka-producer-demo</artifactId>
<version>1.0.0</version>
<name>kafka-producer-demo</name>
<description>Kafka idempotent and transactional producer demo</description>
<properties>
<java.version>17</java.version>
</properties>
<dependencies>
<!– Web:用于提供测试接口 –>
<dependency>
<groupId>org.springframework.boot</groupId>
<artifactId>spring-boot-starter-web</artifactId>
</dependency>
<!– Kafka:Spring Boot 3.x 集成 Kafka 的核心依赖 –>
<dependency>
<groupId>org.springframework.kafka</groupId>
<artifactId>spring-kafka</artifactId>
</dependency>
<!– JPA:用于演示数据库与 Kafka 协同场景 –>
<dependency>
<groupId>org.springframework.boot</groupId>
<artifactId>spring-boot-starter-data-jpa</artifactId>
</dependency>
<!– H2:本地内存数据库,方便示例运行 –>
<dependency>
<groupId>com.h2database</groupId>
<artifactId>h2</artifactId>
<scope>runtime</scope>
</dependency>
<!– 校验依赖 –>
<dependency>
<groupId>org.springframework.boot</groupId>
<artifactId>spring-boot-starter-validation</artifactId>
</dependency>
<!– 监控依赖,便于观察运行情况 –>
<dependency>
<groupId>org.springframework.boot</groupId>
<artifactId>spring-boot-starter-actuator</artifactId>
</dependency>
<!– 测试依赖 –>
<dependency>
<groupId>org.springframework.boot</groupId>
<artifactId>spring-boot-starter-test</artifactId>
<scope>test</scope>
</dependency>
<dependency>
<groupId>org.springframework.kafka</groupId>
<artifactId>spring-kafka-test</artifactId>
<scope>test</scope>
</dependency>
</dependencies>
<build>
<plugins>
<plugin>
<groupId>org.springframework.boot</groupId>
<artifactId>spring-boot-maven-plugin</artifactId>
</plugin>
</plugins>
</build>
</project>
代码解析
这份依赖设计有几个值得注意的点:
8.4 基础配置文件
server:
port: 8080
spring:
application:
name: kafka–producer–demo
datasource:
url: jdbc:h2:mem:testdb;MODE=MYSQL;DB_CLOSE_DELAY=–1;DB_CLOSE_ON_EXIT=FALSE
driver-class-name: org.h2.Driver
username: sa
password:
h2:
console:
enabled: true
path: /h2–console
jpa:
hibernate:
ddl-auto: update
show-sql: true
properties:
hibernate:
format_sql: true
kafka:
bootstrap-servers: localhost:9092
producer:
key-serializer: org.apache.kafka.common.serialization.StringSerializer
value-serializer: org.springframework.kafka.support.serializer.JsonSerializer
consumer:
group-id: demo–consumer–group
auto-offset-reset: earliest
key-deserializer: org.apache.kafka.common.serialization.StringDeserializer
value-deserializer: org.springframework.kafka.support.serializer.JsonDeserializer
properties:
spring.json.trusted.packages: "*"
isolation.level: read_committed
management:
endpoints:
web:
exposure:
include: health,info,metrics
配置解析
这里先只保留公共配置,不直接把事务相关参数全塞到 spring.kafka.producer.* 里。原因是:
- 我们要分别演示幂等 Producer 和事务 Producer;
- 如果把事务配置全局打开,会让默认模板都变成事务型,反而不利于对比教学。
所以更好的做法是:公共属性放 application.yml,差异化能力放到各自的 Java Config 中。
9. 可运行案例一:幂等生产者实战
先做幂等案例,因为这是理解事务的前置基础。
9.1 主题配置
package com.example.kafkademo.config;
import org.apache.kafka.clients.admin.NewTopic;
import org.springframework.context.annotation.Bean;
import org.springframework.context.annotation.Configuration;
import org.springframework.kafka.config.TopicBuilder;
/**
* Kafka 主题配置。
* 这里直接在应用启动时创建主题,便于本地演示。
*/
@Configuration
public class KafkaTopicsConfig {
/**
* 订单事件主题。
*/
@Bean
public NewTopic orderEventsTopic() {
return TopicBuilder.name("order-events")
.partitions(3)
.replicas(1)
.build();
}
/**
* 审计事件主题。
*/
@Bean
public NewTopic auditEventsTopic() {
return TopicBuilder.name("audit-events")
.partitions(3)
.replicas(1)
.build();
}
/**
* 库存事件主题。
*/
@Bean
public NewTopic stockEventsTopic() {
return TopicBuilder.name("stock-events")
.partitions(3)
.replicas(1)
.build();
}
}
代码解析
这段代码不是本文重点,但很实用。对于零基础读者来说,本地测试 Kafka 最痛苦的一件事就是:
“还没进入业务代码,主题都没建。”
所以在教学文章里把主题创建也纳入配置,是很好的体验优化。
9.2 定义订单事件 DTO
package com.example.kafkademo.dto;
import jakarta.validation.constraints.NotBlank;
import jakarta.validation.constraints.NotNull;
import java.math.BigDecimal;
import java.time.LocalDateTime;
/**
* 订单创建事件。
*/
public class OrderCreatedEvent {
/**
* 订单号。
*/
@NotBlank(message = "订单号不能为空")
private String orderNo;
/**
* 用户编号。
*/
@NotBlank(message = "用户编号不能为空")
private String userId;
/**
* 订单金额。
*/
@NotNull(message = "订单金额不能为空")
private BigDecimal amount;
/**
* 创建时间。
*/
private LocalDateTime createdTime;
public String getOrderNo() {
return orderNo;
}
public void setOrderNo(String orderNo) {
this.orderNo = orderNo;
}
public String getUserId() {
return userId;
}
public void setUserId(String userId) {
this.userId = userId;
}
public BigDecimal getAmount() {
return amount;
}
public void setAmount(BigDecimal amount) {
this.amount = amount;
}
public LocalDateTime getCreatedTime() {
return createdTime;
}
public void setCreatedTime(LocalDateTime createdTime) {
this.createdTime = createdTime;
}
}
代码解析
为什么 DTO 里要有 orderNo 并且后面会把它作为 key?
因为真实业务里,想保证同一订单相关消息尽可能落到同一分区,你就应该使用业务主键作为 key。这样:
- 同一订单的消息会按 key 路由到固定分区;
- 分区内顺序才有意义;
- 幂等和顺序讨论才更贴近真实场景。
9.3 幂等 Producer 配置
package com.example.kafkademo.config;
import org.apache.kafka.clients.producer.ProducerConfig;
import org.springframework.beans.factory.annotation.Qualifier;
import org.springframework.boot.autoconfigure.kafka.KafkaProperties;
import org.springframework.context.annotation.Bean;
import org.springframework.context.annotation.Configuration;
import org.springframework.kafka.core.DefaultKafkaProducerFactory;
import org.springframework.kafka.core.KafkaTemplate;
import org.springframework.kafka.core.ProducerFactory;
import java.util.HashMap;
import java.util.Map;
/**
* 幂等生产者配置。
*/
@Configuration
public class IdempotentProducerConfig {
/**
* 创建幂等 ProducerFactory。
*
* @param kafkaProperties Spring Boot 自动绑定的 Kafka 公共属性
* @return 幂等 ProducerFactory
*/
@Bean("idempotentProducerFactory")
public ProducerFactory<String, Object> idempotentProducerFactory(KafkaProperties kafkaProperties) {
Map<String, Object> props = new HashMap<>(kafkaProperties.buildProducerProperties());
// 开启幂等:防止生产者重试造成重复写入
props.put(ProducerConfig.ENABLE_IDEMPOTENCE_CONFIG, true);
// 所有 ISR 副本确认后才返回,保证更强语义
props.put(ProducerConfig.ACKS_CONFIG, "all");
// 允许重试,这样幂等能力才有意义
props.put(ProducerConfig.RETRIES_CONFIG, Integer.MAX_VALUE);
// 控制同一连接上未确认请求数,避免破坏幂等与顺序保证
props.put(ProducerConfig.MAX_IN_FLIGHT_REQUESTS_PER_CONNECTION, 5);
// 适当设置批量大小与等待时间,提高吞吐
props.put(ProducerConfig.BATCH_SIZE_CONFIG, 16_384);
props.put(ProducerConfig.LINGER_MS_CONFIG, 10);
return new DefaultKafkaProducerFactory<>(props);
}
/**
* 幂等 KafkaTemplate。
*
* @param producerFactory 幂等生产者工厂
* @return KafkaTemplate
*/
@Bean("idempotentKafkaTemplate")
public KafkaTemplate<String, Object> idempotentKafkaTemplate(
@Qualifier("idempotentProducerFactory") ProducerFactory<String, Object> producerFactory) {
return new KafkaTemplate<>(producerFactory);
}
}
代码解析
这段配置对应了我们前面讲的幂等前提:
- 开启 enable.idempotence
- acks=all
- 足够的 retries
- 合理的 max.in.flight
你会注意到:
这里没有任何事务 API,也没有 transactional.id。
这就是幂等 Producer 最典型的工程形态:
- 你增强的是发送语义;
- 不是引入事务生命周期管理。
9.4 幂等发送服务
package com.example.kafkademo.service;
import com.example.kafkademo.dto.OrderCreatedEvent;
import org.slf4j.Logger;
import org.slf4j.LoggerFactory;
import org.springframework.beans.factory.annotation.Qualifier;
import org.springframework.kafka.core.KafkaTemplate;
import org.springframework.kafka.support.SendResult;
import org.springframework.stereotype.Service;
import java.time.LocalDateTime;
import java.util.concurrent.CompletableFuture;
/**
* 幂等订单生产服务。
*/
@Service
public class IdempotentOrderProducerService {
private static final Logger log = LoggerFactory.getLogger(IdempotentOrderProducerService.class);
private final KafkaTemplate<String, Object> idempotentKafkaTemplate;
public IdempotentOrderProducerService(
@Qualifier("idempotentKafkaTemplate") KafkaTemplate<String, Object> idempotentKafkaTemplate) {
this.idempotentKafkaTemplate = idempotentKafkaTemplate;
}
/**
* 发送订单创建事件。
*
* @param event 订单创建事件
*/
public void sendOrderCreatedEvent(OrderCreatedEvent event) {
// 如果创建时间为空,则由服务端补齐
if (event.getCreatedTime() == null) {
event.setCreatedTime(LocalDateTime.now());
}
// 以订单号作为消息 key,确保同一订单尽量进入同一分区
CompletableFuture<SendResult<String, Object>> future =
idempotentKafkaTemplate.send("order-events", event.getOrderNo(), event);
future.whenComplete((result, ex) -> {
if (ex != null) {
log.error("幂等消息发送失败,orderNo={}", event.getOrderNo(), ex);
return;
}
if (result != null && result.getRecordMetadata() != null) {
log.info("幂等消息发送成功,topic={}, partition={}, offset={}, orderNo={}",
result.getRecordMetadata().topic(),
result.getRecordMetadata().partition(),
result.getRecordMetadata().offset(),
event.getOrderNo());
}
});
}
}
代码解析
这段发送代码看起来和普通 Producer 没什么区别,这恰恰就是幂等模式的特点:
- 业务层调用方式几乎不变;
- 幂等语义主要体现在底层 Producer 行为上。
也正因为如此,幂等非常适合“从普通发送平滑升级”的场景。
9.5 控制器:触发幂等发送
package com.example.kafkademo.controller;
import com.example.kafkademo.dto.OrderCreatedEvent;
import com.example.kafkademo.service.IdempotentOrderProducerService;
import com.example.kafkademo.service.TransactionalOrderProducerService;
import jakarta.validation.Valid;
import org.springframework.http.ResponseEntity;
import org.springframework.web.bind.annotation.PostMapping;
import org.springframework.web.bind.annotation.RequestBody;
import org.springframework.web.bind.annotation.RequestMapping;
import org.springframework.web.bind.annotation.RestController;
import java.util.HashMap;
import java.util.Map;
/**
* 订单事件控制器。
*/
@RestController
@RequestMapping("/api/orders")
public class OrderEventController {
private final IdempotentOrderProducerService idempotentOrderProducerService;
private final TransactionalOrderProducerService transactionalOrderProducerService;
public OrderEventController(IdempotentOrderProducerService idempotentOrderProducerService,
TransactionalOrderProducerService transactionalOrderProducerService) {
this.idempotentOrderProducerService = idempotentOrderProducerService;
this.transactionalOrderProducerService = transactionalOrderProducerService;
}
/**
* 幂等方式发送订单创建消息。
*/
@PostMapping("/idempotent")
public ResponseEntity<Map<String, Object>> sendIdempotent(@Valid @RequestBody OrderCreatedEvent event) {
idempotentOrderProducerService.sendOrderCreatedEvent(event);
Map<String, Object> result = new HashMap<>();
result.put("success", true);
result.put("mode", "idempotent");
result.put("orderNo", event.getOrderNo());
return ResponseEntity.ok(result);
}
/**
* 事务方式发送多条消息。
*/
@PostMapping("/transactional")
public ResponseEntity<Map<String, Object>> sendTransactional(@Valid @RequestBody OrderCreatedEvent event) {
transactionalOrderProducerService.publishOrderEventsInTransaction(event);
Map<String, Object> result = new HashMap<>();
result.put("success", true);
result.put("mode", "transactional");
result.put("orderNo", event.getOrderNo());
return ResponseEntity.ok(result);
}
}
代码解析
控制器里同时暴露两个接口,是为了让你更直观地对比两种模式:
- /api/orders/idempotent
- /api/orders/transactional
它们接收相同的业务入参,但背后的发送编排模型完全不同。
9.6 幂等案例小结
到这里你应该已经感受到:
- 幂等 Producer 使用上并不复杂;
- 复杂性主要藏在 Kafka client 与 Broker 协议层;
- 从 Spring Boot 工程角度看,幂等非常适合作为默认增强方案。
但别忘了,幂等依然只解决“重复重试”问题,不保证“多条消息一起成功”。
下面我们进入事务 Producer。
10. 可运行案例二:事务生产者实战
10.1 定义事务相关 DTO
先补上两个 DTO,用来模拟订单创建后需要同时发出的两条辅助消息。
package com.example.kafkademo.dto;
import java.time.LocalDateTime;
/**
* 审计事件。
*/
public class AuditEvent {
/**
* 业务对象编号。
*/
private String bizNo;
/**
* 审计动作。
*/
private String action;
/**
* 事件时间。
*/
private LocalDateTime eventTime;
public String getBizNo() {
return bizNo;
}
public void setBizNo(String bizNo) {
this.bizNo = bizNo;
}
public String getAction() {
return action;
}
public void setAction(String action) {
this.action = action;
}
public LocalDateTime getEventTime() {
return eventTime;
}
public void setEventTime(LocalDateTime eventTime) {
this.eventTime = eventTime;
}
}
package com.example.kafkademo.dto;
import java.time.LocalDateTime;
/**
* 库存预占事件。
*/
public class StockReservedEvent {
/**
* 订单号。
*/
private String orderNo;
/**
* 用户编号。
*/
private String userId;
/**
* 预占时间。
*/
private LocalDateTime reserveTime;
public String getOrderNo() {
return orderNo;
}
public void setOrderNo(String orderNo) {
this.orderNo = orderNo;
}
public String getUserId() {
return userId;
}
public void setUserId(String userId) {
this.userId = userId;
}
public LocalDateTime getReserveTime() {
return reserveTime;
}
public void setReserveTime(LocalDateTime reserveTime) {
this.reserveTime = reserveTime;
}
}
10.2 事务 Producer 配置
package com.example.kafkademo.config;
import org.apache.kafka.clients.producer.ProducerConfig;
import org.springframework.beans.factory.annotation.Qualifier;
import org.springframework.boot.autoconfigure.kafka.KafkaProperties;
import org.springframework.context.annotation.Bean;
import org.springframework.context.annotation.Configuration;
import org.springframework.kafka.core.DefaultKafkaProducerFactory;
import org.springframework.kafka.core.KafkaTemplate;
import org.springframework.kafka.core.ProducerFactory;
import org.springframework.kafka.transaction.KafkaTransactionManager;
import java.util.HashMap;
import java.util.Map;
/**
* 事务生产者配置。
*/
@Configuration
public class TransactionalProducerConfig {
/**
* 创建事务型 ProducerFactory。
*
* @param kafkaProperties Spring Boot 自动绑定的 Kafka 公共属性
* @return 事务型 ProducerFactory
*/
@Bean("transactionalProducerFactory")
public ProducerFactory<String, Object> transactionalProducerFactory(KafkaProperties kafkaProperties) {
Map<String, Object> props = new HashMap<>(kafkaProperties.buildProducerProperties());
// 事务生产者隐式要求幂等,这里显式写出便于教学理解
props.put(ProducerConfig.ENABLE_IDEMPOTENCE_CONFIG, true);
props.put(ProducerConfig.ACKS_CONFIG, "all");
props.put(ProducerConfig.RETRIES_CONFIG, Integer.MAX_VALUE);
props.put(ProducerConfig.MAX_IN_FLIGHT_REQUESTS_PER_CONNECTION, 5);
DefaultKafkaProducerFactory<String, Object> producerFactory = new DefaultKafkaProducerFactory<>(props);
// 设置事务 ID 前缀,Spring 会基于此前缀为底层 Producer 分配事务身份
producerFactory.setTransactionIdPrefix("demo-tx-");
return producerFactory;
}
/**
* 事务型 KafkaTemplate。
*/
@Bean("transactionalKafkaTemplate")
public KafkaTemplate<String, Object> transactionalKafkaTemplate(
@Qualifier("transactionalProducerFactory") ProducerFactory<String, Object> producerFactory) {
return new KafkaTemplate<>(producerFactory);
}
/**
* Kafka 事务管理器。
* Spring 事务体系通过它把 Kafka Producer 绑定到线程上下文。
*/
@Bean
public KafkaTransactionManager<String, Object> kafkaTransactionManager(
@Qualifier("transactionalProducerFactory") ProducerFactory<String, Object> producerFactory) {
return new KafkaTransactionManager<>(producerFactory);
}
}
代码解析
这一段是全文最重要的配置之一。
你需要特别注意下面几点:
(1)事务 ProducerFactory 和幂等 ProducerFactory 是两套
这不是重复劳动,而是为了表达清晰:
- 幂等 Producer:只负责安全重试;
- 事务 Producer:负责事务生命周期。
(2)setTransactionIdPrefix() 是 Spring 风格的重要桥接点
在原生 Kafka API 里,你会更关注 transactional.id。
在 Spring Kafka 里,DefaultKafkaProducerFactory 通过 transactionIdPrefix 来管理事务型 Producer 的创建与缓存,这是 Spring 工程化封装的重要体现。
(3)为什么要有 KafkaTransactionManager
因为在 Spring 体系中,事务不只是“手动 begin/commit”。
你可能会通过:
- @Transactional
- TransactionTemplate
- KafkaTemplate.executeInTransaction()
来驱动事务,而这些能力都离不开事务管理器把资源绑定到线程上下文。
10.3 事务发送服务
package com.example.kafkademo.service;
import com.example.kafkademo.dto.AuditEvent;
import com.example.kafkademo.dto.OrderCreatedEvent;
import com.example.kafkademo.dto.StockReservedEvent;
import org.slf4j.Logger;
import org.slf4j.LoggerFactory;
import org.springframework.beans.factory.annotation.Qualifier;
import org.springframework.kafka.core.KafkaTemplate;
import org.springframework.stereotype.Service;
import java.time.LocalDateTime;
/**
* 事务订单生产服务。
*/
@Service
public class TransactionalOrderProducerService {
private static final Logger log = LoggerFactory.getLogger(TransactionalOrderProducerService.class);
private final KafkaTemplate<String, Object> transactionalKafkaTemplate;
public TransactionalOrderProducerService(
@Qualifier("transactionalKafkaTemplate") KafkaTemplate<String, Object> transactionalKafkaTemplate) {
this.transactionalKafkaTemplate = transactionalKafkaTemplate;
}
/**
* 在一个 Kafka 事务中发布多条消息。
*
* @param event 订单创建事件
*/
public void publishOrderEventsInTransaction(OrderCreatedEvent event) {
if (event.getCreatedTime() == null) {
event.setCreatedTime(LocalDateTime.now());
}
AuditEvent auditEvent = new AuditEvent();
auditEvent.setBizNo(event.getOrderNo());
auditEvent.setAction("ORDER_CREATED");
auditEvent.setEventTime(LocalDateTime.now());
StockReservedEvent stockReservedEvent = new StockReservedEvent();
stockReservedEvent.setOrderNo(event.getOrderNo());
stockReservedEvent.setUserId(event.getUserId());
stockReservedEvent.setReserveTime(LocalDateTime.now());
transactionalKafkaTemplate.executeInTransaction(operations -> {
// 第一条:订单创建主事件
operations.send("order-events", event.getOrderNo(), event);
// 第二条:审计日志事件
operations.send("audit-events", event.getOrderNo(), auditEvent);
// 第三条:库存预占事件
operations.send("stock-events", event.getOrderNo(), stockReservedEvent);
log.info("事务消息已全部加入待提交队列,orderNo={}", event.getOrderNo());
return null;
});
}
}
代码解析
这段代码看起来也很简单,但它代表的是发送模式的根本变化:
- 幂等模式:一条消息就是一次相对独立的发送;
- 事务模式:多条消息先进入同一个事务上下文,再统一提交。
也就是说,事务的重点不在于“每条 send 长得不一样”,而在于:
发送动作不再是彼此独立的,而是被纳入一个统一的提交边界。
如果中间出现异常,整个事务会失败,而不会留下“主消息成功、辅助消息失败”的半成功状态。
10.4 从源码角度理解 executeInTransaction
从设计上看,KafkaTemplate.executeInTransaction() 做了几件关键事情:
这恰好对应了 Kafka 原生事务 API 的生命周期,只不过 Spring 帮你包装得更符合模板方法模式。
10.5 为什么事务型模板不建议在事务外随便发
这是个很重要的实战点。
如果一个 KafkaTemplate 是基于事务型 ProducerFactory 创建的,那么它通常期望自己运行在事务上下文中。
原因很简单:
- 它背后的 Producer 是按事务语义设计的;
- Spring 也会在发送时检查当前线程是否已有事务资源;
- 如果你不在事务上下文里随便调用,框架很可能直接抛出异常或表现出与你预期不一致的行为。
所以工程中比较稳妥的方式是:
- 非事务发送,使用普通/幂等模板;
- 事务发送,使用专门的事务模板。
这比“一把梭哈所有发送都走事务模板”清晰得多。
10.6 用 Mermaid 看事务型发送路径
示意图绘制如下,仅供参考:
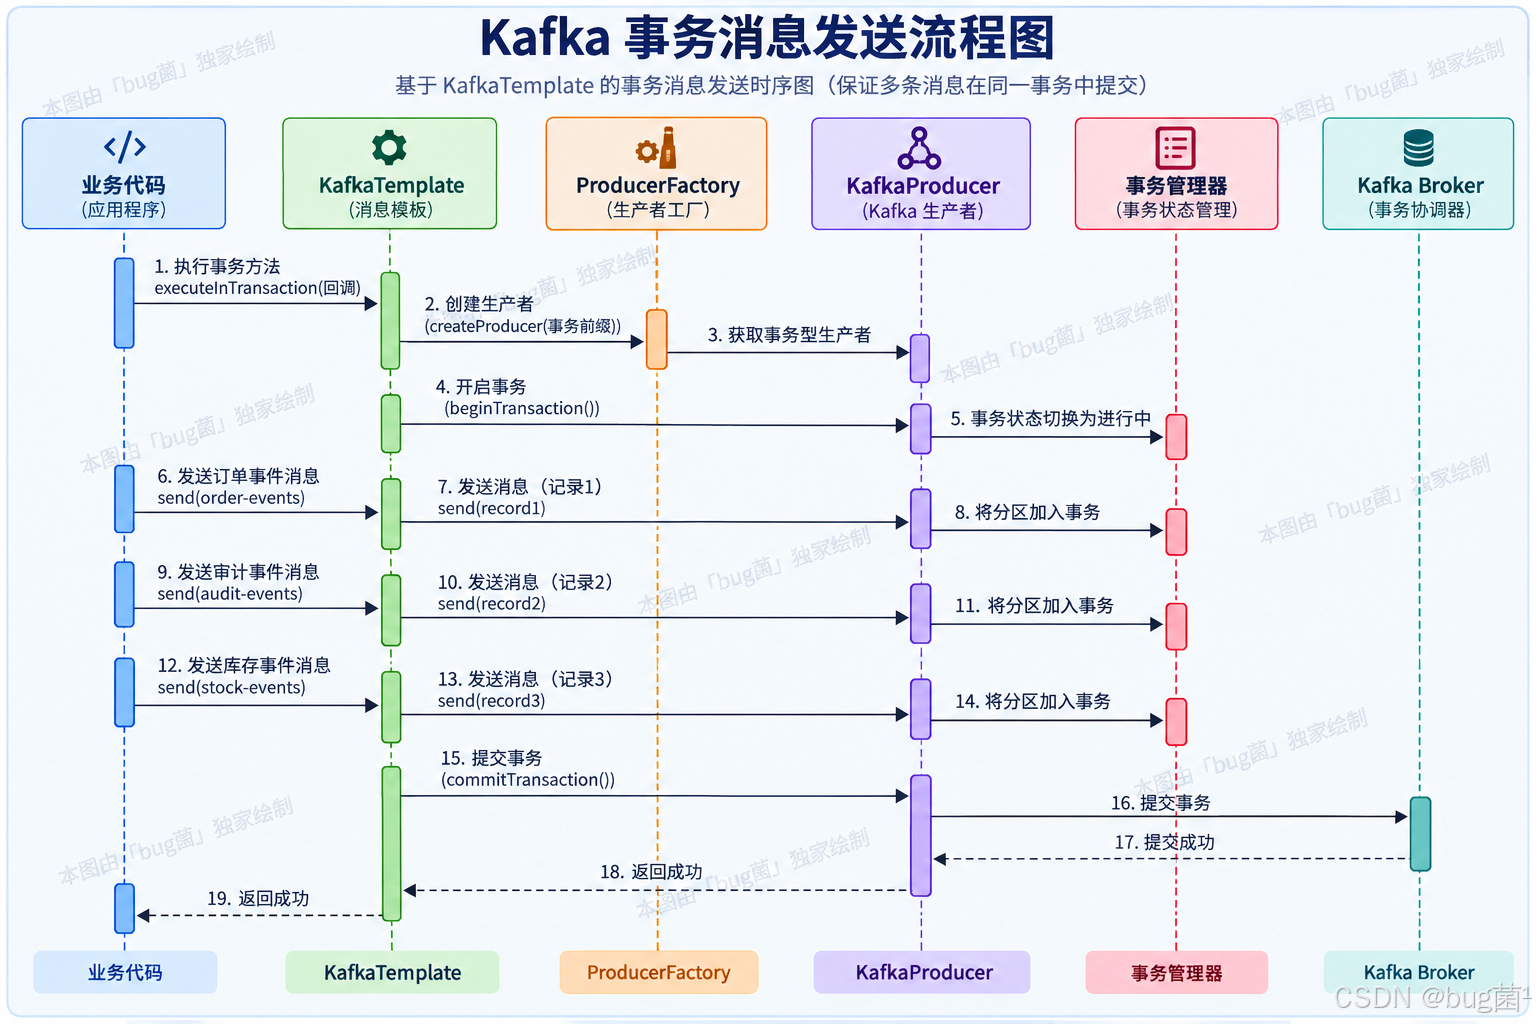
这个图里最关键的一步是:将分区加入事务。
它说明事务不是简单“最后一起 commit”这么口语化,而是 Producer 在发送过程中就不断维护“这个事务影响了哪些分区”的元数据。
11. 可运行案例三:数据库与 Kafka 发送协同的设计思路
这一节是很多读者最关心也最容易误用的地方。
11.1 先说结论:Kafka 事务 ≠ 数据库 + Kafka 的全局 XA
很多同学一看到 Spring 里既有 @Transactional,又有 KafkaTransactionManager,就容易脑补成:
“那我数据库插入一行,再发 Kafka,天然就是全局强一致。”
这并不准确。
Spring Kafka 官方也明确强调:KafkaTransactionManager 是针对 单个 Kafka ProducerFactory 的事务管理器,它不是 XA 事务管理器。
所以你一定要记住:
- 数据库事务管理器:管理数据库连接与本地事务;
- KafkaTransactionManager:管理 Kafka Producer 与 Kafka 事务;
- 它们可以被 Spring 协调、串联、同步,但不是传统意义上的两阶段提交 XA。
11.2 为什么业务上还会把它们一起使用
因为很多场景里,我们并不追求理论上的全局 XA,而是追求:
- 足够强的一致性;
- 清晰的失败策略;
- 可控的补偿机制;
- 合理的复杂度。
比如:
不同方案适用于不同业务。
11.3 本文给出的教学方案:本地事务 + Kafka 发送协同
下面给一个教学用的示例:
- 数据库保存订单日志;
- 再通过事务型 KafkaTemplate 发送订单事件;
- 让你理解 Spring Boot 3.x 中事务边界是如何编排的。
实体类
package com.example.kafkademo.entity;
import jakarta.persistence.*;
import java.math.BigDecimal;
import java.time.LocalDateTime;
/**
* 订单日志实体。
*/
@Entity
@Table(name = "t_order_log")
public class OrderLog {
@Id
@GeneratedValue(strategy = GenerationType.IDENTITY)
private Long id;
/**
* 订单号。
*/
@Column(nullable = false, unique = true, length = 64)
private String orderNo;
/**
* 用户编号。
*/
@Column(nullable = false, length = 64)
private String userId;
/**
* 订单金额。
*/
@Column(nullable = false, precision = 18, scale = 2)
private BigDecimal amount;
/**
* 创建时间。
*/
@Column(nullable = false)
private LocalDateTime createdTime;
public Long getId() {
return id;
}
public void setId(Long id) {
this.id = id;
}
public String getOrderNo() {
return orderNo;
}
public void setOrderNo(String orderNo) {
this.orderNo = orderNo;
}
public String getUserId() {
return userId;
}
public void setUserId(String userId) {
this.userId = userId;
}
public BigDecimal getAmount() {
return amount;
}
public void setAmount(BigDecimal amount) {
this.amount = amount;
}
public LocalDateTime getCreatedTime() {
return createdTime;
}
public void setCreatedTime(LocalDateTime createdTime) {
this.createdTime = createdTime;
}
}
Repository
package com.example.kafkademo.repository;
import com.example.kafkademo.entity.OrderLog;
import org.springframework.data.jpa.repository.JpaRepository;
import java.util.Optional;
/**
* 订单日志仓储。
*/
public interface OrderLogRepository extends JpaRepository<OrderLog, Long> {
/**
* 根据订单号查询。
*/
Optional<OrderLog> findByOrderNo(String orderNo);
}
协同服务
package com.example.kafkademo.service;
import com.example.kafkademo.dto.OrderCreatedEvent;
import com.example.kafkademo.entity.OrderLog;
import com.example.kafkademo.repository.OrderLogRepository;
import jakarta.transaction.Transactional;
import org.slf4j.Logger;
import org.slf4j.LoggerFactory;
import org.springframework.stereotype.Service;
import java.time.LocalDateTime;
/**
* 本地数据库事务与 Kafka 发布协同服务。
*
* 注意:该示例主要用于教学,帮助理解 Spring 中数据库事务与消息发布的配合方式。
* 在真正的高一致性生产场景中,仍需根据业务选择更适合的策略,例如 Outbox Pattern。
*/
@Service
public class OrderLocalTransactionService {
private static final Logger log = LoggerFactory.getLogger(OrderLocalTransactionService.class);
private final OrderLogRepository orderLogRepository;
private final TransactionalOrderProducerService transactionalOrderProducerService;
public OrderLocalTransactionService(OrderLogRepository orderLogRepository,
TransactionalOrderProducerService transactionalOrderProducerService) {
this.orderLogRepository = orderLogRepository;
this.transactionalOrderProducerService = transactionalOrderProducerService;
}
/**
* 先写数据库,再发布 Kafka 事务消息。
*
* @param event 订单创建事件
*/
@Transactional
public void createOrderAndPublish(OrderCreatedEvent event) {
OrderLog orderLog = new OrderLog();
orderLog.setOrderNo(event.getOrderNo());
orderLog.setUserId(event.getUserId());
orderLog.setAmount(event.getAmount());
orderLog.setCreatedTime(LocalDateTime.now());
orderLogRepository.save(orderLog);
log.info("订单日志已写入数据库,orderNo={}", event.getOrderNo());
// 发布 Kafka 事务消息
transactionalOrderProducerService.publishOrderEventsInTransaction(event);
}
}
代码解析
这段代码的价值不在于“它是不是最终生产最佳方案”,而在于帮你建立正确认知:
11.4 为什么很多公司最终会落到 Outbox Pattern
因为 Outbox 的优点是:
- 业务主数据和待发送事件先写同一个数据库本地事务;
- 后续由独立任务或 CDC 把 Outbox 表推送到 Kafka;
- 这样能显著降低“数据库成功但消息没发出去”的窗口。
所以你可以把本文的三个层次理解为:
- 幂等:解决发送重试重复;
- Kafka 事务:解决 Kafka 内部多消息原子提交;
- Outbox:解决数据库与消息系统协同一致性。
这三个不是替代关系,而是不同边界的问题。
12. 消费端如何配合事务生产者实现端到端语义
只讲 Producer 而不讲 Consumer,这篇文章就不完整。
12.1 为什么消费者要关心事务
如果 Producer 已经用了事务,但消费者仍然随便消费,那么你很可能得不到自己想象中的语义。
原因在于:
- 事务中的消息可能尚未提交;
- 已回滚事务中的消息不应对业务可见;
- 消费者要通过隔离级别决定“我到底读不读这些记录”。
12.2 read_committed 的意义
当消费者配置:
spring:
kafka:
consumer:
properties:
isolation.level: read_committed
它的语义就是:
- 只读取已提交事务中的消息;
- 跳过未提交或已回滚事务对应的记录。
这一步非常关键。否则你 Producer 端辛辛苦苦做事务,消费端却没有按事务语义读取,那整体效果就被削弱了。
12.3 简单消费者示例
package com.example.kafkademo.service;
import com.example.kafkademo.dto.OrderCreatedEvent;
import org.slf4j.Logger;
import org.slf4j.LoggerFactory;
import org.springframework.kafka.annotation.KafkaListener;
import org.springframework.stereotype.Component;
/**
* 订单事件消费者。
*/
@Component
public class OrderEventConsumer {
private static final Logger log = LoggerFactory.getLogger(OrderEventConsumer.class);
/**
* 监听订单创建主题。
*
* @param event 订单创建事件
*/
@KafkaListener(topics = "order-events", groupId = "demo-consumer-group")
public void consumeOrderCreatedEvent(OrderCreatedEvent event) {
log.info("消费到订单事件,orderNo={}, userId={}, amount={}",
event.getOrderNo(), event.getUserId(), event.getAmount());
}
}
代码解析
消费者代码本身并不复杂,关键反而在配置:
- 生产端开启事务;
- 消费端使用 read_committed。
这说明 Kafka 事务语义不是“Producer 一边努力就行”,而是消息链路多方共同参与。
13. 深入源码思维:为什么说事务生产者比幂等生产者“重得多”
这一节不贴更多源码文件,而是用“源码阅读视角”帮你建立理解框架。
13.1 幂等的核心复杂度在哪里
幂等主要复杂在:
- Producer 端给分区写入维护 sequence;
- Broker 端维护 ProducerState;
- 重试时能根据序列判断是不是重复;
- 需要在吞吐、顺序、重试之间取得平衡。
它的难点是“安全重试”。
13.2 事务的核心复杂度在哪里
事务的复杂度比幂等明显更高,至少多出以下问题:
你会发现,事务本质上把问题从“发送一条消息”升级成了“管理一个分布式日志系统中的事务生命周期”。
13.3 为什么事务异常常常比幂等异常更难处理
幂等发送失败时,很多场景你只需要判断:
- 这次 send 是否成功;
- 是否需要重试;
- 是否需要人工排查是否重复。
事务失败时则不同,你还要考虑:
- 当前事务是否还能继续使用;
- 是否必须 abort;
- Producer 是否已经进入 fatal error;
- 当前事务涉及的消息是否部分写入但未提交;
- 消费者到底能不能看见这部分数据。
所以事务型 Producer 的错误处理模型也更复杂,线上排障成本更高。
14. 高频误区与线上避坑
这一节很重要,我按“新手最容易犯的错误”来写。
14.1 误区一:开启幂等就等于彻底没有重复消息
错。
幂等主要防的是:
- 同一 Producer 因重试造成的重复写入。
它不负责:
- 应用层重复调用;
- 业务逻辑重复触发;
- 跨系统重复投递的所有可能。
所以关键业务依然要做业务幂等。
14.2 误区二:事务生产者就是“更强的幂等”
也不准确。
更准确的说法是:
- 事务生产者建立在幂等之上;
- 但它新增的核心能力是 原子提交与事务可见性控制。
所以两者不是“强弱版本关系”,而是“包含关系 + 语义升级”。
14.3 误区三:事务型 KafkaTemplate 可以当普通模板随便用
这在 Spring Boot 项目里非常常见。
事务型模板最好在以下方式中使用:
- executeInTransaction()
- @Transactional + 正确事务管理器绑定
- 监听容器启动 Kafka 事务的场景
否则就可能出现:
- 没有事务上下文;
- 模板抛异常;
- 或者行为和你预期不一致。
14.4 误区四:Kafka 事务能直接解决数据库与消息的一切一致性问题
错。
Kafka 事务解决的是 Kafka 内部消息写入的一致性边界; 数据库与 Kafka 之间仍需要结合:
- Spring 事务同步;
- 失败补偿;
- Outbox Pattern;
- CDC 等架构方案。
14.5 误区五:消费者不配 read_committed 也没关系
如果你用的是事务生产者,这个误区会直接让事务价值缩水。
因为 Producer 端的事务语义,本来就需要消费端按已提交隔离级别来配合,才能形成完整闭环。
14.6 误区六:所有业务都应该上事务 Producer
不建议。
原则应该是:
- 能用幂等解决的,不要贸然上事务;
- 只有确实存在“多消息原子提交”需求时,才引入事务;
- 事务越强,成本越高,排障越复杂。
这就是典型的工程权衡。
15. 一图总结:幂等与事务的关系
示意图绘制如下,仅供参考:
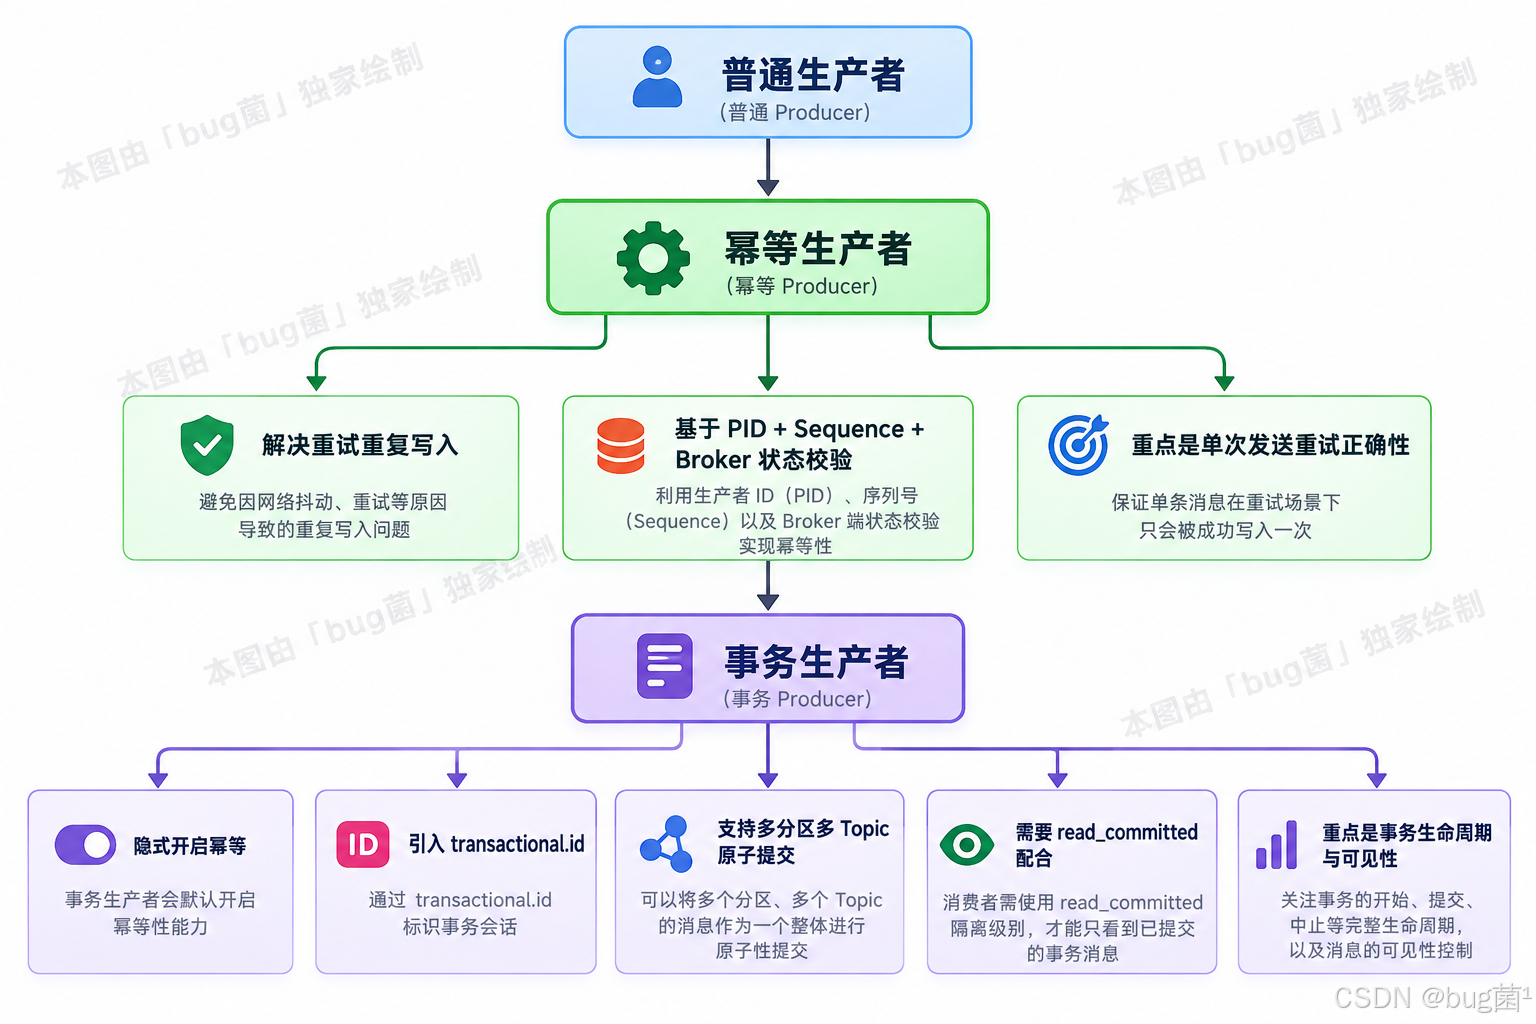
这个图我建议你收藏。很多同学学完一堆概念,脑子里还是一团线,原因就在于缺少这种“层级图”。
请记住:
- 事务不是替代幂等;
- 事务是幂等之上的进一步扩展;
- 幂等关注重试安全;
- 事务关注提交边界。
16. 面试题与答题模板
下面这组问题非常高频,建议你直接掌握。
16.1 面试题:Kafka 幂等生产者和事务生产者有什么区别?
参考回答
Kafka 幂等生产者和事务生产者的共同点是都基于 Kafka Producer 的状态管理机制,事务生产者还会隐式开启幂等。它们的主要区别在于语义边界:
16.2 面试题:为什么事务一定需要 transactional.id?
参考回答
因为事务不仅要解决当前发送过程的可靠性,还要解决 Producer 重启后的事务恢复和旧实例 fencing 问题。transactional.id 提供了稳定的逻辑身份,让 Kafka 能够区分同一个事务型 Producer 的新旧实例,并通过 epoch 机制阻止旧实例继续写入,避免僵尸 Producer 破坏事务语义。
16.3 面试题:幂等能保证 exactly-once 吗?
参考回答
不能简单这么说。幂等生产者能保证的是同一 Producer 在重试时不会把同一条逻辑消息重复写入 Kafka 日志,这是 Producer 侧的重要基础。但如果要实现更完整的端到端 exactly-once,还需要事务生产者、消费者 read_committed、位点提交协同以及业务层幂等等多方面配合。
17. 全文总结
现在我们把全文收束一下。
如果只用一句话总结:
幂等生产者解决“重试不重复”,事务生产者解决“多条消息原子提交”;事务建立在幂等之上,但两者的语义边界、状态复杂度和工程使用方式都明显不同。
再拆开一点看:
17.1 从概念上总结
- 幂等:避免同一 Producer 重试造成重复写入;
- 事务:保证一个事务单元内多条消息要么全部提交、要么全部回滚。
17.2 从源码思路上总结
- 两者都走 KafkaProducer 主链路;
- 两者都依赖 Producer 状态与 Broker 状态协作;
- 事务生产者在此基础上增加事务状态机、分区注册、提交/回滚以及消费者可见性控制。
17.3 从 Spring Boot 3.x 工程实践上总结
- 默认业务通知:优先幂等;
- 多 Topic/多分区原子发布:使用事务;
- 数据库与 Kafka 协同:根据一致性要求权衡 Spring 事务同步、Outbox、CDC 等方案;
- 不要迷信单个配置项,真正可靠的系统一定是“协议语义 + 业务幂等 + 架构补偿”三者结合。
17.4 给零基础读者的学习建议
如果你是第一次接触这个主题,请按下面顺序继续深入:
这就是“从零基础到源码级理解”的正确路线:
- 先建立业务问题感;
- 再建立概念模型;
- 再通过工程代码落地;
- 最后回到源码反证你的理解。
课后思考题
把这四个问题真正想明白,你对 Kafka Producer 可靠性语义的理解,就已经超过很多只会背配置的人了。
小结
- 幂等不是万能去重,它是协议层的安全重试机制。
- 事务不是“更强幂等”,而是“幂等之上的原子提交机制”。
- Spring Boot 3.x 的价值不只在于自动配置,更在于它把底层 Kafka 事务能力工程化成了 ProducerFactory、KafkaTemplate 和事务管理器。
- 真正成熟的消息系统设计,从来不是只靠一个开关,而是边界清晰、职责分层。
…
ok,同学们,本节课就上到这儿,下课~
🧧 学习福利 · 限时开放 🧧
当然,无论你是计算机专业在读学生,还是对编程充满兴趣的入门者,都强烈建议系统学习SpringBoot全体系专栏:👉 「滚雪球学 Spring Boot」;涵盖SpringBoot所有教学内容。
该专栏以“循序渐进 + 实战驱动”为核心理念,从基础到进阶到就业到架构师逐层展开,帮助你快速建立完整的 Spring Boot 技术体系,带你玩转SpringBoot框架。
📌 学习承诺: 通过该专栏,你将能够:
- 快速掌握 Spring Boot 核心开发能力
- 构建完整的后端项目认知体系
- 实现从“入门”到“独立开发”的跃迁
就像“滚雪球”一样,知识不断积累、能力持续放大,实现指数级成长 🚀
最后,如果这篇文章对你有所帮助,帮忙给作者来个一键三连,关注、点赞、收藏,您的支持就是我坚持写作最大的动力。
同时欢迎大家关注技术号:「猿圈奇妙屋」 ,以便学习更多同类型的技术文章,免费白嫖最新BAT互联网公司面试题、4000G PDF编程电子书、简历模板、技术文章Markdown文档等海量资料。
ps:本文涉及所有源代码,均已上传至Gitee开源,供同学们直接对照学习 Gitee传送门,同时,原创开源不易,欢迎给个star🌟,想体验下被🌟的感jio,非常感谢❗
🫵 Who am I?
我是 bug菌,一名深耕 Java 后端领域数十年的一线研发老兵,曾担任独角兽企业后端技术经理、研发架构师等职位,长期专注于 Java 后端、分布式架构、微服务治理、高并发系统、工程效能与研发管理等方向。
目前活跃于多个主流技术社区,包括:
CSDN|稀土掘金|InfoQ|51CTO|华为云开发者社区|阿里云开发者社区|腾讯云开发者社区|开源中国|博客园|墨天轮 等平台。
曾获得:
- CSDN 博客之星 Top30
- 华为云多年度十佳博主 & 卓越贡献奖
- 掘金多年度人气作者 Top40
- CSDN、掘金、InfoQ、51CTO 等平台签约作者 / 优质作者
截至目前,全网技术内容累计影响读者众多,全网粉丝已超过 30w+。
如果你也关注 Java 后端、架构设计、技术成长、职场进阶与研发管理,欢迎关注我的技术内容合集入口:👉 点击查看 👈️
硬核技术号 「猿圈奇妙屋」 期待你的加入。
这里不仅分享技术干货,也记录一线研发人的成长、踩坑、思考与进阶路径。
愿我们一起打怪升级,在技术路上持续进阶。
– End –