OpenHands(前身 OpenDevin)是目前规模最大的开源 AI 软件工程代理平台,它的核心主张不是“帮你补全下一行代码”,而是把完整任务交给代理,由它在真实环境中读代码、改文件、跑测试、调试错误,直到任务完成或需要人类介入。 截至 2026 年,其 GitHub Star 数已超过 90,000,采用 MIT 许可证,是“代理式软件开发”(agentic software development)这一范式最完整的开源实现之一。
🎯 定位:从“代码补全”到“代理式工程”
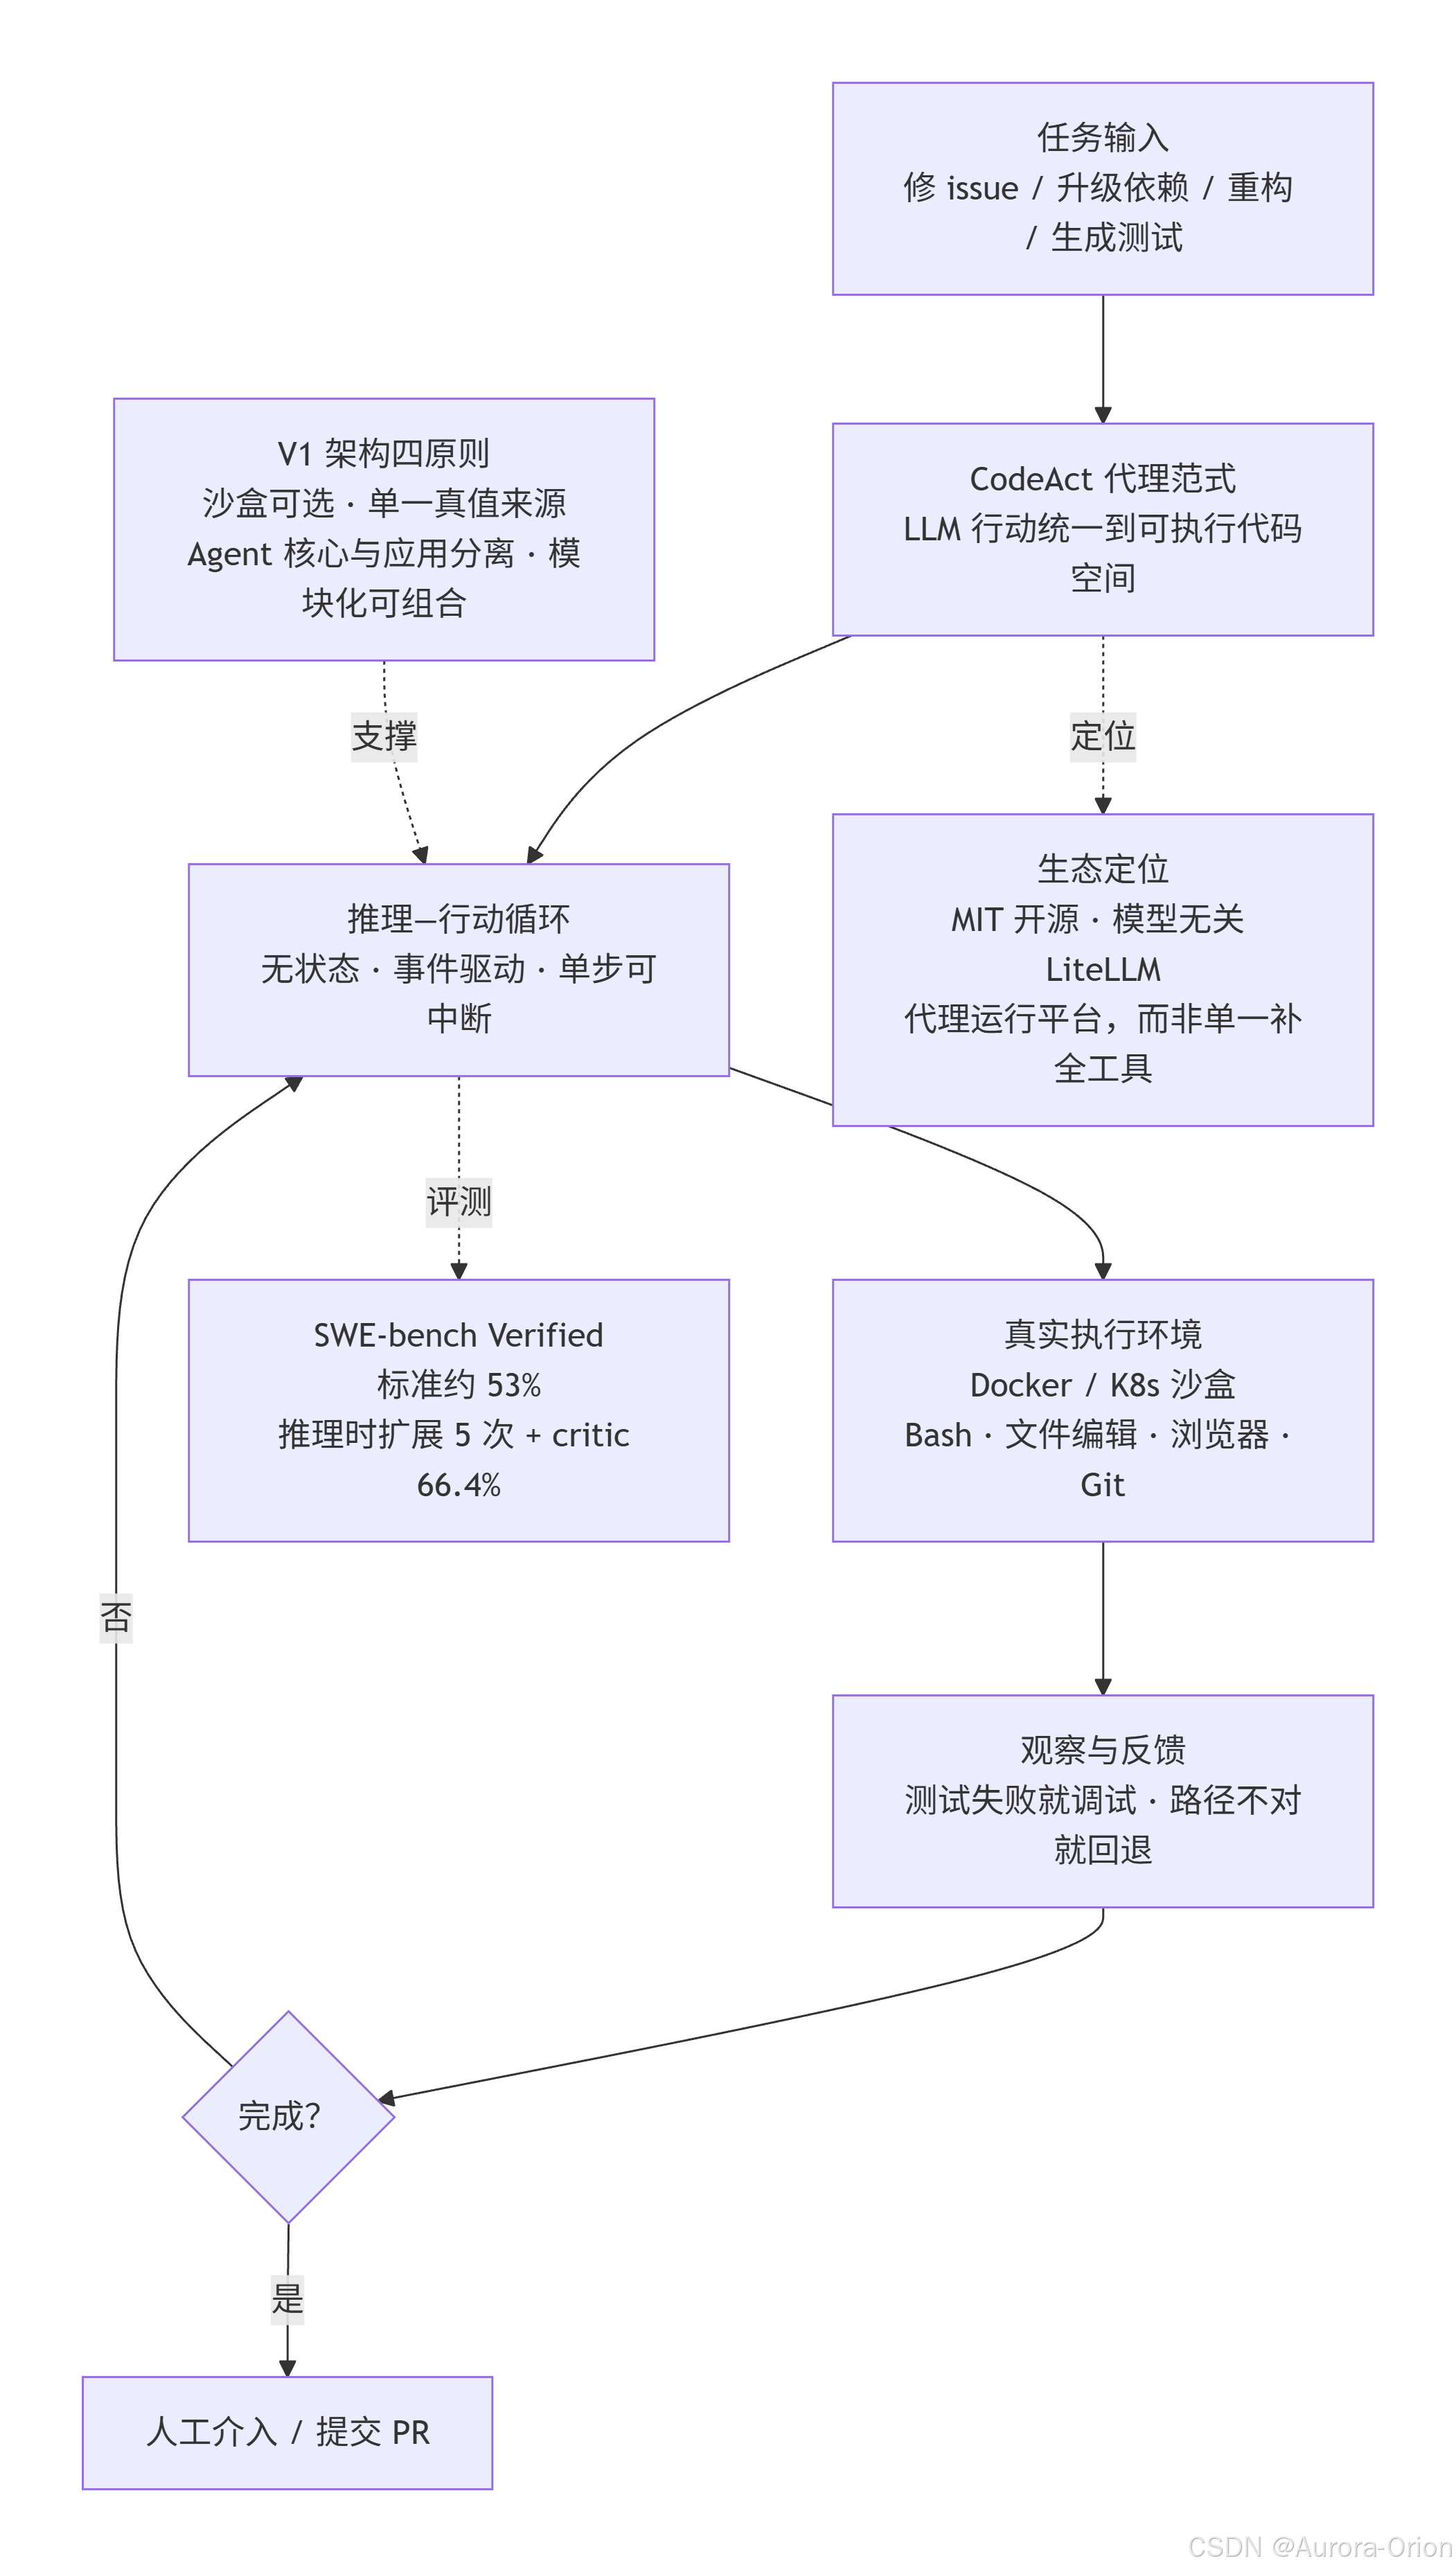
理解 OpenHands 的关键,在于区分它与 Copilot 类工具的根本不同。代码补全工具给出的是文本建议,它看不到自己生成的代码在运行后会发生什么。OpenHands 走的是另一条路径:给它一个完整任务(例如“修复这个 issue”或“把依赖升级到新版本”),它会在受控环境中实际执行操作,观察结果,然后根据反馈决定下一步——测试失败就调试,路径不对就回退重试。
这种“行动—观察—再行动”的闭环,是 OpenHands 能力边界的根基。它支持的任务谱系很宽:一次性的小任务(为仓库生成 README)、常规维护(依赖升级、单测生成、merge conflict 解决),以及需要多代理协作的大型工程(重构与重写)。使用形态也覆盖了多种入口:SDK(Python / REST API)、CLI、Agent Canvas(浏览器界面)、Cloud 托管服务和企业版,开发者可以按自己的基础设施偏好选择介入方式。
⚙️ 核心机制:CodeAct 与推理—行动循环
OpenHands 的代理行为建立在一个名为 CodeAct 的范式之上。CodeAct 的核心思想是把大语言模型的“行动”统一到代码空间:模型不是输出自然语言指令再由外部系统翻译为操作,而是直接生成可执行的代码动作,在一个统一的动作空间中完成写文件、执行 Bash 命令、编辑代码等操作。这相当于给模型装上了“手”和“眼”,让它能在文件系统和终端中真实操作,而不仅仅是在对话中“谈论”代码。
在 SDK 层面,这一范式被实现为一个无状态、事件驱动的推理—行动循环。Agent 的每一个 step() 处理一个推理周期:查询 LLM 生成下一步动作,解析响应,执行工具,将观察结果写回事件历史,然后进入下一步。这个设计有三个关键特性:
-
无状态(Stateless) :Agent 在步骤之间不持有可变状态,状态的真值来源是单一的事件历史。这使得确定性重放、故障恢复和强一致性成为可能。
-
事件驱动:读取事件历史,写入新事件,整个执行过程可以被完整追溯。
-
可中断:每个步骤是原子的,可以在任意步骤暂停和恢复,这对长周期任务和人工审批流程至关重要。
🏗️ V1 架构:一次以“可组合性”为目标的重构
OpenHands 在 2025—2026 年间完成了从 V0 到 V1 的重大架构迁移。V0 是一个单体式设计,把代理逻辑、评估和应用耦合在同一个代码库中,适合快速原型,但带来了沙盒僵化和研究—生产过度耦合的问题。V1 的重构围绕四项设计原则展开:
第一,沙盒化从“强制”变为“可选”。 V0 中每一次工具调用都默认在 Docker 容器中执行,安全但引入了进程间摩擦。V1 的默认设置是在单进程中统一 Agent 与工具的执行,当需要隔离时,同一个栈可以被透明地容器化。安全隔离没有被放弃,而是从“默认强制”转变为“按需启用”。
第二,默认无状态,单一真值来源。 所有组件——Agent、工具、LLM、配置——都被建模为不可变的、在构建时验证的 Pydantic 模型。唯一可变的实体是会话状态,所有变更被隔离在这一个地方,从而支持确定性重放和长期运行的稳定恢复。
第三,严格分离 Agent 核心与应用。 代理核心被隔离为独立的 SDK,应用通过 API 集成。研究可以独立于应用演进,生产部署也可以复用同一套核心逻辑而不被应用层绑架。
第四,可组合性优先。 V1 的四个模块化包——SDK、Tools、Workspace、Agent Server——可以在部署层面灵活组合,支持本地、托管或容器化执行;在能力层面,类型化的组件模型允许开发者以声明式方式扩展工具、LLM 和上下文,而不必触碰核心代码。
在生产架构中,一次对话的完整链路大致是:用户或 webhook 创建会话 → 鉴权 → Runtime API 分配一个预热或新建的沙盒 pod → 沙盒内的 Agent 通过 LiteLLM 代理调用配置的 LLM,执行 Bash、文件编辑、浏览器、Git 等工具 → 事件流回传至应用和浏览器 → 会话状态持久化到 PostgreSQL、Redis 和对象存储。LiteLLM 代理的存在使得模型无关的多 LLM 路由成为架构层面的原生能力,而不是事后补丁。
📊 性能:SWE-bench 上的真实位置与推理时扩展
SWE-bench Verified 是当前衡量 AI 编程代理解决真实 GitHub issue 能力的行业金标准,包含 500 个人工验证过的 issue。OpenHands 在这一基准上的表现需要分层来看:
在标准单次执行设定下,一项独立实证研究使用 OpenHands CodeAct v2.1 在全部 500 个 issue 上的官方结果解决了 53.0%(265/500) ,与 Agentless 的 50.8% 和 Tools Claude 的 49.0% 处于同一量级(差异在 4 个百分点以内)。值得注意的是,OpenHands 与 Tools Claude 使用相同的基座模型和相似的工具集,但仍有 4 个百分点的差距,说明脚手架实现细节(文件导航方式、工具使用指令、工作区路径约定等)在整体成功率中起着不可忽略的作用。更有信息量的发现来自实例层面的互补性:OpenHands 与 Tools Claude 共同解决了 205 个 issue,但各自还独有解决了 60 个和 40 个,意味着即使总体准确率相近,不同系统在不同类型的 issue 上各有优势。
OpenHands 团队随后展示了推理时扩展(inference-time scaling) 带来的提升:通过生成多条轨迹并从中选择最佳解,配合一个专门训练的 critic model(基于 Qwen 2.5 Coder 32B,使用时序差分学习目标将单元测试的终端信号反向传播到每一步动作),单轨迹的 60.6% 提升到了五次尝试的 66.4%,呈现对数线性改进。这一步的意义不在于刷榜,而在于证明了在不修改底层模型和脚手架的前提下,额外的推理计算可以系统性地转化为成功率提升——这对于实际部署中的成本—可靠性权衡是一个可操作的维度。
🔍 与生态中其他路线的差异
OpenHands 在 AI 编程代理生态中的位置,可以通过与几个代表性系统的对照来定位。
与 Devin 相比,最直接的差异是开源与成本结构。Devin 是 Cognition 的全托管商业产品,Pro 版 $20/月,企业版按 Agent Compute Unit 计费;OpenHands 自托管版本在 MIT 许可下免费,云服务提供 bring-your-own-key 的免费层级,成本主要是模型 API 费用。一项对比估算认为,在单任务层面,OpenHands 路线与 Devin 的成本差距可达三个数量级。代价是 OpenHands 需要用户自行承担基础设施运维和沙箱管理的责任,而 Devin 把这些作为托管服务交付。在自主循环的完整性上,OpenHands 被评价为能够端到端运行完整自主软件工程循环:读 issue、写代码、跑测试、调试失败、提交 PR,无需逐步人工指令。
与 Aider、Claude Code 等“harness”类工具相比,差异在设计重心。Aider 聚焦于现有仓库内的结对编程,强调通过版本控制实现可审计性;Claude Code 侧重运行时护栏和交互式体验;OpenHands 则把沙盒隔离执行和事件流架构作为首要设计约束,服务于“启动任务→监控执行”的 headless 自主运行模式。一个有意思的生态事实是,OpenHands 的 Agent Canvas 甚至可以将 Claude Code、Codex、Gemini CLI 等第三方代理作为可互换的后端来运行,这反过来也说明 OpenHands 的定位更接近代理运行平台,而不仅仅是单一代理实现。
与 OpenAI、Claude、Google 的 Agent SDK 相比,OpenHands 官方强调的差异化在于原生集成了四项能力:沙盒化执行、生命周期控制、模型无关的多 LLM 路由,以及内置的安全分析。这些不是外围功能,而是被写进核心架构的设计约束。
📋 核心能力一览
| 范式 | CodeAct:将 LLM 行动统一到可执行代码空间,形成“推理—执行—观察”闭环 |
| 核心循环 | 无状态、事件驱动、单步原子可中断的推理—行动循环 |
| V1 设计原则 | 沙盒可选、默认无状态/单一真值来源、Agent 核心与应用分离、模块化可组合 |
| 执行环境 | Docker / Kubernetes 沙盒;本地到远程执行可移植 |
| 模型支持 | 模型无关,通过 LiteLLM 路由 Claude、GPT、Qwen、本地模型等 |
| 安全 | Security Analyzer 在执行前评估动作风险(直接执行 / 确认 / 阻断) |
| 基准表现 | SWE-bench Verified:标准设定约 53%;推理时扩展(5 次尝试 + critic)66.4% |
| 使用形态 | SDK、CLI、Agent Canvas(浏览器)、Cloud、Enterprise |
| 许可与生态 | MIT 开源核心;GitHub Star 90k+;支持 MCP、Jira、Slack、Git 提供商集成 |
总结:OpenHands 的价值不在于它在单一基准上是否排名第一,而在于它把“自主软件工程代理”从一个演示概念变成了一套可自托管、模型无关、架构上认真对待隔离与状态管理的开源基础设施。CodeAct 给了代理“动手”的能力,V1 的无状态事件驱动架构给了这种能力可复现、可恢复、可组合的工程底座,而 SWE-bench 上的推理时扩展结果则表明,在基座模型能力持续演进的同时,脚手架质量和测试时计算仍然是决定实际可用性的独立变量。如果说 Copilot 改变的是“写每一行代码的方式”,OpenHands 试图改变的是“一个工程任务从被交出去到被完成的方式”。