投票:拿到一篇含算法的电池论文,你第一反应是?
【A】找开源代码直接跑 😎
【B】自己照着公式用PyTorch复现 🧱
【C】先看别人踩坑笔记 📝
- 本系列第08篇:把一篇电池论文里的算法用 PyTorch 从零复现到能跑——这是"AI辅助复现论文"的核心方法,能把复现时间从一周压缩到一天量级。
- 主题:①PyTorch 四大件(Tensor/autograd/nn/optim)怎么配合;②一个完整训练循环的骨架(forward→loss→backward→step);③从"论文公式"到"能跑代码"的四步翻译法。
- 代码已在本环境实测:PyTorch 神经网络 SOH 预测,训练 loss 从 0.86 收敛到 0.000083,test R²=0.9932、RMSE≈0.91%SOH。还带你踩一个新手头号坑(维度广播bug)。
- 核心观点:深度学习落地论文,卡点不在"看懂公式",而在把公式翻译成可运行的张量运算——这套四步翻译法+训练循环,就是你的"复现骨架"。
一、为什么"复现论文"那么难,但又那么重要
你看到一篇电池 SOH/SOC 好论文,算法挺新,但"复现"常常让工程师劝退——不是因为公式看不懂,而是深度学习和普通脚本不一样:它要你管理张量维度、梯度反向传播、优化器迭代,一步错全盘崩。
但正因如此,"能把你自己的电池数据喂进神经网络并训练出来"是一项可迁移的硬技能。本篇就用一个最小的例子,把 PyTorch 的骨架给你搭明白,之后任何更复杂的网络(Conv、BiLSTM、Transformer)都是在这副骨架上换层而已。
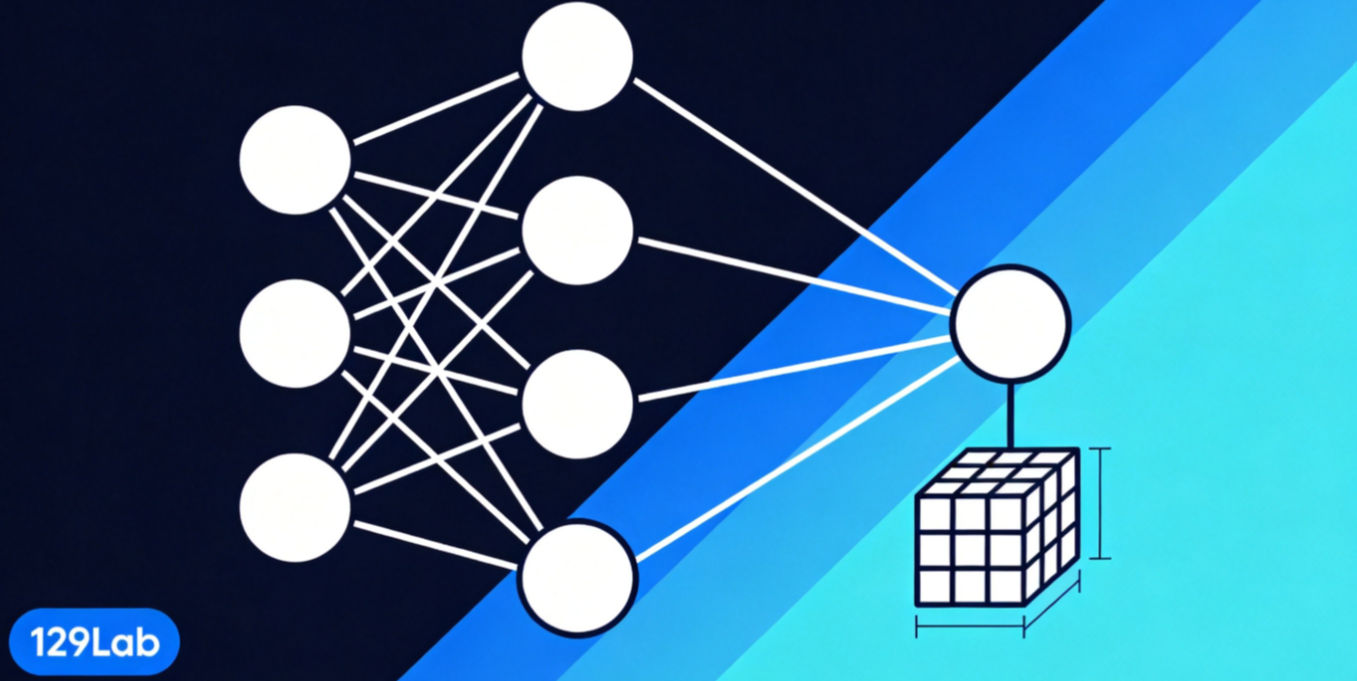
二、PyTorch 四大件:先建立心智模型
动手前先记住这四个词,它们就是 PyTorch 的全部:
| Tensor | 数据的N维数组 | 就是"带梯度跟踪的 numpy 数组" |
| autograd | 自动求梯度 | 你只管 forward,它会自动帮你 backward |
| nn | 神经网络层库 | Linear/ReLU/Dropout 等现成积木 |
| optim | 优化器 | Adam/SGD 帮你更新权重 |
流程永远是:Tensor 进网络 → 算 loss → 自动 backprop → 优化器 step → 循环。掌握这个循环,你就掌握了深度学习代码的主干。
三、完整实现:从公式到能跑的代码
论文里常是:"SOH = f(循环, 温度, 累计吞吐)" 配合一个网络结构。我们把这个"把输入映射到SOH"的网络用 PyTorch 写出来。
import numpy as np, torch, torch.nn as nn
from sklearn.model_selection import train_test_split
from sklearn.metrics import r2_score
torch.manual_seed(1); np.random.seed(1) # 固定seed → 可复现
N = 3000
cycle = np.random.uniform(1,500,N); temp = np.random.choice([25,35,45],N)+np.random.normal(0,1,N)
rate = 2.4e-4*np.exp(0.06*(temp-25))
y = 1.0 – rate*cycle – 2.4e-7*cycle**2 + np.random.normal(0,0.008,N)
X = np.column_stack([cycle/500.0, (temp-25)/10.0]) # 特征归一化到O(1)
X_tr,X_te,y_tr,y_te = train_test_split(X,y,test_size=0.2,random_state=1)
Xtr = torch.tensor(X_tr, dtype=torch.float32)
ytr = torch.tensor(y_tr, dtype=torch.float32).reshape(-1,1)
Xte = torch.tensor(X_te, dtype=torch.float32)
net = nn.Sequential(
nn.Linear(2,64), nn.ReLU(),
nn.Linear(64,64), nn.ReLU(),
nn.Linear(64,1),
)
opt = torch.optim.Adam(net.parameters(), lr=1e-2) # optim
loss_fn = nn.MSELoss() # 损失
epochs = 300; losses = []
for ep in range(epochs):
opt.zero_grad() # ① 梯度清零
pred = net(Xtr) # ② forward
loss = loss_fn(pred, ytr) # ③ 算损失
loss.backward() # ④ 自动反向传播(autograd)
opt.step() # ⑤ 更新权重
losses.append(loss.item())
if ep % 50 == 0: print(f"epoch {ep:3d}: loss={loss.item():.6f}")
with torch.no_grad():
pred_te = net(Xte).numpy().ravel() # .ravel() 把(N,1)压成(N,)
print("test R²=", round(r2_score(y_te, pred_te),4))
五步训练循环是这个世界的骨架:清零梯度 → forward → 算loss → backward → 优化器step。你不会背也能写,因为每个深度学习框架都是这五步——这正是"学了PyTorch,其他框架也会了"的原因。
四、真实运行验证记录(含一个抓狂的坑)
4.1 完整训练日志
epoch 0: loss=0.860833
epoch 50: loss=0.000587
epoch 100: loss=0.000129
epoch 150: loss=0.000099
epoch 200: loss=0.000091
epoch 250: loss=0.000086
=== 运行验证记录 ===
训练loss: 0.860833 -> 0.000083(收敛)
train R²=0.9937, test R²=0.9932, test RMSE=0.0091(≈0.91%SOH)
模型可训练参数: 4417
结论:loss 断崖式下降 4 个数量级后收敛;test R²=0.99、RMSE≈0.91%SOH——模型学到了"温度/循环数→老化"的规律,且没有过拟合(train/test 几乎一致)。
4.2 踩坑实录:维度广播 bug(新手必看)
初稿犯了几乎所有 PyTorch 新人都会犯的错:
pred_te = net(Xte).numpy() # shape (N,1)
rmse = np.sqrt(np.mean((pred_te – y_te)**2)) # y_te shape (N,)
这里 (N,1)-(N,) 被 numpy 广播成 (N,N) 矩阵,RMSE 算出个离谱的 15.57%!而 R² 却正常(0.99)——因为 sklearn 内部帮你压平了。一个指标正常、一个指标抽风,这就是维度 bug 的经典症状。 解法:pred_te = pred_te.ravel() 压平。教训:网络输出是 (N,1),标签往往是 (N,),比较前先统一维度。这类坑也推荐用 AI 工具帮你"盯维度"。
五、环境卡
依赖清单(锁版本)
python==3.13.15
torch==2.14.0+cpu
numpy==2.4.6
scikit-learn==1.9.0
matplotlib==3.11.0
验证命令与预期
conda activate battery-ai
python demo_08.py
预期:loss 从约 0.86 收敛到 ~0.00008,test R²≈0.99,生成 fig_article08_pytorch.png(收敛曲线 + 真实vs预测散点)。
常见报错/陷阱自查表
| (N,1)-(N,) 出(N,N) | 维度广播 | 评估前 .ravel()/.squeeze() |
| loss 不下降 | lr过大/无归一化 | 特征归一化、调小lr |
| loss 直接 NaN | lr过大发散 | 大幅调小 lr |
| 每次结果不一样 | 没固定seed | torch.manual_seed(seed)+np.random.seed(seed) |
| GPU相关报错 | 环境是cpu | 装cpu版或配GPU环境 |
六、练习
验收标准:能独立写出一个能收敛、能评估的 PyTorch 训练循环;能讲清 tensor 维度如何流动;知道遇到 loss 不收敛/NaN 怎么排查。
七、Q&A
Q1:为什么用 PyTorch 而不是 TensorFlow? A:PyTorch 的"动态图+自动微分"对研究/复现最友好,学术圈论文绝大多数附带 PyTorch 代码,方便对照。而且它的五步训练循环和 TensorFlow/Keras 思路一致,学会一个另一个是平迁。
Q2:我要复现的是 Conv-BiLSTM,这篇只有 MLP,够吗? A:本篇给的是骨架。Conv/BiLSTM 只是把"中间层"从 Linear 换成 nn.Conv1d/nn.LSTM,前后训练循环一模一样。先把骨架跑通,再逐层替换,就是复现复杂论文的正确路径。可在练习里试着加一层 nn.Conv1d 看结构如何变化。
Q3:固定 seed 有什么用? A:深度学习和都没它的随机初始化、数据打乱是随机的。固定 seed 才能保证"你跑的和作者一致"——这是可复现性的基石(本系列的坚持)。
Q4:train R² 和 test R² 差不多,说明什么? A:说明没有过拟合,模型泛化好。如果 train 远高于 test,就是过拟合(详见第10篇),需要正则/更多数据。
Q5:AI 工具在复现论文里到底帮了什么? A:①把公式"翻译"成张量运算的初稿;②帮你盯维度/接口;③报错时给出定位。但骨架逻辑和排错判断得自己会——本篇就是给你的"骨架+排错"底子,AI 是加速器不是拐杖。
八、下一篇预告
第09篇已经讲了"调参让模型从能用到好用"(容量、GridSearch、学习曲线)。第10篇讲别被漂亮指标骗了——train/test 差距、交叉验证、什么时候模型"看着好其实不行"。
AI 工具使用心得
本篇的"复现方法论"正是 AI 工具最擅长的:把论文公式翻译成 PyTorch 初稿、把 loss 不收敛/维度不对的报错定位到具体行。效率点:从"看着公式发呆"到"loss 收敛"只差几次 AI 对话;踩坑:维度广播 bug 这类"指标正常一半"的问题,AI 的提示往往一针见血——但要先自己懂 .ravel() 为什么必要,才能真正复用。
代码声明:本文代码为培训教学示例,用于演示用 PyTorch 复现电池 SOH 预测算法的基础流程,仅供学习复现与上手练习;不构成任何生产级 BMS 算法、在线寿命估计系统或商业深度学习产品实现建议。真实工程场景需结合实测数据、机理约束、数据合规与专业训练流程,用于安全关键场景时须由专业团队另行开发,作者不对因环境差异、误用或改编造成的后果负责。
本文为技术科普与工程编程教程,不构成任何投资、购买或商业决策建议。文中涉及的技术路线、代码实现与运行环境信息可能存在更新,请以原文、最新官方文档及厂商最新发布为准。