必会算法之:SAM
- 1、引言
- 2、SAM(Segment Anything Model)
-
- 2.1 定义与解析
- 2.2 核心原理
-
- 2.2.1 图像编码器(Image Encoder)
- 2.2.2 提示编码器(Prompt Encoder)
- 2.2.3 掩码解码器(Mask Decoder)
- 2.2.4 训练数据引擎:SA-1B
- 2.3 实现方式 / 工作流程
- 2.4 算法公式
- 2.5 代码示例
- 3、总结
1、引言
小屌丝:鱼哥,最近刷 GitHub,老看见一个叫 SAM 的项目,Star 都飙到 4w+ 了,这是啥来头啊?
小鱼:哦,你说的是 Meta 那个"分割一切"的基础模型吧。
小屌丝:对对对,Segment Anything,这名字听着就霸气。鱼哥给讲讲呗?
小鱼:行,今天咱就扒一扒这个 SAM,从原理到代码实战,包教包会。
小屌丝:矮油~ 鱼哥还是你懂我。不过鱼哥,这玩意儿跟我之前看的 YOLO 有啥不一样?
小鱼:问到点子上了。YOLO 是"看见什么就框什么",类别是固定的;SAM 是"你指哪我分哪",靠提示(prompt)驱动,开放词汇、零样本,啥都能分。
小屌丝:懂了,一个靠学出来的,一个靠点出来的。
小鱼:(⊙o⊙)… 你这总结还挺到位。那咱正式开整。
2、SAM(Segment Anything Model)
2.1 定义与解析
SAM(Segment Anything Model,分割一切模型),是 Meta AI(FAIR 团队)在 2023 年 4 月提出的一个图像分割基础模型(Foundation Model for Segmentation)。
一句话理解它:你给模型一个"提示"(点一下、框一下、或者给个掩码),它就能把图像里对应的物体精准地分割出来,而且换一张从来没见过的图、换一个领域(医学、遥感、自动驾驶),它照样能分。
这里有两个关键词,必须拎清楚:
- 可提示(Promptable):分割不再是一个"固定输入输出"的死任务,而是变成了"我给你提示,你给我掩码"的交互式任务。这跟 NLP 里 GPT 的"提示范式"是一个思路。
- 零样本泛化(Zero-shot):在超大规模数据上预训练后,模型能直接迁移到新任务、新数据分布,无需重新训练。
简单来说,SAM 把"分割"从专精一项的"手艺人",变成了啥活都能接的"万能工"。
2.2 核心原理
SAM 的网络结构非常清爽,就三大件,像流水线一样各司其职:
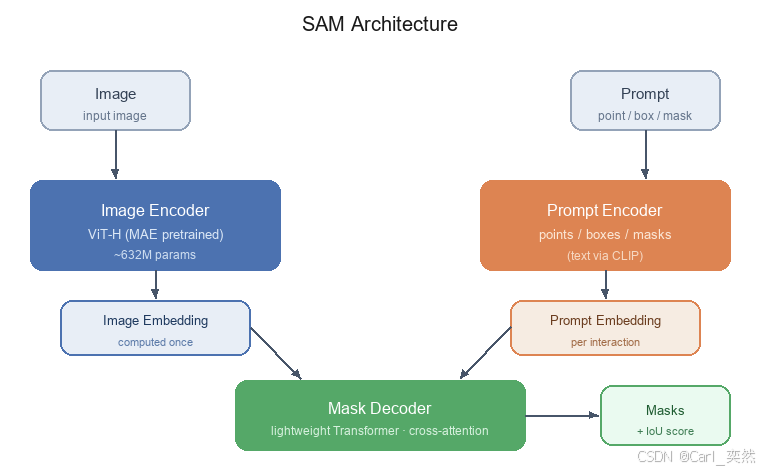
图1:SAM 整体架构——图像编码器、提示编码器、掩码解码器三大件各司其职
2.2.1 图像编码器(Image Encoder)
这是 SAM 里最重的部件,直接搬了 ViT-H(Vision Transformer – Huge),用 MAE(掩码自编码)预训练,参数量约 632M。
它干一件事:把输入图像编码成一个图像 Embedding。
关键点在于——这个编码只需对每张图跑一次。无论你后面给 1 个提示还是 100 个提示,图像 Embedding 都复用,这就把"实时交互"变得非常快。
2.2.2 提示编码器(Prompt Encoder)
负责把用户的"提示"变成向量,分两类:
- 稀疏提示(Sparse):
- 点(Points):用坐标位置编码,再叠加"前景/背景"标签(1=前景,0=背景);
- 框(Boxes):用框的两个对角点坐标编码;
- 文本(Text):接口基于 CLIP 文本编码器设计(官方发布的权重主要以点/框/掩码训练,文本为预留能力)。
- 密集提示(Dense):
- 掩码(Mask):用轻量卷积嵌入后,直接与图像 Embedding 相加。
2.2.3 掩码解码器(Mask Decoder)
这是 SAM 的"灵魂",一个轻量级的 Transformer 解码器(参数量仅约 9M,推理极快)。
它通过 Prompt 自注意力 + 图像/提示双向交叉注意力(Cross-attention),把图像 Embedding 和提示 Embedding 融合,最终吐出:
这里有个非常巧妙的设计——歧义感知(Ambiguity-aware)。当你点的提示有歧义(比如点了一下"车轮",到底是只要轮子,还是连车身一起?),SAM 会一次性输出多个(通常 3 个)有效掩码:整体 / 部分 / 子部分,由你按 IoU 分数挑。
2.2.4 训练数据引擎:SA-1B
巧妇难为无米之炊。SAM 强,强在它的"米"——**SA-1B(Segment Anything 1-Billion)**数据集:
- 1100 万张图像;
- 11 亿个高质量分割掩码(自动生成);
- 掩码量是 Open Images 的约 400 倍。
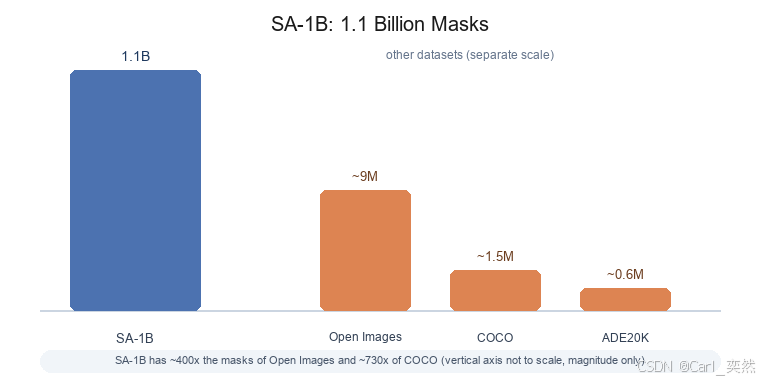
图2:SA-1B 掩码量对比——11 亿掩码,约是 Open Images 的 400 倍、COCO 的 730 倍
这些掩码不是人工标的,而是 Meta 用一个**“数据引擎”**自动造出来的,分三个阶段:辅助人工 → 半自动 → 全自动。模型一边训、数据一边涨,形成飞轮。
2.3 实现方式 / 工作流程
SAM 的推理流程可以压缩成 4 步,非常好记:
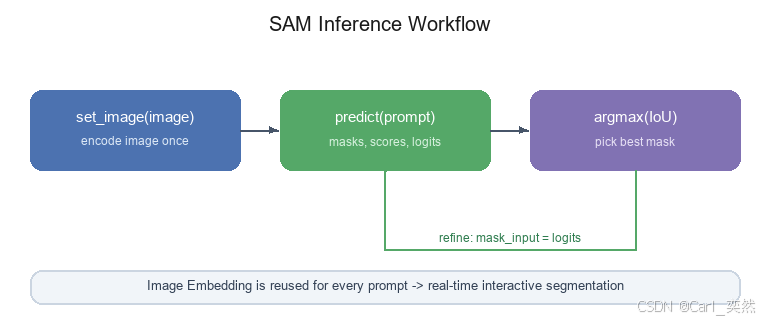
图3:SAM 推理流程——图像只编码一次,提示实时编码,掩码解码器轻量出结果,还能回灌 logits 精炼
SAM 2(2024 升级版):把这套范式从"图像"搬到了"视频",引入了记忆机制(Memory Bank / Memory Attention),在帧与帧之间传播掩码,实现了交互式视频对象分割(Segment Anything in Videos)。如果你做的是视频任务,直接上 SAM 2 即可,思路一脉相承。
2.4 算法公式
SAM 的数学表达很克制,核心就是三段映射:
① 图像编码
F
=
Encoder
image
(
I
)
F = \\text{Encoder}_{\\text{image}}(I)
F=Encoderimage(I)
其中
F
F
F 为图像 Embedding,
I
I
I 为输入图像。
② 提示编码
P
=
Encoder
prompt
(
p
)
P = \\text{Encoder}_{\\text{prompt}}(p)
P=Encoderprompt(p)
其中
p
p
p 为用户提示(点/框/掩码),
P
P
P 为提示 Embedding。
③ 掩码解码
M
^
,
q
^
=
Decoder
(
F
,
P
)
\\hat{M},\\, \\hat{q} = \\text{Decoder}(F, P)
M^,q^=Decoder(F,P)
输出预测掩码
M
^
\\hat{M}
M^ 与对应的 IoU 质量预测
q
^
\\hat{q}
q^。
④ 训练损失
掩码分支用 Focal Loss + Dice Loss 组合监督,IoU 头用预测分数与真实 IoU 的均方误差:
L
=
L
focal
(
M
^
,
M
)
+
L
dice
(
M
^
,
M
)
+
λ
⋅
MSE
(
q
^
,
q
gt
)
\\mathcal{L} = \\mathcal{L}_{\\text{focal}}(\\hat{M}, M) + \\mathcal{L}_{\\text{dice}}(\\hat{M}, M) + \\lambda \\cdot \\text{MSE}(\\hat{q}, q_{\\text{gt}})
L=Lfocal(M^,M)+Ldice(M^,M)+λ⋅MSE(q^,qgt)
不用被公式吓到,记住一句话:图像编码一次、提示实时编码、解码器轻量出掩码,这就是 SAM 又快又准的底层逻辑。
2.5 代码示例
下面用 Meta 官方 segment-anything 包,跑通"点提示分割"和"框提示分割"两个最常用场景。
环境准备:
# 安装官方库
pip install segment-anything
# 下载 ViT-H 权重(约 2.4GB)
# 官方地址:https://github.com/facebookresearch/segment_anything
# 权重文件:sam_vit_h_4b8939.pth
① 点提示分割(点一下,分一个物体)
import numpy as np
import cv2
from segment_anything import sam_model_registry, SamPredictor
# 1、加载模型(vit_h / vit_l / vit_b 三档可选)
sam = sam_model_registry["vit_h"](checkpoint="sam_vit_h_4b8939.pth")
predictor = SamPredictor(sam)
# 2、读取图像并编码(这一步只跑一次,最耗时)
image = cv2.cvtColor(cv2.imread("demo.jpg"), cv2.COLOR_BGR2RGB)
predictor.set_image(image)
# 3、给提示:中心点 = 前景
point_coords = np.array([[500, 350]]) # [x, y] 像素坐标
point_labels = np.array([1]) # 1=前景, 0=背景
# 4、预测(multimask_output=True 输出多个候选掩码)
masks, scores, logits = predictor.predict(
point_coords=point_coords,
point_labels=point_labels,
multimask_output=True,
)
# 5、取 IoU 分数最高的掩码
best_mask = masks[np.argmax(scores)]
print("掩码形状:", best_mask.shape, "置信度:", scores[np.argmax(scores)])
② 框提示分割(框一下,抠出目标)
# 直接给一个边界框 [x1, y1, x2, y2]
box = np.array([120, 80, 460, 520])
masks, scores, logits = predictor.predict(
box=box,
multimask_output=False, # 框提示通常目标明确,取单掩码
)
# 把掩码叠加到原图,做可视化
color = np.array([30, 255, 30])
masked = image.copy()
masked[best_mask] = color
cv2.imwrite("result.jpg", cv2.cvtColor(masked, cv2.COLOR_RGB2BGR))
③ 掩码精炼(用预测结果再提示一次)
# 把上一轮输出的 logits 当作"密集提示"喂回去,精度更上一层
masks_refined, scores_refined, _ = predictor.predict(
point_coords=point_coords,
point_labels=point_labels,
mask_input=logits[np.argmax(scores)],
multimask_output=False,
)
小提示:如果你要做视频分割,把 segment-anything 换成 segment-anything-2,SamPredictor 升级为 SAM2VideoPredictor,加一个 add_new_points_or_box + propagate_in_video 就能逐帧传播掩码,思路和上面完全一致。
典型应用场景:智能抠图/换背景、医学影像分割、遥感地物提取、自动驾驶感知、机器人抓取、AR/VR、以及自动生成训练数据(用 SAM 打标,再喂给下游模型)。
3、总结
今天这篇,咱们把 SAM(Segment Anything Model) 从头到尾过了一遍:
- 是什么:Meta 出品的"分割一切"基础模型,提示驱动、零样本泛化;
- 怎么搭:图像编码器(ViT-H) + 提示编码器 + 轻量掩码解码器,三件套各管一摊;
- 强在哪:SA-1B 的 11 亿掩码喂出来的,歧义还能一次出多掩码;
- 怎么用:set_image 编码一次,predict 给提示出掩码,几行代码就能跑通;
- 往哪走:SAM 2 已经把能力从图像延伸到视频,记忆机制一加,视频对象分割也不在话下。
到这儿,你手里就多了一把"万能分割刀"。不论是做图像编辑、数据标注,还是给自己的 CV 项目打底,SAM 都是绕不开的必会算法。
要是这篇对你有帮助,点赞 + 收藏 + 关注 三连走起,鱼哥继续带你从 0 到 1 啃透计算机视觉。下篇想听啥,评论区留言,咱接着唠~
我是小鱼:
- CSDN 博客专家;
- AIGC MVP专家;
- 阿里云 专家博主;
- 51CTO博客专家;
- 企业认证金牌面试官;
- 多个头部名企认证&特邀讲师等;
- 名企签约职场面试培训、职场规划师;
- 多个国内主流技术社区的认证专家博主;
- 多款主流产品(阿里云等)评测一等奖获得者;
关注小鱼,学习【机器视觉与目标检测】最新最全的领域知识。
创作不易,转载请注明出处。技术迭代飞快,具体 API 以官方仓库最新文档为准。