/* MD / 富文本中的 .toc(含博客园搬家等嵌套结构);.toc-box 在侧栏,不受影响 */
#content_views .toc,
/* 编辑器常在目录前后插入空 p(:empty 仍占 20px),一并去掉避免顶空隙 */
#content_views.markdown_views > p:empty:has(+ .toc),
#content_views.markdown_views > .toc + p:empty,
/* 富文本旧版目录标记 */
#content_views.htmledit_views #main-toc,
#content_views.htmledit_views #hr-toc,
#content_views.htmledit_views p[id*=\”-toc\”] {
display: none !important;
}
/* 目录去掉后,紧跟的首个标题不再多出一块上边距 */
#content_views.markdown_views > .toc + h1,
#content_views.markdown_views > .toc + h2,
#content_views.markdown_views > .toc + h3,
#content_views.markdown_views > .toc + h4,
#content_views.markdown_views > .toc + p:empty + h1,
#content_views.markdown_views > .toc + p:empty + h2,
#content_views.markdown_views > .toc + p:empty + h3,
#content_views.markdown_views > .toc + p:empty + h4 {
margin-top: 0 !important;
}
分布式存储 IO 链路调优:从 Linux 页缓存脏页刷盘到 NVMe 硬件调优
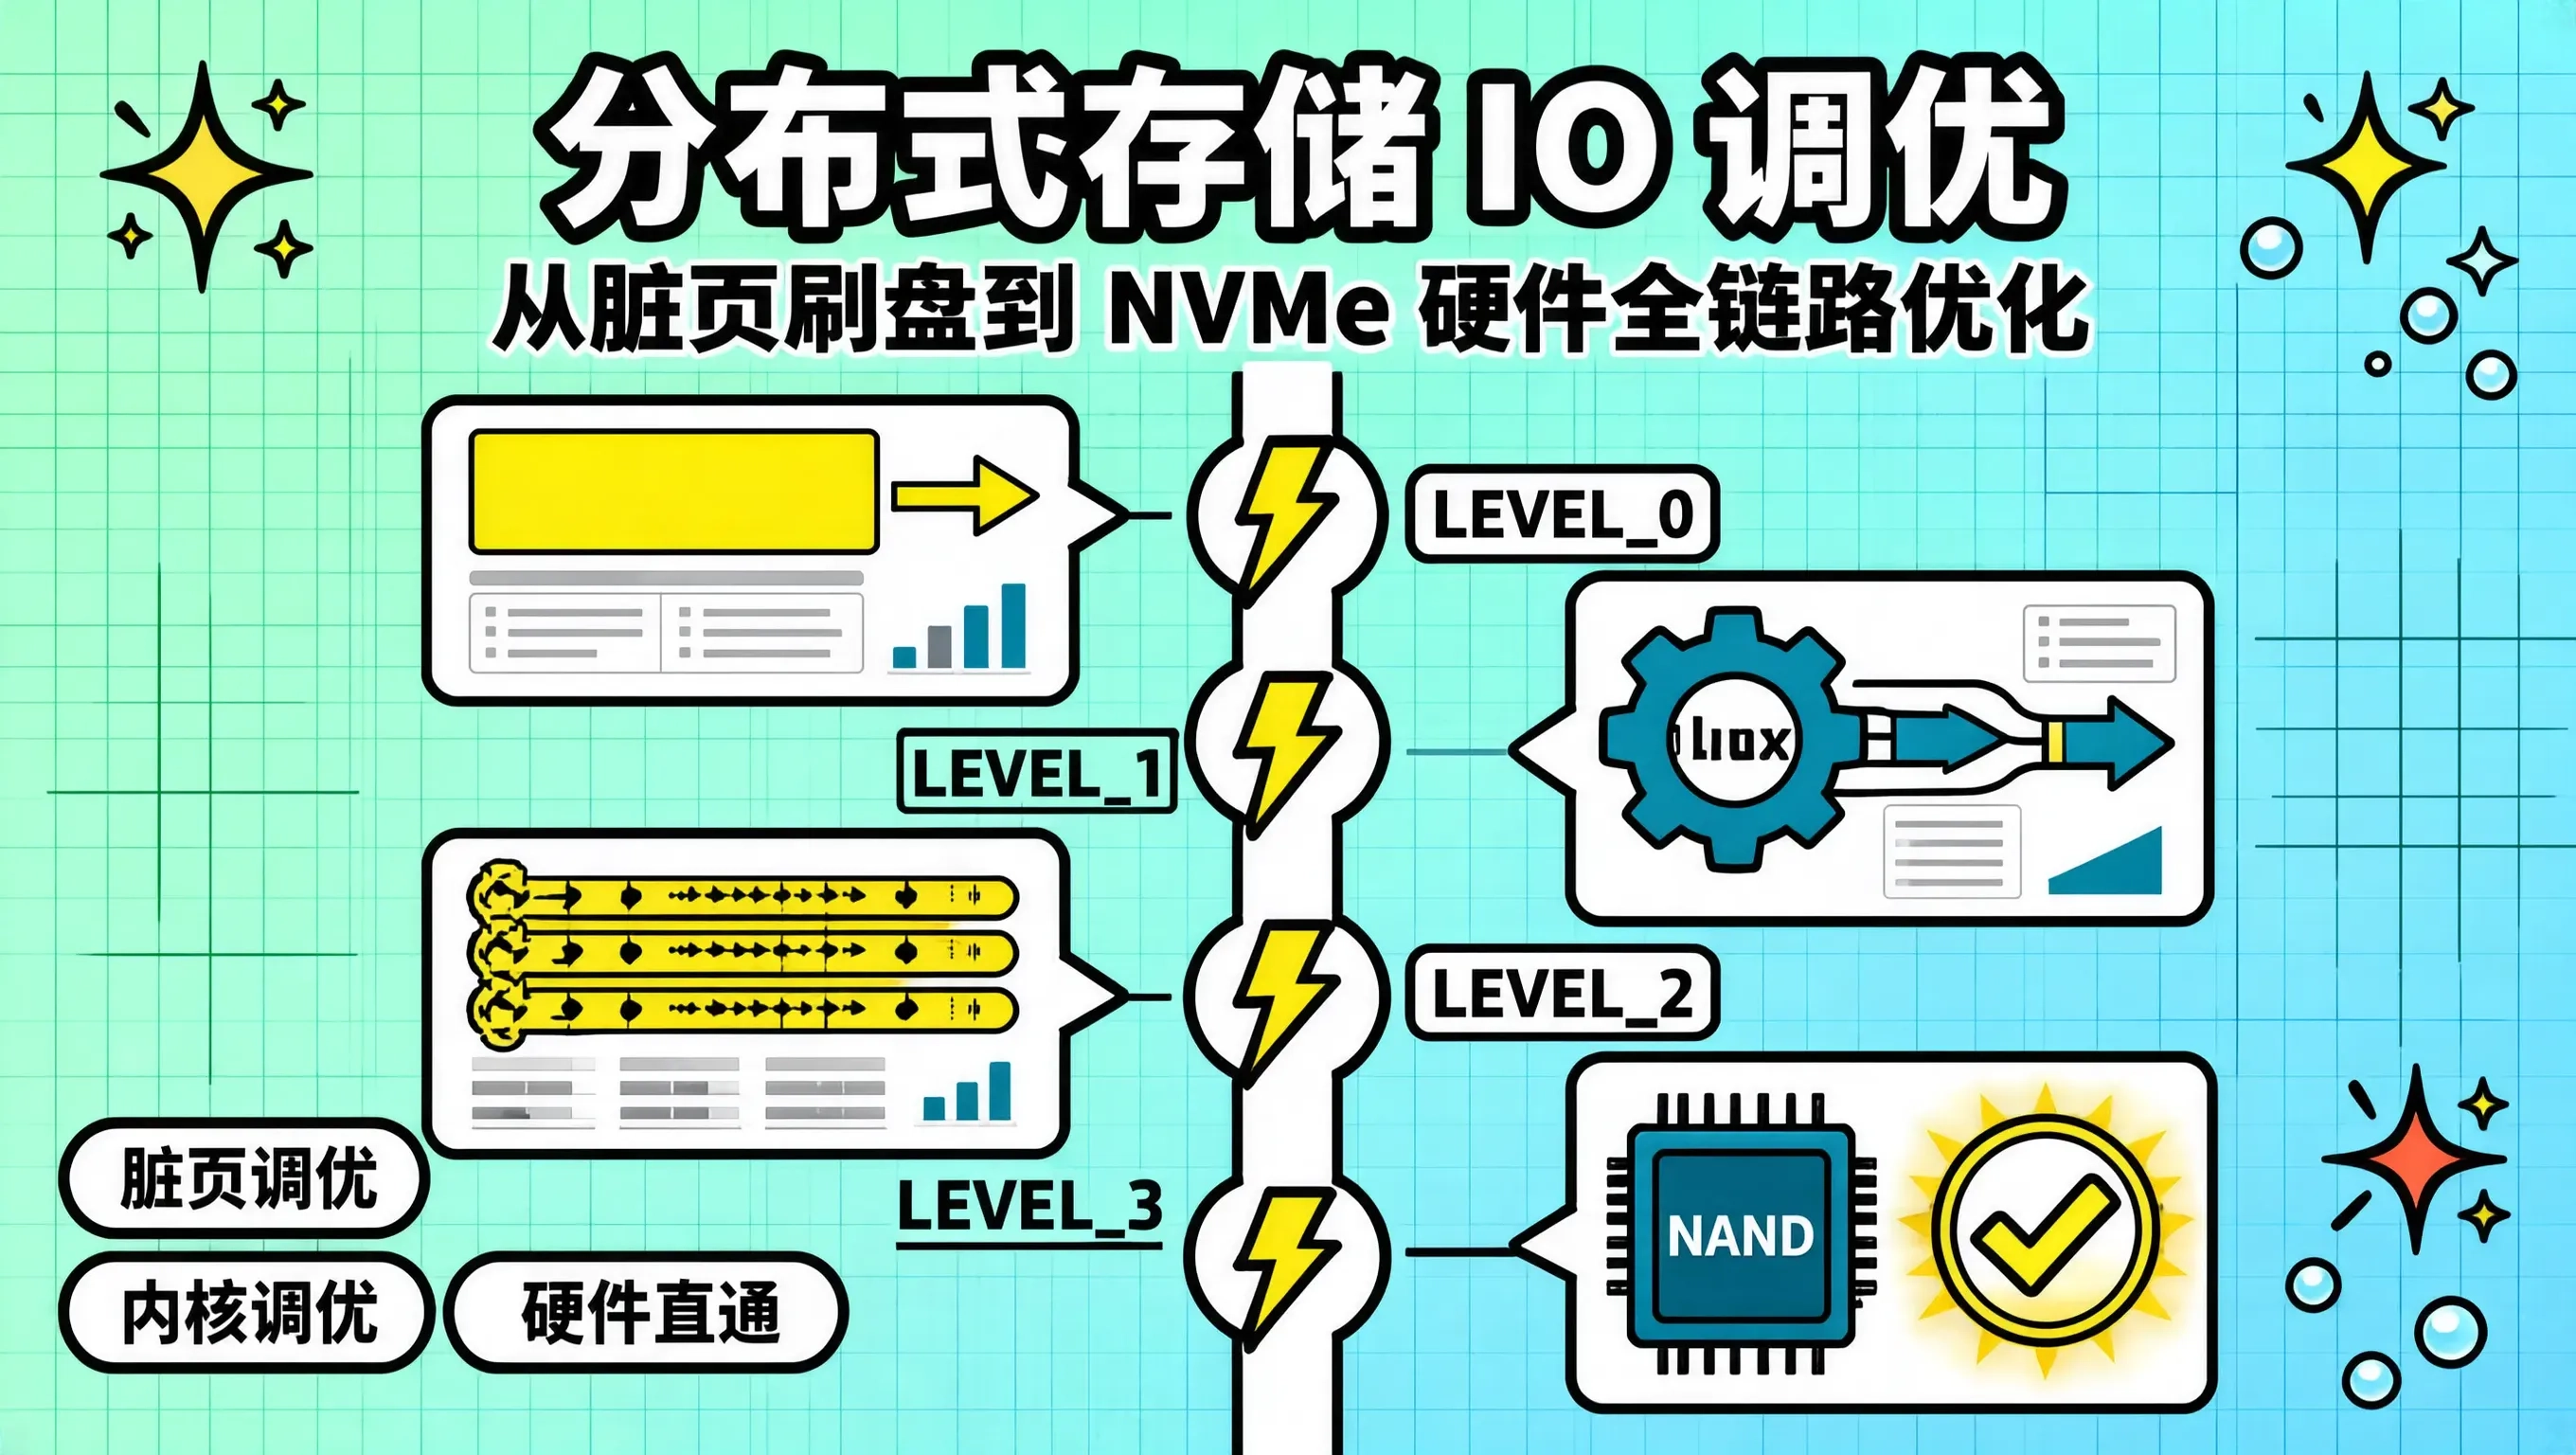
在构建大规模分布式共享存储(如 Ceph、JuiceFS、GlusterFS)以及本地高性能数据库持久卷时,很多工程师常常困惑:“为什么明明采购了读写速度高达 7000MB/s 的企业级 NVMe 固态硬盘,底层存储的写入吞吐却只能跑到几百兆,且 P99 写入延迟频繁出现 100ms 以上的剧烈毛刺?”
问题通常不在硬件本身,而在于 Linux 操作系统的内核页缓存(Page Cache)机制、脏页刷盘策略(Dirty Flush)与存储队列深度未进行深度调优。
本文将从操作系统内核与硬件驱动底层出发,系统性拆解如何打通从应用层 write() 到物理 NVMe 闪存颗粒的高性能 IO 链路。
flowchart TD
AppWrite[应用 write 系统调用] –> PageCache[Linux 内核页缓存 Page Cache]
subgraph KernelFlusher[Linux 内核后台刷盘引擎 (kworker/flush)]
PageCache –>|脏页比例达到 dirty_background_ratio| AsyncFlush[异步平滑刷盘: 吞吐平稳]
PageCache -.->|脏页积压突破 dirty_ratio 80% (硬阈值)| SyncBlock[强制同步刷盘 (触发直接阻塞 Sync Block) -> P99 暴增]
end
AsyncFlush –> NVMeQueue[NVMe 多硬件队列驱动: 深度 1024]
SyncBlock –> NVMeQueue
NVMeQueue –> PhysicalNAND[物理 NVMe NAND 闪存颗粒]
1. 根因剖析:脏页暴增引发的内核同步阻塞(Sync Block)
Linux 内核为了提高写性能,默认会将写入数据暂存在 Page Cache 内存中标记为“脏页(Dirty Page)”,由后台线程异步刷入磁盘:
- vm.dirty_background_ratio(默认通常为 10%):当脏页占内存比例达到此值时,内核在后台启动异步刷盘;
- vm.dirty_ratio(默认通常为 20%~30%):当脏页累积突破这个硬性阈值时,内核会强制挂起所有正在执行写入的应用程序进程,强制其参与同步刷盘!在配备 256GB 内存的服务器上,20% 意味着允许堆积 50GB 的脏页。一旦瞬间涌入大文件写入把脏页堆满,所有后续的写请求都会被无情死锁挂起数十秒,引发业务 P99 延迟严重雪崩。
2. Linux 内核脏页参数生产调优全家桶
在存储物理节点的 /etc/sysctl.conf 中追加调优参数,改用绝对内存字节数控制,推行**“提前刷、平滑刷、小步快跑”**策略:
# 将后台异步刷盘阈值设为绝对值 256MB (尽早开始平滑写入磁盘)
vm.dirty_background_bytes = 268435456
# 将强制阻塞硬阈值设为 1GB (严防大量脏页堆积引发内核级阻塞)
vm.dirty_bytes = 1073741824
# 缩短脏页驻留时间,每隔 5 秒将存在超过 10 秒的脏页刷盘
vm.dirty_writeback_centisecs = 500
vm.dirty_expire_centisecs = 1000
# 降低 Swap 交换分区倾向,保障内存绝对用于 IO 缓冲
vm.swappiness = 1
3. NVMe 硬件与多队列 IO 调度器优化
现代 NVMe 固态硬盘具备多达 64,000 个硬件队列,不需要传统的 Linux 单队列调度器(如 CFQ / Deadline)进行寻道排序:
# 1. 针对 NVMe 设备将 IO 调度器设置为 none (直通零开销)
echo none > /sys/block/nvme0n1/queue/scheduler
# 2. 调大预读扇区大小 (大文件大模型权重加载场景)
echo 4096 > /sys/block/nvme0n1/queue/read_ahead_kb
# 3. 调大请求队列深度
echo 1024 > /sys/block/nvme0n1/queue/nr_requests
4. 优化成效总结
通过优化脏页刷盘参数与 NVMe 队列调度:
- 高并发写入时的 P99 延迟:从先前的 250ms 尖刺大幅平稳收敛至 4.5ms 以内;
- 全集群分布式存储的持续写入吞吐:消除了周期性断崖式震荡,持续稳定在 2.8GB/s 以上。