Strata Linux 部署全流程:setup.sh 自动安装、CUDA 编译与 WSL 限制一次讲清
【免费下载链接】Strata Qwen3.8-Flash-Next (125B MoE) on a 8GB+ NVIDIA GPU: one-click install for Windows / Linux. Strata inference engine, OpenAI/Anthropic API on localhost, optional image input.  项目地址: https://gitcode.com/gh_mirrors/strata11/Strata
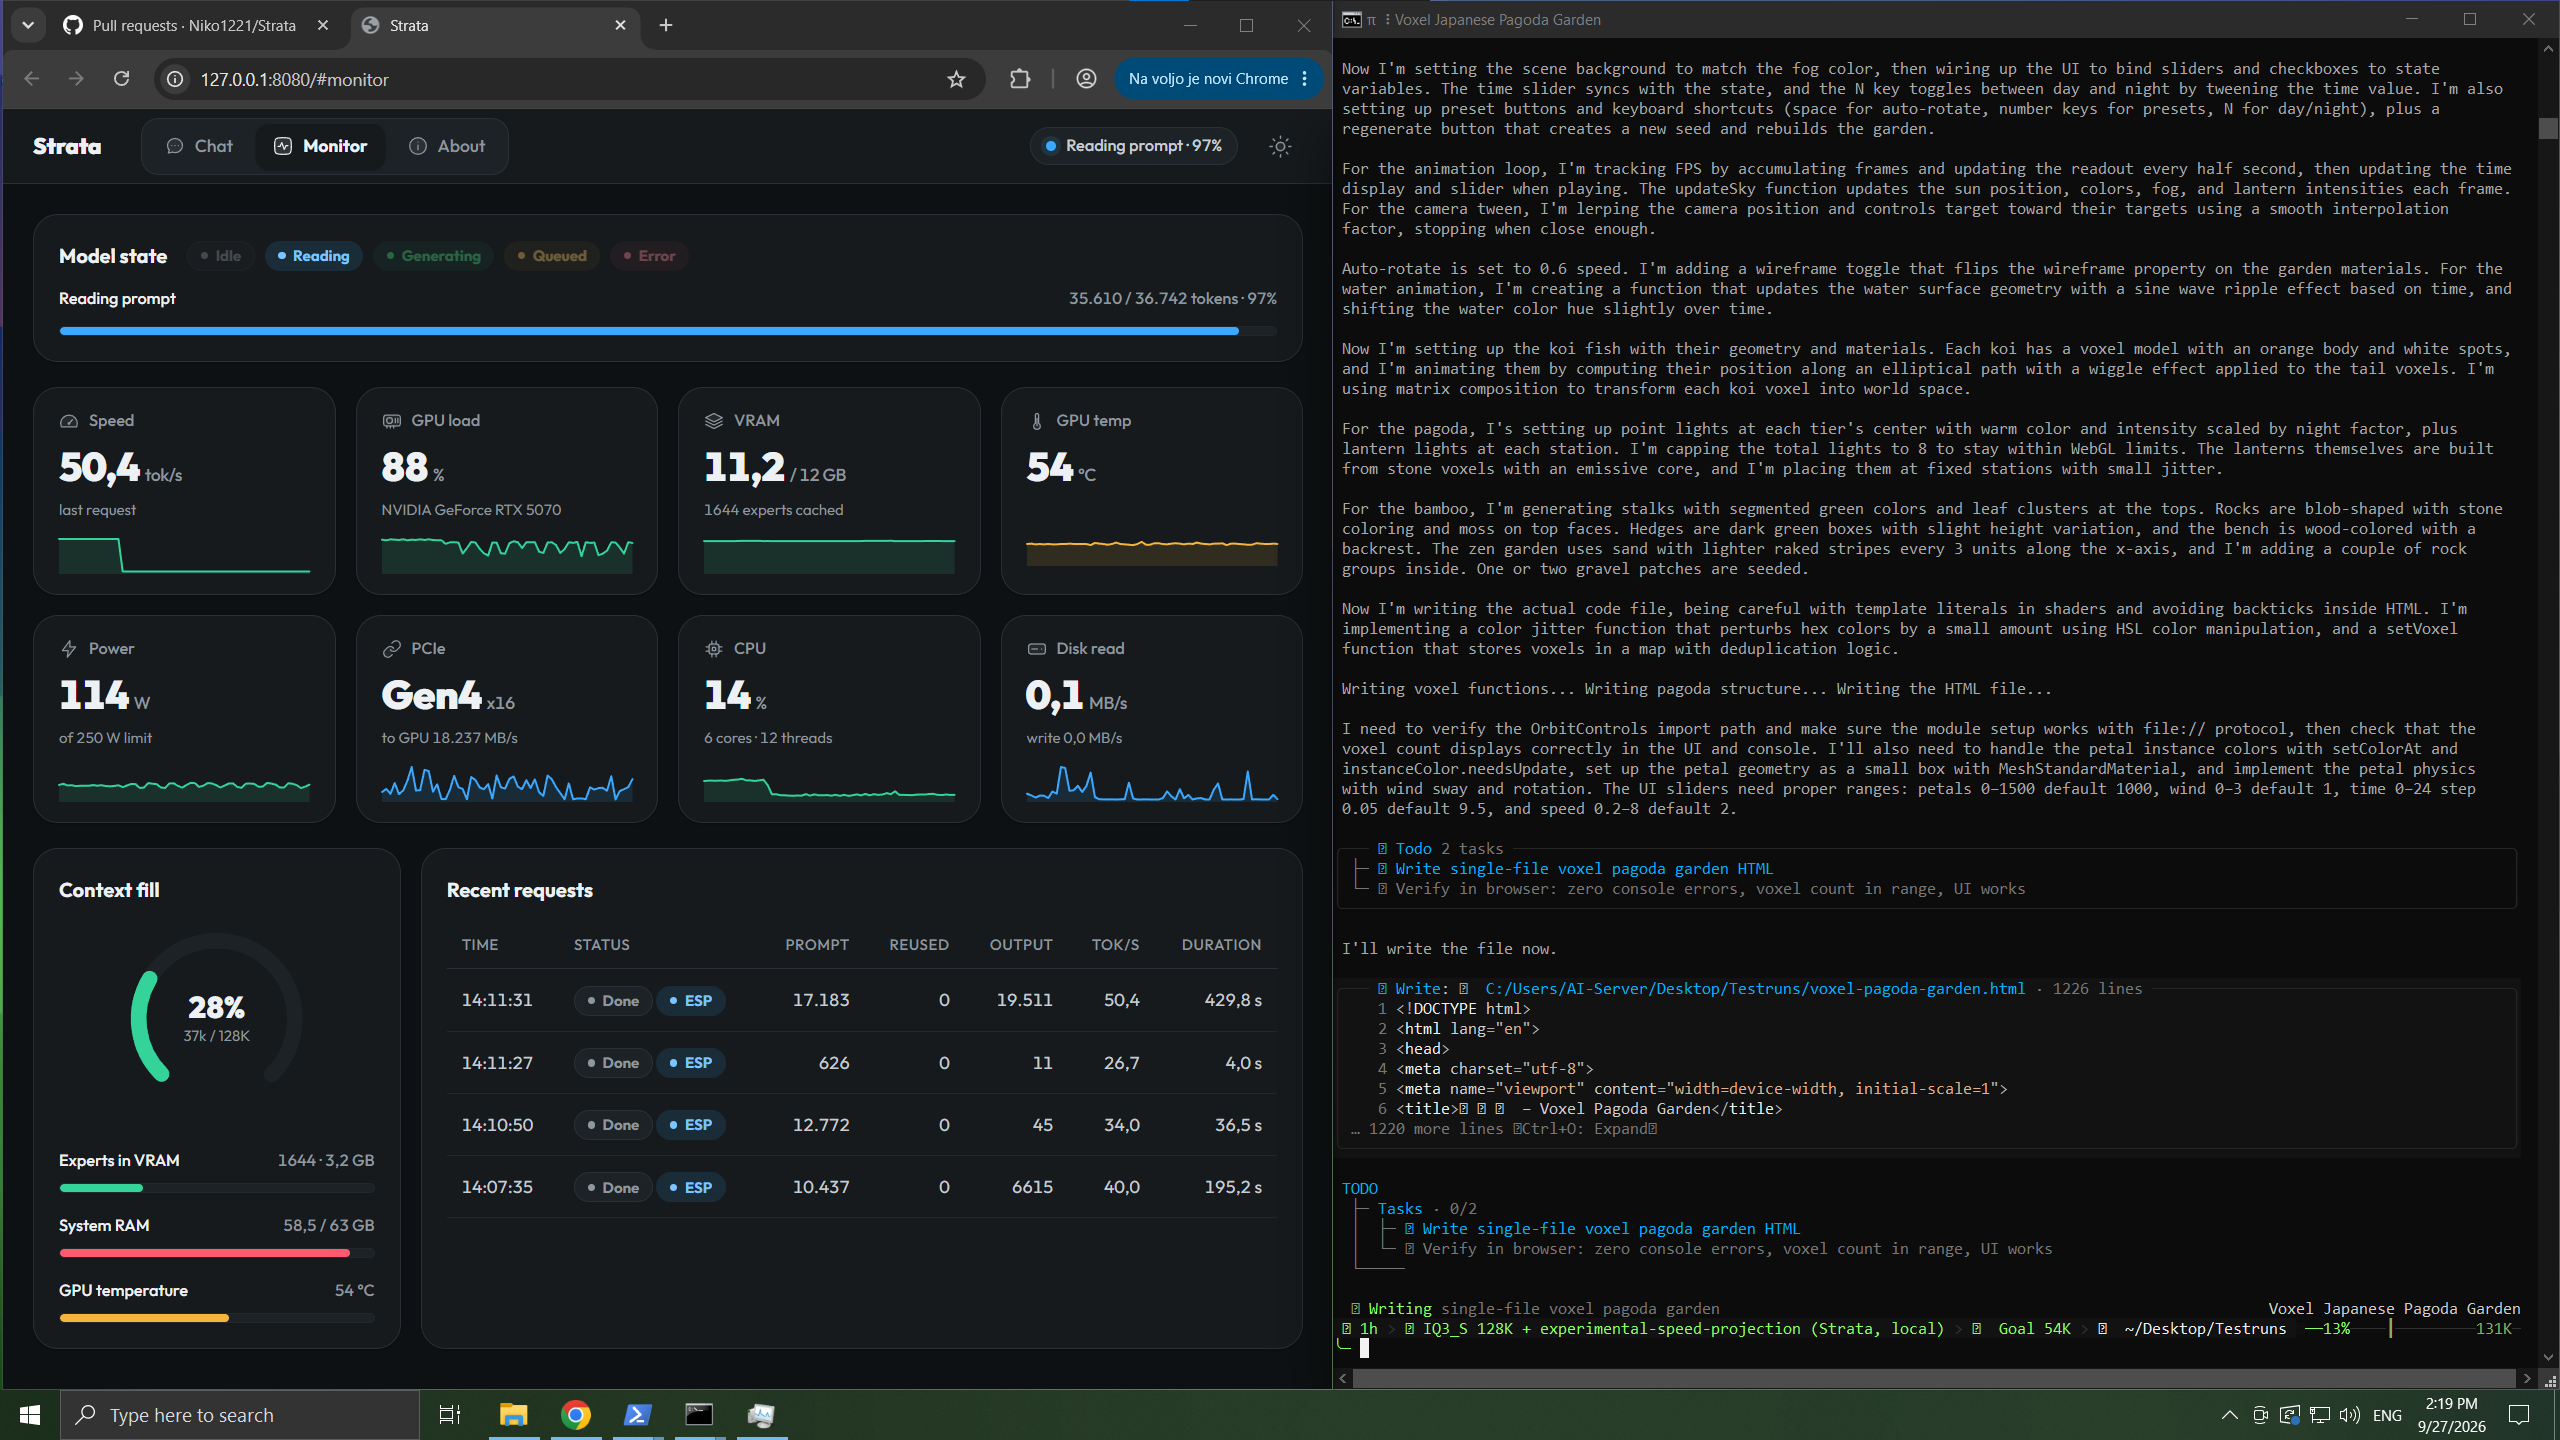
Strata 是一个本地部署的 AI 推理引擎,能把 1250 亿参数的 Qwen3.8-Flash-Next(MoE 大模型)跑在一张 NVIDIA 显卡上,在 Linux 上只需运行 ./setup.sh 一条命令即可完成安装与启动,并在本机 http://127.0.0.1:8080 提供 OpenAI/Anthropic 兼容 API。本文将从硬件清单、setup.sh 自动安装机制、CUDA 编译原理到 WSL 的使用限制,把 Linux 部署的每一步一次讲清楚 🧭
部署前先看:Strata Linux 部署的硬件需求清单
安装之前,确认你的机器满足以下条件(详见 docs/DETAILS.md 的 "Before you start" 一节):
| 显卡 | NVIDIA RTX 30/40/50 系列,12 GB 显存起步(8 GB 可运行但较慢) |
| 驱动 | NVIDIA 驱动 580 或更新(唯一需要你手动装的东西) |
| 内存 | 推荐 64 GB(模型主体驻留内存) |
| CPU | 近 8 年内的 x86-64 桌面 CPU(带 AVX2) |
| 磁盘 | 约 70–80 GB 空闲(模型 + MTP 草稿层),强烈建议 NVMe SSD |
| 系统 | Ubuntu 22.04/24.04 可全自动;Arch、Fedora 等发行版需先手动装编译器 |
setup.sh 一键安装:到底替你做了哪些事
在 Linux 上,入口就是项目根目录的 setup.sh:
./setup.sh
这个脚本本身很短,职责是"准备好 Python 环境后交给主安装器":
首跑向导:4 个问题,其余全自动
setup.py 的首次运行会依次执行(每一步都有断点标记,中断后重跑会跳过已完成的部分):
- 模型家族:原版 Qwen3.8-Flash-Next 还是 Swift 1.5 微调版;
- 量化尺寸:Q2_0 / IQ2_XS(推荐)/ IQ3_XXS / IQ3_S;
- 上下文长度:8K–262K(按你的显存给推荐值);
- 是否支持读图(视觉编码器)。
⚠️ 首次启动时电脑可能"假死" 1–3 分钟:引擎要把 35–55 GB 载入内存并锁定一部分给显卡,属正常现象,等待即可,别关窗口。
所有模型文件(models/、packs/、mtp/)保存在项目目录旁边的 Strata-data 文件夹,位置记录在 ~/.config/strata/settings.json。这意味着以后解压新版本更新 Strata 时,不用重新下载几十 GB 的模型。
CUDA 编译:什么时候要编译、什么时候不用
这是 Linux 部署中最容易困惑的一步,其实分两种情况:
多数情况:预编译引擎,零编译
RTX 30/40/50 用户会直接下载官方预编译引擎(engine/ 目录,内含 strata 可执行文件和 BUILD.json 版本清单),完全不需要编译器。setup 会比对 BUILD.json 里的 GPU 架构列表和你显卡的 compute capability,匹配即装。
兜底情况:本地编译 Strata 引擎
只有当预编译包不存在或不含你的 GPU 架构时,setup 才会在征求你同意后安装构建工具并编译(首次约 20–40 分钟):
- Ubuntu 22.04 / 24.04:全自动——sudo apt-get install build-essential + 从 NVIDIA 官方源装 CUDA Toolkit 13.0(cuda-toolkit-13-0);
- 其他发行版(Arch、Fedora 等):需先手动装好 C++ 编译器和 CUDA 13,例如 Arch 执行 sudo pacman -S base-devel cuda。setup 的 find_nvcc() 会按顺序在 PATH、/usr/local/cuda*、/opt/cuda* 里自动查找 nvcc,找到后其余步骤继续自动完成。
编译产物同样落到 engine/,并记录源码指纹:以后 git pull 改动了 src/、include/、CMakeLists.txt 等源文件,下次启动时只会增量重编变更部分(一两分钟);若重编失败,setup 会保留并启动旧引擎,不会让你断网。
WSL 限制:能跑,但要知道这 1 个坑
在 Windows 上用 WSL 跑 Strata 是官方支持的(Ubuntu 24.04 已验证),setup.py 的 is_wsl() 会检测内核字符串里的 "microsoft" 标志并自动调整配置。唯一的实质限制是:
- KV streaming 自动关闭:–kv-resident 需要把内存中 KV 缓存副本"钉住"(pin),而 WSL 下 NVIDIA 驱动总共只能 pin 约 1 GB 内存,远不够长上下文使用。因此 setup 会在 WSL 里自动移除该参数,KV 缓存全部留在显存中(引擎侧说明见 src/core/layer.cpp)。
- 长 prompt 略慢:专家权重从未 pin 的内存拷贝到 GPU,读取长文档的速度低于原生 Linux。
结论:WSL 日常聊天、接 API 完全够用;如果你对超长上下文吞吐敏感,建议直接在原生 Linux 上部署。
日常使用与更新:Strata Linux 的常用命令
| 再次启动(不重复下载) | ./setup.sh 或 ./run-<model>.sh |
| 加装模型 / 改上下文或图像设置 | ./setup.sh –setup |
| 无交互安装(全用推荐值) | ./setup.sh –model IQ2_XS –yes |
| 指定已有 GGUF 文件 | ./setup.sh –gguf-dir /data/IQ2_XS |
| 换端口 | ./setup.sh –port 8081 |
| 终端聊天 | .venv/bin/python chat.py |
| 更新 Strata | git pull && ./setup.sh |
启动后,你的应用和编程代理可以把 http://127.0.0.1:8080/v1 当作 OpenAI 兼容端点接入(任意 API key 和模型名),Anthropic 格式则用 /v1/messages。
常见问题速查
- 下载/安装中断了? 直接重跑 ./setup.sh,会从断点继续;
- 提示驱动太旧? 升级 NVIDIA 驱动(≥580)后重启再跑;
- 提示 8080 端口被占用? 说明 Strata 已在运行,找到它的窗口即可;
- 首次启动卡住? 等一等;超过 10 分钟再重启系统、关掉占内存的程序或选更小的 Q2_0 尺寸。
更完整的排错表和各项性能数据,见 docs/DETAILS.md 的故障排查章节。
写在最后
Strata 的 Linux 部署设计哲学就是"一条命令走天下":./setup.sh 自动补齐 Python 环境,预编译引擎让 99% 的 RTX 30/40/50 用户跳过 CUDA 编译,断点续传和 Strata-data 分离让更新不折腾,WSL 用户也能开箱即用——只要知道 KV streaming 这一项在 WSL 下会缺席即可。装完打开 http://127.0.0.1:8080,一个每秒 50–90 token 的本地 125B 大模型就在你的机器上了 🚀
【免费下载链接】Strata Qwen3.8-Flash-Next (125B MoE) on a 8GB+ NVIDIA GPU: one-click install for Windows / Linux. Strata inference engine, OpenAI/Anthropic API on localhost, optional image input. 项目地址: https://gitcode.com/gh_mirrors/strata11/Strata
创作声明:本文部分内容由AI辅助生成(AIGC),仅供参考