第 32 章 每班只能一个人
这一章要解决什么
上一章的门岗排班允许"某个时段两个人同时在岗",只要人够、钱够,多一个人不算错。现实里更常见的是另一种规矩:一个岗位,一个时段,只能有一个人。多一个人不只是多花钱,而是违规——值班表上同一格写了两个名字,交班时就说不清谁负责。
这条规矩把"至少一人"改成了"恰好一人"。符号上只是把 ≥\\ge≥ 换成 ===,可行域却整个变了形状:原来能用的方案,现在可能一个都不剩。
读完这一章,你会知道三件事:为什么这个"="比"≥"严格得多;怎样用一张 0-1 矩阵把"谁管哪几段"写清楚;以及当"恰好一人"根本排不出来时,该怎么判断是缺人、缺班型,还是需求本身矛盾。
32.1 门岗的一天
城南的机械厂有个正门岗亭,进出厂的货车、班车、访客都要在这里登记。厂里定了死规矩:岗亭 24 小时不能空,一空就是安全责任事故。
门岗由后勤班组负责,一共六个人:周德海、吴敏、郑小满、刘长顺、季红、赵大年。班组长郑小满每个月排一次班,排班表是一张 24 行的格子纸,每格两小时。
厂里认可的班型只有五种,都是跟工会谈定的:
- 早短班 08:00 到 12:00,四小时,管上午的进厂高峰;
- 午短班 12:00 到 16:00,四小时;
- 晚短班 16:00 到 20:00,四小时,管下班高峰,跨晚饭点,多给十块钱夜餐津贴;
- 长白班 08:00 到 18:00,十小时;
- 长夜班 20:00 到次日 08:00,十二小时。
每种班型的钱不一样。厂里的算法是三块相加:每人每班 200 元到场固定成本(班车、工装、交接、餐补,人来了就得花),加上 30 元一小时的工时费,再加上班型自带的津贴。四小时的短班 200+120=320 元,十小时的长白班 200+300=500 元,十二小时的长夜班 200+360=560 元。
郑小满手里有两个硬条件。一个是厂规:一个人一天只能上一个班,不能上午站完下午再来。另一个是这次要改的规矩:每个两小时时段,恰好一个人,不多不少。
他排过一版"至少一人"的表,那个好排,随便多塞个人就补上了。这次不行。上个月安全科来检查,指着 16:00 到 18:00 那格说:这里写了两个人,签字栏却只有一个名字,出了事谁负责?
于是他把格子纸推到一边,打开了电脑。
32.2 先把问题说清楚
表 32-1 三个问题与答案
| 他能决定什么? | 六个人里,谁上哪一种班型;一人最多一班 |
| 他受什么限制? | 每个两小时时段恰好一个人;一天 24 小时不能有空档 |
| 他想达到什么? | 全场总成本最低 |
矛盾的形状很清楚:想省钱就得让长班多顶几段,可长班一顶就跨过别人管的时段,两段就撞在一起;要保证每格恰好一人,班的边界必须一格不差地接上。
这里有个说法要先立住。让每个时段"至少一人",是集合覆盖;让每个时段"恰好一人",是集合划分,也叫恰好覆盖。两个名字只差一个字,含义差一层:覆盖允许同一格被数到两次,划分不允许。
为什么这一字之差要紧?把两种写法的可行解摆在一起看:任何一个划分方案,把"恰好"松成"至少"之后照样成立,所以划分的可行解全都落在覆盖的可行解里面。反过来不成立——那个 16:00 到 18:00 有两个人同时在岗的方案,覆盖认,划分不认。
于是有一句可以直接用的话:划分的可行域是覆盖的真子集,所以划分的最优成本不会低于覆盖;划分还多一种覆盖没有的结局——一个解都排不出来。
32.3 把大白话变成数学
五种班型与十二个时段的关系,如图 32-1 所示。横轴是十二个两小时时段,从早上 8 点排到次日 8 点;纵轴是五种班型;哪一格涂了色,就说明这个班型管这个时段。
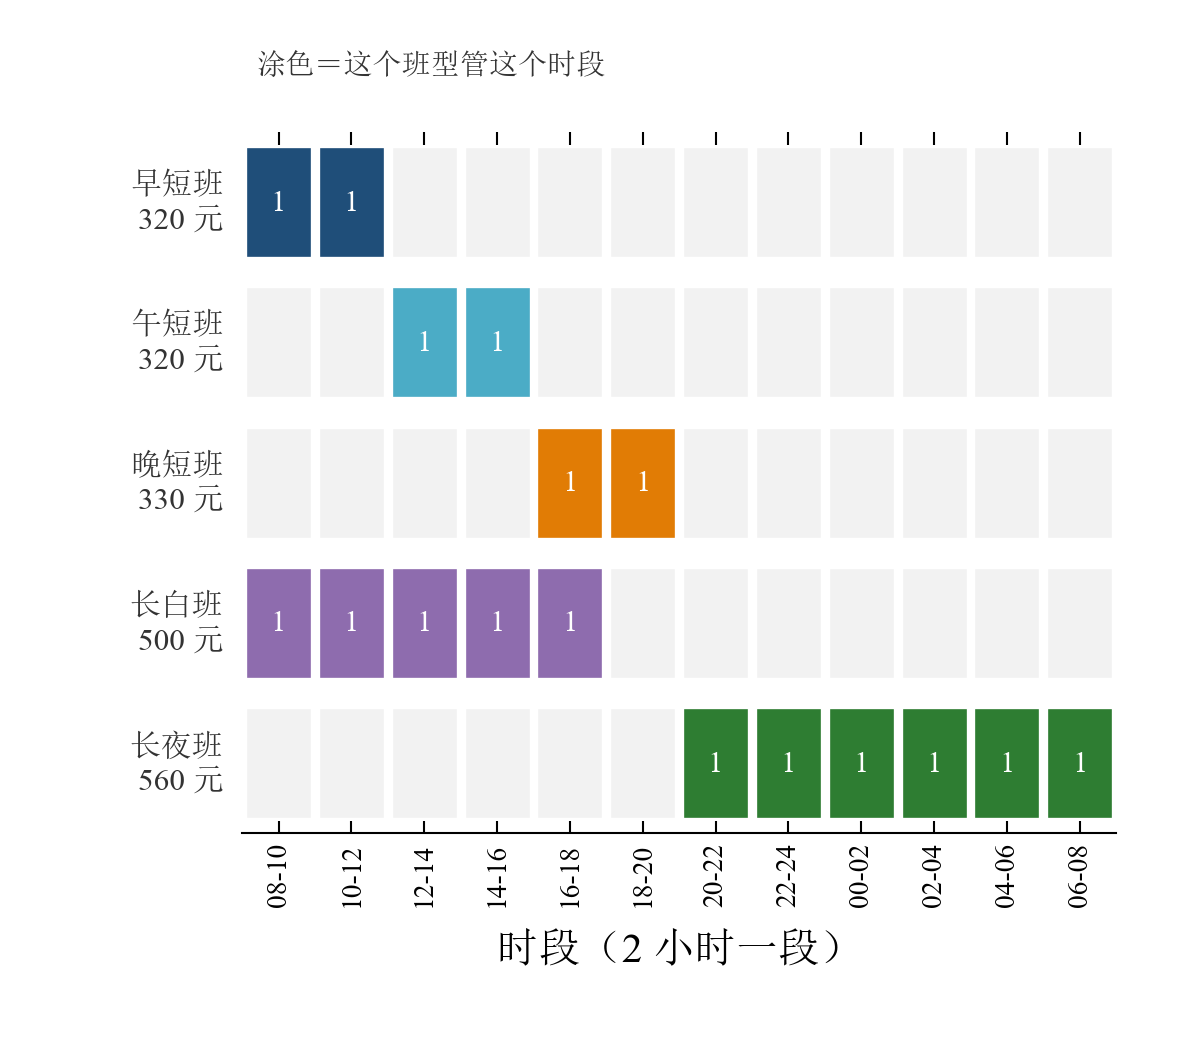
图 32-1 五种班型各管哪几个时段
这张图告诉你什么:先看每一行的涂色长度——早、午、晚三个短班各占两格,长白班占五格,长夜班占六格,加起来是 2+2+2+5+6=17 格,而真正要填的只有 12 格。多出来的 5 格就是重叠的余地。再看纵向:08-10 和 10-12 这两列,早短班和长白班都能管;12-14 和 14-16 这两列,午短班和长白班都能管;16-18 这一列,晚短班和长白班都能管。前五列都有两个选择,是排班的活口;18-20 只有晚短班一个。最要紧的是右边那六列——20-22 到 06-08,只有长夜班一行涂了色。这六格没有第二个选择,谁想排夜班,就只能动用长夜班,这是整道题的死穴,32.8 节会拿它做文章。
第一步:编号。
- 下标 jjj:时段,从 1 到 12,每个两小时;
- 下标 iii:班型,一共 5 种;
- 下标 ppp:值班员,一共 6 个人。
第二步:把"管不管"写成一个 0-1 数。
aija_{ij}aij:班型 iii 管不管时段 jjj,管是 1,不管是 0。它代表现实中的"这一班有没有把这段时间包进去"。比如早短班管前两段,a早短,1=a早短,2=1a_{\\text{早短},1}=a_{\\text{早短},2}=1a早短,1=a早短,2=1,其余全 0;长夜班管后六段,a长夜,7=⋯=a长夜,12=1a_{\\text{长夜},7}=\\dots=a_{\\text{长夜},12}=1a长夜,7=⋯=a长夜,12=1,前六段全 0。图 32-1 那张彩色格子,就是这 60 个 0-1 数画出来的。
第三步:把成本写成一个数。
cic_ici:班型 iii 的成本,单位元。它是三块钱加起来的:200 元到场固定成本、30 元乘小时数、加上班型津贴。五种班型的数见表 32-2。
表 32-2 五种班型的时长、成本与每小时单价
| 早短班 | 08:00-12:00 | 2 | 4 | 320 | 80.0 |
| 午短班 | 12:00-16:00 | 2 | 4 | 320 | 80.0 |
| 晚短班 | 16:00-20:00 | 2 | 4 | 330 | 82.5 |
| 长白班 | 08:00-18:00 | 5 | 10 | 500 | 50.0 |
| 长夜班 | 20:00-08:00 | 6 | 12 | 560 | 46.7 |
表注:每小时单价 = 成本 ÷ 小时数。短班的单价是长班的一点六倍以上,钱全花在"到场"这两个字上。
这张表里有一列数字值得多看两眼:每小时单价那一列。四小时短班每小时 80 元,十小时长白班 50 元,十二小时长夜班 46.7 元。人到场就要花 200 元,站得越久,这 200 元摊得越薄。短班贵,不是贵在工时,是贵在"多叫一个人"。这句话后面会反复出现。
第四步:给"谁上哪一班"设变量。
xpix_{pi}xpi:值班员 ppp 上不上班型 iii,只能取 0 或 1。取 1 表示这一班归他,取 0 表示不归他。
这个变量带两个下标:一个说是谁,一个说是哪一班。六个人乘五种班型,一共 30 个 0-1 变量。它们的取值合起来,就是一张完整的值班表。
第五步:写"恰好一人"。
时段 jjj 上到底有几个人?把所有"管这个时段的班型"和"上这些班型的人"都数一遍:
∑p=16∑i=15aij xpi=1,j=1,…,12\\sum_{p=1}^{6}\\sum_{i=1}^{5} a_{ij}\\,x_{pi}=1,\\qquad j=1,\\dots,12p=1∑6i=1∑5aijxpi=1,j=1,…,12
等号右边是 1,这就是全部的分量。它说的是一件很强的事:时段 jjj 上的人数,既不能是 0,也不能是 2。左边那个求和号里的 aija_{ij}aij 起的是"筛选"作用——班型 iii 不管时段 jjj 时 aij=0a_{ij}=0aij=0,这一项自动消失,不管这个人上不上这个班,都不会被算进这一格。
第六步:写"一人最多一班"。
∑i=15xpi≤1,p=1,…,6\\sum_{i=1}^{5} x_{pi}\\le 1,\\qquad p=1,\\dots,6i=1∑5xpi≤1,p=1,…,6
这条是厂规。取等号时这个人今天有班,取 0 时今天休息。这里用的是 ≤\\le≤ 而不是 ===,因为六个人不必人人有活干。
32.4 完整的数学模型
装起来:
最小化:∑p=16∑i=15ci xpi(今天请人的总花费)满足:∑p=16∑i=15aij xpi=1,j=1,…,12(每个时段恰好一个人)∑i=15xpi≤1,p=1,…,6(一个人一天只上一班)xpi∈{0,1}(派或不派,没有半个人)
\\begin{aligned}
\\text{最小化:}\\quad & \\sum_{p=1}^{6}\\sum_{i=1}^{5} c_i\\,x_{pi} && \\text{(今天请人的总花费)}\\\\[2pt]
\\text{满足:}\\quad
& \\sum_{p=1}^{6}\\sum_{i=1}^{5} a_{ij}\\,x_{pi}=1,\\quad j=1,\\dots,12
&& \\text{(每个时段恰好一个人)} \\\\
& \\sum_{i=1}^{5} x_{pi}\\le 1,\\quad p=1,\\dots,6
&& \\text{(一个人一天只上一班)} \\\\
& x_{pi}\\in\\{0,1\\}
&& \\text{(派或不派,没有半个人)}
\\end{aligned}
最小化:满足:p=1∑6i=1∑5cixpip=1∑6i=1∑5aijxpi=1,j=1,…,12i=1∑5xpi≤1,p=1,…,6xpi∈{0,1}(今天请人的总花费)(每个时段恰好一个人)(一个人一天只上一班)(派或不派,没有半个人)
这个模型的骨架叫集合划分:把"要覆盖的全体时段"切成若干块,每块正好交给一个班型,一块也不重、一块也不漏。它和集合覆盖只差中间那一行,≥\\ge≥ 换成 ===。
把中间那行换成 ∑∑aijxpi≥1\\sum\\sum a_{ij}x_{pi}\\ge 1∑∑aijxpi≥1,模型就退成集合覆盖,也就是上一章的写法;再把它彻底删掉,就只剩"一人一班",那是没有意义的。
矩阵的写法更省事:把 aija_{ij}aij 排成一张 5 行 12 列的表(图 32-1 就是它的彩色版),每一列是一个时段,每一行是一个班型;划分要求"每一列的和恰好是 1"。这个视角在排班、机组配对、课程表里通用,因为它们的共同点是——一件事只能有一个人负责。
32.5 用 Python 写出来
分五段看。
第一段:读数据,把"班型管哪些时段"变成可以查询的表。
import json
from pathlib import Path
DATA = json.loads((HERE / "数据.json").read_text(encoding="utf-8"))
SLOTS = [s["key"] for s in DATA["slots"]] # 12 个时段
SHIFTS = [s["key"] for s in DATA["shifts"]] # 5 种班型
COST = {s["key"]: s["cost"] for s in DATA["shifts"]} # 每班成本
COVER = {s["key"]: set(s["slots"]) for s in DATA["shifts"]} # 这个班型管哪几段
STAFF = [p["key"] for p in DATA["staff"]] # 6 个值班员
COVER 就是 aija_{ij}aij 的另一种存法:用集合代替 12 个 0/1,判断"这家班型管不管这一段"时写成 t in COVER[s] 就行,不必翻矩阵。
第二段:建变量与"一人最多一班"。
m = gp.Model("duty")
x = m.addVars(STAFF, alive, vtype=GRB.BINARY, name="x") # 30 个 0-1 变量
for p in STAFF: # 厂规:一人一天一班
m.addConstr(gp.quicksum(x[p, s] for s in alive) <= 1, name=f"one_{p}")
变量名长成 x[p3,B] 这样,前半是"谁",后半是"哪一班"。加上 vtype=GRB.BINARY,取值就被限制在 0 和 1。
第三段:核心那十二行——每段恰好一人。
for t in SLOTS:
# 只有管这个时段的班型才进求和号,a_ij 由 "t in COVER[s]" 承担
expr = gp.quicksum(x[p, s] for p in STAFF for s in alive if t in COVER[s])
m.addConstr(expr == 1, name=f"slot_{t}") # 恰好一人:等号
这十二行是整章的骨头。把 == 1 改成 >= 1,同一个模型立刻变成上一章的覆盖模型,成本会从 1530 掉到 1390 元——这个对照马上会跑。
第四段:设目标并求解。
m.setObjective(gp.quicksum(COST[s] * x[p, s] for p in STAFF for s in alive),
GRB.MINIMIZE)
res = solve_both(m, name="032_每班只能一个人")
solve_both 把这份模型交给 Gurobi 和 COPT 各解一遍,两边的状态、目标值、解向量都写进 结果.json。
第五段:做三组对照。
m2, x2, _ = build("cover") # 对照一:把 == 换成 >=
cov = solve_quiet(m2) # 1390 元,3 个人
m3, _, _ = build("partition", drop="E") # 对照二:长夜班停用
bad = solve_quiet(m3) # INFEASIBLE
scan = scan_standing() # 对照三:到场成本从 100 调到 400
三组对照回答三个问题:放松一个字省多少钱、少一个班型还剩不剩解、到场成本涨价时两种写法的差距怎么变。
32.6 跑起来,先看输出
在案例目录下执行 python 建模.py:
================================================================
求解状态: OPTIMAL
最低总成本:1530.00 元,动用 4 个人
—————————————————————-
时段 班型 值班员 时数 成本
08:00-12:00早短班 吴敏 4 320
12:00-16:00午短班 郑小满 4 320
16:00-20:00晚短班 刘长顺 4 330
20:00-08:00长夜班 赵大年 12 560
—————————————————————-
每个时段的人数: 1 1 1 1 1 1 1 1 1 1 1 1
时段标签: 08-10 10-12 12-14 14-16 16-18 18-20 20-22 22-24 00-02 02-04 04-06 06-08
人数恒为 1:是
—————————————————————-
放宽为「至少一人」:1390.00 元,3 个人,重叠时段 ['16-18']
省下 140.00 元,代价是 1 个时段出现两个人同时值守
—————————————————————-
停用长夜班后:INFEASIBLE,无人可上的时段 ['20-22', '22-24', '00-02', '02-04', '04-06', '06-08']
每班每小时单价: 早短班 80.0、午短班 80.0、晚短班 82.5、长白班 50.0、长夜班 46.7
—————————————————————-
到场成本扫描:
到场 100 元 恰好 1130 至少 1090 差 40
到场 150 元 恰好 1330 至少 1240 差 90
到场 200 元 恰好 1530 至少 1390 差 140
到场 250 元 恰好 1730 至少 1540 差 190
到场 300 元 恰好 1930 至少 1690 差 240
到场 400 元 恰好 2330 至少 1990 差 340
双后端核对: Gurobi=OPTIMAL obj=1530.0 t=0.0023s | COPT=OPTIMAL obj=1530.0 t=0.0162s | 偏差=0.00e+00
================================================================
逐段读。
“最低总成本:1530.00 元,动用 4 个人”——排出来的表是:吴敏早短班、郑小满午短班、刘长顺晚短班、赵大年长夜班。三个短班各管两段,正好拼满白天十二小时里的六段;长夜班一肩挑后六段。六加六,十二段不多不少。
“人数恒为 1:是”——这行字是划分模型的验收单。把每个方案的十二个时段数一遍,全是 1,说明既没有空档,也没有重叠。把等号换成大于等于,同一个数就会在重叠的那一段数出 2。
“放宽为「至少一人」:1390.00 元,3 个人,重叠时段 16-18”——只改了一个符号,少了 140 元、少叫一个人。方案变成:周德海长白班 08:00-18:00、吴敏晚短班 16:00-20:00、赵大年长夜班。长白班和晚短班在 16:00-18:00 这一格撞上了,两个人同时在岗。
“停用长夜班后:INFEASIBLE,无人可上的时段 20-22、22-24、00-02、02-04、04-06、06-08”——六个时段一起变空。求解器说的 INFEASIBLE 是"无解",不是"没算完";这六个时段的候选班型数是 0,任何整数解都填不满,所以整张表根本排不出来。
“每班每小时单价”——80.0、80.0、82.5、50.0、46.7。这五个数解释了后面所有取舍:短班贵在到场,长班省在摊薄。
“到场成本扫描:差 40 → 340”——到场成本越贵,覆盖比划分省得越多。原因下面拆开讲。
32.7 图上看答案
排出来的值班表,如图 32-2 所示。
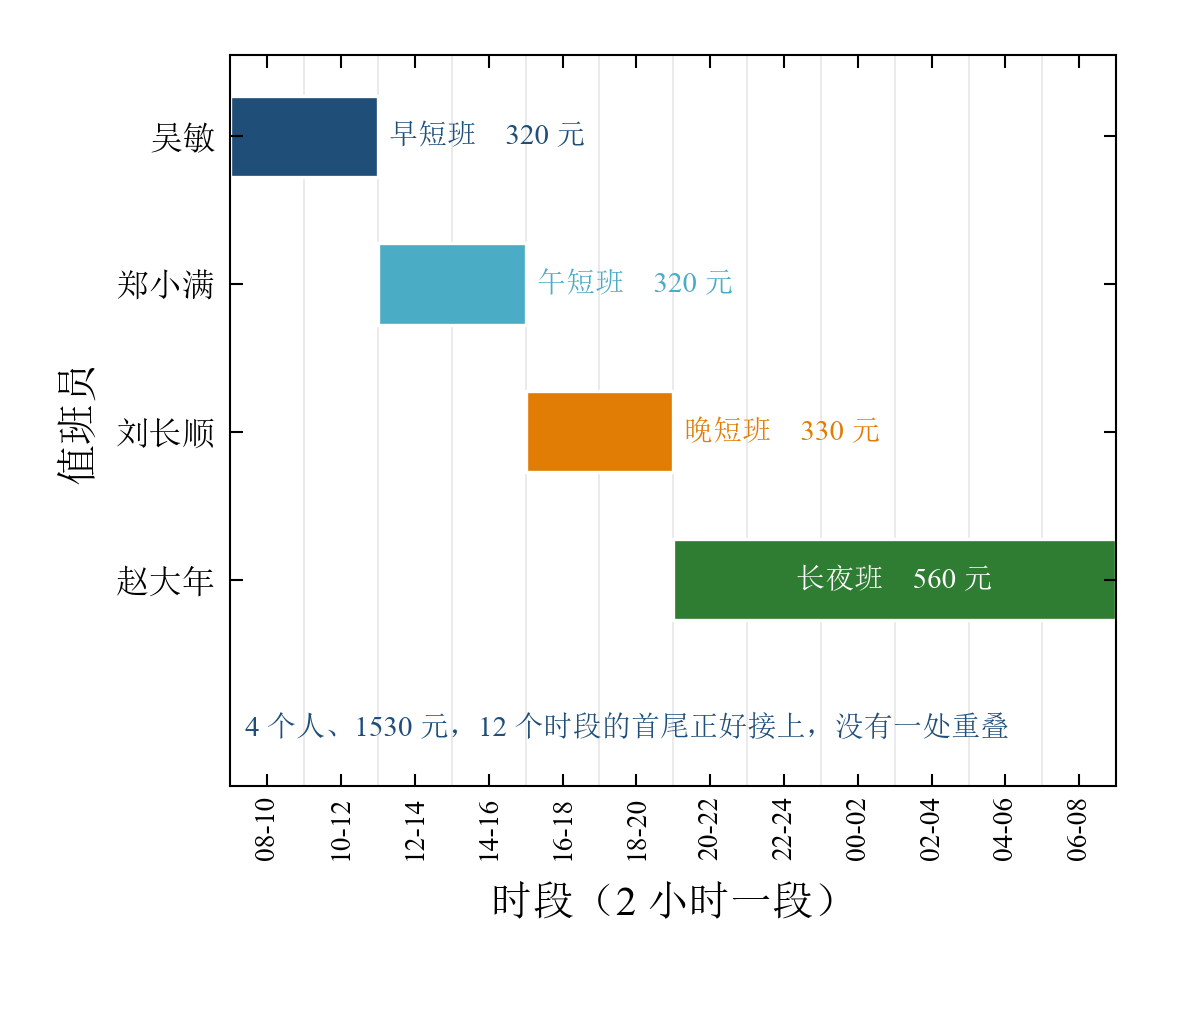
图 32-2 恰好一人时排出来的值班表
这张图告诉你什么:横轴是十二个时段,纵轴是四个值班员,每个色块是一个班。先看色块的接缝——早短班到 12 点收,午短班正好 12 点起;午短班到 16 点收,晚短班正好 16 点起;晚短班到 20 点收,长夜班正好 20 点起。三处接缝一条不差,二十四小时严丝合缝,没有一处重叠,也没有一处空档。再看长度:前三块各两格,末尾那块六格。这就是"恰好"逼出来的形状:因为不允许重叠,每个班的终点必须正好是下一个班的起点,班与班只能首尾相接,不能搭肩。
首尾相接这件事,是划分模型最本质的特征。覆盖模型可以让班与班"搭肩",多出来的那截就算重叠;划分模型把搭肩也禁掉了,于是每个时段由谁负责,被一条条边界钉死。
把十二个时段的人数一根一根数过去,如图 32-3 所示。
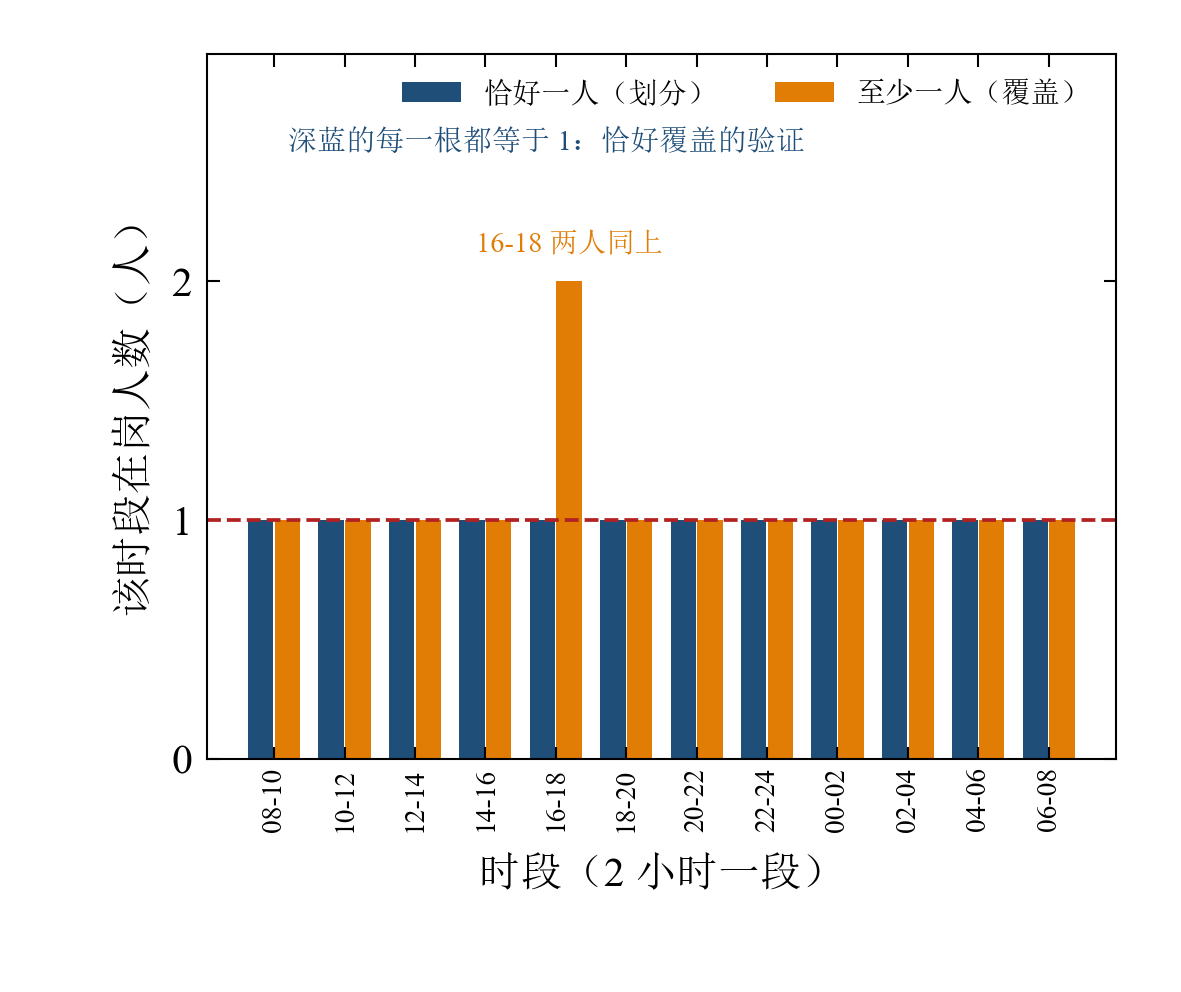
图 32-3 十二个时段的在岗人数
这张图告诉你什么:深蓝的十二根柱子全都顶在同一条红线上——那是"1"。这是划分方案的体检报告:每个时段一个人,不多不少。橙色那组是覆盖方案,十一根柱子和深蓝一样高,只有 16-18 那一根窜到 2。两根都看得见的地方,就是两种写法的唯一差别:橙色多站了一个人,换来 140 元的节省。这张图也顺便说明为什么不能只看"有没有人"——覆盖方案真的没漏人,它漏的是"每格只能一个"这条规矩。
每班成本的构成,如图 32-4 所示。
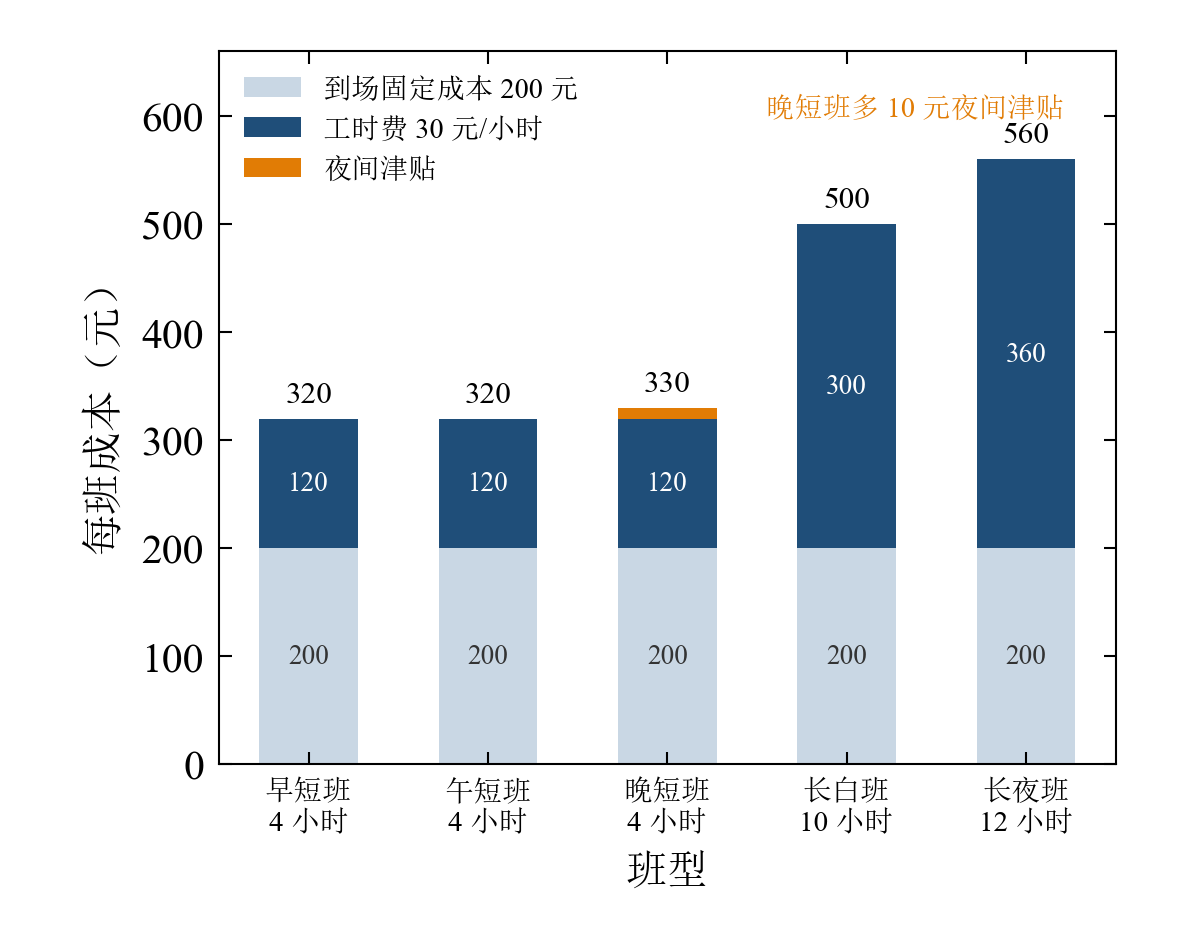
图 32-4 每班成本的构成
这张图告诉你什么:每根柱子都是三段叠起来的:最下面浅灰的 200 元到场固定成本,中间深蓝的工时费,最上面一点点橙色的夜间津贴。先横着比:五个班型的浅灰段一样高,都是 200 元——这部分与站多久无关。再竖着比:四小时短班的深蓝段只有 120 元,整根柱子却已经到 320 元;十二小时长夜班的深蓝段是 360 元,柱子 560 元。也就是说,长夜班多站了八小时,多花的钱(240 元)比短班整根柱子还少。这张图解释了为什么"少叫一个人"这么值钱:省下来的不是工时,是那 200 元的到场成本。
把三张图连起来看,这道题的账就清楚了:划分方案用四个人,付了四份到场成本;覆盖方案用三个人,只付三份。多出来的那份到场成本 200 元,减掉重叠时段多付的两小时工时 60 元,净差 140 元。这 140 元不是算出来的巧合,是"到场成本抵掉重叠浪费"的必然结果。
32.8 换个条件,答案会怎样
条件一:把"=“换成"≥”
同一批班型、同一条需求,只改中间那一行。
表 32-3 恰好一人与至少一人的账
| 总成本(元) | 1530 | 1390 |
| 动用人数(人) | 4 | 3 |
| 启用的班型 | 早短、午短、晚短、长夜 | 长白、晚短、长夜 |
| 重叠时段 | 无 | 16-18(两人同上) |
| 空档时段 | 无 | 无 |
表注:两种写法的差异只在中间一行约束的符号,其余数据、变量、目标完全相同。
两种写法的成本并排放在一起,如图 32-5 所示。
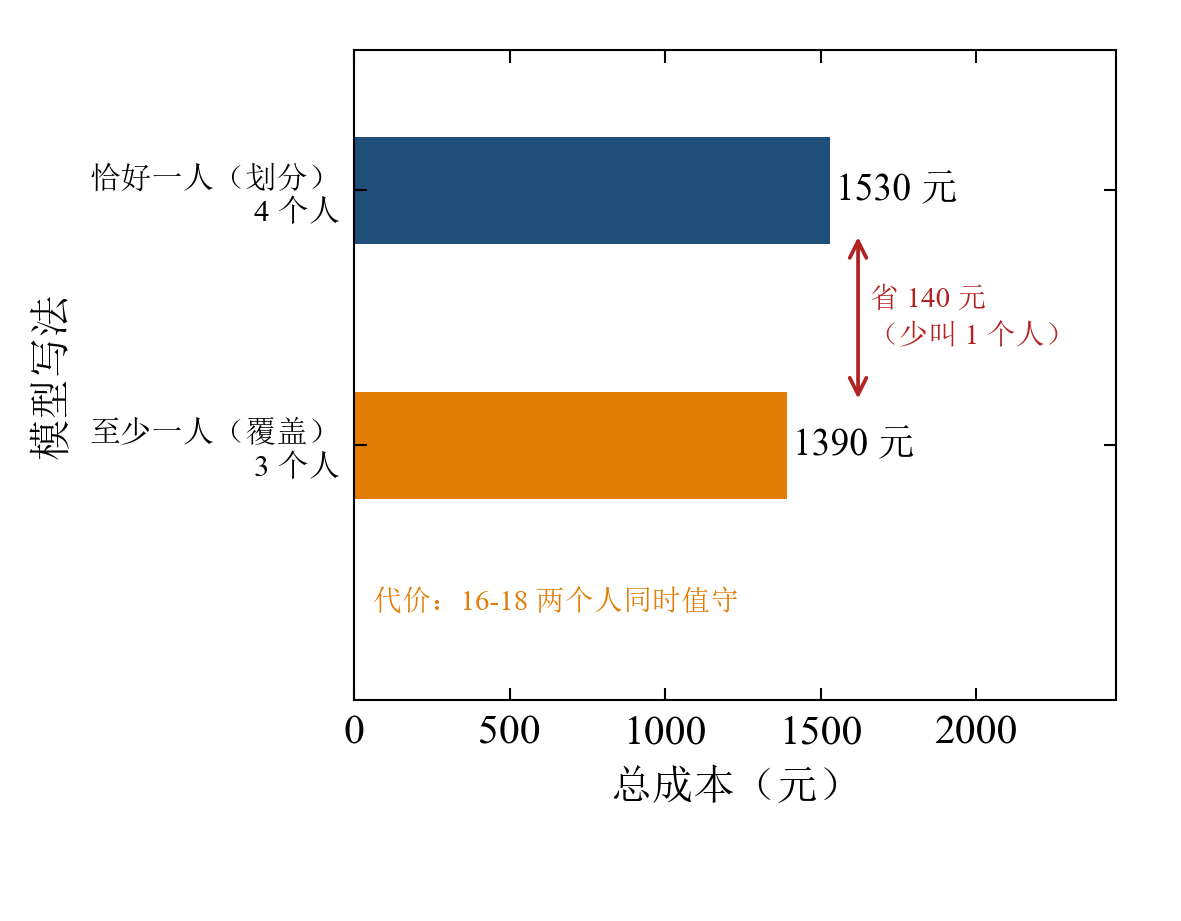
图 32-5 把"="放宽成"≥"之后的成本
这张图告诉你什么:上面那根深蓝柱子 1530 元,四个人;下面那根橙色柱子 1390 元,三个人。中间那对红色箭头标着 140 元,是这次放宽省下的钱。看箭头的位置:它不是省在"少干了一点活",而是省在"少叫了一个人"——活儿一点没少,十二个时段照样有人。真正的代价写在图的左下角:16-18 这个时段从此两个人同时值守,签字栏要写两个名字,这正是安全科上次挑出来的毛病。
这张图值得反过来读一遍:如果厂里能接受 16:00-18:00 两个人同时在岗,那就该用覆盖模型,一年省下的钱不是小数;如果那条规矩是安全红线,覆盖模型再便宜也不能用,必须回到划分。模型的选择取决于"多一个人算不算错",这是一个管理判断,不是数学判断。
条件二:到场成本涨到多少,"至少"才显得划算
短班的贵,贵在那 200 元到场成本。如果这 200 元变了,两种写法的差距会怎么变?
表 32-4 到场固定成本变化时两种写法的成本
| 100 | 1130 | 1090 | 40 |
| 150 | 1330 | 1240 | 90 |
| 200 | 1530 | 1390 | 140 |
| 250 | 1730 | 1540 | 190 |
| 300 | 1930 | 1690 | 240 |
| 400 | 2330 | 1990 | 340 |
表注:其余参数不变(工时费 30 元/小时,津贴照旧),只把到场固定成本从 100 元调到 400 元。
六个数字排下来,差额从 40 元一路涨到 340 元,每加 50 元到场成本,差额正好多 50 元。这不是巧合:覆盖方案比划分方案少叫一个人,省下的就是那一份到场成本;其余部分——工时和重叠浪费——两边差不太多。
反过来看 100 元那一行:差额只有 40 元。到场成本便宜的时候,"恰好一人"几乎不花钱,为它多付的代价还不如为它省下的管理麻烦值钱。这条扫描的真正用处,是告诉你哪一头更贵:是重叠浪费贵,还是守规矩贵。
条件三:一个时段无人可上
把长夜班整个停掉(两个人同时请事假,班型取消),再排一次。
表 32-5 十二个时段的候选班型数
| 候选班型数 | 2 | 2 | 2 | 2 | 2 | 1 | 1 | 1 | 1 | 1 | 1 | 1 |
| 停用长夜班后 | 2 | 2 | 2 | 2 | 2 | 1 | 0 | 0 | 0 | 0 | 0 | 0 |
表注:候选班型数指"有几种班型能把这一段包进去"。第二行是五种班型齐备时的候选数,第三行是停用长夜班之后剩下的候选数,0 表示一个都没有。
求解器给出的答案是 INFEASIBLE。这不是求解器偷懒,而是这六列的和无论怎么取都是 0,与等号右边的 1 对不上。
这个例子还说明一件容易被忽略的事:划分模型无解,往往不是"人不够",而是"某一段只剩一条路,而那条路被堵死了"。 20:00 之后只有长夜班一行涂色(图 32-1 右侧那六列),停掉它,等于把六个时段的唯一入口封住。人多没用——六个人全来上班,也上不了那六段。
判断这类无解有个笨办法,比看求解器的报错更快:逐列数候选。哪一列数到 0,那里就是病灶;哪一列只有 1,那里就是死穴(32.3 节说的死穴,就是指 20-22 这六列在覆盖方案里的地位)。表 32-5 第三行数出来的空档,与终端打印的"无人可上的时段"完全一致。
两个后端的逐项对比,如图 32-6 所示。
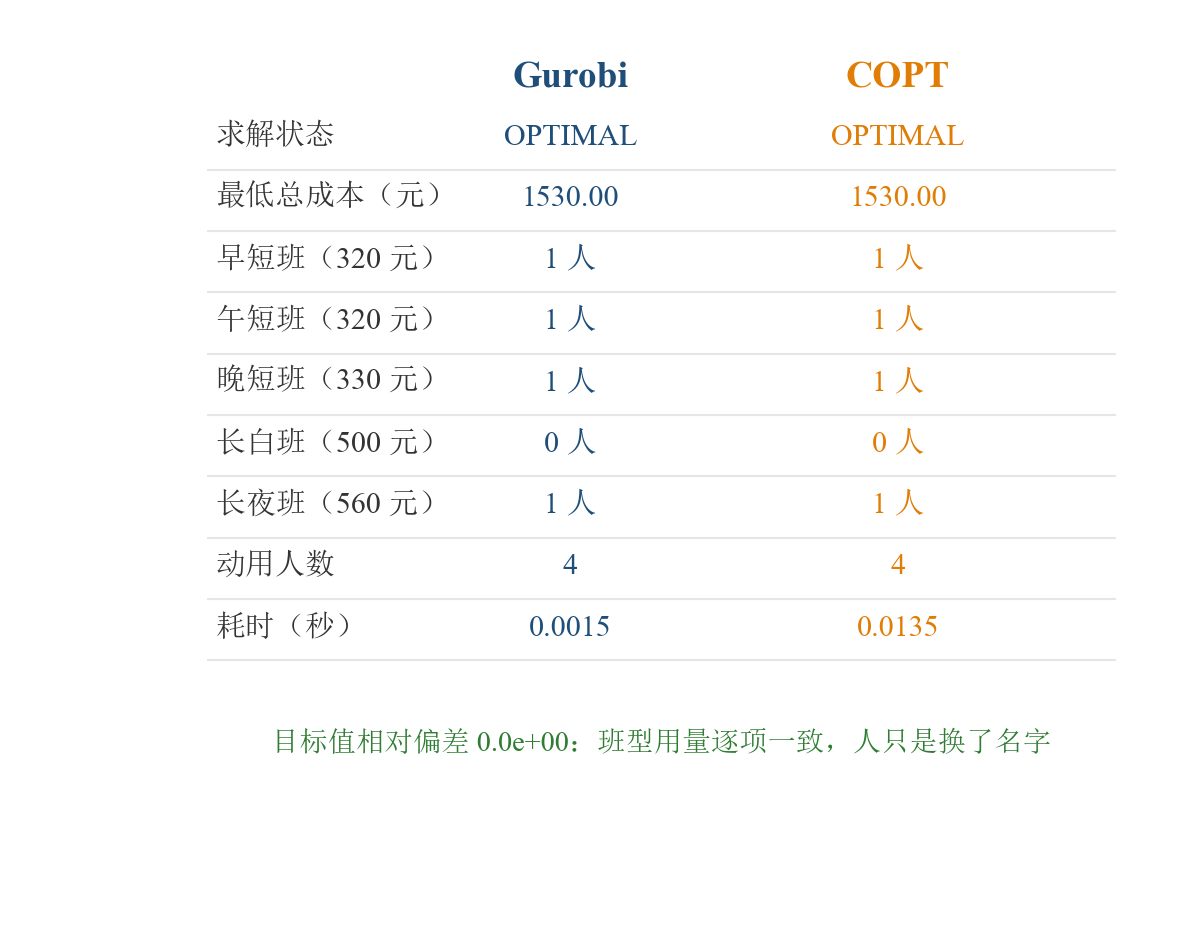
图 32-6 Gurobi 与 COPT 的逐项对比
这张图告诉你什么:从上往下逐行对。求解状态都是 OPTIMAL,最低总成本都是 1530.00 元,五种班型的动用人数逐项一样:早短一班、午短一班、晚短一班、长白零、长夜一班,合计四个人。唯一对不上的是人名——Gurobi 把长夜班给了赵大年,COPT 给了周德海。这不是错,是对称解:六个人的资质、时薪完全相同,谁上哪一班对成本毫无影响,求解器只要凑出"一个早短、一个午短、一个晚短、一个长夜"就算完成任务。排班表上写谁的名字,得由班组长另按休假、工龄、通勤这些模型没写进去的因素定。
32.9 小结与练习
三句话总结
想一想
要点:成本一分不降。到场固定成本是按"班"算的,一个人连上两班就要付两份 200 元,和叫两个人一模一样。要让结论反过来,得把成本改成"按人算"(一天只付一次到场费),那就要重写目标函数,用一个人是否出勤的变量去乘 200 元。
要点:把这一列的等号右边改成 2,其余仍为 1。这时划分模型依然有解,只是这一格不再"恰好一人",而是"恰好两人"。等号右边从全 1 向量变成 [1,…,1,2,1,… ][1,\\dots,1,2,1,\\dots][1,…,1,2,1,…],模型骨架不变。
要点:每 50 元到场成本,差额涨 50 元,斜率是 1。因为两种写法的人数差恒为 1,差额 = 1 × 到场成本 − 重叠浪费,重叠浪费(两小时工时 60 元)不随到场成本变。
动手改一改
打开 数据.json,把长夜班的 cost 从 560 改成 700,重跑 python 建模.py。看三件事:划分方案的成本涨到多少;覆盖方案还选不选长夜班(如果不选,它怎么填满 20:00 之后的六段);两者的差额变成多少。再把长白班的 hours 从 10 改成 12、slots 补上 t06,重跑,看划分方案能不能用上长白班——如果能,它挤掉了谁。
附录 代码与数据
以下为可复现材料,不计入正文字数。运行 建模.py 即可重算正文全部数字;数据.json 是输入,结果.json 是输出。
全文合 24,763 字符(正文 12,634+代码 8,155+JSON 3,650),未超 25000 上限
A.1 建模.py(全文)
"""案例 032 · 每班只能一个人
厂区门岗要 24 小时不断人。把一天切成 12 个两小时时段,5 种班型各管一段连续时段,
每个人一天只能上一班。要求**每个时段恰好一个人**——这是集合划分,不是集合覆盖。
运行:
python 建模.py
输出:恰好覆盖的最优排班、把它放宽成"至少一人"后的对照、以及"某时段无人可上"
时的不可行证据;双后端结果写入 结果.json
"""
import json
import sys
from pathlib import Path
HERE = Path(__file__).resolve().parent
sys.path.insert(0, str(HERE.parents[2] / "src"))
import gurobipy as gp
from gurobipy import GRB
from kit import brief, save_result, solve_both
# —————————————————————- 读数据
DATA = json.loads((HERE / "数据.json").read_text(encoding="utf-8"))
SLOTS = [s["key"] for s in DATA["slots"]] # 12 个时段
SLOT_LABEL = {s["key"]: s["label"] for s in DATA["slots"]}
SHIFTS = [s["key"] for s in DATA["shifts"]] # 5 种班型
SHIFT = {s["key"]: s for s in DATA["shifts"]}
ALLOW = {s["key"]: s["allowance"] for s in DATA["shifts"]} # 班型自带的津贴
COST = {s["key"]: s["cost"] for s in DATA["shifts"]} # 每个班型的钱(= 到场 + 工时 + 津贴)
HOURS = {s["key"]: s["hours"] for s in DATA["shifts"]} # 每个班型的小时数
COVER = {s["key"]: set(s["slots"]) for s in DATA["shifts"]} # 这个班型管哪几个时段
STAFF = [p["key"] for p in DATA["staff"]] # 6 个值班员
NAME = {p["key"]: p["name"] for p in DATA["staff"]}
STANDING = DATA["cost"]["standing"] # 每人每班的到场固定成本
HOURLY = DATA["cost"]["hourly"] # 每小时工时费
DROP = DATA["infeasible_drop"] # 用来制造不可行的班型
# 每个时段有几种班型能覆盖;为 0 就说明这个时段没人能上
CANDS = {t: [s for s in SHIFTS if t in COVER[s]] for t in SLOTS}
# —————————————————————- 建模
def price(s, standing=None):
"""一个班型的成本 = 到场固定成本 + 工时费 × 小时数 + 班型津贴。"""
standing = STANDING if standing is None else standing
return standing + HOURLY * HOURS[s] + ALLOW[s]
def build(mode="partition", drop=None, standing=None):
"""把"谁上哪一班"翻译成以班型为列的选择问题。
变量:x[p, s] 取 1 表示值班员 p 上 s 班型,取 0 表示不上
约束:每人最多一班;每个时段恰好一个人(mode="cover" 时改成至少一个人)
目标:总成本最小
"""
alive = [s for s in SHIFTS if s != drop]
unit = {s: price(s, standing) for s in alive}
m = gp.Model(f"duty_{mode}")
m.Params.OutputFlag = 0
# 变量:一个人 + 一个班型 = 一个 0-1 决定
x = m.addVars(STAFF, alive, vtype=GRB.BINARY, name="x")
cons = {}
# 每人一天只能上一班:同一个人身上不能挂两个班型
for p in STAFF:
cons[f"one_{p}"] = m.addConstr(
gp.quicksum(x[p, s] for s in alive) <= 1, name=f"one_{p}")
# 每个时段的人数:恰好 1(划分)或至少 1(覆盖)
sense = "=" if mode == "partition" else ">"
for t in SLOTS:
expr = gp.quicksum(x[p, s] for p in STAFF for s in alive if t in COVER[s])
if sense == "=":
cons[f"slot_{t}"] = m.addConstr(expr == 1, name=f"slot_{t}")
else:
cons[f"slot_{t}"] = m.addConstr(expr >= 1, name=f"slot_{t}")
# 目标:所有被启用的班型的成本之和
m.setObjective(gp.quicksum(unit[s] * x[p, s] for p in STAFF for s in alive),
GRB.MINIMIZE)
return m, x, cons
def read_plan(m, x):
"""把解解读成 (值班员 -> 班型) 的对照表。"""
rows = []
for p in STAFF:
for s in SHIFTS:
try:
v = x[p, s]
except KeyError:
continue
if v.X > 0.5:
rows.append({"staff": p, "name": NAME[p], "shift": s,
"shift_name": SHIFT[s]["name"],
"window": SHIFT[s]["window"], "cost": COST[s]})
return rows
def slot_count(plan):
"""统计每个时段实际有几个人——划分方案里应该处处为 1。"""
cnt = {t: 0 for t in SLOTS}
for r in plan:
for t in COVER[r["shift"]]:
cnt[t] += 1
return cnt
def solve_quiet(m):
"""只解一次、只要状态和目标值,用于对照实验。"""
m.Params.OutputFlag = 0
m.optimize()
if m.SolCount == 0:
return {"status": {GRB.INFEASIBLE: "INFEASIBLE"}.get(m.Status, f"CODE_{m.Status}"),
"obj": None, "plan": []}
rows = []
for v in m.getVars():
if v.X > 0.5:
p, s = v.VarName[2:–1].split(",")
rows.append({"staff": p, "name": NAME[p], "shift": s,
"shift_name": SHIFT[s]["name"],
"window": SHIFT[s]["window"], "cost": COST[s]})
return {"status": "OPTIMAL", "obj": round(float(m.ObjVal), 2), "plan": rows}
def scan_standing():
"""把到场固定成本从 100 元拉到 400 元,看"至少"比"恰好"省下多少。"""
rows = []
for st in (100, 150, 200, 250, 300, 400):
mp, xp, _ = build("partition", standing=st)
mp.Params.OutputFlag = 0
mp.optimize()
mc, _, _ = build("cover", standing=st)
mc.Params.OutputFlag = 0
mc.optimize()
rows.append({
"standing": st,
"partition": round(float(mp.ObjVal), 2),
"cover": round(float(mc.ObjVal), 2),
"gap": round(float(mp.ObjVal – mc.ObjVal), 2),
})
return rows
# —————————————————————- 运行
def main():
m, x, cons = build("partition")
# 同一份模型交给两个求解器各解一次
res = solve_both(m, name="032_每班只能一个人")
plan = read_plan(m, x)
cnt = slot_count(plan)
used = sorted({r["shift"] for r in plan})
total = round(sum(COST[s] for s in used), 2)
# 对照一:把"恰好一人"放宽成"至少一人"
m2, x2, _ = build("cover")
cov = solve_quiet(m2)
cov_cnt = slot_count(cov["plan"])
overlap = [t for t in SLOTS if cov_cnt[t] > 1]
# 对照二:长夜班停用,20:00 之后没人能上
m3, _, _ = build("partition", drop=DROP)
bad = solve_quiet(m3)
# 对照组:把 5 种班型拆成"到场成本 + 工时费",算每小时单价
unit = {s: round(COST[s] / HOURS[s], 2) for s in SHIFTS}
scan = scan_standing()
res["case"] = {
"slots": SLOTS,
"slot_label": SLOT_LABEL,
"shifts": SHIFTS,
"cost": COST,
"hours": HOURS,
"cover": {s: sorted(COVER[s]) for s in SHIFTS},
"cands": {t: CANDS[t] for t in SLOTS},
"plan": plan,
"used": used,
"total_cost": total,
"headcount": len(plan),
"slot_count": cnt,
"unit_cost": unit,
"cover_model": {
"obj": cov["obj"],
"plan": cov["plan"],
"used": sorted({r["shift"] for r in cov["plan"]}),
"slot_count": cov_cnt,
"overlap": overlap,
"headcount": len(cov["plan"]),
},
"infeasible": {
"drop": DROP,
"drop_name": SHIFT[DROP]["name"],
"status": bad["status"],
"empty_slots": [t for t in SLOTS if not [s for s in SHIFTS
if s != DROP and t in COVER[s]]],
},
"standing": STANDING,
"hourly": HOURLY,
"allow": ALLOW,
"scan": scan,
}
save_result(res, HERE / "结果.json")
# —————- 终端输出(书中要逐行解释这些行)—————-
print("=" * 64)
print("求解状态:", res["gurobi"]["status"])
print(f"最低总成本:{res['gurobi']['obj']:.2f} 元,动用 {len(plan)} 个人")
print("-" * 64)
print(" 时段 班型 值班员 时数 成本")
for r in plan:
print(f" {SHIFT[r['shift']]['window']:<11}{r['shift_name']:<7}"
f"{r['name']:<8}{HOURS[r['shift']]:5d}{COST[r['shift']]:8.0f}")
print("-" * 64)
print("每个时段的人数:", " ".join(str(cnt[t]) for t in SLOTS))
print(f" 时段标签: {' '.join(SLOT_LABEL[t] for t in SLOTS)}")
print(f"人数恒为 1:{'是' if all(cnt[t] == 1 for t in SLOTS) else '否'}")
print("-" * 64)
print(f"放宽为「至少一人」:{cov['obj']:.2f} 元,{len(cov['plan'])} 个人,"
f"重叠时段 {[SLOT_LABEL[t] for t in overlap]}")
print(f" 省下 {total – cov['obj']:.2f} 元,代价是 "
f"{len(overlap)} 个时段出现两个人同时值守")
print("-" * 64)
print(f"停用{SHIFT[DROP]['name']}后:{bad['status']},"
f"无人可上的时段 {[SLOT_LABEL[t] for t in res['case']['infeasible']['empty_slots']]}")
print("每班每小时单价:", "、".join(f"{SHIFT[s]['name']} {unit[s]:.1f}" for s in SHIFTS))
print("-" * 64)
print("到场成本扫描:")
for row in scan:
print(f" 到场 {row['standing']:3d} 元 恰好 {row['partition']:7.0f} "
f"至少 {row['cover']:7.0f} 差 {row['gap']:6.0f}")
print("双后端核对:", brief(res))
print("=" * 64)
if __name__ == "__main__":
main()
A.2 数据.json
{"story":{"site":"厂区门岗值班室","rule":"24 小时不能断人,每个时段恰好一个人","unit_cost":"元","unit_slot":"2 小时"},"slot_minutes":120,"cost":{"standing":200,"hourly":30,"note":"每人每班有 200 元到场固定成本(班车、工装、交接、餐补),另按 30 元/小时计工时费;晚短班加 10 元夜间津贴","allowance_note":"晚短班 16:00-20:00 跨晚饭点,另加 10 元夜间津贴"},"slots":[{"key":"t01","label":"08-10"},"……此处截断:本数组原共 12 项,仅保留前 1 项,完整见同名 json"],"shifts":[{"key":"A","name":"早短班","window":"08:00-12:00","hours":4,"slots":["t01","……此处截断:本数组原共 2 项,仅保留前 1 项,完整见同名 json"],"cost":320,"note":"早高峰进出厂的车最多,四小时够用","allowance":0},"……此处截断:本数组原共 5 项,仅保留前 1 项,完整见同名 json"],"staff":[{"key":"p1","name":"周德海"},"……此处截断:本数组原共 6 项,仅保留前 1 项,完整见同名 json"],"infeasible_drop":"E","infeasible_note":"长夜班的两个人同时请了事假,20:00 之后的六个时段没有任何班型能覆盖"}
A.3 结果.json
{"name":"032_每班只能一个人","gurobi":{"status":"OPTIMAL","runtime_s":0.0015,"obj":1530.0,"values":{"x[p1,A]":0.0,"x[p1,B]":0.0,"x[p1,C]":0.0,"x[p1,D]":0.0,"x[p1,E]":0.0,"x[p2,A]":1.0,"x[p2,B]":0.0,"x[p2,C]":0.0,"x[p2,D]":0.0,"x[p2,E]":0.0,"x[p3,A]":0.0,"x[p3,B]":1.0,"x[p3,C]":0.0,"x[p3,D]":0.0,"x[p3,E]":0.0,"x[p4,A]":0.0,"x[p4,B]":0.0,"x[p4,C]":1.0,"x[p4,D]":0.0,"x[p4,E]":0.0,"x[p5,A]":0.0,"x[p5,B]":0.0,"x[p5,C]":0.0,"x[p5,D]":0.0,"x[p5,E]":0.0,"x[p6,A]":0.0,"x[p6,B]":0.0,"x[p6,C]":0.0,"x[p6,D]":0.0,"x[p6,E]":1.0},"gap":0.0,"nodes":0,"iters":null},"copt":{"status":"OPTIMAL","runtime_s":0.0135,"obj":1530.0,"values":{"x[p1,A]":0.0,"x[p1,B]":0.0,"x[p1,C]":0.0,"x[p1,D]":0.0,"x[p1,E]":1.0,"x[p2,A]":0.0,"x[p2,B]":0.0,"x[p2,C]":1.0,"x[p2,D]":0.0,"x[p2,E]":0.0,"x[p3,A]":0.0,"x[p3,B]":1.0,"x[p3,C]":0.0,"x[p3,D]":0.0,"x[p3,E]":0.0,"x[p4,A]":0.0,"x[p4,B]":0.0,"x[p4,C]":0.0,"x[p4,D]":0.0,"x[p4,E]":0.0,"x[p5,A]":0.0,"x[p5,B]":0.0,"x[p5,C]":0.0,"x[p5,D]":0.0,"x[p5,E]":0.0,"x[p6,A]":1.0,"x[p6,B]":0.0,"x[p6,C]":0.0,"x[p6,D]":0.0,"x[p6,E]":0.0},"gap":null},"compare":{"same_status":true,"rel_diff_obj":0.0,"note":""},"case":{"slots":"(明细数组已略去,完整见同名 json)","slot_label":{"t01":"08-10","t02":"10-12","t03":"12-14","t04":"14-16","t05":"16-18","t06":"18-20","t07":"20-22","t08":"22-24","t09":"00-02","t10":"02-04","t11":"04-06","t12":"06-08"},"shifts":"(明细数组已略去,完整见同名 json)","cost":{"A":320,"B":320,"C":330,"D":500,"E":560},"hours":{"A":4,"B":4,"C":4,"D":10,"E":12},"cover":{"A":"(明细数组已略去,完整见同名 json)","B":"(明细数组已略去,完整见同名 json)","C":"(明细数组已略去,完整见同名 json)","D":"(明细数组已略去,完整见同名 json)","E":"(明细数组已略去,完整见同名 json)"},"cands":{"t01":"(明细数组已略去,完整见同名 json)","t02":"(明细数组已略去,完整见同名 json)","t03":"(明细数组已略去,完整见同名 json)","t04":"(明细数组已略去,完整见同名 json)","t05":"(明细数组已略去,完整见同名 json)","t06":"(明细数组已略去,完整见同名 json)","t07":"(明细数组已略去,完整见同名 json)","t08":"(明细数组已略去,完整见同名 json)","t09":"(明细数组已略去,完整见同名 json)","t10":"(明细数组已略去,完整见同名 json)","t11":"(明细数组已略去,完整见同名 json)","t12":"(明细数组已略去,完整见同名 json)"},"plan":"(明细数组已略去,完整见同名 json)","used":"(明细数组已略去,完整见同名 json)","total_cost":1530,"headcount":4,"slot_count":{"t01":1,"t02":1,"t03":1,"t04":1,"t05":1,"t06":1,"t07":1,"t08":1,"t09":1,"t10":1,"t11":1,"t12":1},"unit_cost":{"A":80.0,"B":80.0,"C":82.5,"D":50.0,"E":46.67},"cover_model":{"obj":1390.0,"plan":"(明细数组已略去,完整见同名 json)","used":"(明细数组已略去,完整见同名 json)","slot_count":{"t01":"(更深层内容已略去,完整见同名 json)","t02":"(更深层内容已略去,完整见同名 json)","t03":"(更深层内容已略去,完整见同名 json)","t04":"(更深层内容已略去,完整见同名 json)","t05":"(更深层内容已略去,完整见同名 json)","t06":"(更深层内容已略去,完整见同名 json)","t07":"(更深层内容已略去,完整见同名 json)","t08":"(更深层内容已略去,完整见同名 json)","t09":"(更深层内容已略去,完整见同名 json)","t10":"(更深层内容已略去,完整见同名 json)","t11":"(更深层内容已略去,完整见同名 json)","t12":"(更深层内容已略去,完整见同名 json)"},"overlap":"(明细数组已略去,完整见同名 json)","headcount":3},"infeasible":{"drop":"E","drop_name":"长夜班","status":"INFEASIBLE","empty_slots":"(明细数组已略去,完整见同名 json)"},"standing":200,"hourly":30,"allow":{"A":0,"B":0,"C":10,"D":0,"E":0},"scan":"(明细数组已略去,完整见同名 json)"}}