软考Cache命中率与平均访问时间真题(附百度网盘真题包)
适用对象:备考软考中级「软件设计师」「网络工程师」的同学 考查位置:上午综合知识·存储系统,1~2 分,与流水线并列“必拿分” 本文解决三件事:命中率怎么用、平均访问时间怎么代、反向求命中率怎么解
目录
- 软考Cache命中率与平均访问时间真题(附百度网盘真题包)
-
- 一、Cache 为什么能让访问变快
-
- 1.1 两个概率,一个公式
- 1.2 注意题干里的“缺失代价”
- 二、先把三种映射方式理清(选择题常考)
- 三、一条直线:命中率越高,Ta 越接近 Tc
- 四、真题四步法
-
- 4.1 反问题:给 Ta 求 H
- 4.2 真题变体:缺失代价含 Cache 查找时间
- 五、局部性原理:命中率不是天上掉下来的
- 六、用代码验证正算与反算
- 六、易错点清单
- 七、写在最后
Cache 题几乎只考一个公式,但很多人在两个地方丢分:缺失代价要不要加 Cache 时间、题目给的是命中率还是缺失率。下面把公式、曲线、真题、代码一次讲清。
一、Cache 为什么能让访问变快
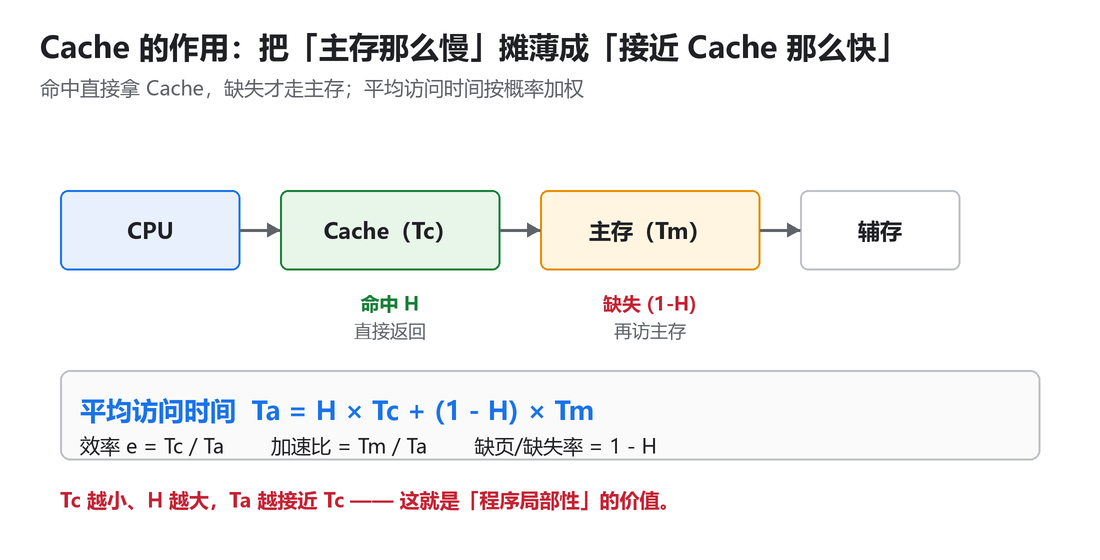
CPU 取数据先查 Cache:命中就直接返回,缺失才去主存。因为程序有局部性,绝大多数访问都能命中,所以平均下来接近 Cache 的速度。
1.1 两个概率,一个公式
- 命中率 H:访问在 Cache 中命中的比例;缺失率 = 1 − H;
- 平均访问时间 Ta = H × Tc + (1 − H) × Tm(Tc 为 Cache 存取时间,Tm 为主存存取时间);
- 效率 e = Tc / Ta,加速比 = Tm / Ta。
这条公式的本质就是“按概率加权平均”,不需要背推导。
1.2 注意题干里的“缺失代价”
软考有两种给法,得分点完全不同:
| 直接给 Cache 与主存存取时间 | Tm | Ta = H·Tc + (1−H)·Tm |
| 明确“缺失时先查 Cache 再访主存” | Tc + Tm | Ta = H·Tc + (1−H)·(Tc+Tm) |
看到“同时访问”“先查后访”这类字眼,务必回去确认一遍。
二、先把三种映射方式理清(选择题常考)
Cache 的考题分两条线:一条算时间(本文主线),另一条考映射方式。两者常在同一份卷子里出现,混淆点在于“块怎么放”。
| 直接映射 | 主存块号 mod Cache 行数,位置唯一 | 硬件最简单、查找最快 | 冲突最严重,抖动明显 | 高 |
| 全相联映射 | 任意块可放任意行 | 冲突最少、命中率最高 | 比较器多、成本高 | 低 |
| 组相联映射 | 组间直接映射、组内全相联 | 折中方案,实际最常用 | 逻辑稍复杂 | 中 |
一句话记忆:直接映射最便宜也最容易撞车,全相联最贵也最灵活,组相联是工业界的选择(n 路组相联就是“每组 n 行,组内随便放”)。
三、一条直线:命中率越高,Ta 越接近 Tc
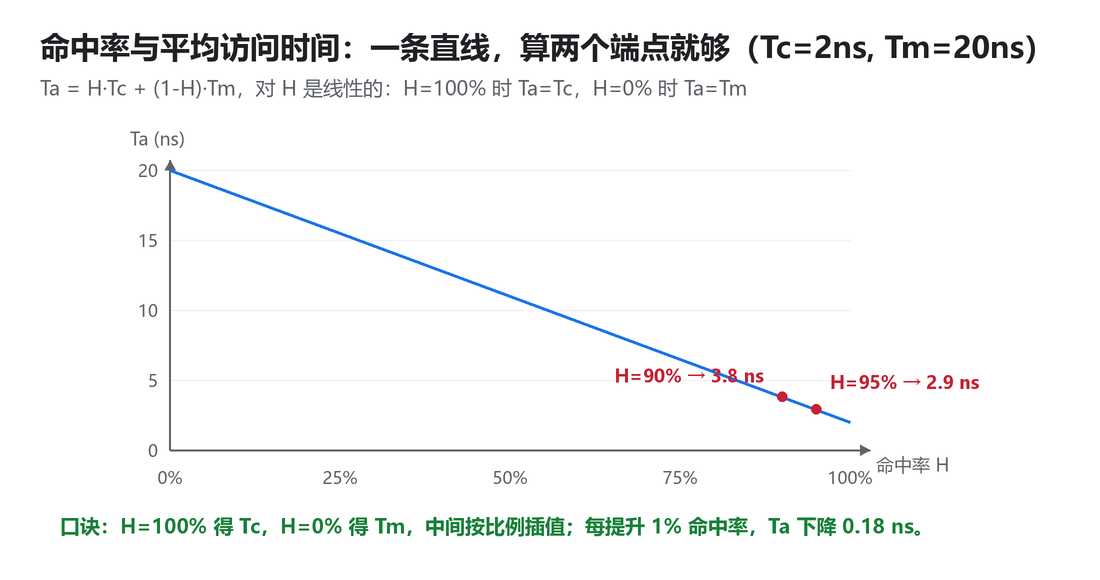
Ta 对 H 是线性关系,所以只要算两个端点就能估任何一点:H = 100% 时 Ta = Tc,H = 0% 时 Ta = Tm。以 Tc = 2 ns、Tm = 20 ns 为例,H 每提升 1%,Ta 下降 0.18 ns。
四、真题四步法
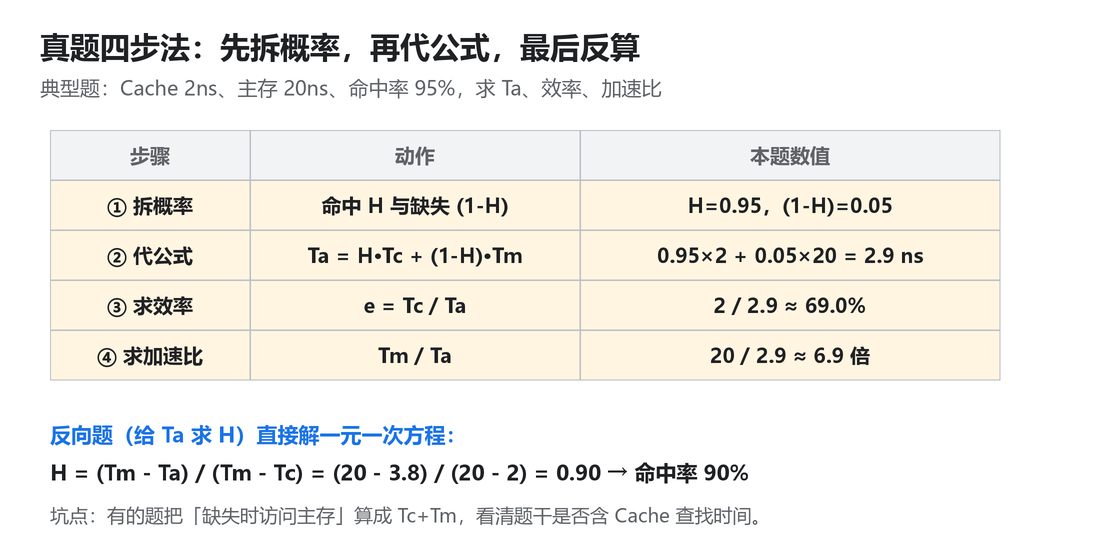
【题干】 某计算机 Cache 存取时间为 2 ns,主存存取时间为 20 ns,命中率为 95%。求平均访问时间、Cache 效率与加速比。
| ① 拆概率 | H = 0.95,(1−H) = 0.05 | — |
| ② 代公式 | Ta = 0.95×2 + 0.05×20 | 2.9 ns |
| ③ 求效率 | e = 2 / 2.9 | ≈ 69.0% |
| ④ 求加速比 | 20 / 2.9 | ≈ 6.9 倍 |
4.1 反问题:给 Ta 求 H
题干改成“平均访问时间为 3.8 ns,求命中率”,只需解一元一次方程:
H = (Tm − Ta) / (Tm − Tc) = (20 − 3.8) / (20 − 2) = 0.90
即命中率 90%。这类题几乎每年都有变体,把公式变形记住即可。
4.2 真题变体:缺失代价含 Cache 查找时间
【题干】 某系统采用“先查 Cache、未命中再访主存”的方式,Cache 存取周期 2 ns,主存存取周期 20 ns,命中率 90%,求平均访问时间。
【解析】 缺失时先花 2 ns 查 Cache 再花 20 ns 访主存,代价为 22 ns: Ta = 0.9 × 2 + 0.1 × 22 = 1.8 + 2.2 = 4.0 ns。比按 Tm 直接代入的 3.8 ns 更大,差的就是那一次无效查找。
五、局部性原理:命中率不是天上掉下来的
| 时间局部性 | 刚访问过的数据很可能再次被访问 | 循环变量复用、提高 Cache 替换策略质量(LRU) |
| 空间局部性 | 相邻地址的数据很可能被一起访问 | 按行访问数组、循环分块、预取 |
这也是为什么“把二维数组的遍历顺序从按列改成按行”能让程序快好几倍——不是算法变了,是命中率变了。
六、用代码验证正算与反算
def amat(H, Tc, Tm):
"""平均访问时间"""
return H * Tc + (1 – H) * Tm
def solve_h(Ta, Tc, Tm):
"""已知平均访问时间,反解命中率"""
return (Tm – Ta) / (Tm – Tc)
Tc, Tm = 2, 20
for H in (0.90, 0.95, 0.99):
ta = amat(H, Tc, Tm)
print(f"H={H:.2f} Ta={ta:.2f}ns 效率={Tc/ta:.1%} 加速比={Tm/ta:.2f}")
print("反解:", round(solve_h(3.8, Tc, Tm), 2))
运行结果:
H=0.90 Ta=3.80ns 效率=52.6% 加速比=5.26
H=0.95 Ta=2.90ns 效率=69.0% 加速比=6.90
H=0.99 Ta=2.18ns 效率=91.7% 加速比=9.17
反解: 0.9
可以看到:命中率从 90% 提到 99%,效率从 53% 涨到 92%,这就是局部性优化(循环分块、提高空间局部性)的价值。
六、易错点清单
- 命中率与缺失率弄反:把 5% 的缺失率当成命中率代入,结果会算成 19 ns。
- 缺失代价漏加 Tc:题干写“先查 Cache 再访主存”时,缺失代价是 Tc + Tm。
- 效率与加速比混用:效率以 Tc 为基准,加速比以 Tm 为基准,分母都是 Ta。
- 单位不统一:ns 与 μs 混算,差 1000 倍。
- 忽略写策略:写直达/写回会影响实际访存次数,但 Ta 的公式仍按命中率加权。
七、写在最后
Cache 题只有一条主线:概率加权求平均,再拿 Tc 和 Tm 分别做比值。把本文 95% 那道题手算一遍,再用代码对拍一次,就把它变成稳拿的 1~2 分。
下一篇写「段页式地址转换与页面置换算法」,同属存储管理板块,需要的同学可以关注专栏更新。
本文涉及的历年真题与解析已整理成合集,需要的同学可自取: 链接: https://pan.baidu.com/s/1SwVEmITKHveCupjP_VH7pA 提取码: rk02